 AI 热点
在本地 AMD 和 NVIDIA GPU 上,增强提示词、描述图像和撰写故事的速度提升至 2 倍。
 rattus1282026 年 11 月 11 日
ComfyUI 可在本地运行多种大语言模型(LLM),用于增强提示词、撰写故事、描述图像,甚至进行基础聊天。最近,我们重写了该文本生成的热路径,重点针对 Qwen3.x 系列 LLM。结果是, 同一 GPU 上的相同 checkpoint 现在生成 token 的速度最高可达原来的两倍,而模型本身及其输出质量均无变化。 这同时也加速了近期最先进图像生成模型所附带的许多提示词增强器。
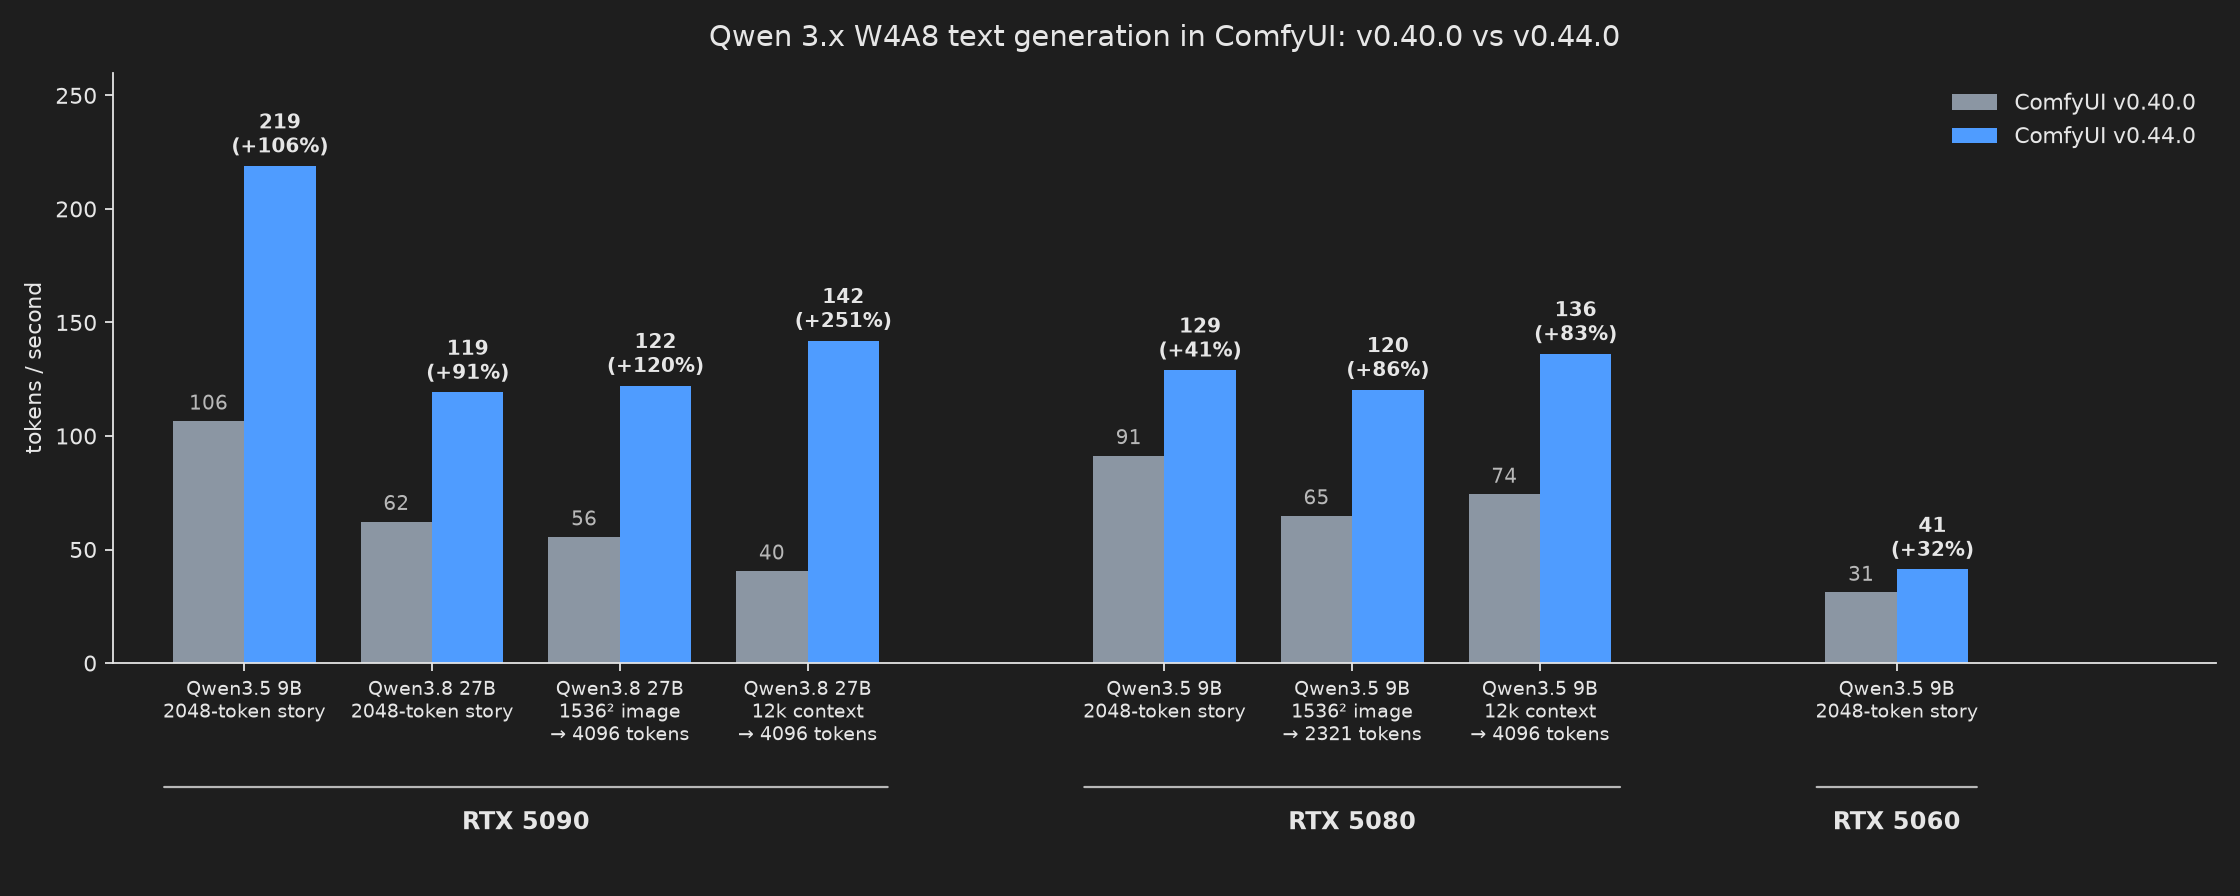
在 RTX 5090 上,Qwen3.5 9B 从每秒 106 个 token 提升到 219 个 token;在 RTX 5080 上则从每秒 91 个提升到 129 个。Qwen3.8 27B 在 RTX 5090 上描述一张 1536×1536 图像时,从 55 提升到 122。
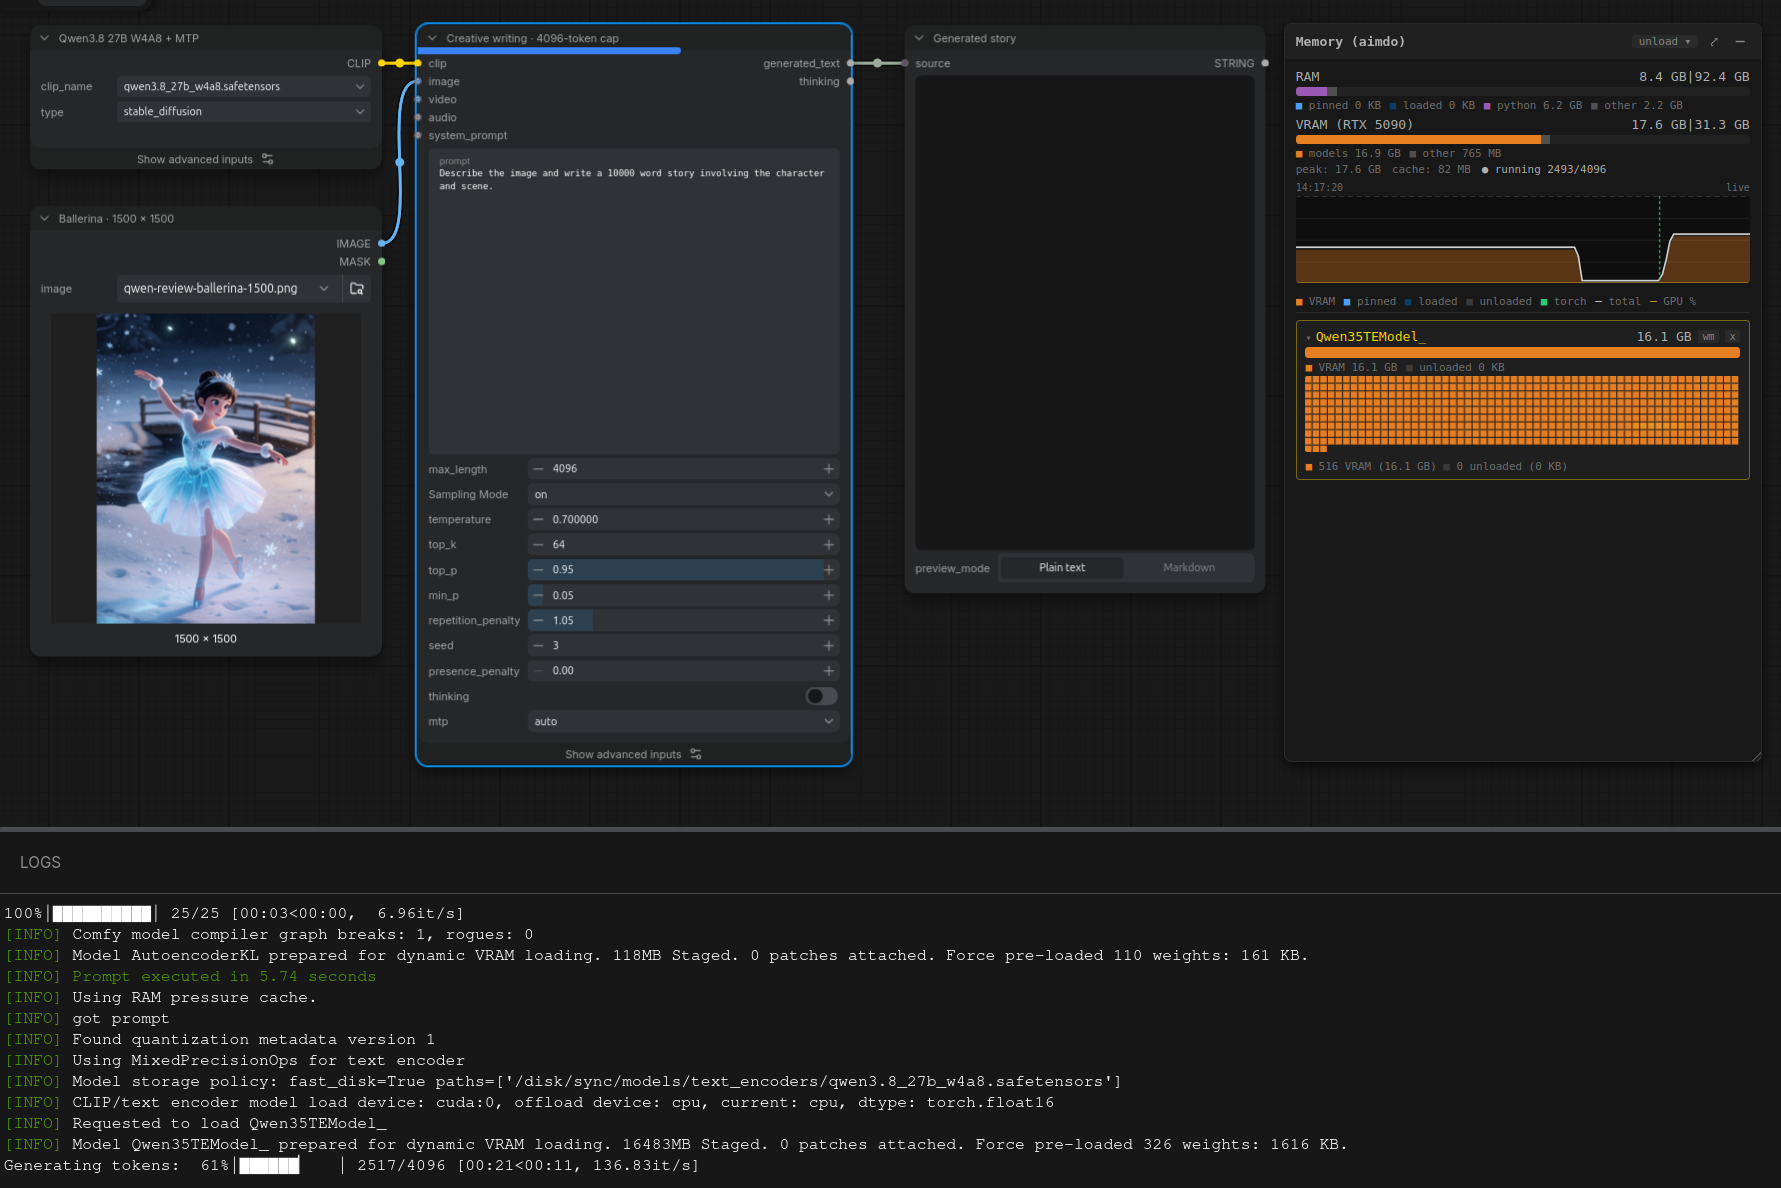
RTX 5090 上的 Qwen3.8 27B W4A8,描述一张 1500×1500 图像并撰写故事:每秒 137 个 token, mtp 开启 auto.
本博客讨论 LLM 推理的一些架构与实现细节,以及近期的提速成果。本文所述内容均已在 ComfyUI v0.45.0 中提供。只需加载一个 Qwen3.x checkpoint,将 Text Generate 节点的 mtp 选项保持为 auto,即可开始使用。
瓶颈是什么?
文本生成是顺序进行的:每个新 token 都依赖于前一个 token,并且每个 token 都需要完整读取一次模型权重。大规模 LLM 推理通常可以通过将多次推理批处理在一起来摊薄这一权重读取成本,例如将多个用户的多个完全独立的聊天合并处理。然而,单个 ComfyUI 工作流通常只生成一个序列,因此每一步的批大小都为一。对于一个量化为四比特的 27B 参数模型,例如 Qwen3.8 W4A8,一步大约需要读取 14 GB 权重才能生成一个 token,而每个权重可能只参与一次数学运算。token 生成的瓶颈取决于你的 GPU 从 VRAM 读取模型的速度。
相比之下,ComfyUI 中用于图像或视频生成的扩散模型在每一步都会处理完整的相应潜空间输出,每个权重都作用于整个序列长度。与 LLM 不同,扩散模型的瓶颈在于算力,即你的 GPU 计算速度有多快。这为图像和视频生成领域带来了截然不同的优化问题。
LLM 模型中的大部分权重都用于线性矩阵乘法。这些运算由线性内核处理,即 GEMM/GEMV 内核,它们是针对矩阵乘法优化的 GPU 内核(程序)。在我们的 LLM 场景中,一个稠密的、通常是方形的矩阵会乘以一个向量 M=1 (对应单个 token 的状态),或乘以一个非常薄的矩阵,例如 M=3 (对应小 token 数量的多 token 预测(MTP)验证状态)。这就是“瘦长型”线性问题。
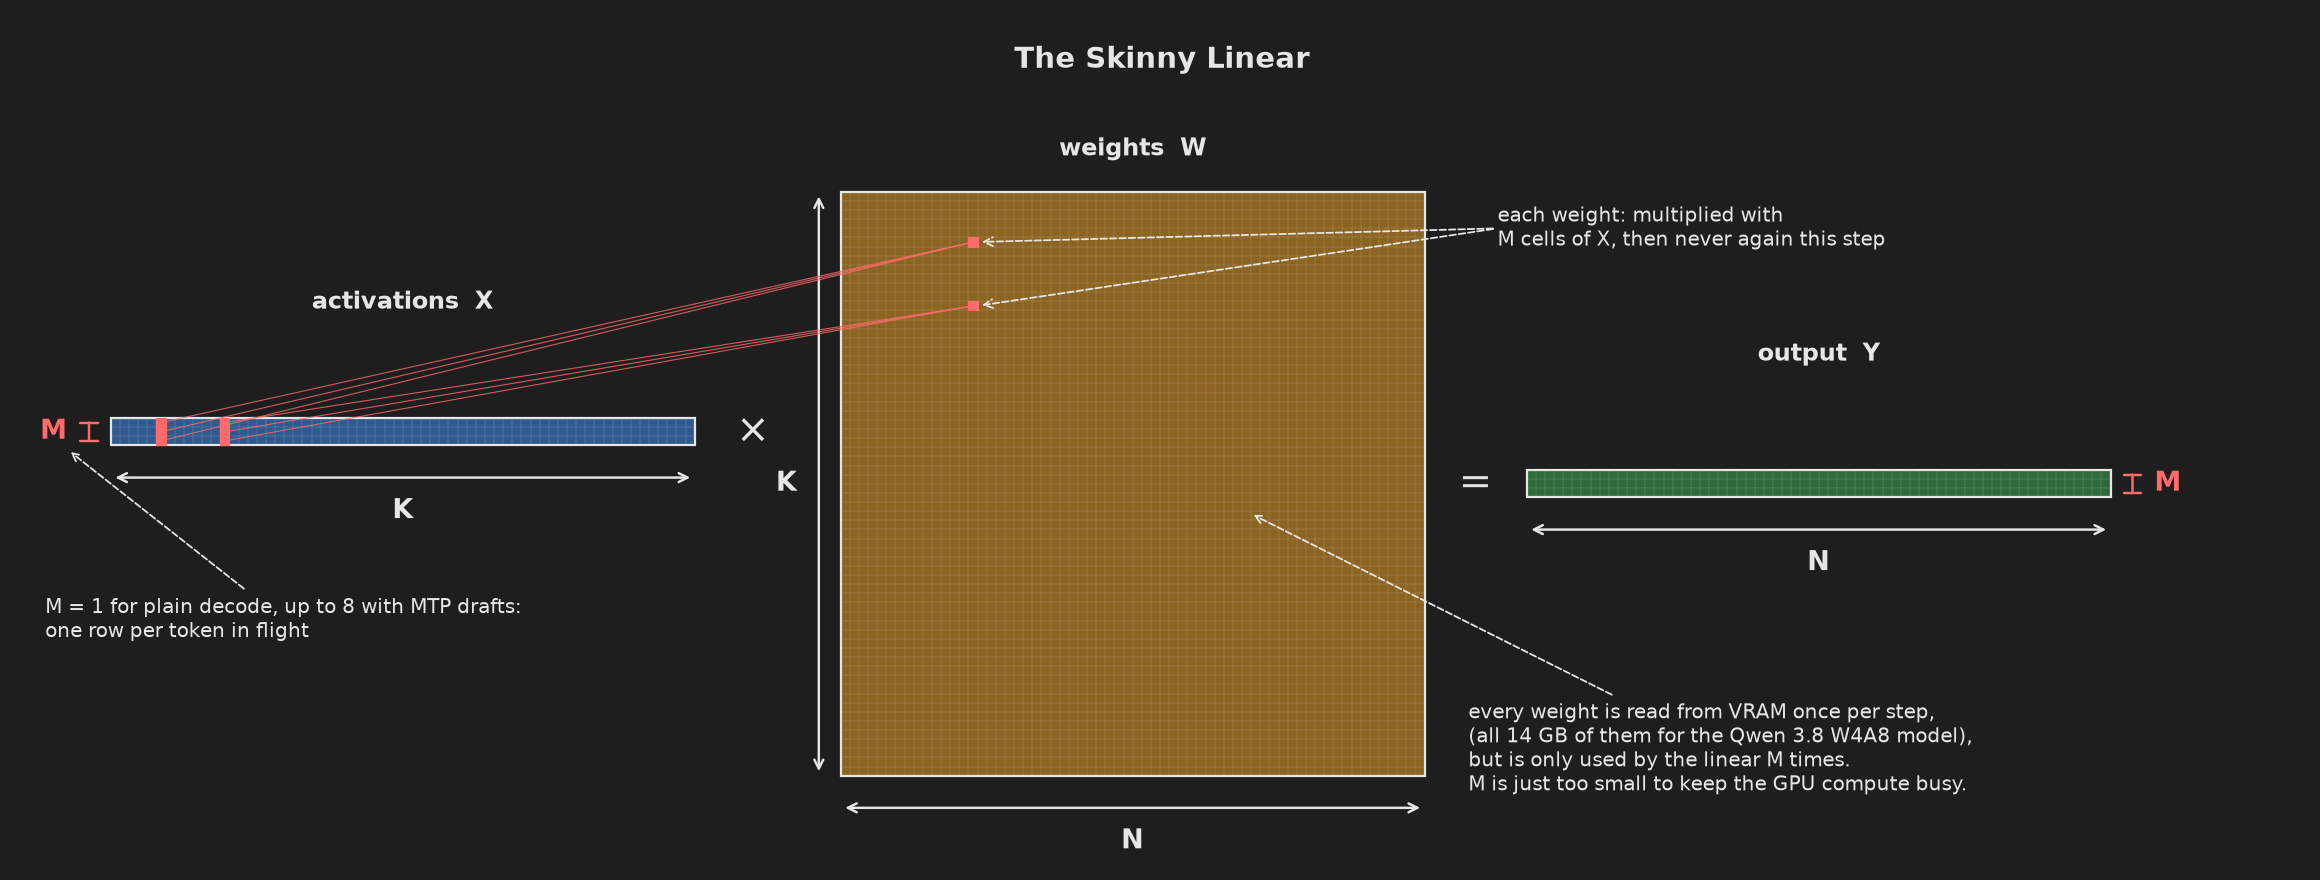
在近期的改动中,我们针对 VRAM 总线利用率和效率加入了大量优化,纯粹围绕 VRAM 读取速度和 VRAM 内存总线占用时间进行重新优化。
什么是多 token 预测?
Qwen3.x checkpoint 附带一个多 token 预测(MTP)头:与主模型相比,这是一个更小的额外层,它利用模型的隐藏状态来同时猜测下一个 token。ComfyUI 利用这一 MTP 特性进行推测解码。MTP 头先草拟出几个 token,然后在下一个 token 的前向传播中,所有候选草稿 token 会被一起进行推测性验证。这一过程的成本与生成一个 token 大致相同,因为该传播仍然受限于 VRAM 速度。每一个与主模型本会选择的 token 相匹配的 MTP 草稿都会被模型接受,从而省去一次完整的前向传播,进而为每个正确猜中的 MTP token 省去一次完整的模型读取。这就是 MTP 能够将输出 token 速率提升一倍以上、显著提高性能的原因。
在近期的改动中,我们既优化了 MTP 的计算内核,又通过新的自适应树 MTP 算法增强了 MTP 算法本身。
优化线性内核
ComfyUI 中的 Qwen3.x checkpoint 通常是 W4A8(4 比特权重、8 比特激活)或 W6A8(6 比特权重、8 比特激活)。在 ComfyUI v0.40.0 中,这些由一条通用 INT8 路径处理:量化激活,然后运行一个矩阵-向量线性内核,该内核的编写仅匹配 safetensors 文件中存储的 W4A8 VRAM 布局。我们将其替换为一个优化的矩阵-向量(GEMV)内核,其中权重及其分组缩放因子按内核消费它们的顺序在内存中交错排列。这样,每个线程块流式读取一段连续数据,而不必在权重张量和缩放张量之间来回跳转,从而减少 VRAM 寻址并提高批量 VRAM 读取流水线的效率。这种针对内核的 VRAM 重排是在 VRAM 中就地完成的,由动态 VRAM 权重加载引擎管理,每次模型加载只需执行一次。该过程不需要额外的 RAM 或 VRAM。这种重排仅对我们的瘦长型线性层有必要,因为更“胖”的扩散模型线性层瓶颈在算力上,会掩盖上述 VRAM 寻址的延迟。
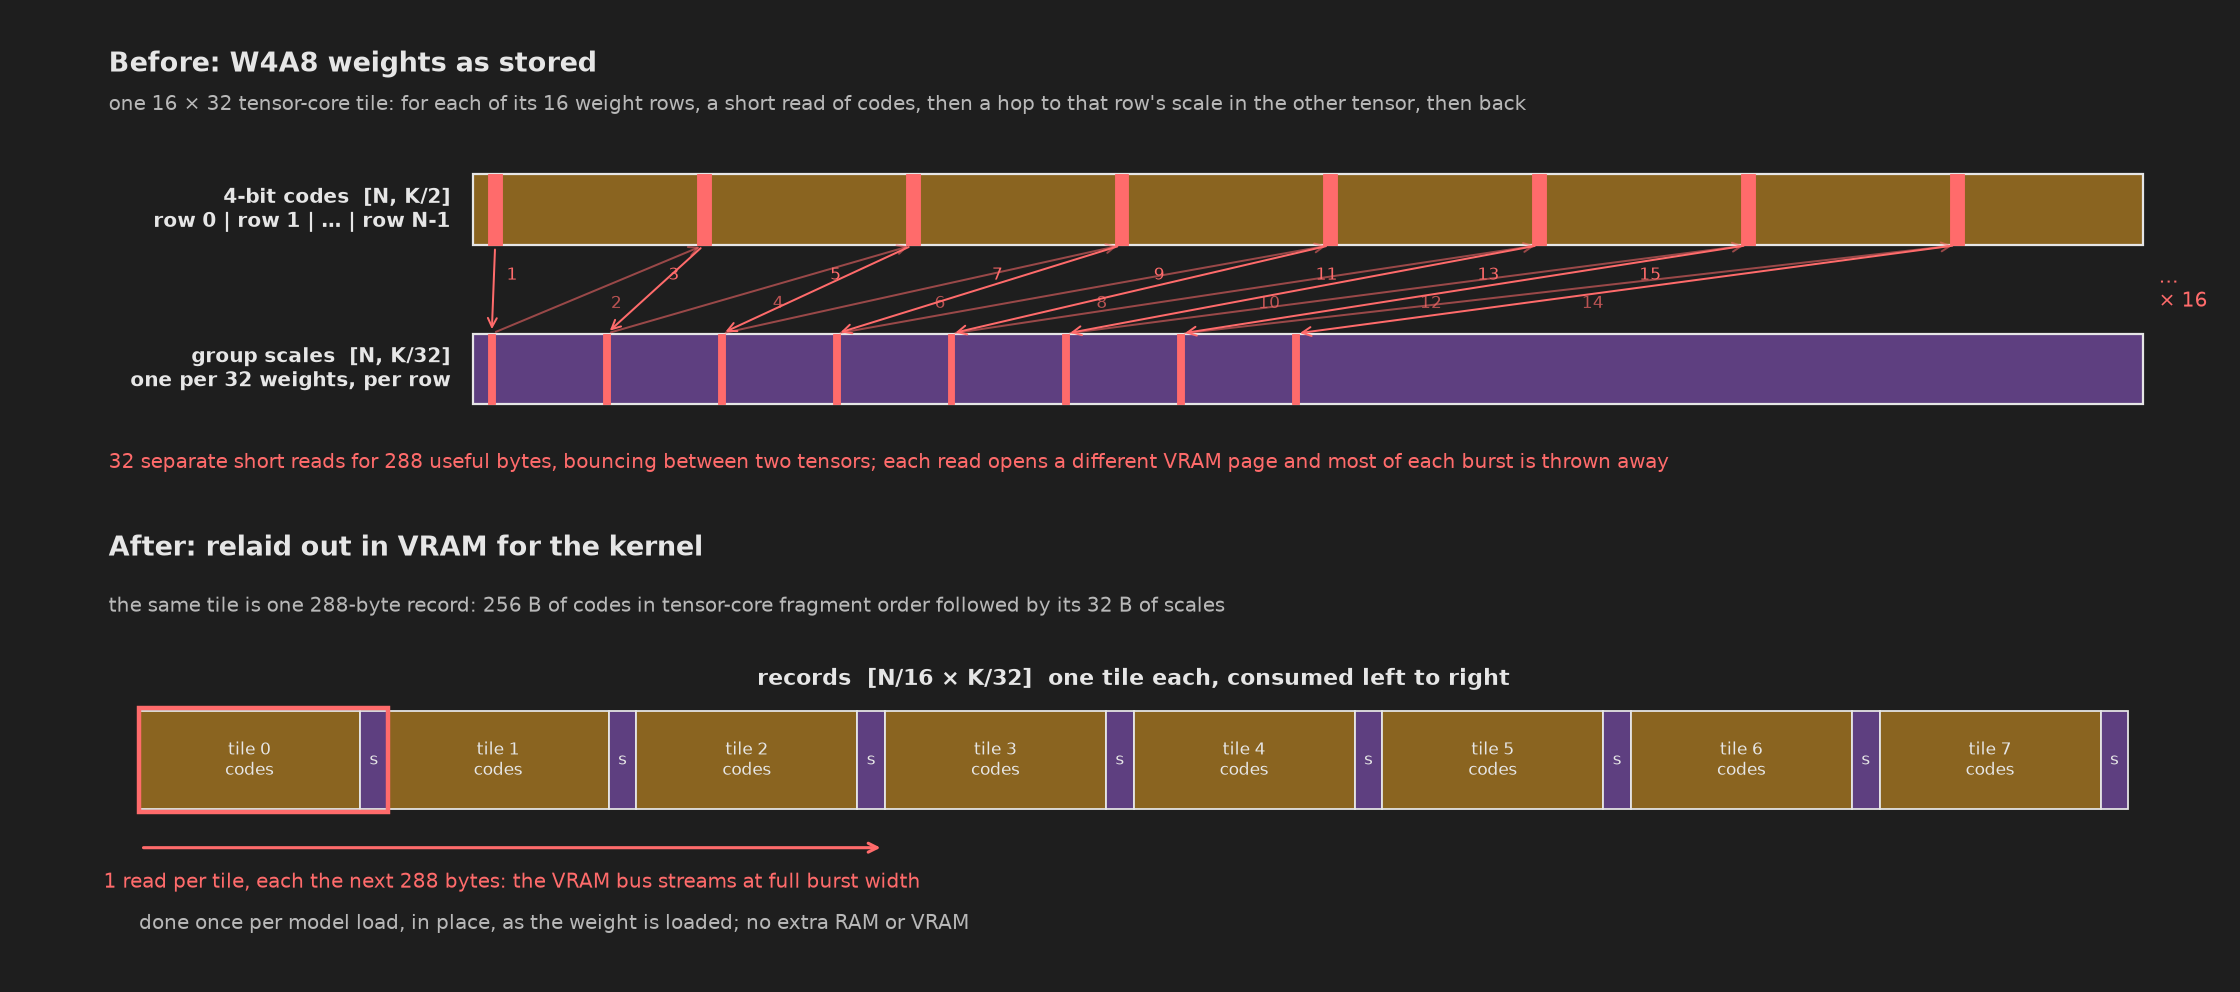
大多数现代 GPU 都具备张量核心,可用单条 GPU 指令计算一个矩阵乘法运算块。从 30 系列开始的 NVIDIA GPU 针对最小瓦片维度 8进行了优化,其他矩形维度可以更大。新内核使用这一矩阵乘累加(MMA)指令,并将权重和输入排列成使上例中所示的瘦长维度 M, 映射到硬件支持的最小瓦片维度 8。这样既能使用单条指令,又能最大限度地减少浪费的未使用计算行(当 M < 8时)。对于纯单 token 生成的情况,即 M=1,其性能与使用非张量(CUDA)核心指令(dp4a)大致相同。然而,考虑到 MTP 时,瓦片化方法会立刻变得更快,其中 M > 1最终,最多八行的 MTP 猜测几乎不产生额外开销,因为我们的瓦片化内核计算速度最高可达 M=8 与 M=1.
线性内核中新增了序言融合:激活量化现在会吸收其前面的 RMSNorm 或 SwiGLU,因此这些中间张量在两者之间永远不会被写入内存,从而最大限度地减少缓存内存流量和内核启动开销。这反过来又最大限度地减少了 VRAM 总线活动之间的小段纯计算间隙,带来小幅额外加速。
关注注意力机制!
Qwen3.5 和 3.8 是混合注意力模型:这类模型使用两种不同的注意力方案,分别应用于不同的 transformer 块。每四层中有三层是带有小型循环状态的 DeltaNet 线性注意力,第四层是带有 KV 缓存的普通分组查询注意力。
对于注意力层,我们新增了一个解码内核,它直接处理单个 token 或来自 MTP 的少量草稿 token 及其因果验证行的短查询,而无需物化注意力掩码。它将缓存的 prefix 拆分到许多线程块上,因此只有很小的查询会占用 GPU,而最后完成的块在同一次启动中合并部分结果。
对于 DeltaNet 层,代价高昂的部分是推测。验证包含多个 token 的草稿需要每个 token 之后的循环状态,而如果草稿被拒绝,则必须恢复该状态。此前,这意味着在每个推测 token 之后为每一层对每个头 64 KiB 的完整状态进行快照。现在,内核记录每个 token 的小型中间量,并推迟状态更新,以便下一次调用只重放已接受的 token,并一次性写入已提交的状态。内核反过来用少量额外算术换取大量额外的内存流量,这正好契合我们的核心瓶颈问题:受限于 VRAM,同时还有算力余量。
此前,KV 缓存自回归注意力内核与新增的优化版 Comfy-Kitchen 注意力方案是分开的。Comfy-Kitchen 注意力以及 KV 缓存支持已在 ComfyUI v0.45 中加入,为博客前文所述的 LLM 专用注意力方案启用 INT8 注意力。这减少了 KV 缓存的 VRAM 占用,同时也显著提升了长提示词、系统提示词或已有上下文的预填充速度。
你可以通过以下方式启动 ComfyUI: --use-ck-attention 以启用 Comfy-Kitchen attention。
自适应树 MTP
在 ComfyUI v0.40.0 中,MTP 草稿最初仅限于单条 token 猜测链,对应单次猜测接下来 2 到 5 个 token 会是什么。该链会先草拟一个 token,将其反馈给模型,然后再草拟下一个 token,直至达到为 MTP 设定的深度值。默认情况下,将 MTP 设为 auto 后,它会根据采样模式或临时成功率测量结果自适应地给出 2 到 5 个 token。这种链式方法的弱点在于,它把所有赌注都押在这单次猜测上,而且一旦出错,链上后续的每一次猜测都可能作废。如果 MTP 头在深度 1 的首选猜测错误,那么即使深度 1 的次优猜测是正确的,整个步骤也只能产出一个 token。
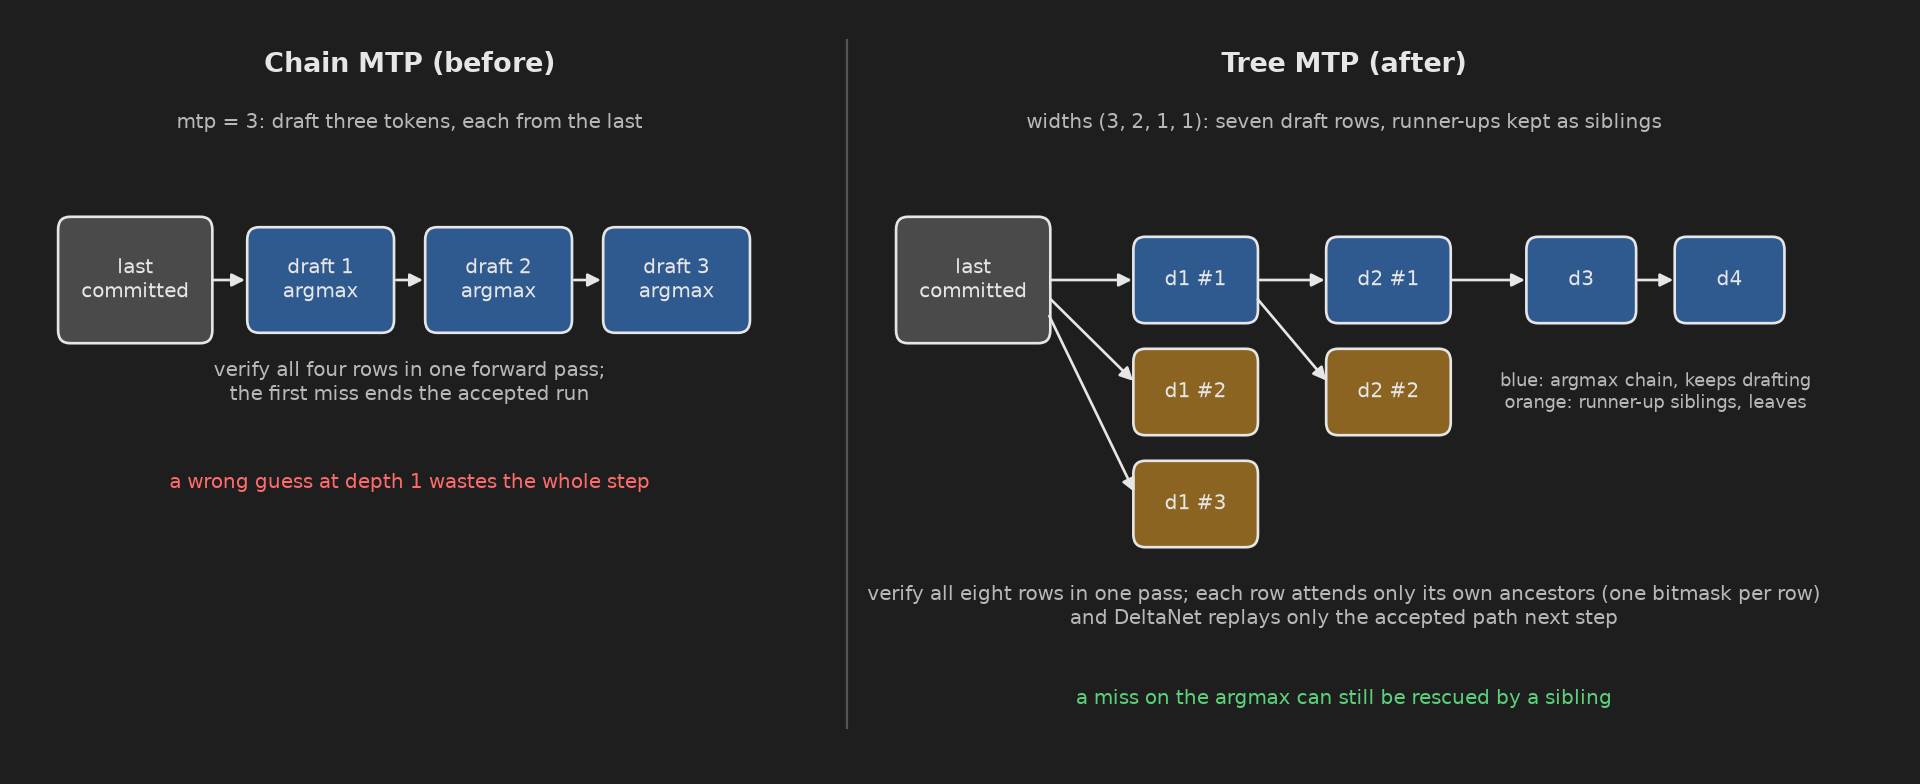
链式 MTP 只草拟一条路径。树式 MTP 在每一层保留次优 token 作为兄弟节点,在一次遍历中验证整棵树,并根据实际命中情况重新规划树的形状。
为避免链中这一潜在缺陷,另一种方法是使用自适应树算法。在每一层,MTP 头的首选猜测像之前一样以每次草拟的最佳猜测延续主链,但少量次优猜测会作为兄弟候选保留下来,供后续 MTP 验证使用。这就形成了一个小型草稿树结构,其中这些额外的候选叶子会被验证,但不会从它们继续草拟。理论上,在任何深度树结构中,你都可以草拟任意数量的猜测,只是每增加一个猜测的收益会递减;不过我们的线性内核可以“免费”计算最多 M=8 个猜测。这将猜测数量上限设为七个(M=8-1)以匹配我们的计算内核和硬件。验证阶段现在最多承载八行;已提交的 token 加上七个草稿 token,同时必须将每一个都视为若干条可能的分支未来。
提示词和输出的文本类型决定了树应当采用何种形状。可预测的输出,例如代码、列表,或重复提示词的描述,有利于深度,即长链会被整体接受。创意写作有利于广度:首选往往错误,但正确的 token 通常在前三名之内。自适应 MTP 会持续测量,因此当设为自动模式时,MTP 会边运行边持续测量并重新规划。它按草稿层级维护一个指数衰减计数,记录被接受的 token 处于哪个排名——是第一选择、第二、第三……还是都没有——并用 CUDA 事件对草稿阶段和验证阶段计时。每 32 步,它会对将七行草稿排布为宽度链的全部 64 种方式进行评分,根据条件命中概率估算每步预期接受的 token 数,再除以实测成本, verify_ms + depth × draft_ms。只有当胜出方案至少好 3% 时它才会切换,以确保形状不会来回震荡;并且由于每种形状都使用相同的八行,为这一步捕获的 CUDA 图在切换后仍可继续工作。
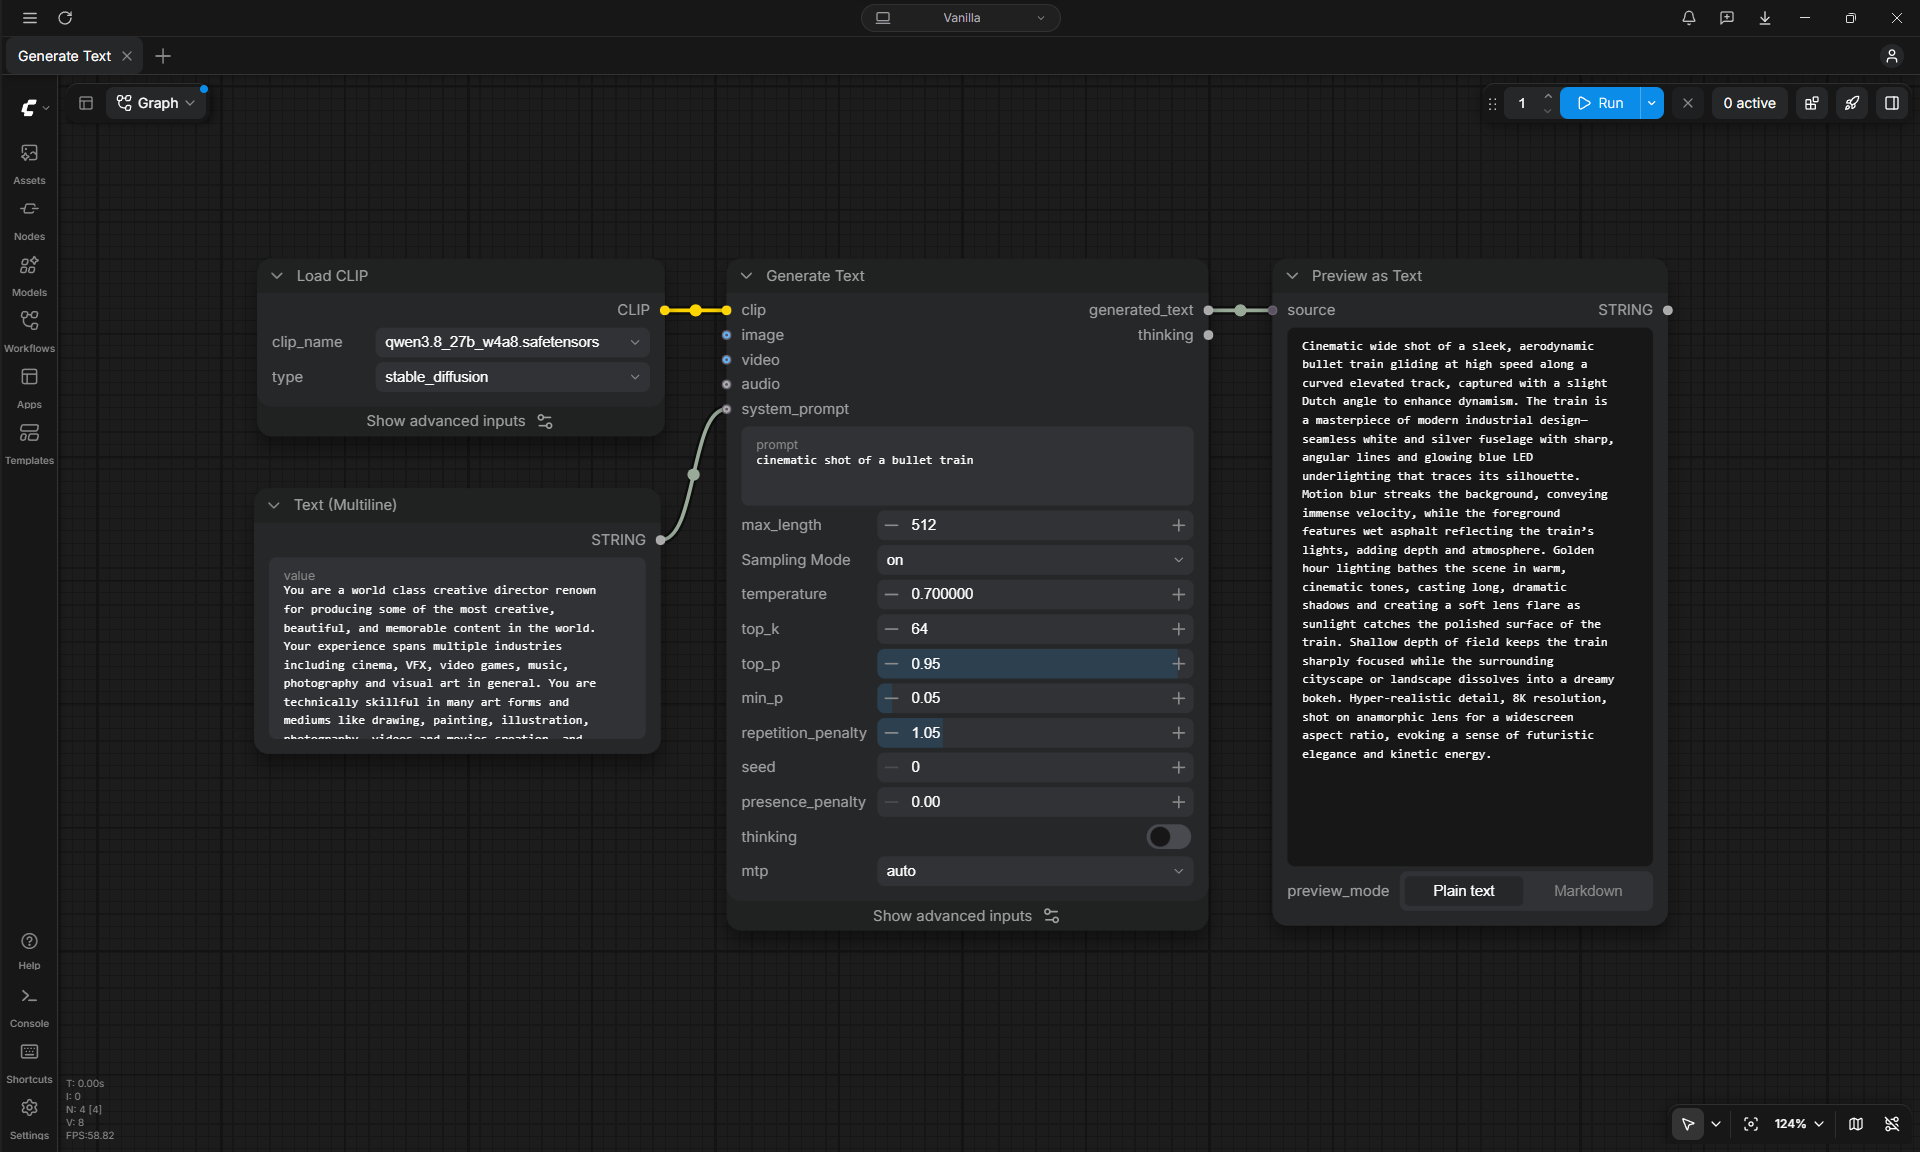
当 MTP 值在 auto 生成文本 节点中设为 时,可以使用自适应树 MTP。
总结
在 ComfyUI v0.40.0 与 v0.45.0 之间,ComfyUI 中的 Qwen3.x 文本生成在相同硬件上显著提速。过去会耗尽显存的更长上下文现在可以顺利容纳,推测解码器现在会根据正在书写的文本自行调整形状。这些改进在 NVIDIA 和 AMD、Windows 和 Linux 上均生效,除保持 ComfyUI 为最新版本外,无需你采取额外步骤。