 AI 热点
人工智能
Amazon SageMaker JumpStart 模型排行榜简介Amazon SageMaker JumpStart 提供数百种可快速部署的开放权重基础模型。丰富的选择带来了强大能力,但也引出了一个现实问题:应该从哪个模型入手?比较模型通常意味着逐一阅读模型卡片,并费力查找不同来源在不同条件下发布的基准测试分数。即便如此,您仍然需要猜测每个模型在您的使用场景中表现如何,以及成本是多少。
今天,我们推出了 Amazon SageMaker JumpStart 模型排行榜,这是一种直接在 Amazon SageMaker Studio 中并排比较 JumpStart 模型 质量、速度和成本的新方式。本文将介绍排行榜展示的内容,以通俗语言定义关键术语,并说明如何从候选模型名单着手,最终完成模型部署。
什么是 JumpStart 模型排行榜?
该排行榜是 SageMaker Studio 中 JumpStart 基础模型页面的一个新视图,紧邻“类别”和“所有模型”视图。它使用您已经熟悉的搜索栏和筛选器,打开后会直接显示大型语言模型(LLM)排行榜。您无需先回答设置问题,就能立即看到排名。对于每个模型,排行榜会显示两类信息:
- 质量分数 ,来自三项公开基准测试(BIG-Bench Hard、GPQA Diamond 和 MMLU-Pro)。这些测试由 AWS 自行运行,并对每个模型采用相同的评测设置,因此分数可以相互比较。
- 性能和成本指标 ,由 AWS 向使用每种 JumpStart 部署配置的端点发送标准化测试工作负载进行测量,让您了解模型的响应速度和运行成本。
由于这两类数据均来自相同来源并采用相同方法,您可以进行同类比较,而不必拼凑来自不同网站的数据。排行榜上线时涵盖了来自 Meta、Google、Qwen、IBM 和 Arcee 等提供方的 70 多个模型 ,未来还会陆续加入更多模型。
以下屏幕截图展示了 SageMaker Studio 中的排行榜,其中包含每个模型的基准测试分数、性能指标和预估成本。
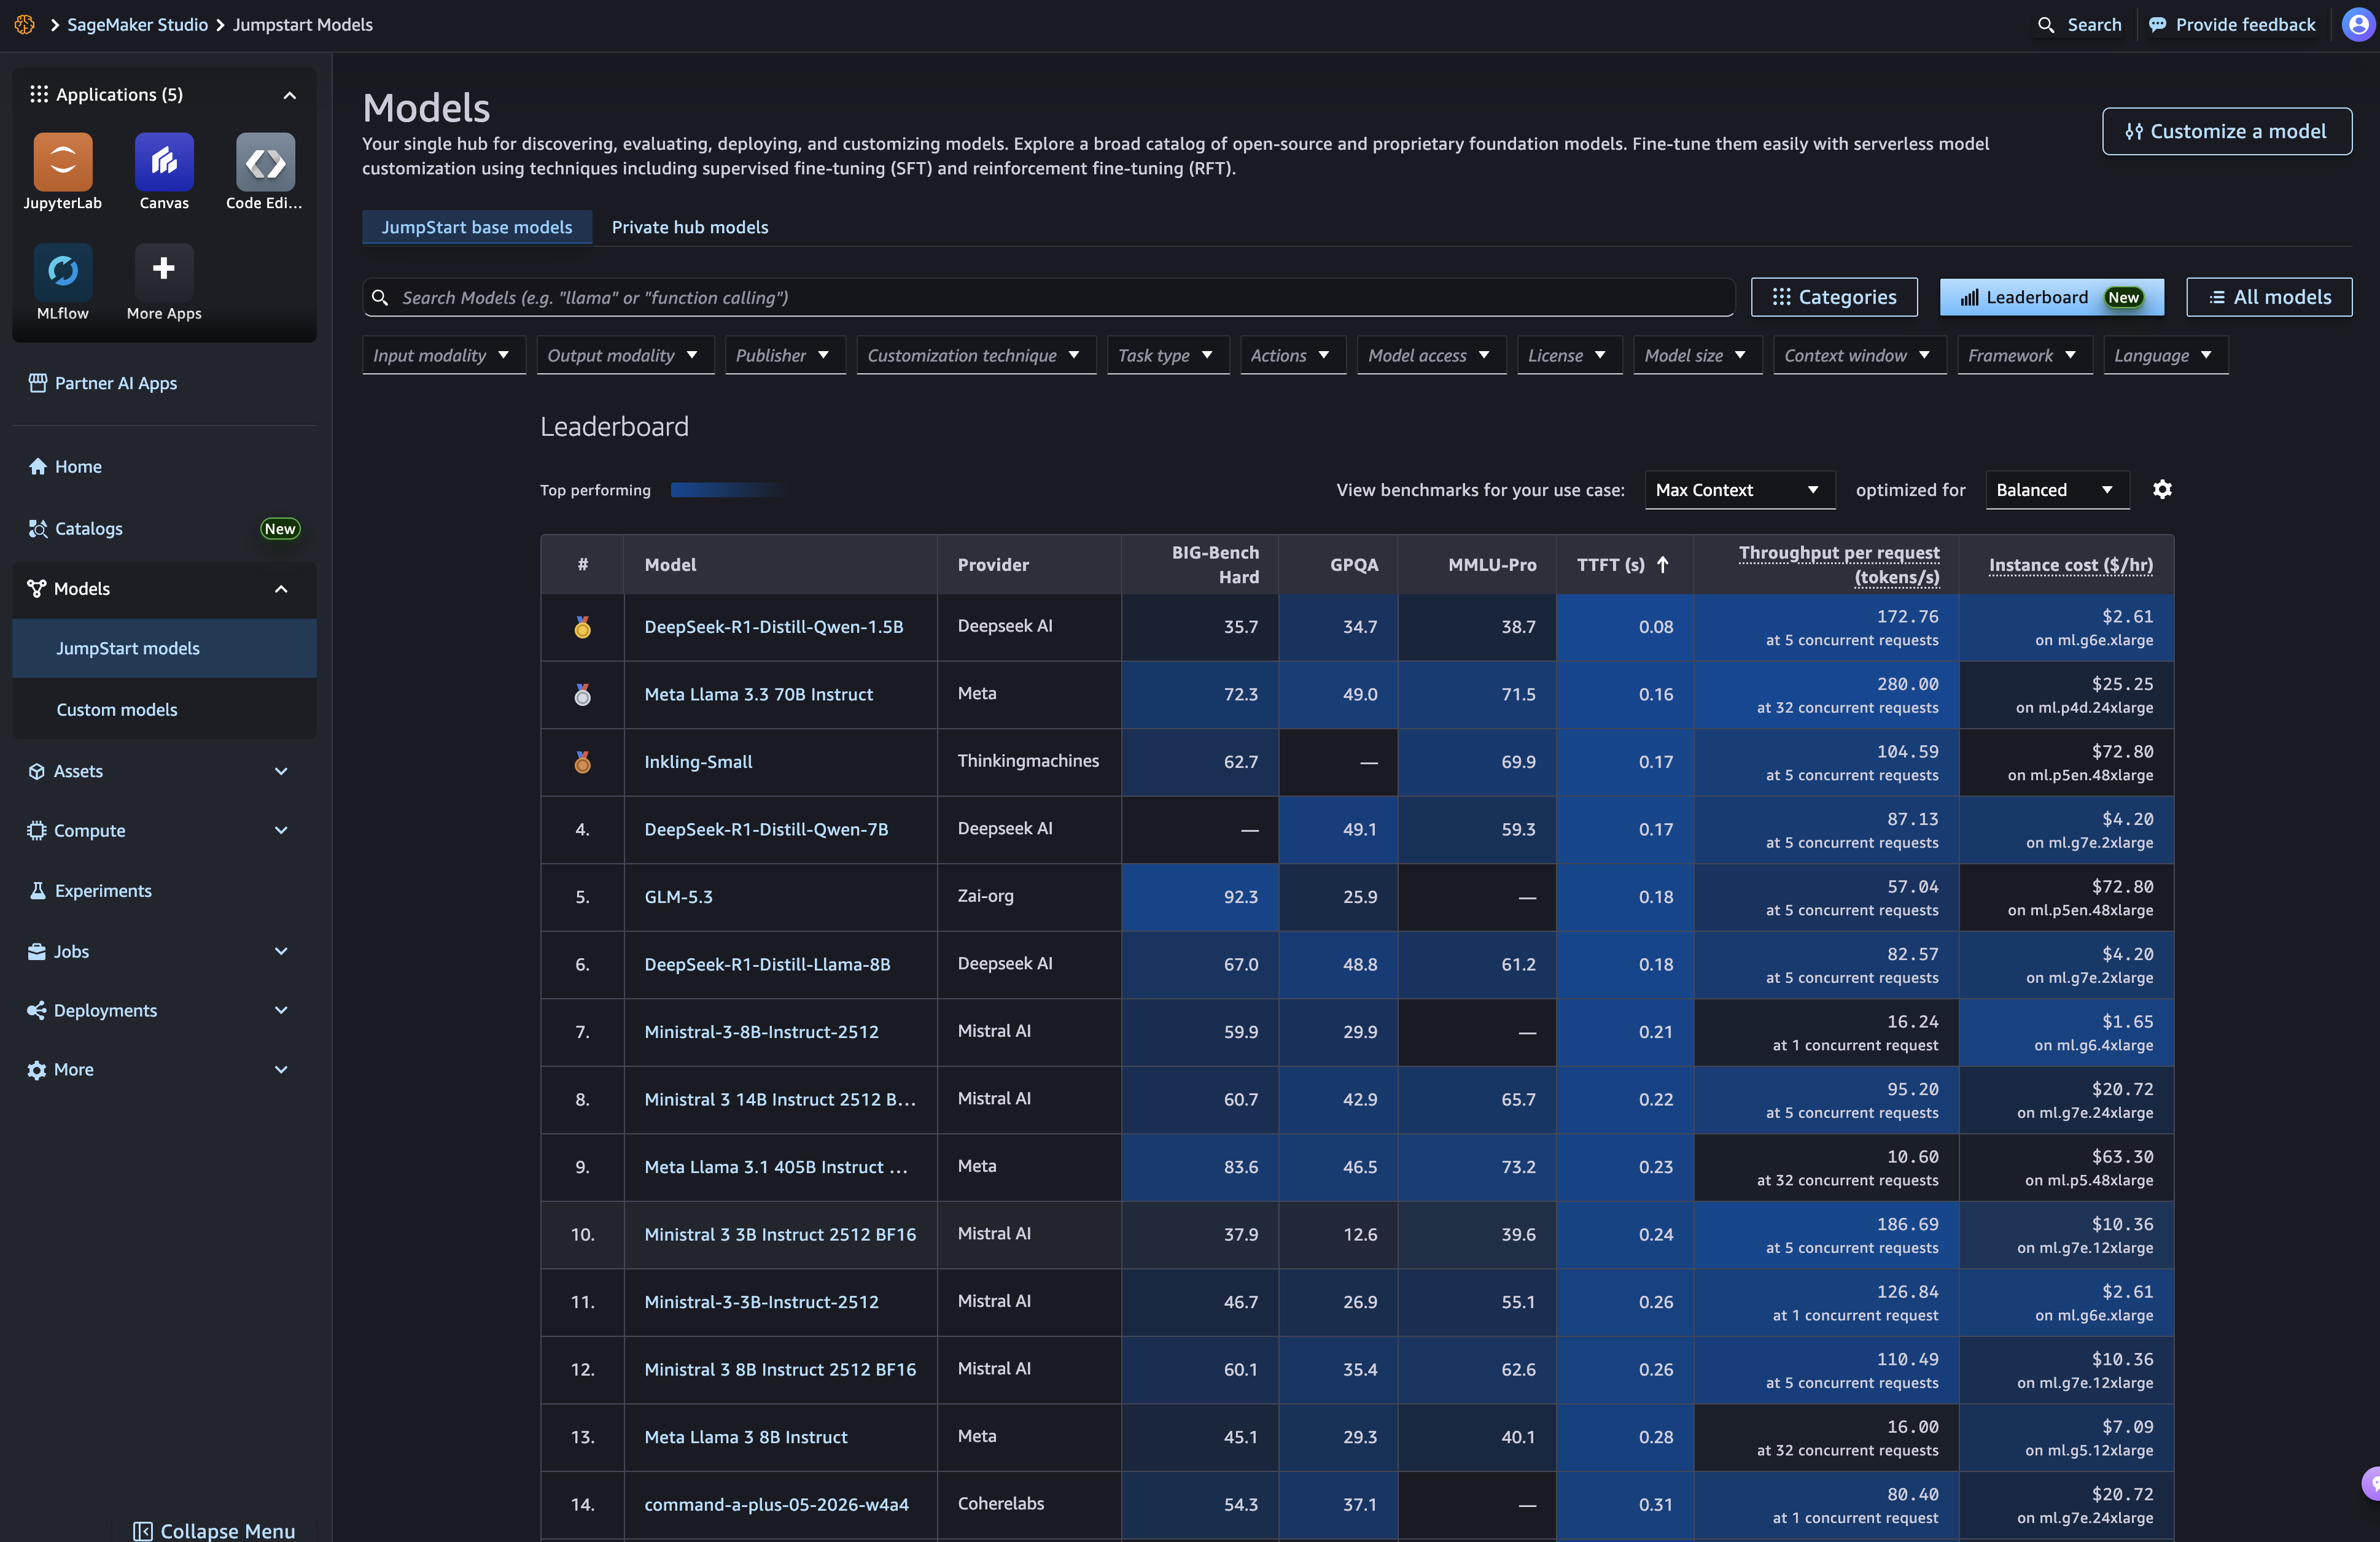
图 1:SageMaker Studio 中的排行榜概览
关键概念
本节将定义排行榜使用的术语,包括质量基准测试、影响性能数据的使用场景配置和优化目标,以及各项性能指标。
质量基准测试
基准测试是一种标准化测试,即一组固定且答案已知的问题。让每个模型完成同一项测试,就能得到可供比较的分数。排行榜上线时会报告针对 LLM 的三项推理基准测试:
| 基准测试 | 通俗来说,它衡量什么 |
| BIG-Bench Hard(BBH) | 一组需要多步推理的高难度任务,例如逻辑推演、对象追踪和多步算术运算。 |
| GPQA Diamond | 研究生水平的科学问题,难以通过搜索网络找到答案,是衡量深度推理能力的良好指标。 |
| MMLU-Pro | 使用难度更高的选择题,衡量科学、法律和工程等众多学科领域的广泛知识和推理能力。 |
这三项测试均为分数越高越好。排行榜会分别显示各项基准测试的结果,而不是将其合并为一个分数。这种方式可以保持结果透明:您可以根据自己的应用权衡各项基准测试的重要性,并依据基准测试的公开定义核查每项分数。
使用场景配置和优化目标
速度和成本取决于您的工作负载以及模型的部署方式。排行榜上方的两个菜单控制您看到的性能和成本数据:
- 使用场景配置。 从“查看您的使用场景对应的基准测试”菜单中,选择最接近您工作负载的配置。默认选项是“最大上下文”。使用场景配置只会改变性能和成本指标;所有配置的质量基准测试分数都相同。
- 优化目标。 对于每种使用场景配置,一个模型可能有多种部署配置,而排行榜每次只显示其中一种配置的指标。您可以通过“优化目标”菜单选择配置,默认选项是“均衡”。
每种优化目标对应不同的配置:
| 优化目标 | 显示的配置 |
| 均衡 | 每个词元预估成本最低的配置。由于每个词元的成本同时取决于实例价格和吞吐量,因此该配置会在每小时费用与实例生成词元的速度之间取得平衡。 |
| 成本优化 | 每小时实例价格最低的配置。与其他优化目标相比,其延迟可能更高,吞吐量也可能更低。 |
| 延迟优化 | 首个词元生成时间最短的配置。 |
| 吞吐量优化 | 吞吐量最高的配置。这些配置可能会使用推测解码。 |
性能指标
| 指标 | 它能告诉您什么 |
| 首个词元生成时间(TTFT) | 用户需要等待多久,模型才开始响应。该数值越低越好,对聊天场景尤其重要。 |
| 单请求吞吐量(词元/秒) | 模型每秒生成多少个词元。该数值越高越好,对批处理和高流量工作负载尤其重要。 |
| 实例成本(美元/小时) | 使用指定实例类型时的预估每小时成本。 |
关于成本的说明: 预估成本仅反映 SageMaker 实例成本,依据相应配置默认实例类型的按需每小时费率计算。它不包括数据传输、存储、推理组件成本,也不包括预留实例或 AWS Savings Plans 等折扣。您的实际账单金额可能有所不同。请使用 AWS 定价计算器 估算账单费用。
我们的基准测试方法
公开的基准测试分数通常来自不同团队,而这些团队使用的提示词、设置和硬件各不相同,因此很难进行比较。我们采用了另一种方法:
- 所有模型采用同一种方法。 AWS 使用相同的评测框架和设置,对排行榜中的所有模型运行各项基准测试。
- 在 SageMaker 上测量。 性能和成本数据来自将标准化测试工作负载发送到使用每种 JumpStart 部署配置所部署的端点,这些配置与您可以启动的配置相同。
有关提示词、生成设置以及配置测量方式等完整详情,请参阅 JumpStart 排行榜方法论.
操作演练:查找模型
以下步骤说明如何从浏览模型开始,最终完成模型部署。您需要拥有 SageMaker Studio 的访问权限以及部署 JumpStart 模型的权限。
第 1 步:打开排行榜
在 SageMaker Studio 中打开“模型”页面,然后选择“排行榜”视图。排行榜沿用其他视图中的搜索栏和筛选条件,并拥有自己的 URL。您可以将其加入书签,也可以与团队共享直接链接。
以下屏幕截图显示了已选择“排行榜”视图的“模型”页面。
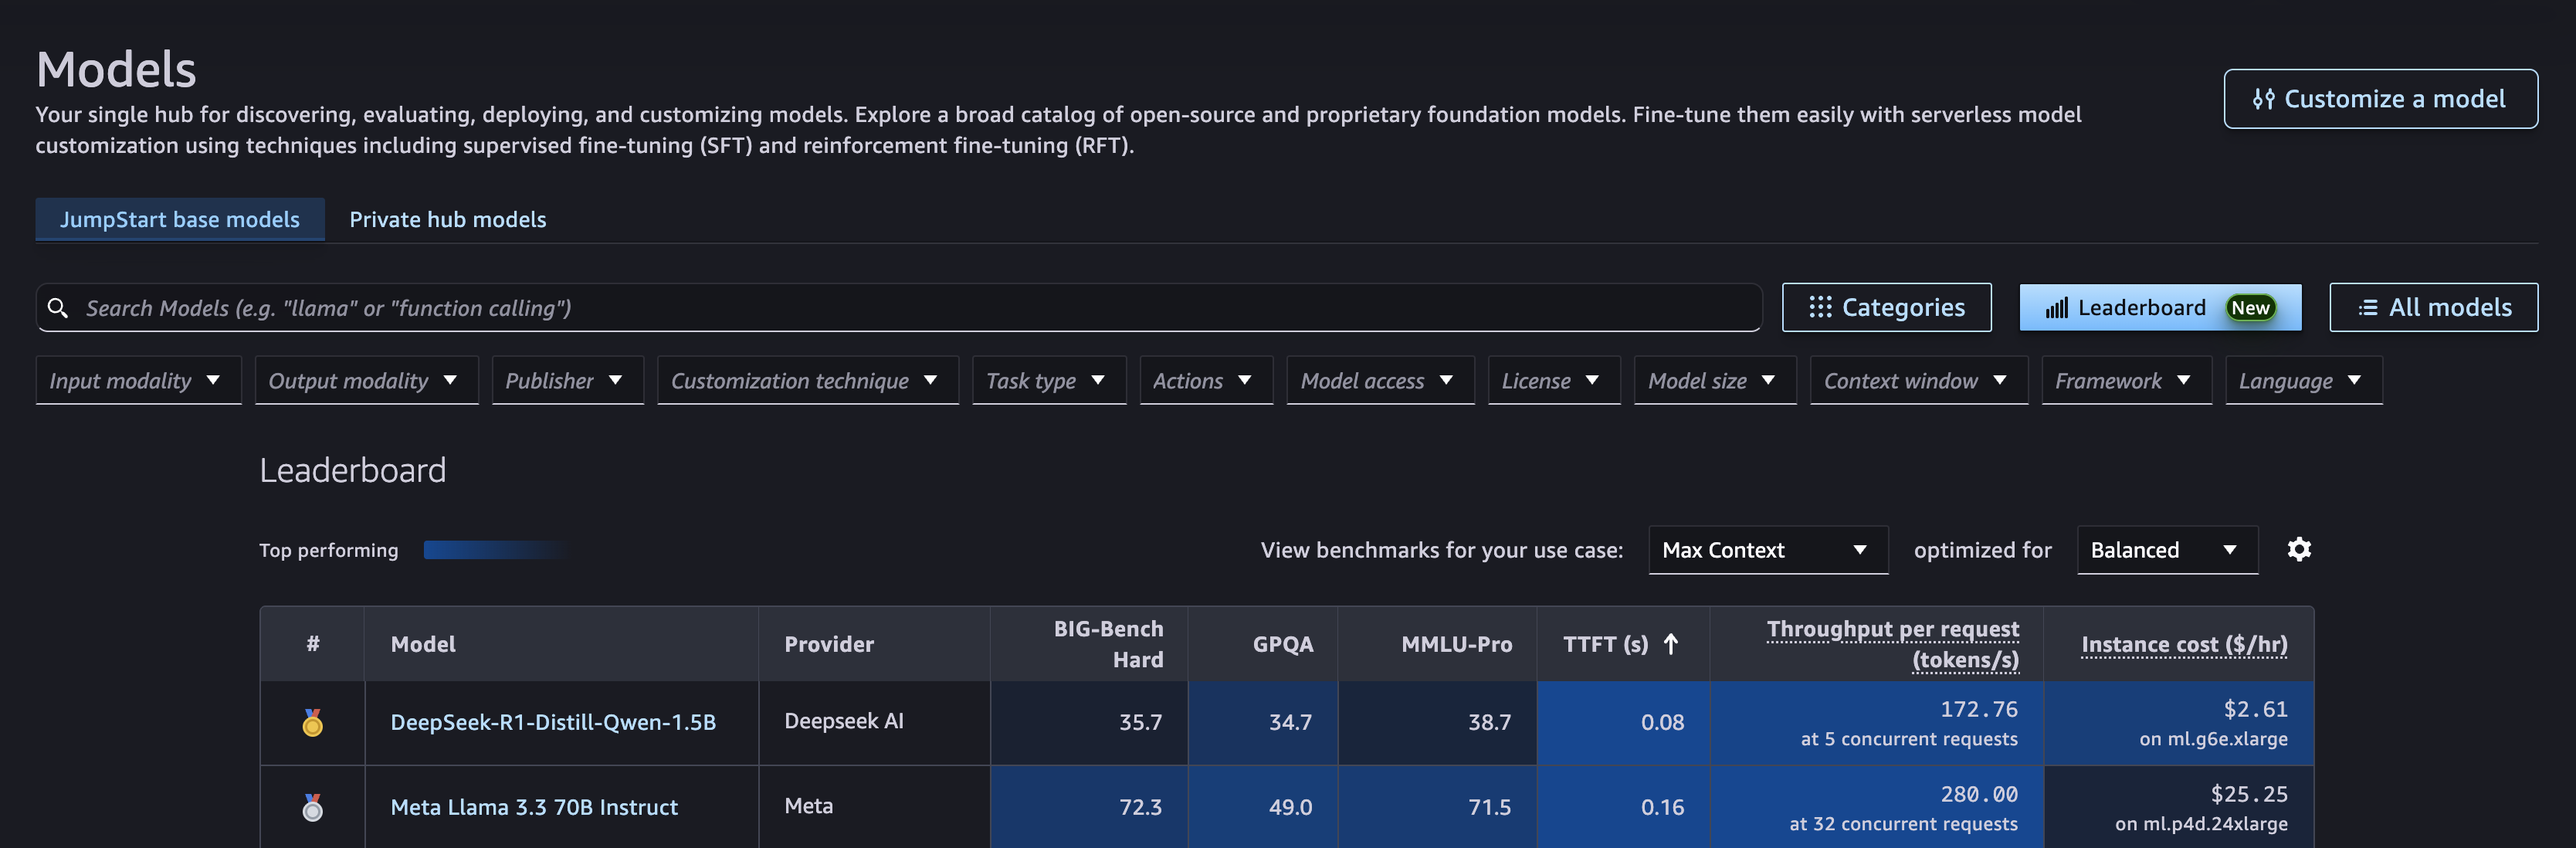
图 2:已选择“排行榜”视图的 JumpStart 基础模型页面
第 2 步:使用筛选条件缩小列表范围
使用您在 JumpStart 其他位置已使用的相同搜索和筛选功能,只保留符合要求的模型。常用筛选条件包括许可证、提供方以及输入和输出模态。在查看分数之前,先从硬性要求入手,例如允许商业用途的许可证。
以下屏幕截图显示了按输入模态、输出模态和许可证筛选后的排行榜。
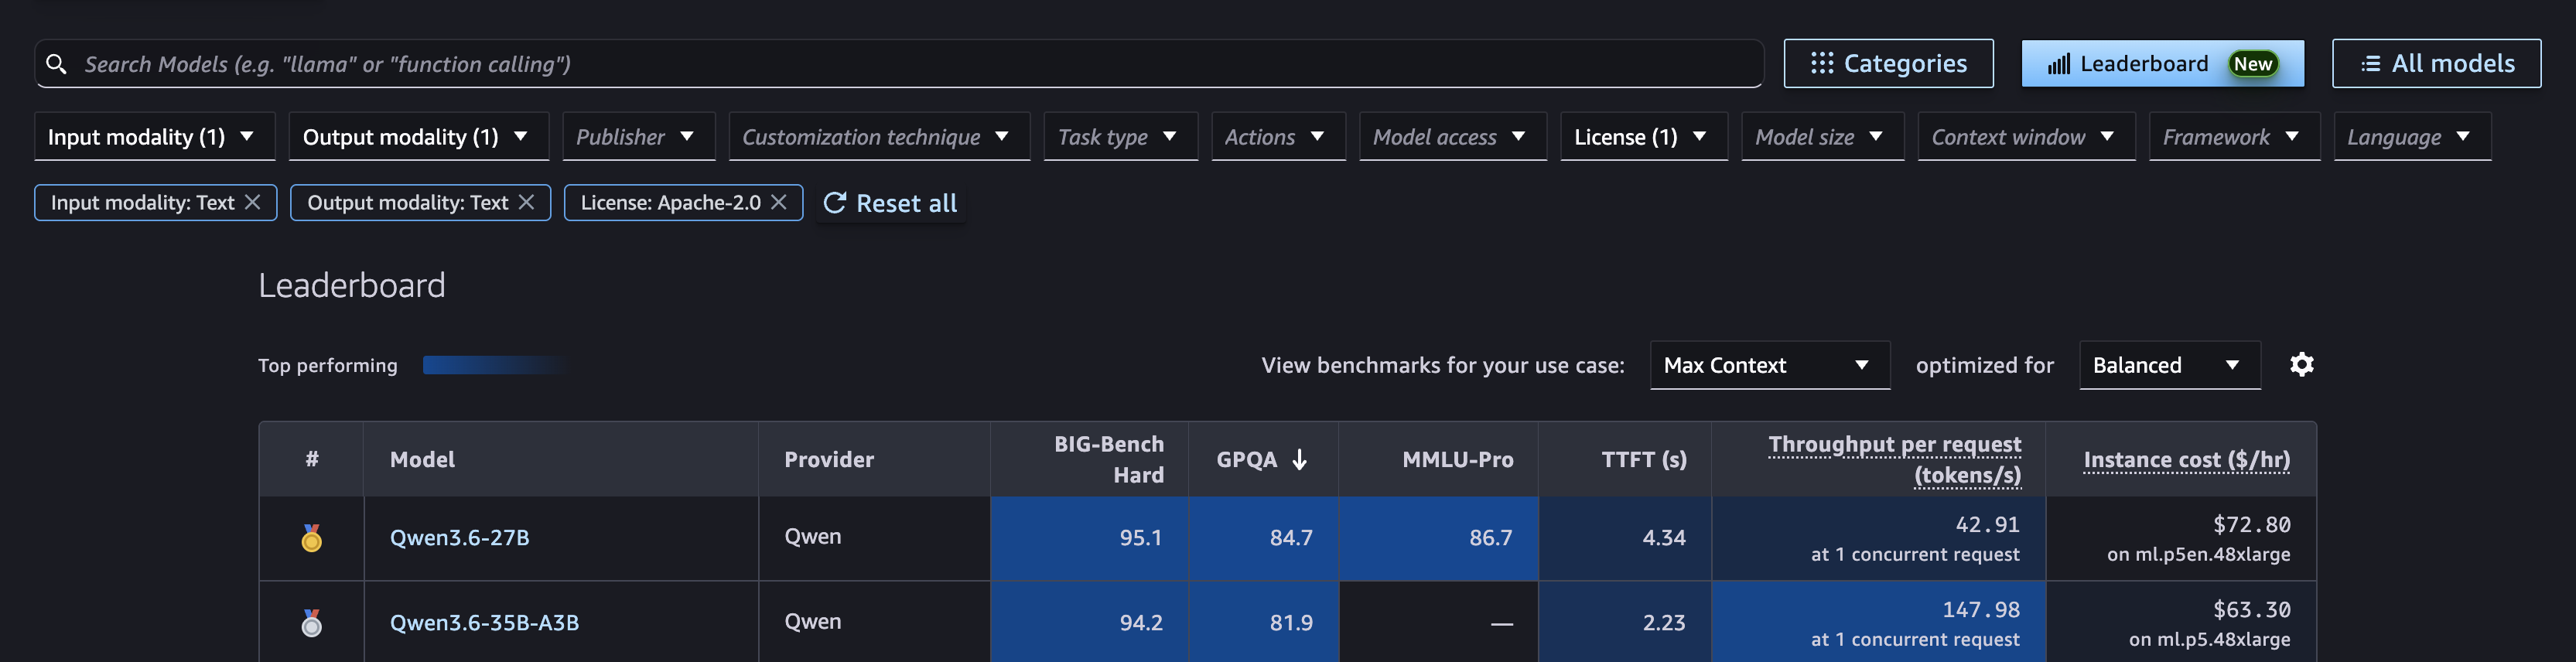
图 3:应用筛选条件后的排行榜
第 3 步:选择使用场景配置文件和优化目标
在排行榜上方的“查看适合您的使用场景的基准测试”菜单中,选择最接近您工作负载的配置文件(默认值:最大上下文)。然后从“优化目标”菜单中选择一个目标(默认值:均衡)。对于与客户交互的聊天机器人,“延迟优化”是合理的起点。对于夜间文档处理,“吞吐量优化”或“成本优化”可能更合适。性能和成本列会随之更新,而质量分数保持不变。
以下屏幕截图显示了排行榜上方的“查看适合您的使用场景的基准测试”和“优化目标”菜单。
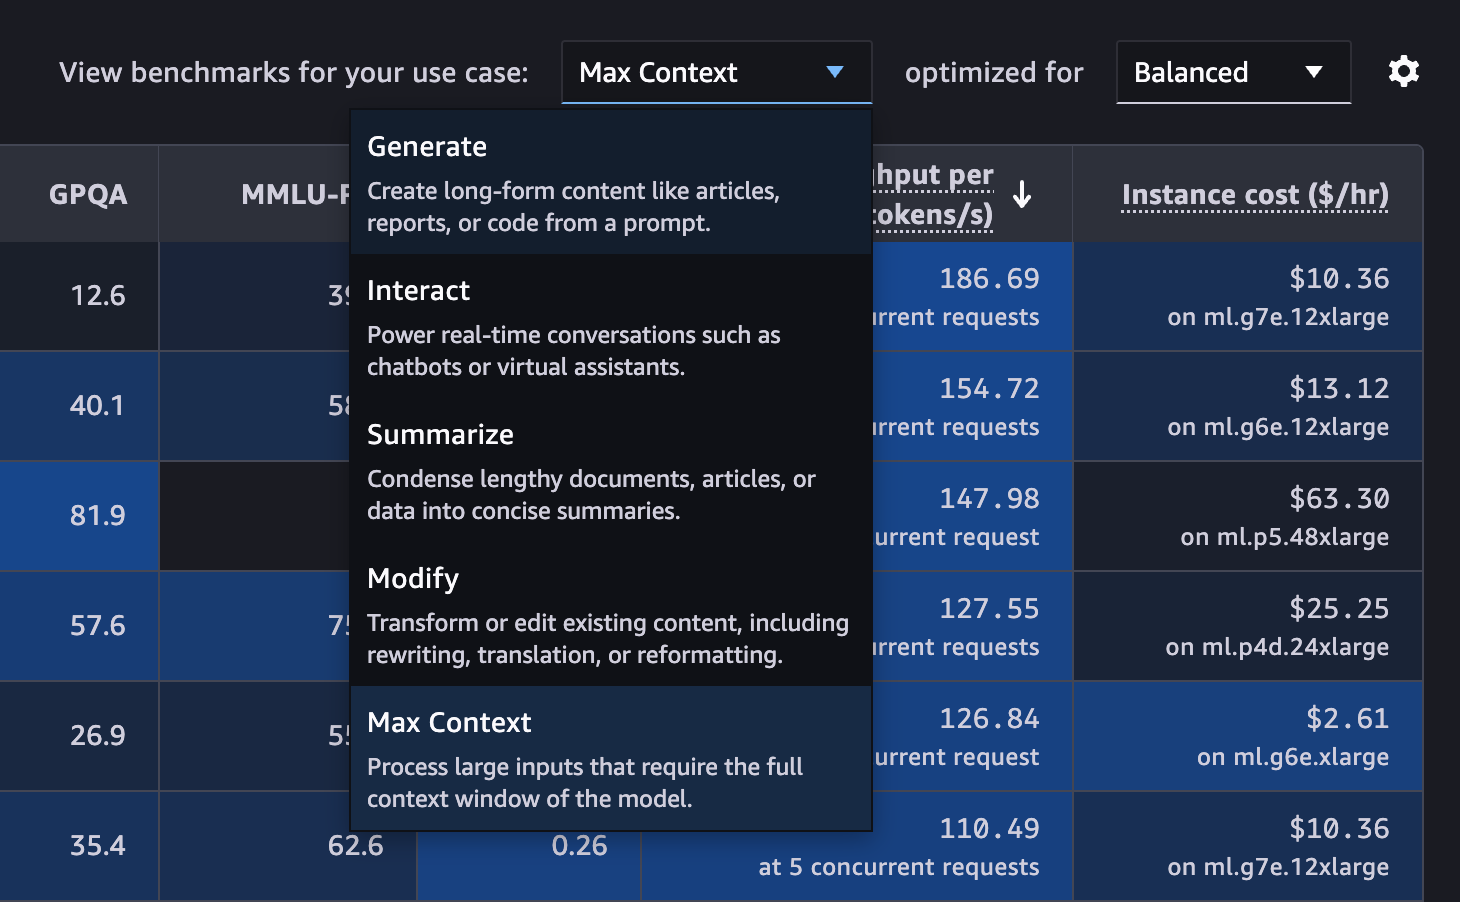
图 4:“查看适合您的使用场景的基准测试”菜单
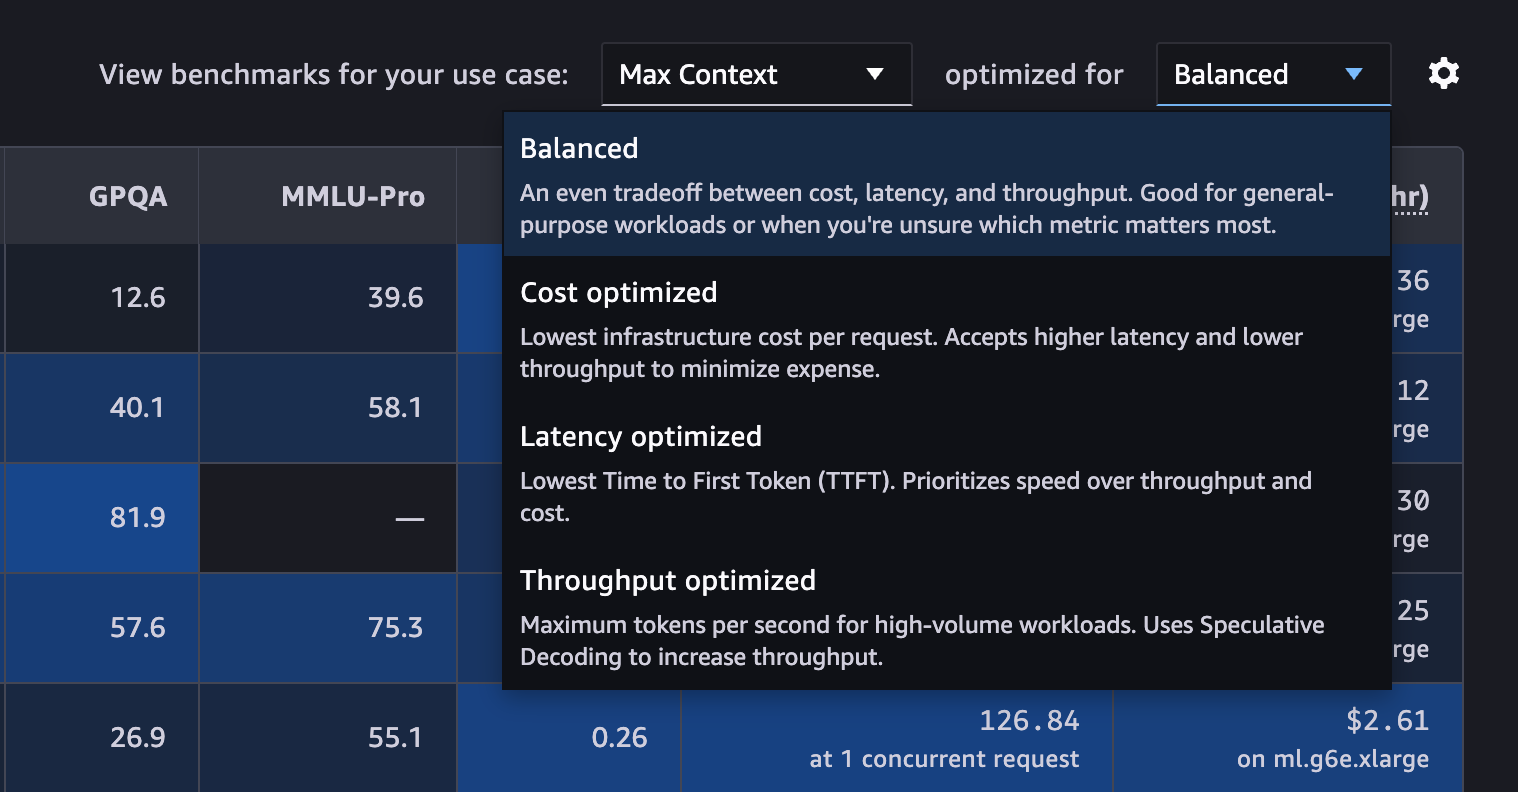
图 5:“优化目标”菜单
第 4 步:查看热力图并自定义列
每一列都有蓝色热力图,因此表现最佳的模型一目了然:蓝色越深,该列中的结果越好。您可以按任意基准测试列排序,根据最关注的指标对模型进行排名。使用列设置(齿轮图标)隐藏不需要的指标,并水平滚动查看更多内容。滚动时,模型名称列会保持冻结;当还有更多列可供查看时,边缘会显示渐隐效果。
以下屏幕截图显示了热力图和列设置菜单。
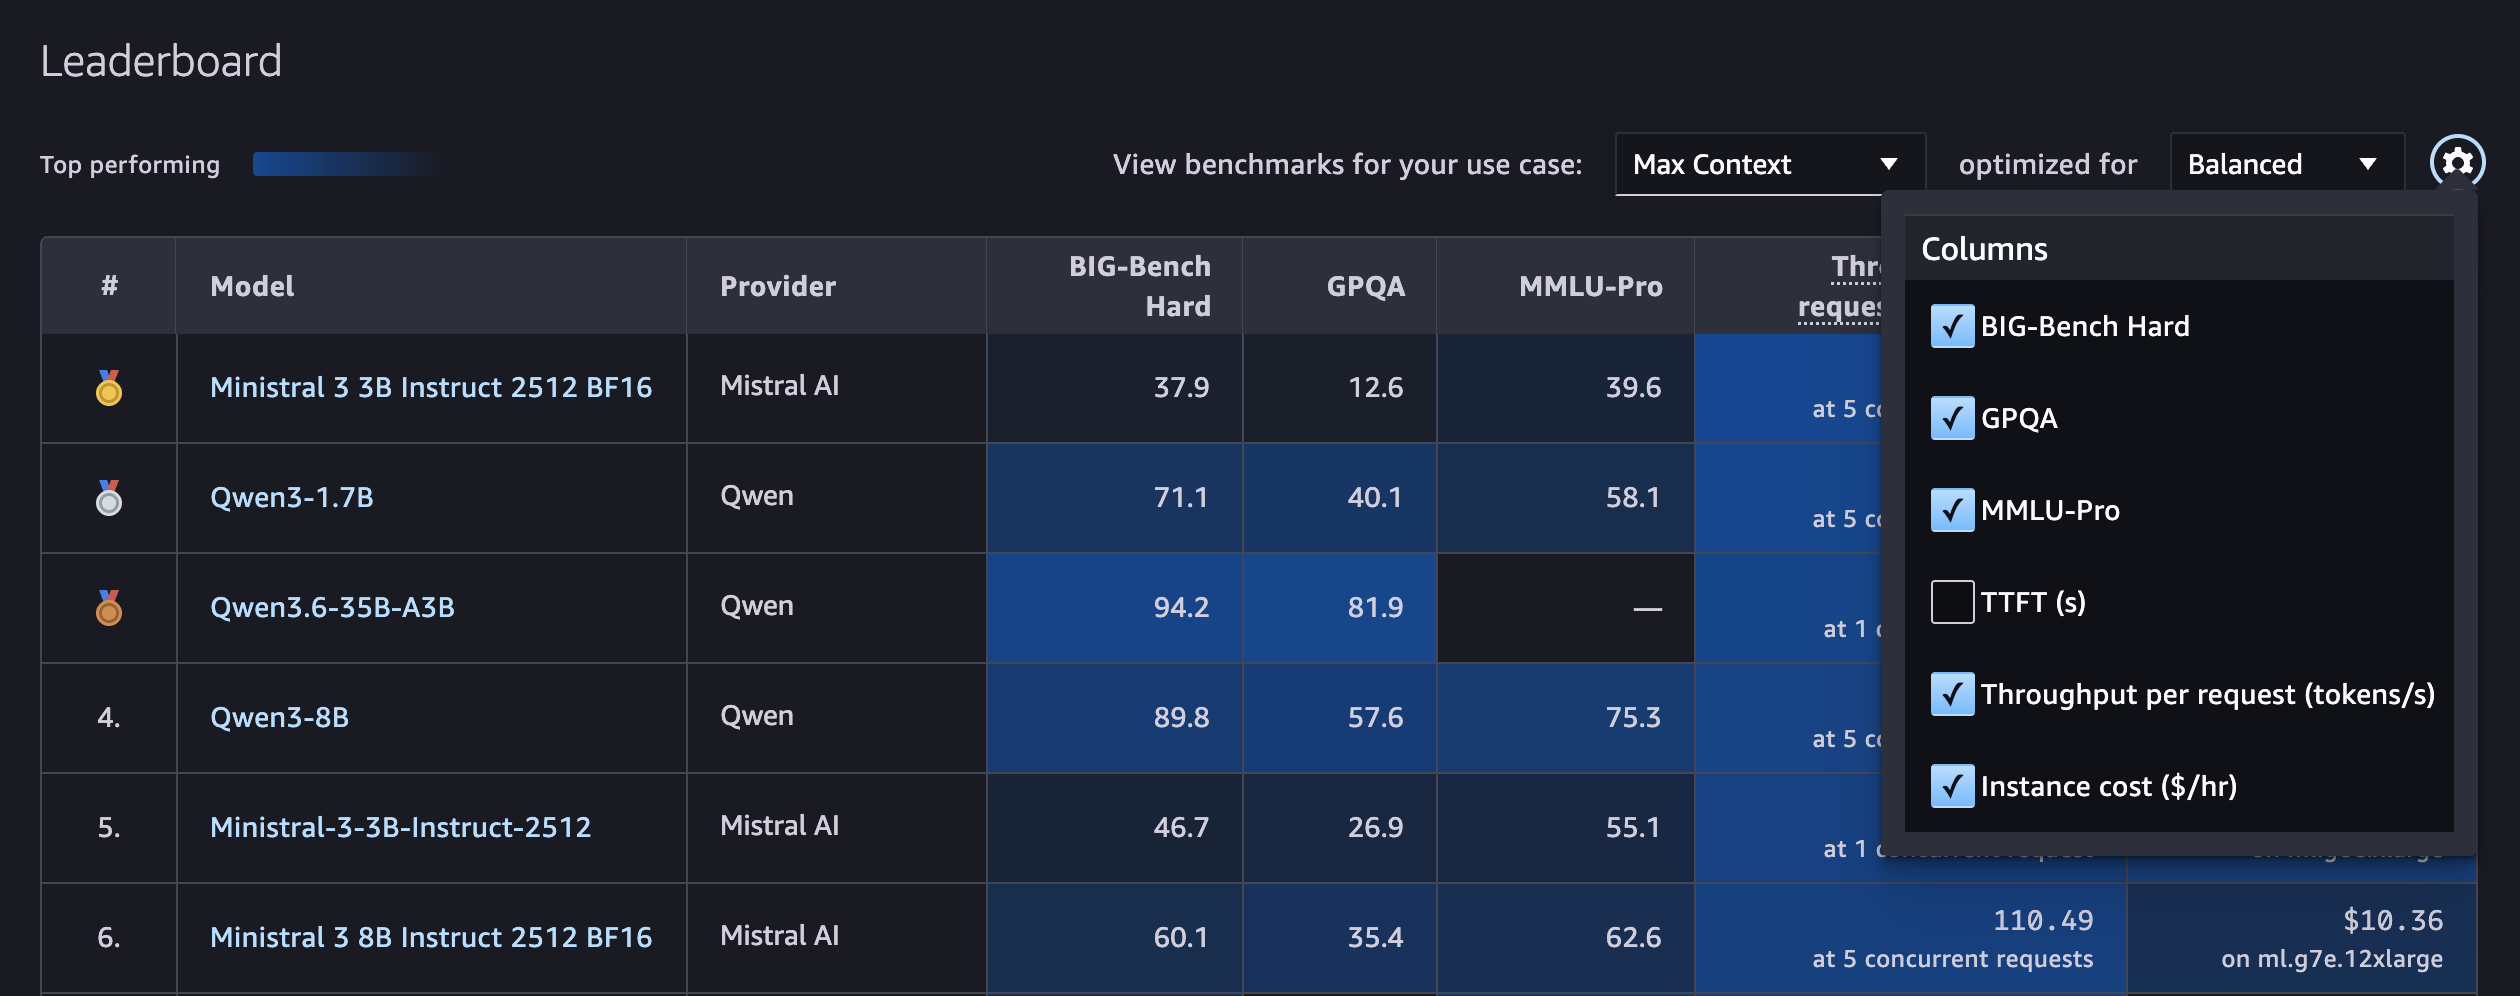
图 6:热力图和列设置
第 5 步:部署或定制模型
选择一个模型以打开其页面。您可以在其中部署模型;对于支持无服务器定制的模型,还可以对其进行定制。如果选择部署,请使用您在排行榜上进行比较时所选的相同使用场景和优化目标。每项指标仅适用于其测量时采用的配置,使用其他配置可能会改变质量、延迟、吞吐量和成本。
以下屏幕截图显示了包含“部署”和“定制”选项的模型页面。
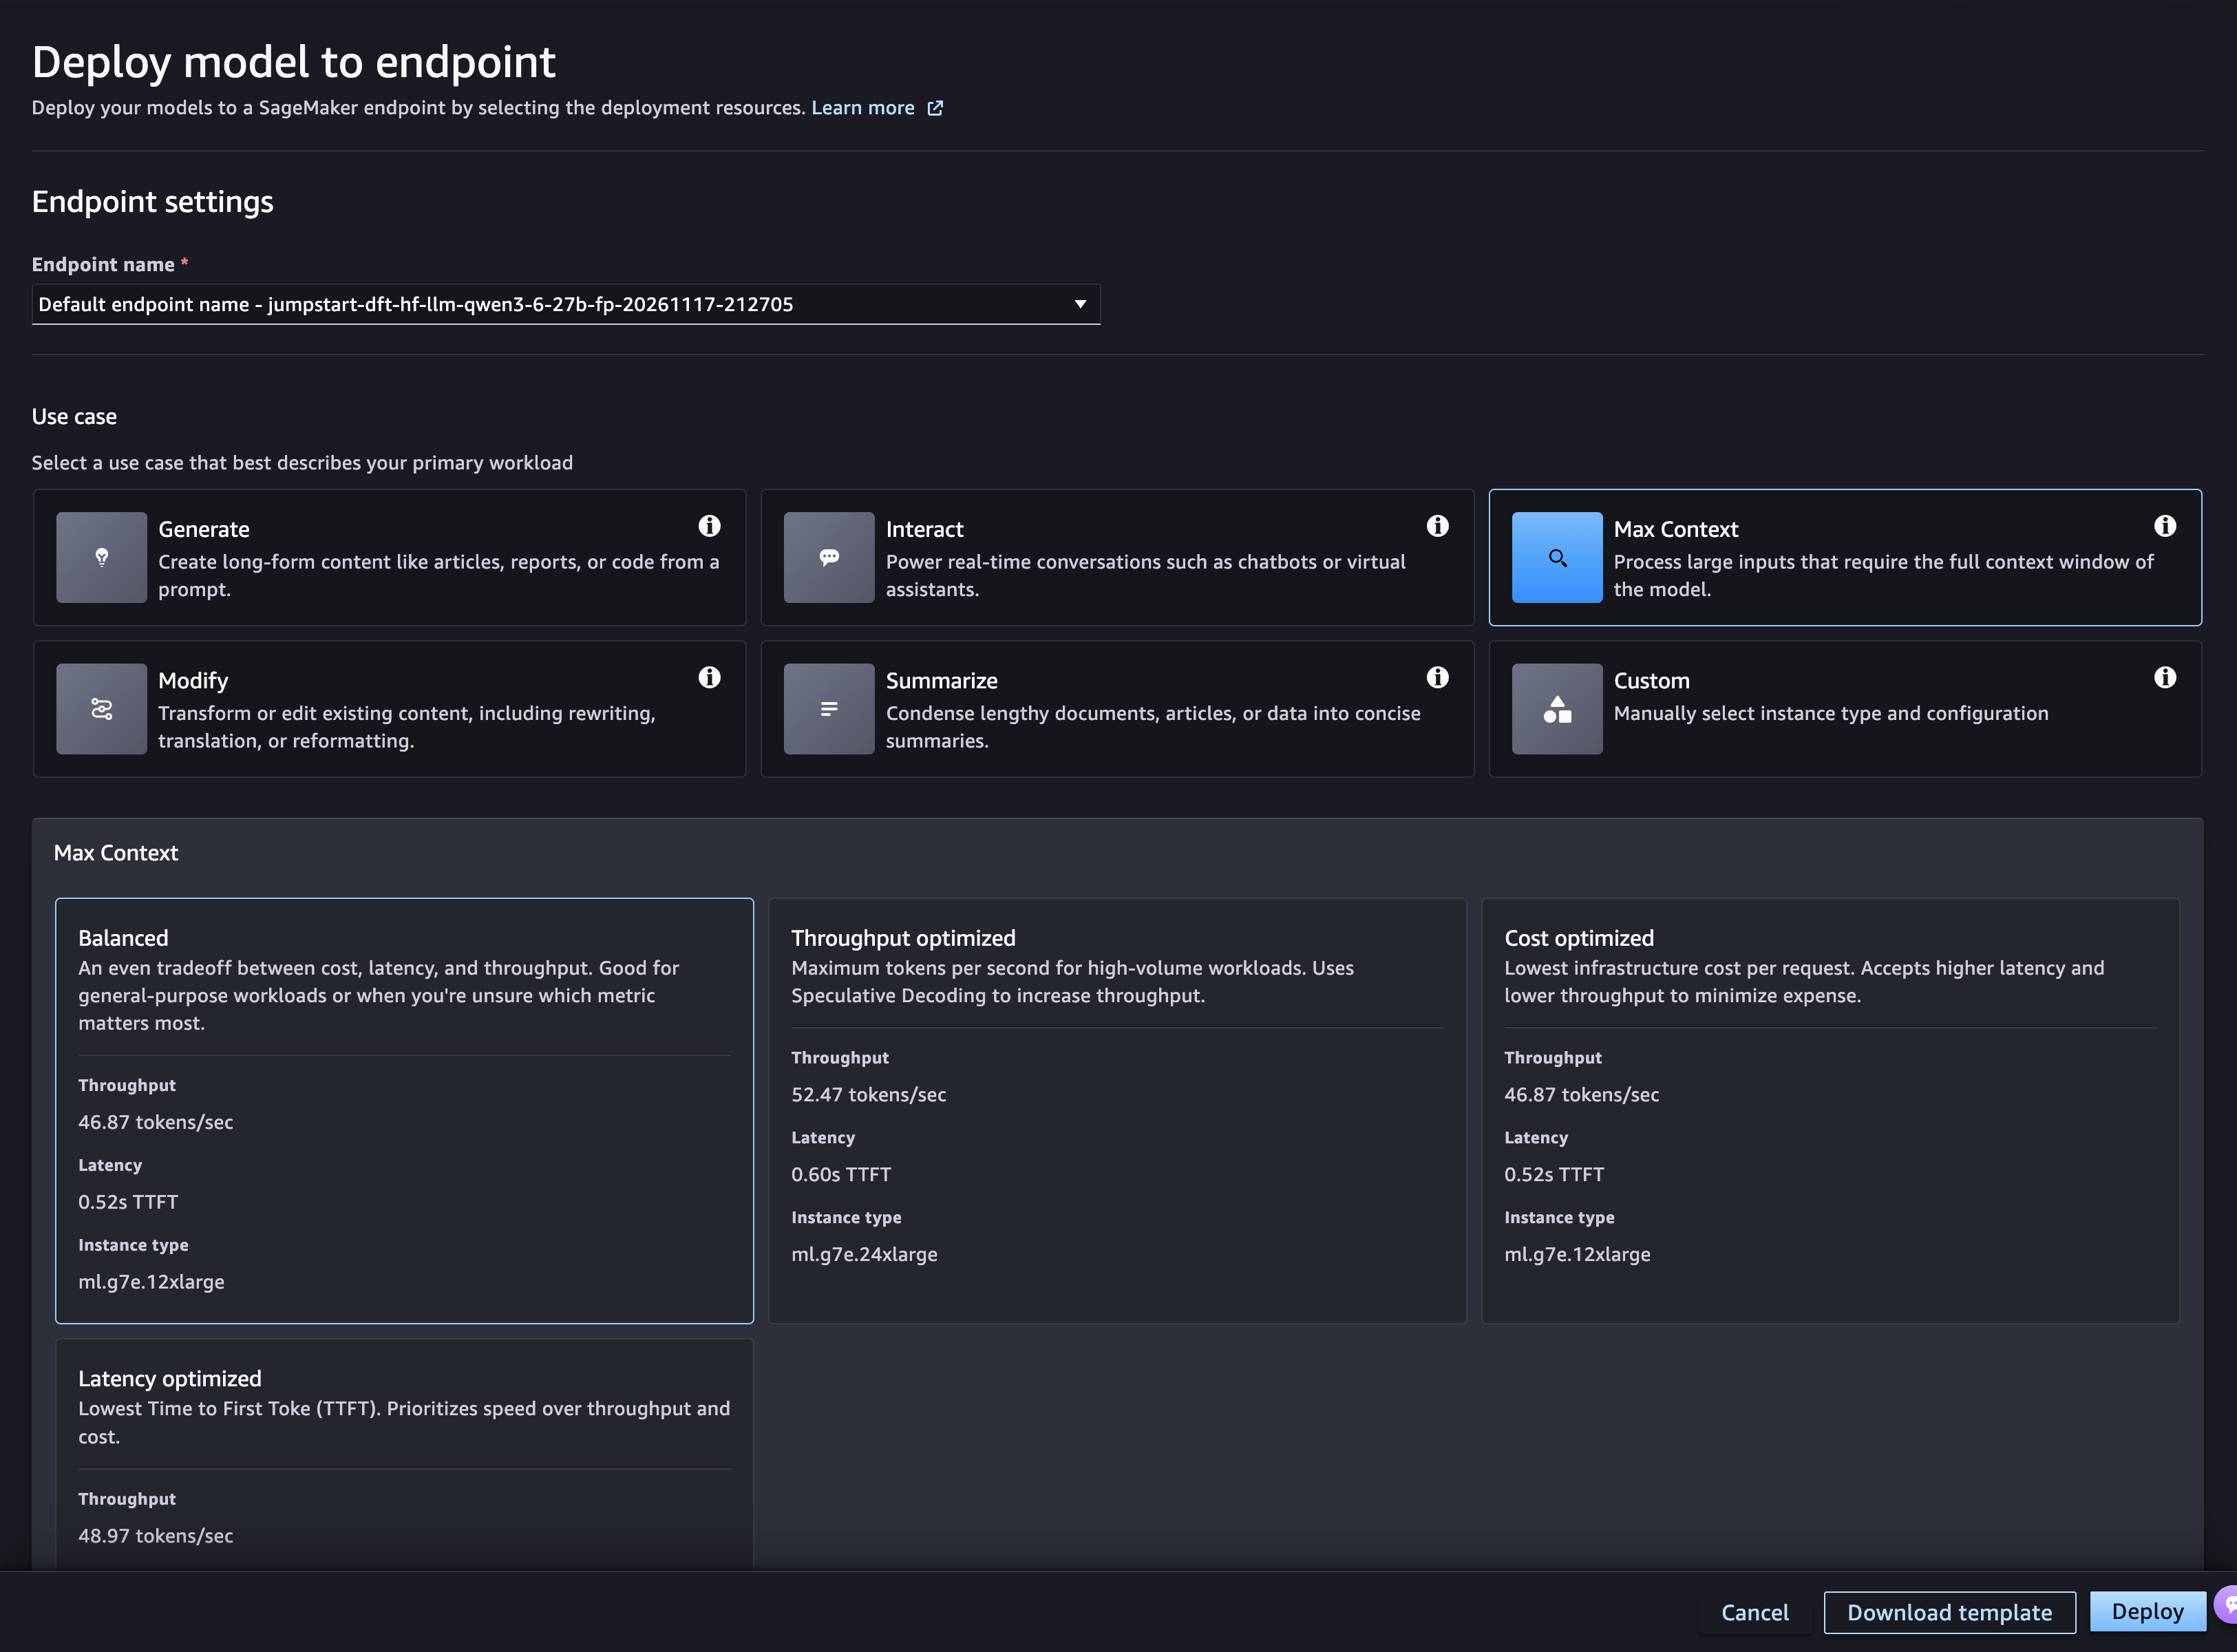
图 7:包含“部署”和“定制”选项的模型页面
示例:为聊天助手选择模型
假设您正在构建一个内部服务台助手。员工会提出问题,并期望获得快速、准确且遵循指定回答格式的答案。您需要一个可用于商业用途的模型,并希望成本保持可预测。
按许可证进行筛选,并选择类似聊天的使用场景配置文件和“延迟优化”后,您的候选模型列表可能如下所示:
| 模型 | BBH | MMLU-Pro | TTFT(秒) | 吞吐量(词元/秒) | 实例成本(美元/小时) |
| 模型 A(大型) | 95.9 | 87.2 | 2.33 | 37 | $37.66 |
| 模型 B(中型) | 94.2 | 84.9 | 0.98 | 44 | $5.75 |
| 模型 C(小型) | 77.4 | 66.1 | 0.27 | 61 | $2.61 |
从表中可以看出,模型 A 的知识分数最高,但成本也最高,首次响应速度最慢。模型 B 的分数几乎同样出色,在多步推理方面表现稳健,并且可以在更小、更便宜的实例上运行。对于服务台而言,对问题进行推理并快速响应比通用知识分数高出最后几分更重要,因此模型 B 是更好的起点。更大的模型并不总是更好的选择,而排行榜可以让您在几秒钟内看清这种权衡。
接下来,您可以部署模型 B,使用服务台中的真实问题对其进行测试;如果模型 C 的质量能够保持,则可将其作为成本更低的备选方案。
提示和注意事项
- 使用排行榜构建候选模型列表,而不要仅凭排行榜做出最终决定。 基准测试衡量的是通用能力。在投入生产之前,务必使用您自己的数据和提示词评估排名前两到三个的模型。
- 先筛选,再排名。 许可证以及输入或输出模态等要求会决定模型是否符合条件。分数只能帮助您对筛选后剩余的模型进行排序。
- 在同一基准测试内比较模型。 每项基准测试的难度各不相同,因此一项基准测试的分数不能与另一项基准测试的分数直接比较。
- 考虑模型类型。 推理模型与非推理模型使用不同的生成参数进行评估,而推理模型的 GPQA Diamond 分数取 10 次运行的平均值。因此,两种类型之间的比较只能视为近似结果。
- 检查部署配置。 每项指标仅适用于其测量时采用的配置。请使用您计划部署的配置来比较模型。
- 将接近的分数视为并列。 微小差异可能处于正常的运行间波动范围内,并不意味着某个模型明显更好。应关注差距显著的结果。
- 覆盖范围正在扩大。 目前并非所有 JumpStart 模型都有基准测试分数,首批基准测试主要聚焦于大语言模型。没有分数并不意味着模型较弱,只是说明它尚未接受基准测试。
后续计划
我们将继续扩大排行榜的覆盖范围。目前正在探索的领域包括:
- 支持私有中心, 让使用精选 JumpStart 私有中心的组织能够查看其已批准模型的排行榜。
- 增加更多任务排行榜, 扩展到大语言模型文本生成之外的任务,例如目标检测、文本嵌入和图像理解。
- 增加更多模型和基准测试 ,因为会有新模型添加到 JumpStart。
结论
SageMaker JumpStart Model Leaderboard 将质量、速度和成本汇集在一处,并在 SageMaker 上采用一致的方法进行衡量。您无需再比较来自不同来源的数据,而是可以筛选出符合要求的模型,按照计划运行的配置对它们进行比较,并只需点击几下即可部署。
要开始使用,请在 SageMaker Studio 中打开 Models 页面,然后选择 Leaderboard 视图。要了解更多信息,请参阅以下资源:
- JumpStart 排行榜方法论.
- Amazon SageMaker JumpStart.
- SageMaker JumpStart 文档.
- SageMaker JumpStart 上基于用例的部署.
- 使用 SageMaker 无服务器定制功能定制模型.
打开排行榜,为您的工作负载筛选出两到三个候选模型,并使用您自己的提示词部署和测试这些模型,然后再选择用于生产环境的模型。