 AI 热点
人工智能
在 Amazon SageMaker JumpStart 上使用 OpenTSLM 对时间序列数据进行推理在各行各业,决策都始于理解什么在变化以及为什么变化。工业组织收集数据,为整个运营中的决策提供依据。这些数据有助于防止生产中断、诊断车辆故障、解释数据中心性能下降,以及根据供需变化调整定价。然而,解读这些数据仍然需要专家投入时间,而且收集更多数据并不意味着团队就能据此采取行动。像 Claude 或 ChatGPT 这样的通用语言模型可以帮助分析数据。但是,将数百项运营指标的长期历史记录作为文本或图像处理,可能会消耗大量 token,从而增加成本。
为了帮助组织基于这些数据采取行动, Aionic Labs 正在开发时间基础模型,其中包括 OpenTSLM,这是一个开源的时间序列语言模型(TSLM)系列。这些模型将运营测量数据(从设备传感器数据到供需数据)与维护记录、市场新闻和工程师观察等上下文结合起来进行解读。通过这种方式,TSLM 帮助系统识别近期测量数据中正在出现的问题。随后,专家可以提出后续问题,以了解发生了什么变化并评估如何应对。 TimeNet,即时间序列数据的共享数据基础设施,提供统一的格式和 API,用于查找、构建和加载用于训练和评估这些模型的数据集。二者共同帮助组织了解其系统如何变化,并在问题造成高昂代价之前采取行动。
OpenTSLM 现已在 Amazon SageMaker JumpStart中提供,因此你可以在自己的 AWS 环境中部署该模型。本文探讨 Nexthink 和 Aionic Labs 如何将这一能力引入主动式 IT 协助,然后展示如何部署 OpenTSLM 并使用 TimeNet 使其适配你自己的数据。
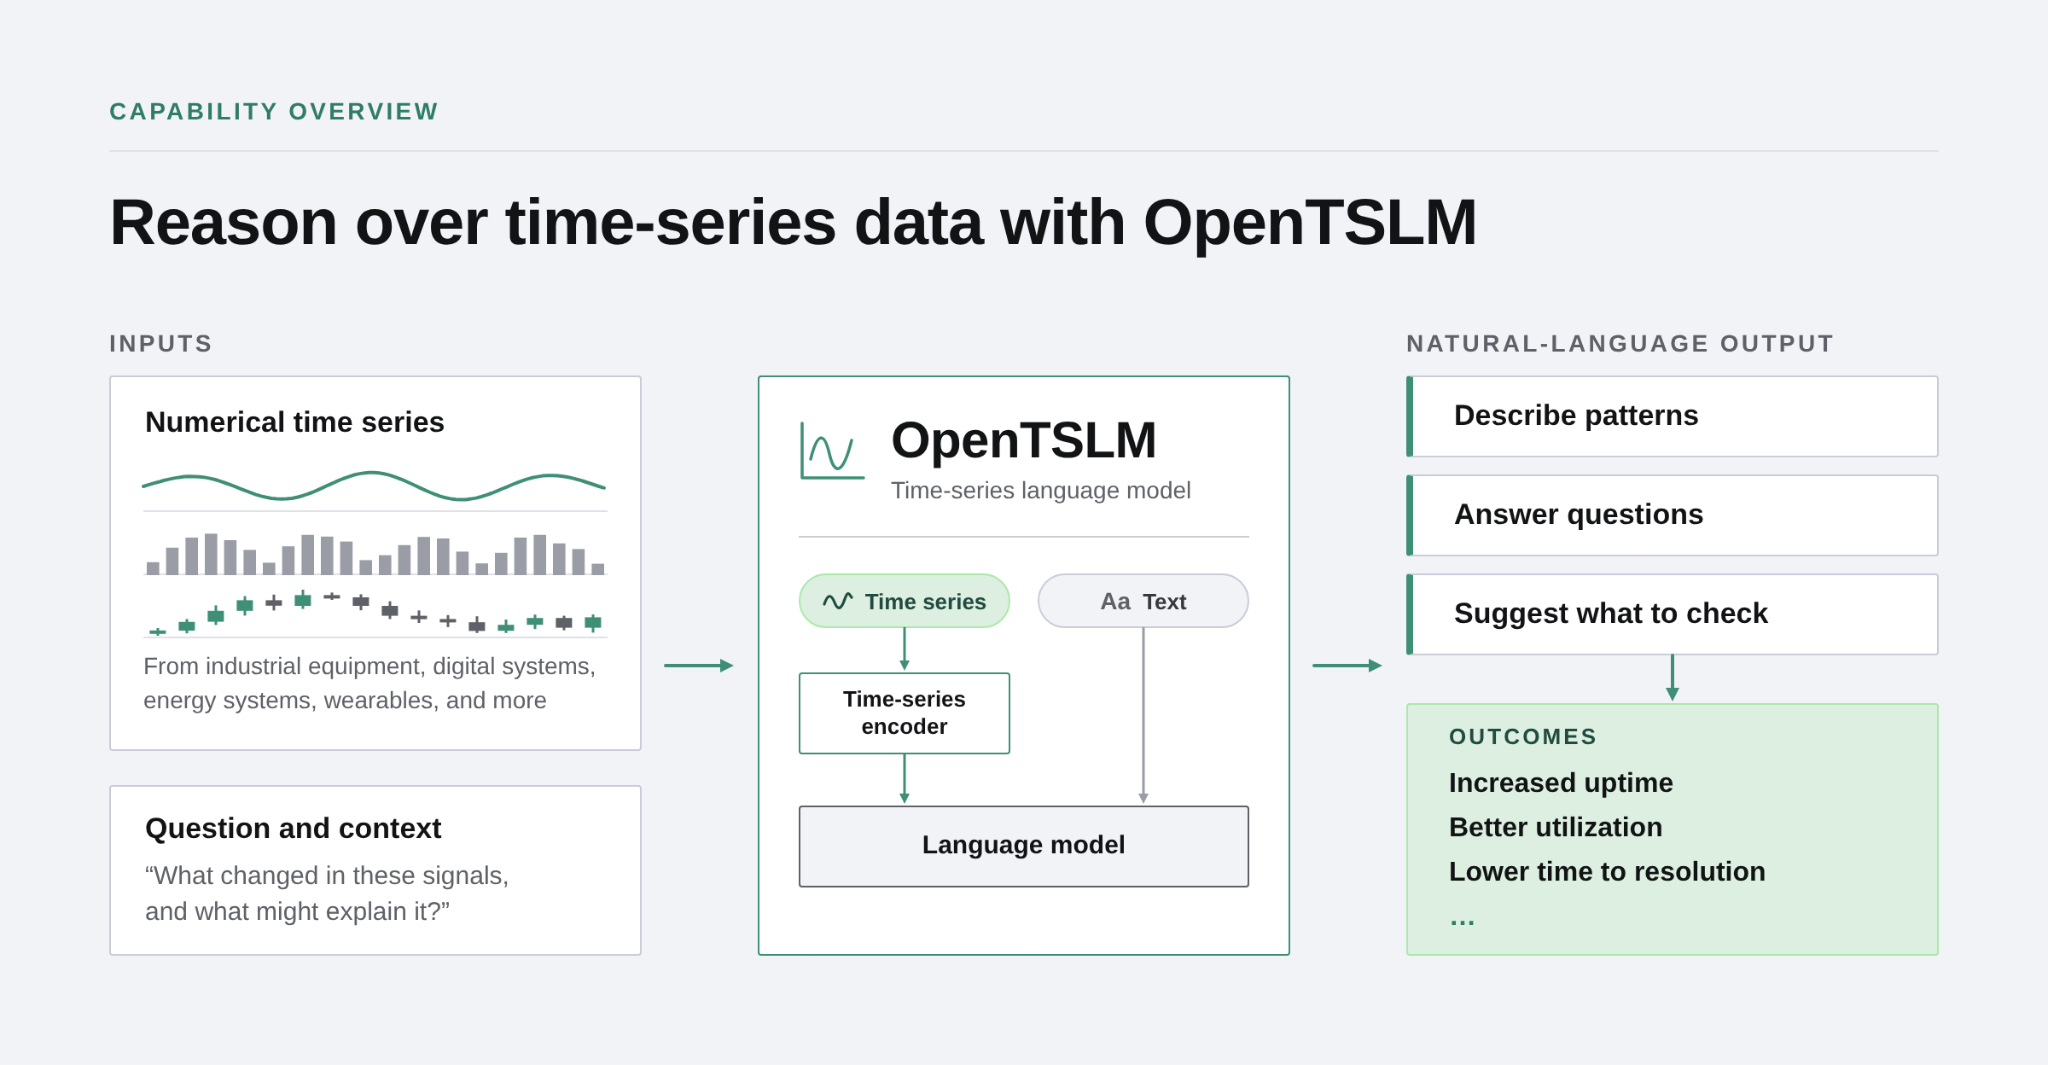
图 1. 时间序列语言模型将数值测量与文本上下文和问题相结合。潜在应用涵盖物理系统和数字系统,并针对每项任务进行适配和评估。
客户案例:Nexthink 的主动式 IT 支持
Nexthink 和 Aionic Labs 正在共同打造一个数字工作场所,让员工在需要求助 之前 就能获得帮助。其核心是 Spark,即 Nexthink 的个人 IT 智能体,它通过时间序列语言模型得到增强,将设备遥测和上下文与员工遇到的问题联系起来。Spark 将这种理解转化为行动:它检查可能的问题,引导员工采取适当的修复措施,并跟进结果。主动式协助成为保持工作持续推进的一部分。
该工作流将近期设备时间序列(如 CPU 活动、内存使用、可用磁盘空间、应用稳定性和连接性)与带时间戳的事件以及设备和软件上下文结合起来。TSLM 接收数值测量数据以及这些文本上下文,并解读信号在观察窗口内如何变化。
TSLM 为 Spark 提供三项输出:
- 状态摘要: 解释可能的问题及支持该判断的信号模式,将设备行为与员工的体验联系起来。
- 建议操作: 明确用于确认问题的检查项,以及 Spark 向员工提供的实用操作。
- 预期结果: 描述预期的改善情况以及 Spark 如何检查结果。
设备遥测和上下文支持对一系列问题的调查,包括高 CPU 或内存负载下的性能缓慢、反复出现的应用卡死或崩溃,以及文件同步失败。资源使用、应用事件、存储测量和连接活动提供了不同的证据。结合设备配置和软件版本,它们为 TSLM 提供了更广泛的基础,用以解释员工的体验并指导 Spark 的后续检查。
在图 2 的说明性低磁盘空间示例中,TSLM 将可用空间下降、磁盘队列上升和应用卡死更频繁与员工可能遇到的症状(如计算机变慢或保存文件困难)联系起来。Spark 检查剩余空间,以及是否可以使用经 IT 批准的清理方式删除临时文件。如果检查确认适合进行清理,Spark 会向员工展示拟删除的内容并请求确认。员工确认后,Spark 执行清理,检查当前可用空间,并询问问题是否有所改善。如果问题仍然存在,Spark 提出将发现结果转交给 IT 支持。
TSLM 理解系统如何变化,并帮助人们基于这种理解采取行动。对于 Spark 而言,这意味着识别正在出现的 IT 问题并引导员工找到解决方案。同样的方法将时间序列智能带入制造业、能源和互联产品,将测量数据和上下文转化为解释和智能决策。
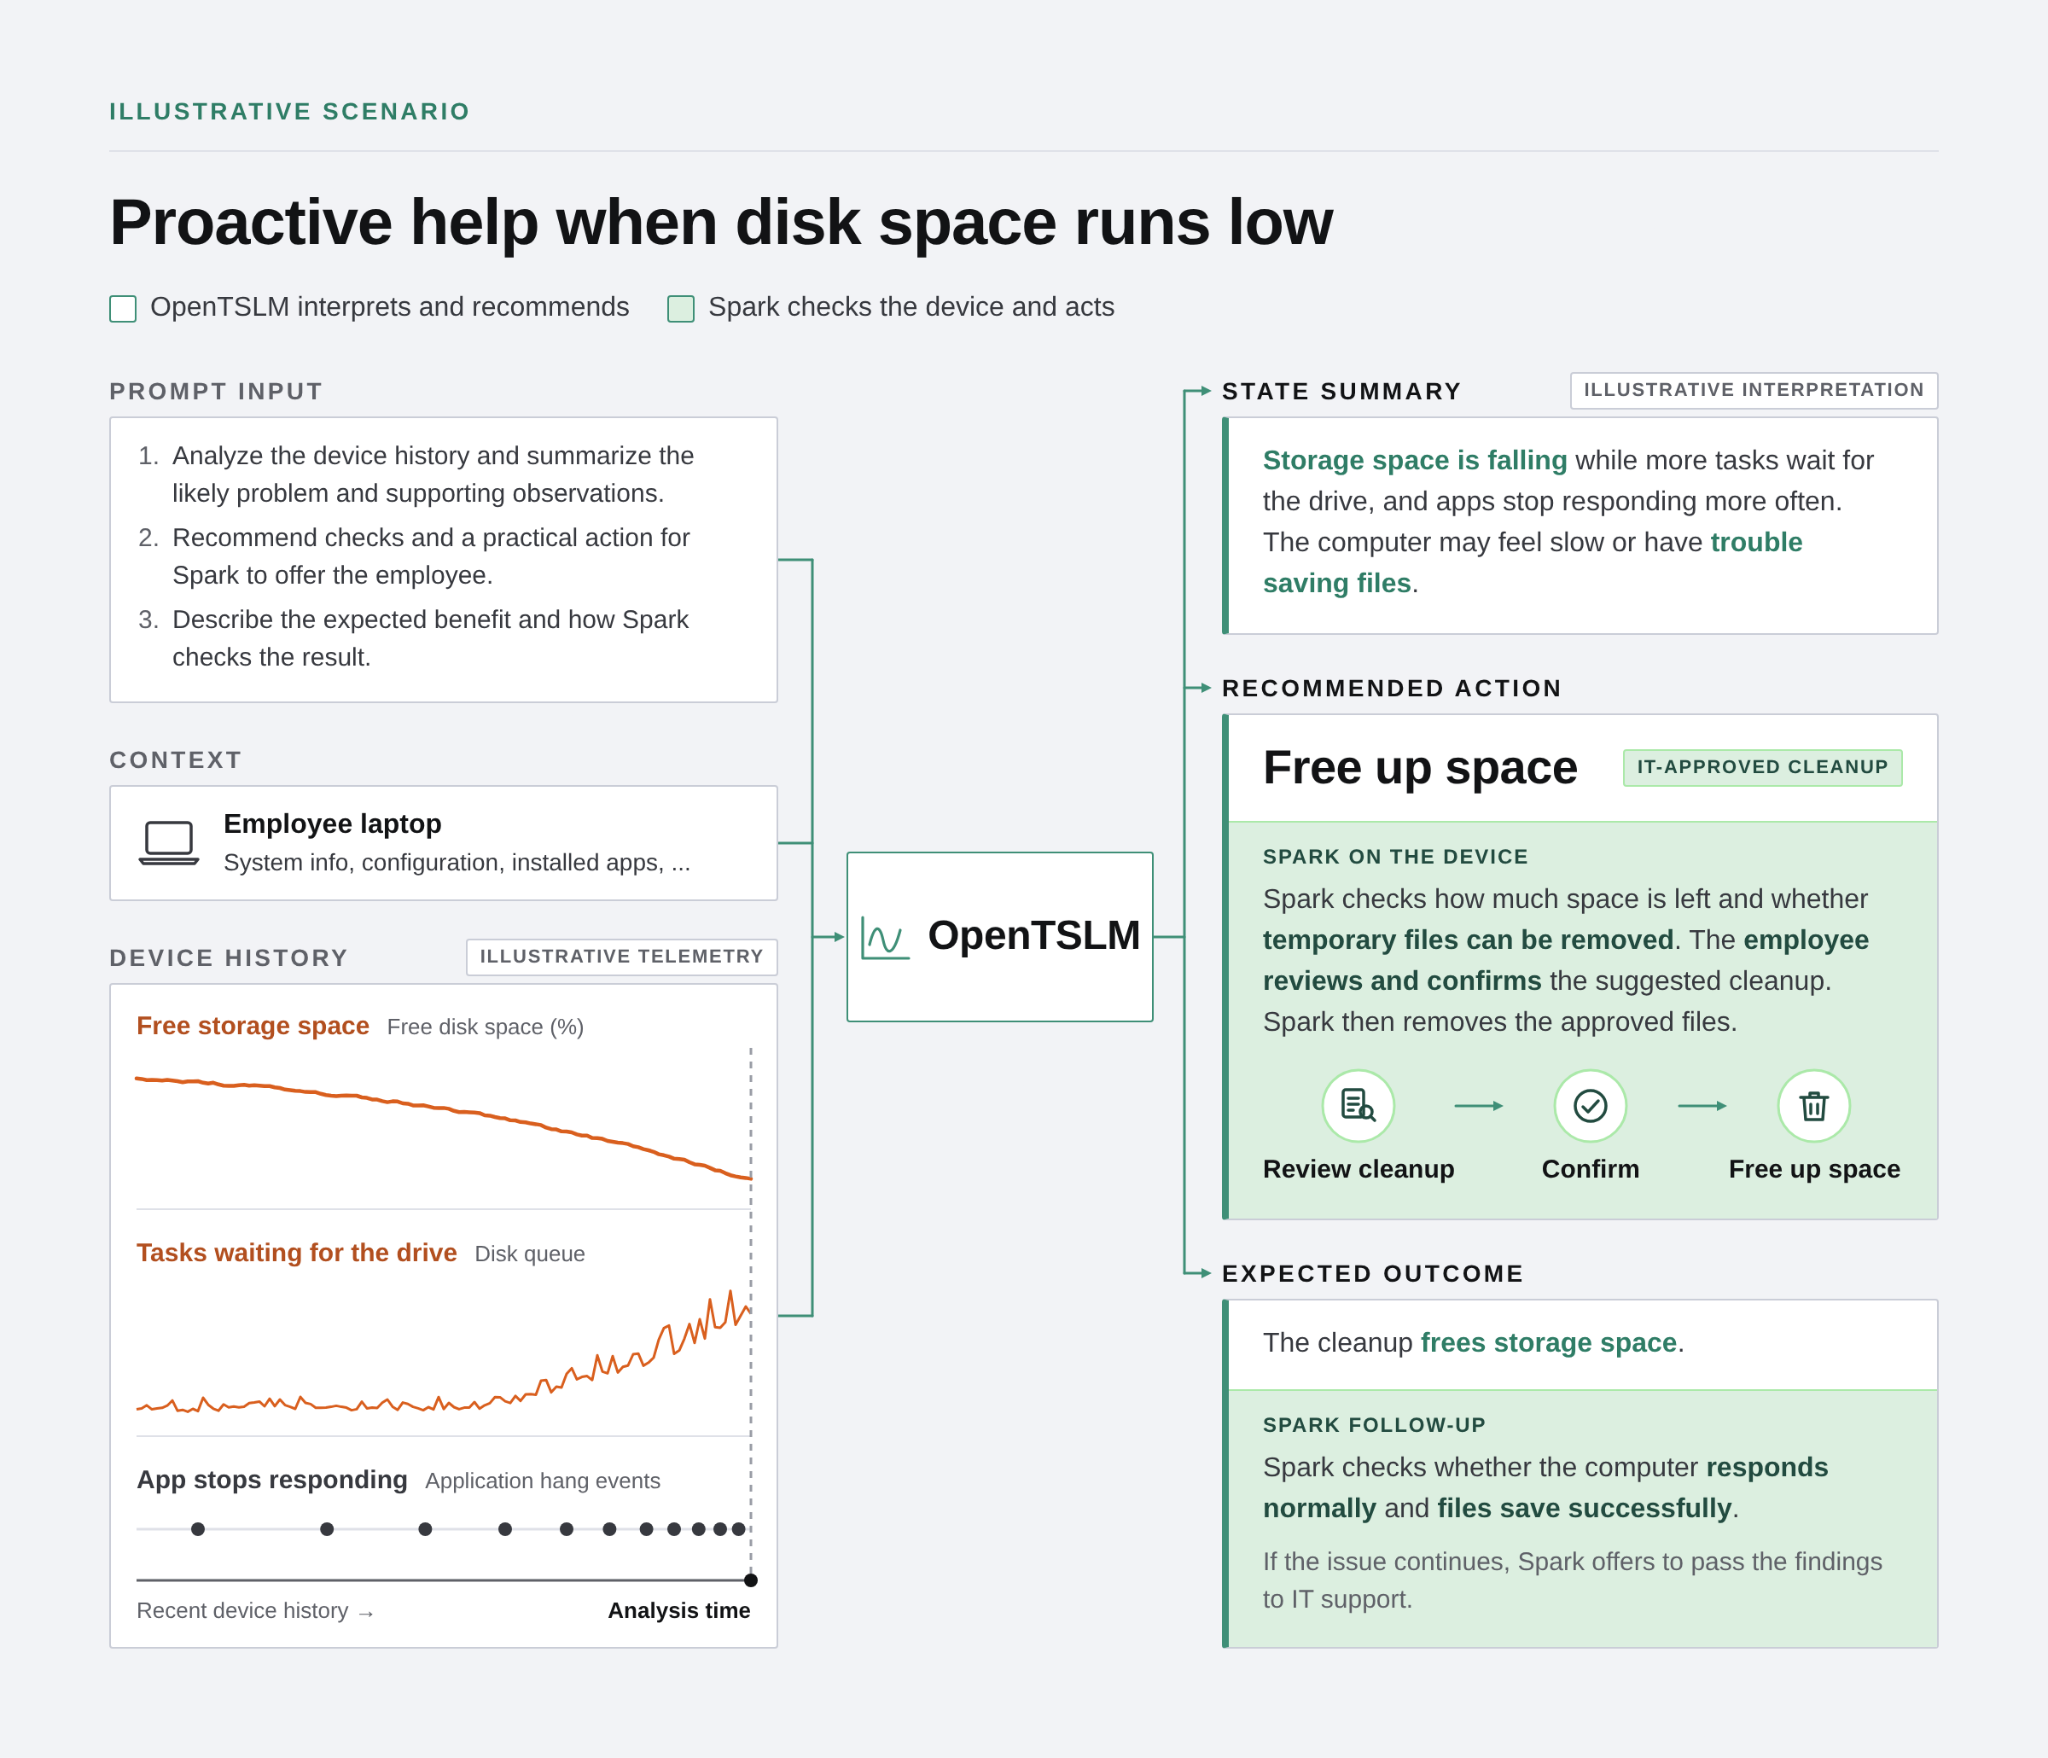
图 2. Nexthink 低磁盘空间的说明性主动支持工作流。OpenTSLM 根据设备历史和上下文生成状态摘要、建议操作和预期结果。Spark 检查设备,在员工确认后运行经 IT 批准的清理,并跟进结果。
解决方案概述
图 3 中的架构为时间序列应用提供了一种可复用的部署模式。SageMaker JumpStart 提供了模型发现和部署路径。
SageMaker JumpStart 是一个机器学习(ML)模型中心,可加速你的 ML 之旅。借助 SageMaker JumpStart,你可以评估、比较和部署预训练基础模型(FM),包括新上线的 OpenTSLM 模型。作为 AWS AI 产品的一部分,SageMaker JumpStart 提供可定制的 ML 解决方案,你可以将其部署到你的 AWS 基础设施内的 Amazon SageMaker AI 推理端点 。它补充了 Amazon Bedrock,后者提供无服务器 API 基础模型推理,以及定制、知识库、智能体和护栏等功能。
SageMaker AI 和 SageMaker JumpStart 的主要技术优势包括:
- 预构建推理容器 – AWS Deep Learning Containers ,具备 GPU 加速能力,因此你无需自行构建镜像即可部署模型。
- 自动扩缩容端点 – 托管基础设施会根据请求量和延迟要求自动扩缩计算资源。
- 推理 API – SageMaker 实时推理端点,提供标准化 API 调用、SDK 以及 AWS Identity and Access Management(IAM)集成。
- 集成监控 – 内置吞吐量、延迟和资源利用率指标,并与 Amazon CloudWatch 集成。
- 企业级安全 – Amazon Virtual Private Cloud(VPC)部署,支持 IAM 访问控制和网络隔离选项。
SageMaker JumpStart 中的模型是 OpenTSLM-Flamingo. 它将 Gemma 3 4B 语言模型与时间序列编码器和交叉注意力层相结合,使语言模型能够关注编码后的序列。该模型共有 52.4 亿个参数,以 bfloat16 存储,因此其权重占用约 10.5 GB 的 GPU 内存。
应用程序准备数值时间序列和文本上下文,调用 SageMaker 端点,并接收模型的响应。应用程序可以将该响应呈现给专家,或将其用作另一个工作流的输入。
这种分离使应用程序能够控制观察窗口、选择相关信号,并在使用前验证响应。它还使模型可以独立调整:在应用程序切换到新检查点之前,可以针对代表性案例对新检查点进行评估。
此外,我们还展示了一个教程,该教程使用通过 TimeNet 加载的 ARFBench 数据,对来自 Hugging Face 的预训练 OpenTSLM 检查点进行微调。该笔记本提交一个 SageMaker 训练作业,该作业通过 TimeNet 加载 ARFBench 并微调模型。Amazon Simple Storage Service(Amazon S3)存储生成的模型产物,然后将其部署到单独的 SageMaker 实时推理端点进行评估。
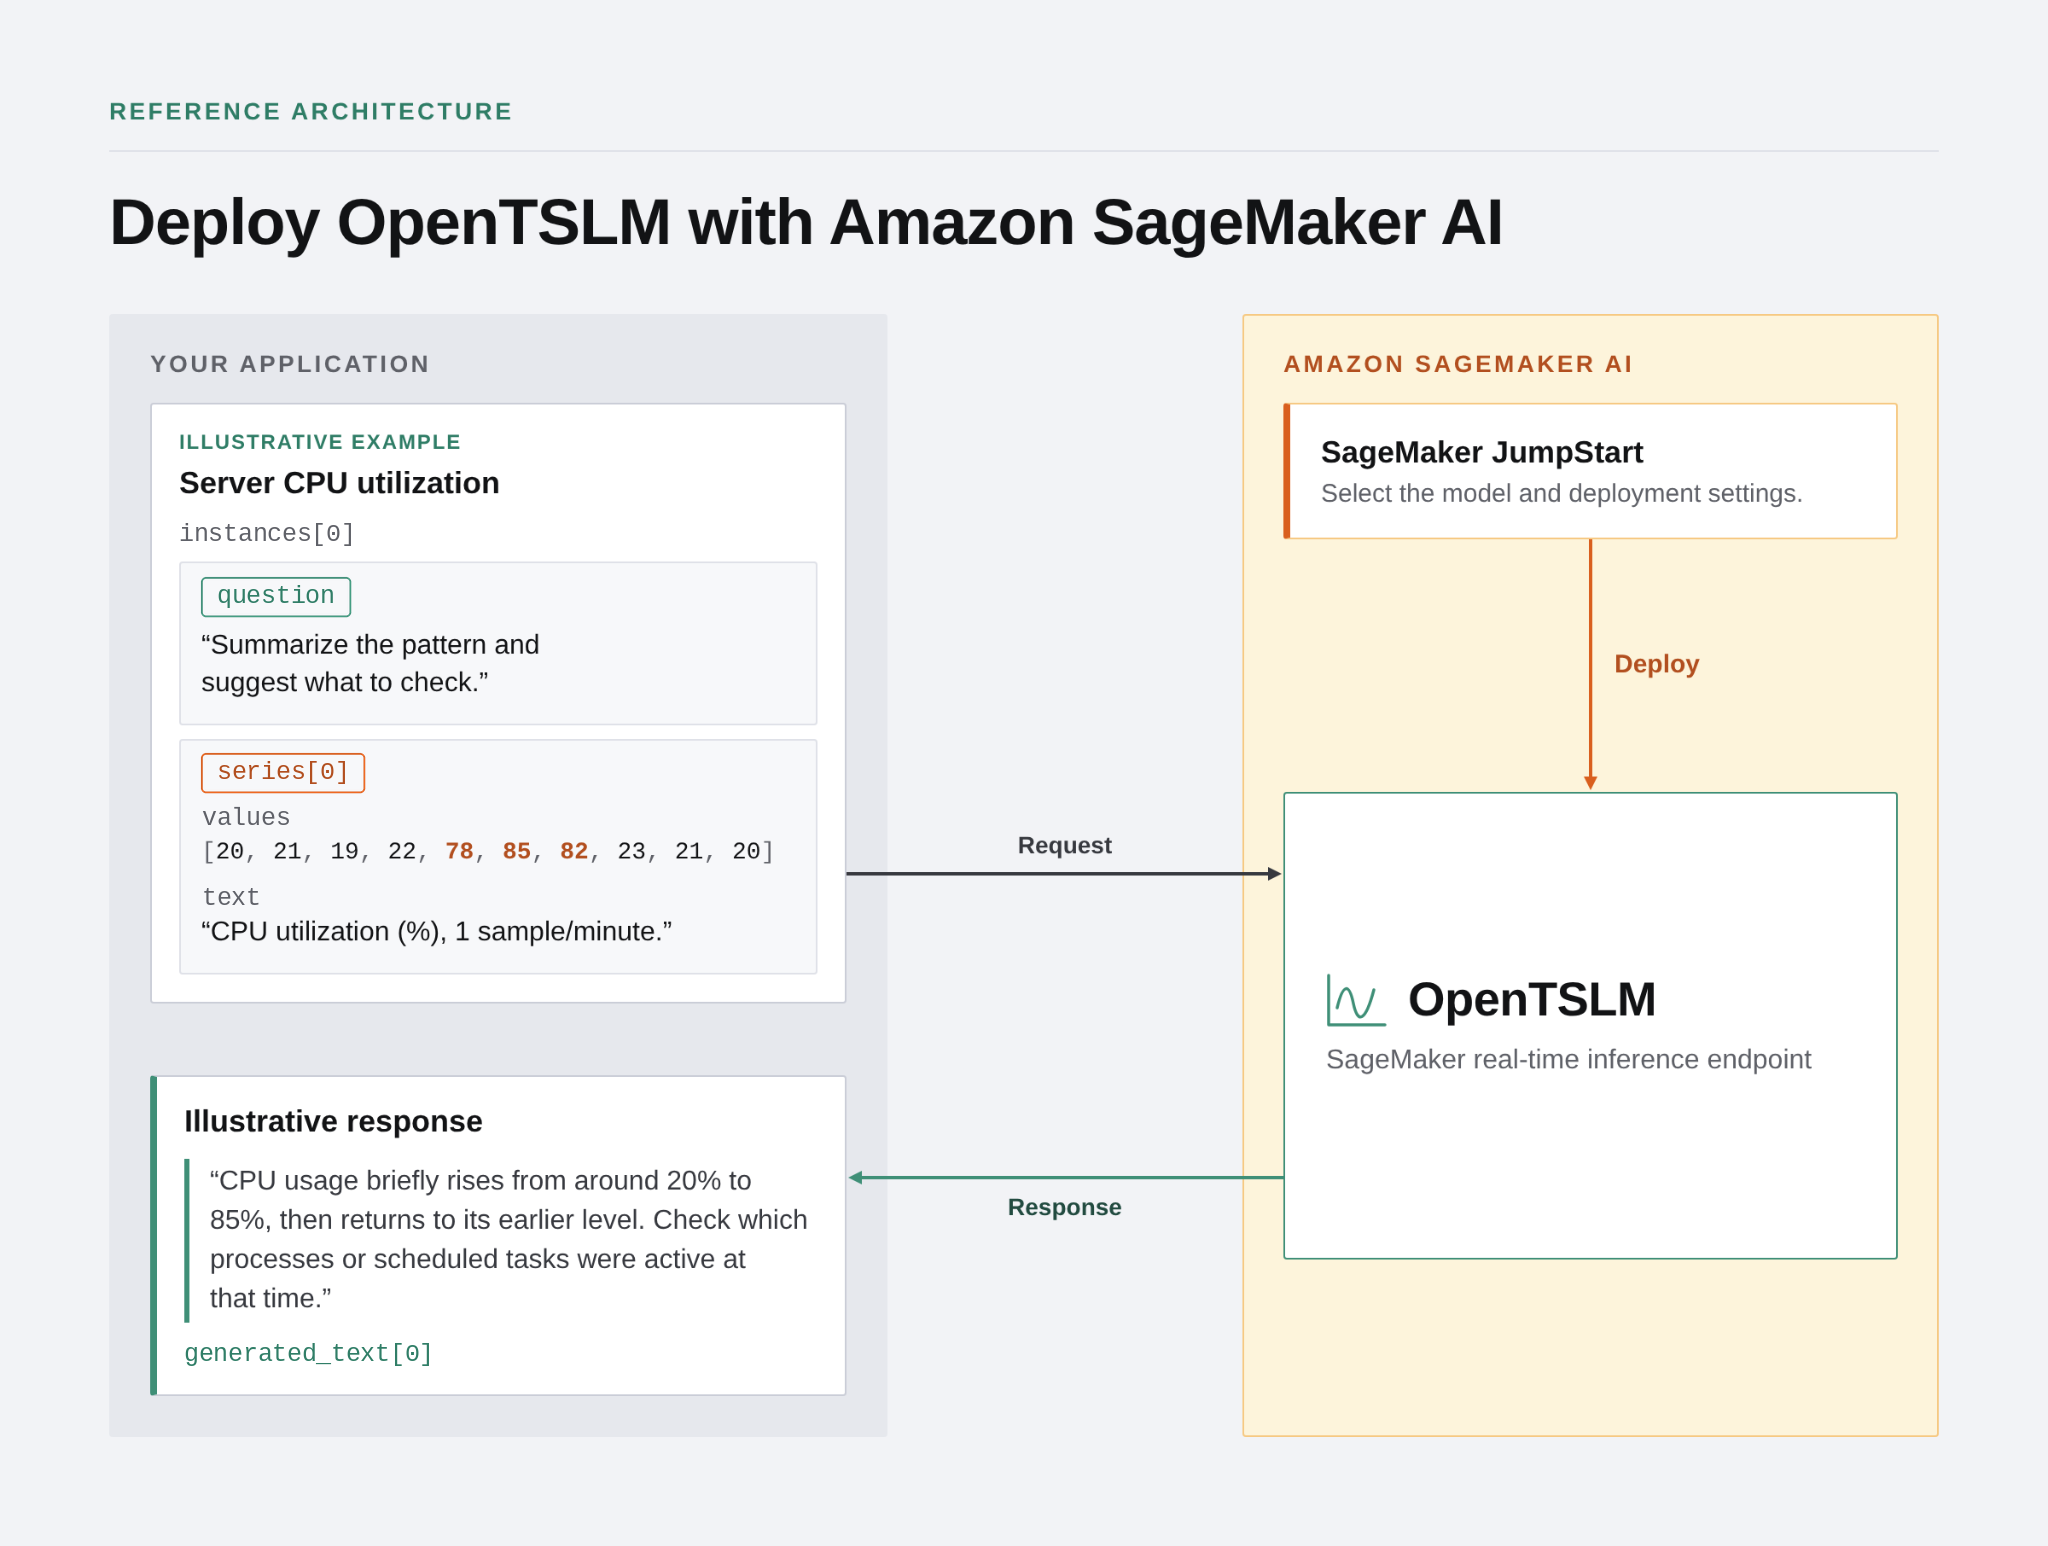
图 3. 一种可复用架构,用于通过 SageMaker JumpStart 部署 OpenTSLM,并从结合时间序列数据与文本上下文的应用程序中调用它。
先决条件
在部署演练中,请使用一个具有 Amazon SageMaker AI 域 和 SageMaker AI 执行角色的 AWS 账户。该角色必须能够在受支持的区域中创建 SageMaker 模型和端点,例如具有 AmazonSageMakerFullAccess 托管策略的角色。单用户快速设置会同时创建两者。该托管策略授予了入门所需的广泛权限。对于生产环境,请使用仅授予所需权限的策略,如 Amazon SageMaker AI 基于身份的策略示例中所述。OpenTSLM 在至少具有 24 GB 内存并支持 bfloat16 的单个 GPU 上运行,我们建议使用 32 GB 主机内存。默认实例类型为 ml.g6.2xlarge (一块具有 24 GB 显存的 NVIDIA L4 GPU,32 GB 主机内存)。在 SageMaker JumpStart 中,OpenTSLM 还支持 ml.g6.4xlarge, ml.g6.8xlarge, ml.g5.2xlarge, ml.g5.4xlarge, ml.g5.8xlarge, ml.g6e.xlarge和 ml.g6e.2xlarge。在 Service Quotas 控制台, 检查您“ml.g6.2xlarge 用于端点使用”的配额,或您所选实例类型的配额。您需要至少为 1 的配额。如果配额更低,请 请求增加配额。有关模型访问要求,请参阅 OpenTSLM JumpStart 模型卡。
微调时,请使用 Amazon SageMaker Studio 中的 JupyterLab 或本地 Jupyter 环境,并配置好 AWS 凭证 ,以运行随附的笔记本,该笔记本会提交训练作业。该笔记本使用 SageMaker 默认 S3 存储桶和一个执行角色。微调运行在 ml.g7e.2xlarge, 因此还要检查您“ml.g7e.2xlarge 用于训练作业使用”的配额。训练在作业托管的 GPU 实例上运行。笔记本本身不需要 GPU。在需要时获取所选 Hugging Face 检查点的访问权限。
使用 SageMaker JumpStart 部署 OpenTSLM
要使用 SageMaker Studio 部署 OpenTSLM,请完成以下步骤: 在 SageMaker Studio 中,在导航窗格中选择“模型”,然后选择“JumpStart 模型”搜索“OpenTSLM”并选择
- OpenTSLM-Flamingo Gemma 3 4B。模型页面会显示模型 ID、许可证以及请求和响应格式。图 4:SageMaker JumpStart 中的 OpenTSLM-Flamingo Gemma 3 4B 模型页面 选择“部署”。 在“将模型部署到端点”表单中,查看“许可协议”下的 Gemma 使用条款,并选中复选框以接受最终用户许可协议(EULA)。保留默认实例类型,或选择其他受支持的实例类型。然后选择“部署”。图 5:将模型部署到端点 。.
- 搜索“OpenTSLM”并选择 OpenTSLM-Flamingo Gemma 3 4B模型页面会显示模型 ID、许可证以及请求和响应格式。
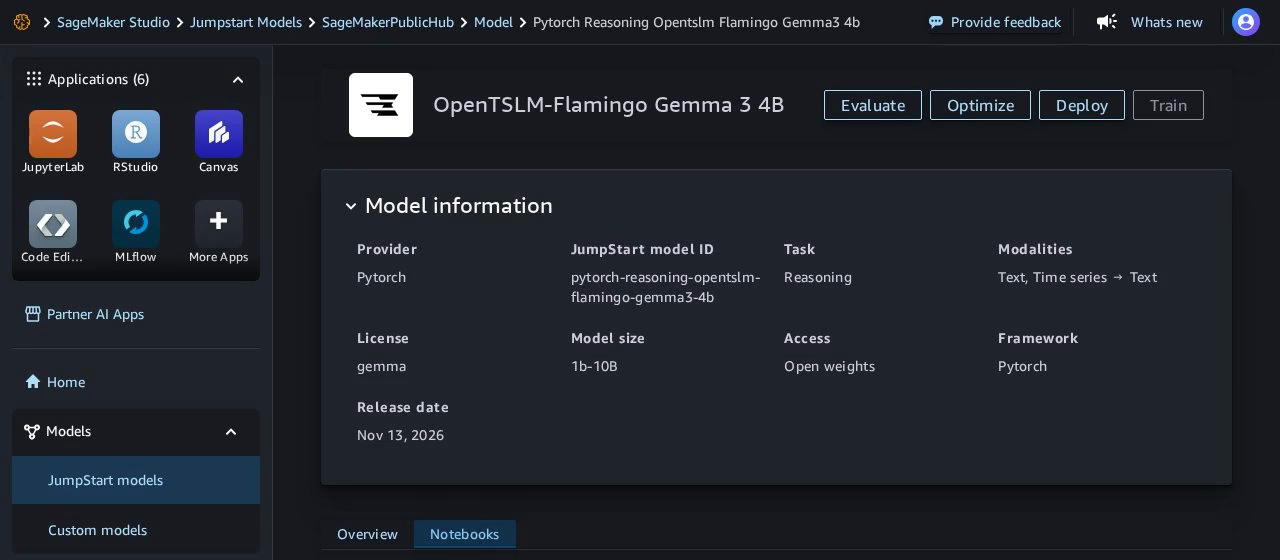
图 4:SageMaker JumpStart 中的 OpenTSLM-Flamingo Gemma 3 4B 模型页面
- 选择 部署.
- 在 将模型部署到端点 表单中,查看 Gemma 使用条款, 许可协议 并选中复选框以接受最终用户许可协议(EULA)。保留默认实例类型,
ml.g6.2xlarge或选择其他受支持的实例类型。然后选择“部署”。 部署.
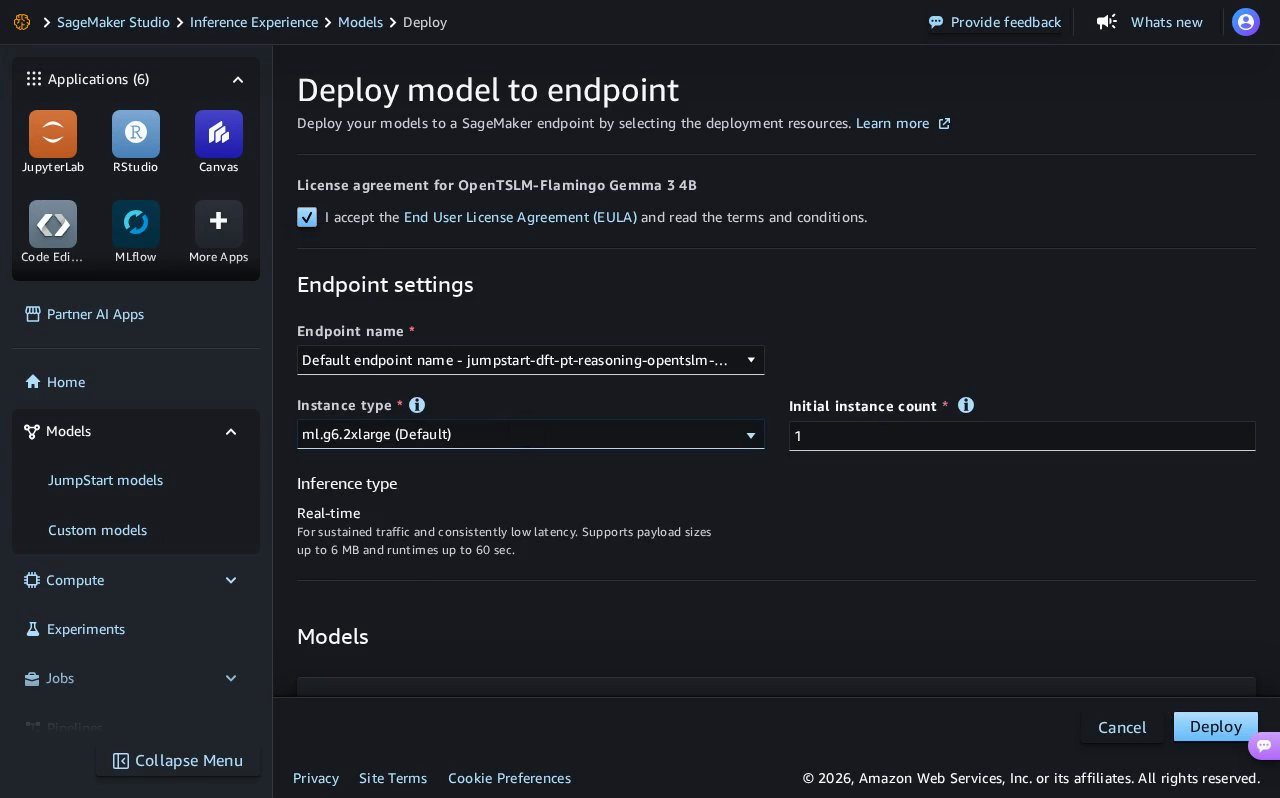
图 5:使用默认设置将模型部署到端点的表单 ml.g6.2xlarge 实例类型和实时推理
- 等待端点状态变为 服务中。在我们的测试中,这大约耗时 6 分钟。请注意端点名称,它以
jumpstart-dft-你需要用它来发送请求并进行清理。
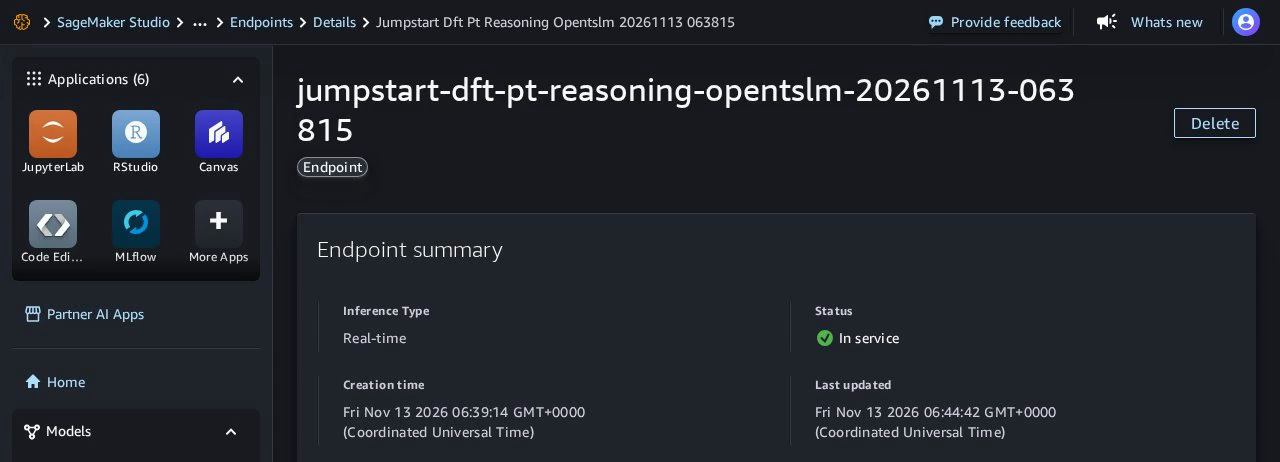
图 6:在 SageMaker Studio 中处于 InService 状态的已部署 OpenTSLM 端点
你也可以使用 SageMaker Python SDK v3 通过 Python 创建部署。以下示例使用 ModelBuilder。该模型受门控限制:设置 accept_eula=True 接受其许可证,即 Gemma 使用条款。在部署之前请审阅这些条款。SDK 在构建模型时会打印指向这些条款的链接。
from sagemaker.core.helper.session_helper import get_execution_role
from sagemaker.core.jumpstart.configs import JumpStartConfig
from sagemaker.serve.model_builder import ModelBuilder
from sagemaker.train.configs import Compute

MODEL_ID = "pytorch-reasoning-opentslm-flamingo-gemma3-4b"
INSTANCE_TYPE = "ml.g6.2xlarge"  # 1 x NVIDIA L4 (24 GB); ml.g5.2xlarge and ml.g6e.2xlarge also work
ROLE_ARN = get_execution_role()  # in SageMaker Studio; elsewhere, set your execution role ARN

builder = ModelBuilder.from_jumpstart_config(
    jumpstart_config=JumpStartConfig(model_id=MODEL_ID, accept_eula=True),
    compute=Compute(instance_type=INSTANCE_TYPE),
    role_arn=ROLE_ARN,
)
builder.build(model_name="opentslm-blog-demo")
endpoint = builder.deploy(endpoint_name="opentslm-blog-demo")
提出一个关于时间序列的问题
该端点接受包含一个或多个实例的 JSON 请求。每个实例包含一个问题、一个或多个数值序列以及可选的上下文行。每个序列包含其数值、一个名称以及对该信号的简短描述,例如其单位和采样间隔。一个序列最多可容纳 32,768 个值。该端点会将每个序列缩放为均值为 0、标准差为 1,并将原始均值和标准差作为文本传递给模型,因此模型既能获得信号的形状,也能获得其尺度。使用 None 表示缺失值。模型会将其屏蔽。
使用 SageMaker Runtime 发送请求 InvokeEndpoint API。将 ENDPOINT_NAME 设置为与你的部署相匹配。调用身份需要具备 sagemaker:InvokeEndpoint 权限。以下合成 CPU 示例展示了一个请求。
import json

import boto3

ENDPOINT_NAME = "opentslm-blog-demo"
runtime = boto3.client("sagemaker-runtime")

# One hour of CPU utilization, one sample per minute, with a five-minute spike.
cpu = [21, 20, 22, 19, 21, 20, 23, 21, 20, 19, 22, 21, 20, 21, 19, 22, 20, 21, 23, 20,
       21, 19, 20, 22, 21, 20, 19, 21, 78, 85, 82, 80, 79, 22, 20, 21, 19, 20, 22, 21,
       20, 21, 23, 19, 20, 21, 22, 20, 19, 21, 20, 22, 21, 20, 19, 21, 22, 20, 21, 20]

request = {
    "instances": [{
        "question": "Summarize the pattern and suggest what to check.",
        "series": [{
            "values": cpu,  # use None for a missing value
            "name": "CPU utilization (%)",
            "text": "CPU utilization (%), 1 sample/minute:",
        }],
        "context": ["The series covers 10:00 to 10:59 on a web server."],  # optional
    }],
    "parameters": {"max_new_tokens": 128},
}

response = runtime.invoke_endpoint(
    EndpointName=ENDPOINT_NAME,
    ContentType="application/json",
    Body=json.dumps(request),
)
print(json.loads(response["Body"].read())["generated_text"][0])
每个请求最多可包含四个实例,每个实例包含 1 到 32 个序列,响应会为每个实例返回一个答案,位于 generated_text. max_new_tokens 接受 1 到 512 之间的值。该模型使用贪心解码,因此相同的请求通常会返回相同的答案。实时调用必须在 60 秒内完成,请求体最大可达 6 MB。在 ml.g6.2xlarge,模型每秒生成约 20 个 token。端点会按顺序处理一个请求中的各个实例,因此响应时间会随实例数量和答案长度增加:512 个 token 的答案大约需要 30 秒。为保持在 60 秒以内,只有在答案较短时才在一个请求中发送多个实例,例如使用 max_new_tokens 128 个。6 MB 的限制也限定了单个请求可携带的序列数据量。对于长时间运行的请求,你可以使用 异步推理.
你可以使用 AWS Command Line Interface(AWS CLI)发送相同的请求。将请求保存为 JSON,例如使用 json.dump(request, open("request.json", "w"))然后运行:
aws sagemaker-runtime invoke-endpoint \
    --endpoint-name opentslm-blog-demo \
    --content-type application/json \
    --body fileb://request.json \
    response.json
cat response.json
选择一个能保留相关事件的输入窗口
OpenTSLM-Flamingo 在语言模型使用编码后的时间序列之前,将其压缩为一组固定大小的表示。这限定了传递给语言模型的表示大小,但并不能使整个系统在内存上不受限制,也不能保证短暂事件在很长的录音中仍然容易识别。
长上下文研究让这一区别变得具体。 TS-Haystack 评估了在不同长度录音上的事件检索,并发现所评估的 TSLM 变体往往随着历史增长而损失准确率,尤其是在定位事件开始和结束时间时。这些结果促使在应用程序所使用的窗口和问题上测试所选检查点。
选择一个包含该事件并有足够周围上下文以便解读它的窗口。对于长时间录音,比较相互重叠的窗口。对短暂事件保留采样分辨率,并在时间上对齐相关通道。在文本上下文中包含单位、采样间隔和观测时段。在预期长度下验证正常和异常示例。端点的可接受负载大小与模型的有效分析窗口是两个独立的约束。
在 SageMaker 上使用 ARFBench 微调 OpenTSLM
随附的微调笔记本,以获取完整示例,从使用 TimeNet 准备 ARFBench 数据到启动 SageMaker 训练作业并部署适配后的模型。何时应该微调?首先在应用程序中的代表性示例上测试预训练的 OpenTSLM 模型,并评估它回答问题的效果。当预训练模型的答案正确且其解释与信号相符时,就使用预训练模型。当重要信息缺失时,改进输入,例如 m 随附的微调笔记本 ,以获取完整示例,从使用 TimeNet 准备 ARFBench 数据到启动 SageMaker 训练作业并部署适配后的模型。
何时应该微调?
首先在应用程序中的代表性示例上测试预训练的 OpenTSLM 模型,并评估它回答问题的效果。
- 当预训练模型的答案正确且其解释与信号相符时,就使用预训练模型。 当预训练模型的答案正确且其解释与信号相符时,就使用预训练模型。
- 改进输入 当重要信息缺失时,例如测量单位、采样率、系统上下文或相关时间窗口。
- 当它持续遗漏你所在领域的特定模式,或即使有足够上下文也难以完成你的任务时,就进行微调。 当它持续遗漏你所在领域的特定模式,或即使有足够上下文也难以完成你的任务时,就进行微调。使用具有代表性的信号并配以经过审核的答案。
TimeNet 提供了一种一致的方式来加载用于训练和评估的数据。微调后,在未用于训练的示例上比较适配后的模型与原始模型。
使用 TimeNet 准备微调数据
ARFBench 是一个关于 Datadog 软件事故遥测中异常的多选题公开基准。我们使用 ARFBench,因为它的多选题答案可以自动评分,从而使微调效果可衡量。同样的工作流程也适用于开放式答案的任务,例如 Nexthink 示例中的摘要和建议操作。TimeNet 作为版本化数据集为 ARFBench 提供服务:每个问题都与其答案选项、正确答案和指标信号一起存储。训练作业通过 TimeNet 加载 ARFBench,并从 Hugging Face 加载模型检查点。
提交 SageMaker 训练作业并部署微调后的模型
SageMaker 训练作业在 GPU 实例上运行 OpenTSLM 训练脚本。该作业微调时间序列编码器、感知器重采样器、交叉注意力层以及语言模型的 token 嵌入,并保持 Gemma 3 语言模型的其余部分冻结。该作业将微调后的模型以 Hugging Face 模型仓库的目录结构保存到 Amazon S3,并将训练前后的测试准确率写入一个 metrics.json 文件。如果你的 SageMaker Studio 域有默认的 MLflow App,该作业还会将训练损失、验证损失和测试准确率记录到其中,这样你就可以在 MLflow UI在我们的一次运行中,在 135 道留出的 ARFBench 问题上,准确率从 5.0% 上升到 45.9%。 ml.g7e.2xlarge 在一次运行中,在 135 道留出的 ARFBench 问题上,准确率从 5.0% 上升到 45.9%。根据 ARFBench 论文微调前,模型对大多数问题都留空答案。微调后,它对每个问题都用给定选项之一作答。ARFBench 在这里作为一个示例应用:它展示了如何借助公开数据集让模型适应新的任务和答案格式。该结果并非与其他模型的比较,也不是 ARFBench 官方排行榜结果。
以下摘自配套笔记本的代码片段会以如下方式启动训练作业: ModelTrainer. scripts/train.py 加载 ARFBench、评估并微调模型,然后将其保存到 FINETUNED_PREFIX.
trainer = ModelTrainer(
    training_image=TRAINING_IMAGE,  # the SageMaker PyTorch 2.9 training image
    source_code=SourceCode(
        source_dir="scripts", entry_script="train.py", requirements="requirements.txt"
    ),
    compute=Compute(instance_type="ml.g7e.2xlarge", volume_size_in_gb=100),
    stopping_condition=StoppingCondition(max_runtime_in_seconds=24 * 60 * 60),
    hyperparameters={"base-model": BASE_MODEL, "output": FINETUNED_PREFIX, "epochs": 3},
    role=ROLE_ARN,
)
trainer.train()
要部署微调后的模型,请在 ml.g6.2xlarge或 JumpStart 模型支持的其他实例类型,使用与 JumpStart 模型相同的容器镜像和环境变量,以及配套笔记本提供的推理脚本。将其模型数据指向微调后模型文件的 S3 位置。请求格式保持不变,因此你可以发送上一节中的请求。配套笔记本中包含相关代码。
将该工作流适配到你的领域
通过将信号窗口与相关问题及经审核的答案配对,同一工作流可以适配到其他时间序列任务。潜在示例包括结合维护背景解读设备行为、结合运行条件解释能耗模式,以及根据可穿戴设备测量数据描述活动。数据、监督和评估应反映应用所面向的领域和决策。
在准备过程中保持测量的时序和含义,并以反映部署情况的方式分离训练数据和评估数据。对于预测任务,只有预测时可用的信息才应放入输入。领域专家应评估答案是否有信号依据,以及对预期工作流程是否有用。对于自由文本答案,将其与经过审核的参考答案进行比较,例如通过专家评分或 LLM-as-a-judge,即由语言模型根据评分标准对每个答案打分。
清理
已部署的端点会持续产生费用,直到你将其删除。完成后,请删除该端点、其端点配置及其模型。如果你是从 SageMaker Studio 部署的,请运行以下命令,而不是选择 删除 在端点页面上,该操作仅删除端点。这些命令会根据端点名称查找配置和模型名称,并删除全部三项。将 ENDPOINT_NAME 设置为你的端点名称,例如以“ jumpstart-dft- 进行 Studio 部署:
ENDPOINT_NAME=opentslm-blog-demo
CONFIG_NAME=$(aws sagemaker describe-endpoint --endpoint-name "$ENDPOINT_NAME" \
    --query EndpointConfigName --output text)
MODEL_NAME=$(aws sagemaker describe-endpoint-config --endpoint-config-name "$CONFIG_NAME" \
    --query 'ProductionVariants[0].ModelName' --output text)

aws sagemaker delete-endpoint --endpoint-name "$ENDPOINT_NAME"
aws sagemaker delete-endpoint-config --endpoint-config-name "$CONFIG_NAME"
aws sagemaker delete-model --model-name "$MODEL_NAME"
使用微调端点名称重复这些命令。停止笔记本应用程序,并删除你不打算保留的教程专用 S3 数据和工件。训练作业在完成后停止。
结论
时间序列语言模型将数值测量与人们用于决策的问题、上下文和专业知识联系起来。在制造业、能源、可穿戴设备和数字基础设施领域,它们为人们和应用提供了一种解读系统如何变化的通用方式。更广泛的机会在于将运营历史与语言连接起来,使过去的观察结果在当前决策中更有用。
OpenTSLM 现已在 Amazon SageMaker JumpStart 中上线,因此你可以通过 SageMaker Studio 或 SageMaker SDK 将其部署到你自己的 AWS 环境中的实时推理端点。TimeNet 和 SageMaker 训练作业提供了一条路径,可将模型适配到你所在领域的信号和问题。要开始使用,请探索 Amazon SageMaker JumpStart,按照 AWS Samples 仓库中的示例操作,并查阅 OpenTSLM 仓库和 TimeNet 文档。从公开的 ARFBench 示例开始,在具有代表性的 Amazon SageMaker JumpStart,因此你可以通过 SageMaker Studio 或 SageMaker SDK 将其部署到你自己的 AWS 环境中的实时推理端点。TimeNet 和 SageMaker 训练作业提供了一条路径,可将模型适配到你所在领域的信号和问题。
Amazon SageMaker JumpStart,并按照 AWS Samples 仓库中的示例操作,同时查阅 OpenTSLM 仓库和 TimeNet 文档。 Amazon SageMaker JumpStart,按照其中的示例操作 AWS Samples 仓库,并查阅 OpenTSLM 仓库 和 TimeNet 文档首先从公开的 ARFBench 示例入手,在代表性案例上对其进行评估,然后引入来自你自己领域的信号、问题和专业知识。