 AI 热点

- 随着机器学习生态系统扩展到大量生产模型,瓶颈已不再是发明新技术来改进这些模型,而是如何在碎片化的模型空间中可靠、高效地部署这些技术,从而水涨船高,让所有模型共同受益。
- 在 Meta,我们构建了一种模板驱动的方法,将模型设计标准化为一小组可复用、可组合的构建模块,把模型迭代从逐个模型的问题转变为一个共享的系统问题。
- 过去两年中,这种方法将单模型工程时间减少了 92%,部署了 5000+ 个技术与模型组合,在服务容量不变的情况下平均将离线模型质量提升了 0.63%,并在覆盖模型总数 70% 的范围内带来了 0.86% 的累计在线提升。
- 我们的论文《一次设计,规模部署:面向大型模型生态系统的模板驱动式机器学习开发.”
Meta 的广告排序系统每天处理数十亿次请求,涵盖多种产品和优化目标,并由大量生产模型提供支持。在如此大的规模下,提升用户相关性和广告主价值的主要挑战,已从发明新技术转变为推广这些技术。每个具有重大影响的想法都需要覆盖其适用的所有模型,而逐个模型进行适配无法随模型集群规模扩大。
在大规模机器学习系统中,碎片化问题会迅速加剧。一种新架构先在某个模型上落地,但要将其推广到生态系统的每个角落,可能需要数年时间。一次平台迁移适用于某一模型家族,却会在大量专业化配置中失效。一项调优心得改善了一个模型,但由于底层设置差异过大,对下一个模型几乎没有参考价值。久而久之,推广创新会变得比创新本身更加困难。
Meta 的广告排序生态系统正是遇到了这一问题。随着生产模型数量因广告优化目标日益多样而增长,架构、特征、训练设置、服务约束和平台专用逻辑也愈加多样。这种多样性赋予了团队灵活性,但也造成了三个系统性问题:广泛部署新想法的工程成本高;边缘情况激增导致可靠性成本高;以及在估算一项变更对整个生态系统的影响时,可预测性低。
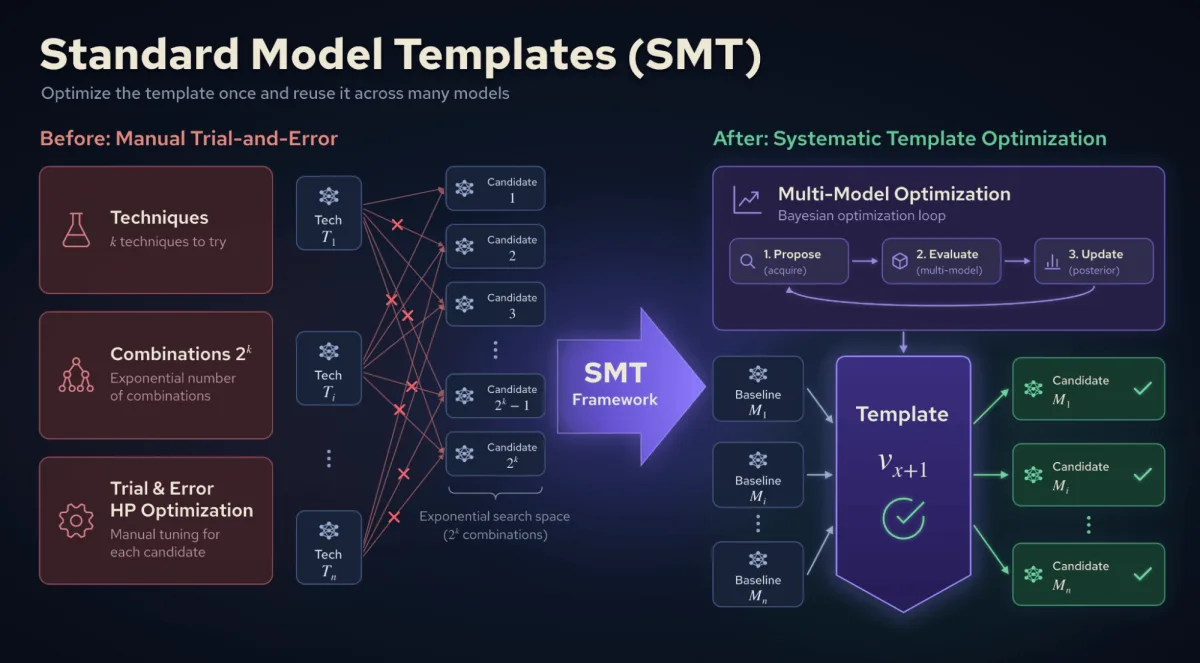
更深层的问题在于,碎片化为工程工作本身带来了一种不利的扩展规律。如果每个想法都必须针对每个模型分别评估和适配,工作量就会随模型数量线性增长。早期这尚可应对,但当模型数量庞大时,就会成为严重的瓶颈。
碎片化还会削弱自动化能力。AutoML 和优化系统在结构化空间中表现最佳,但当每个模型的形态各不相同时,最具潜力的技术只能覆盖部分模型。
我们的解决方案并不是在这种复杂性之上再增加一层自动化,而是首先降低复杂性本身。为此,我们引入了标准模型模板(SMT),通过一组精心筛选的可复用模板来标准化模型设计。
模板驱动的基础
模板是一套具有明确取舍、保持精简的模型设置,由架构选择、特征逻辑、训练设置和服务配置等共享组件构成。我们不再将每个生产模型都作为基本独立的设计来维护,而是围绕数量较少的标准模板对相似模型进行分组。必要时仍会保留模型专用逻辑,但公共部分会被明确表示并共享。
在实践中,我们使用一小组模板来覆盖不同模型规模下的主要排序和检索模式。这些模板封装了用于特征选择、特征交互、模型并行、训练配置和硬件感知型服务的可复用组件。
这以一种重要方式改变了运作模式。我们无需再在每个模型上独立评估新想法,而是可以在少得多的一组代表性模板上进行评估,然后将其推广至使用这些模板的模型组。换言之,我们从逐模型迭代转向了模板级迭代。
这为我们带来了三项主要优势。
- 降低推广复杂度: 一个共享模板可让一套实现服务于许多下游模型,从而降低规模化部署新想法的成本。
- 提高可靠性: 当独特的模型设置减少时,就能够切实构建更强的验证机制、更完善的防护措施以及更具迁移性的调试流程。训练不稳定或服务性能回退等问题也更容易分析,因为它们发生在共享的模板结构内,而非一个无边界的配置空间中。
- 提高可预测性: 当一个组内的模型共享同一模板时,代表性模型的表现就能更准确地反映组内其他模型的表现。这使生态系统层面的规划更有依据,也更少依赖假设。
随着时间的推移,这种模板驱动的方法不再只是一项标准化工作,而是成为更广泛的机器学习开发系统的基础。
SMT:从标准化到可规模化的技术迁移
向 SMT 的转型解锁了一项更具雄心的能力——将整个生态系统作为一个统一、紧密协同的整体进行优化。我们不再管理一组彼此独立的模型,而是开始将整个模型版图视为共享的创新载体。
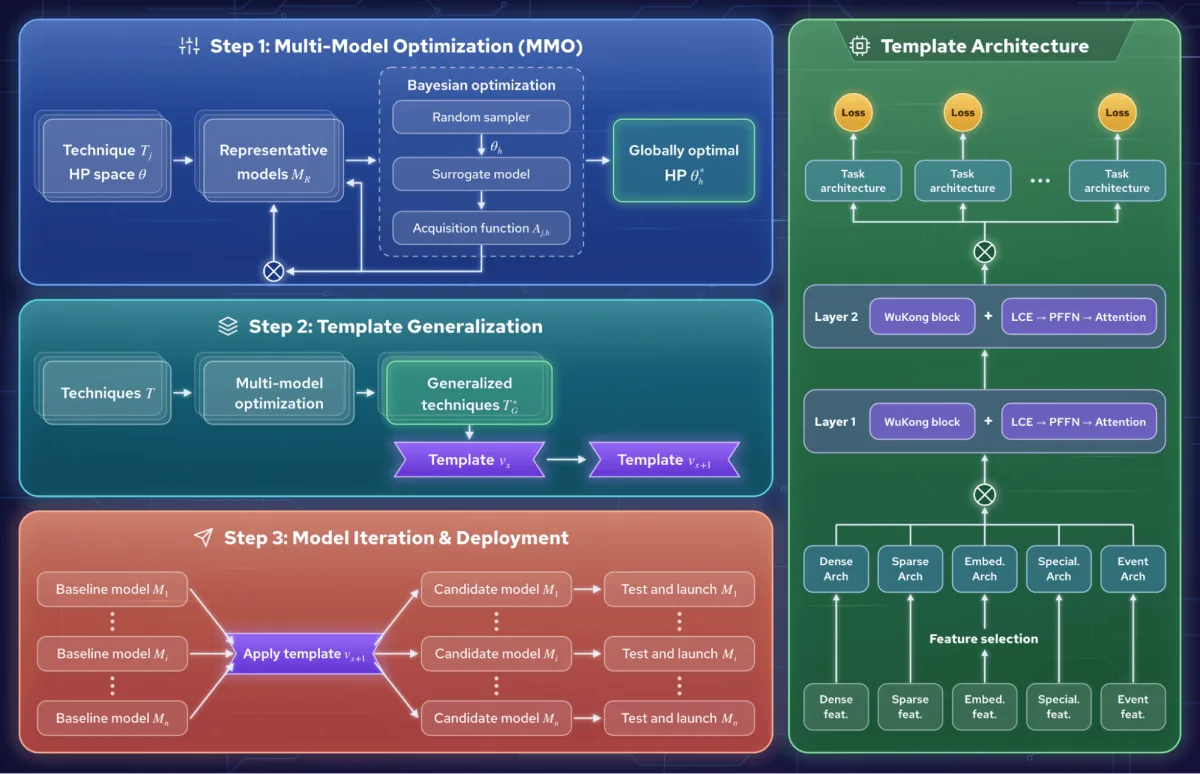
我们不再逐项推广单个技术,而是通过共享模板层,将强大源模型中经过验证的整体模型设计迁移到目标模型家族中。这一点至关重要,因为许多增益来自架构选择、扩展决策和训练策略之间的相互作用,而非独立应用的孤立组件。
过去两年中,这种方法 将单模型工程时间缩短了 92%,在我们庞大且多样化的模型群中部署了 5000 多个技术与模型组合, , 同时将 服务容量不变时的离线模型质量平均提升了 0.63%,并 实现了 0.86% 的累计在线提升。更重要的是,它挑战了一种普遍看法,即多样化的优化目标需要高度多样化的模型设计。在许多情况下,精心设计的共享模板可以实现远超预期的泛化能力。
我们还发现,模型结构标准化后,扩展决策也会变得更具复用性。我们无需再为每个模型分别重新探索成本与性能之间的权衡,而是可以在模板空间中了解这些规律,并将其更广泛地应用。这促成了基于扩展定律的优化工作流,使资源分配更有原则、更少依赖临时决策。
多模型优化
我们使用多模型优化来确保模板迭代的严谨性。该流程在代表性模型上评估候选技术,并搜索既能提升整体性能、又能限制性能回退的配置。
一项技术即使平均增益很高,如果频繁引发性能回退,也很难在庞大的模型群中部署。对于生产规模的推广而言,一致性与峰值提升同样重要。多模型优化在判断一项技术是否可以集成时,会同时考虑整体性能和回退率。
优化完成后,我们会在留出模型上验证候选技术,以检查其增益能否迁移到代表性模型集合之外。通过验证的技术将被集成到下一版本的模板中。过去两年中, 我们通过这一工作流部署了 80 项新的机器学习技术.
由此产生的效果会不断累积。采用成熟模板的每个模型都会继承一系列经过泛化验证的历史改进,而非从孤立的基线开始。
SMT 对智能体式机器学习系统为何至关重要
智能体式模型构建通常设想由单个端到端智能体在大型设计空间中进行探索,并使用工具、训练流水线和评估结果。实践中,这种方法会遇到一个常见问题:搜索空间过于不受约束。如果缺乏强有力的先验,智能体就会耗费过多精力探索无效区域、从本可避免的失败中恢复,或提出难以解释且更难部署的改动。
SMT 有助于解决这一问题,因为它们编码了已知行之有效的设计模式,为智能体提供结构化的起点、边界明确的搜索空间和质量下限。我们无需将模型构建视为自由形式的搜索,而是可以将其分解为多个专门的子问题。
在 Meta,SMT 也是我们采用多智能体方法构建模型的基础。模板提供结构,智能体则提供自适应探索和自动化能力。在模板层面,智能体帮助构建、评估并改进模板本身。它们根据经过验证的技术提出优化构想,在代表性模型上启动实验、诊断故障,并进行多轮迭代,从而协助管理模板开发所需的数日循环。智能体还可以承担更困难的工作,例如将模型迁移到新的硬件平台。以这种方式验证的技术能够触达基于该模板构建的每个模型,而所需计算量仅为逐一适配各个模型的一小部分。我们在以下文章中对此进行了更详细的介绍: Meta 如何利用 AI 智能体在广告排序模型中规模化推广机器学习技术.
SMT 的经验总结与未来之路
在大型机器学习生态系统中,推广机器学习创新以改进模型往往是最主要的规模化挑战。SMT 之所以能够成功,是因为底层系统的结构越完善,自动化就越强大。模板驱动的开发不仅让人类更容易操作生态系统,也让优化系统、扩展工作流和智能体更容易进行有效推理。
但标准化要想奏效,就必须具有足够明确的取舍,以消除不必要的多样性,同时仍保留真正重要的有限灵活性。试图兼容所有历史边缘案例的模板系统,最终会重现它原本旨在解决的碎片化问题。
我们仍需继续扩大覆盖范围、提高模板覆盖率、强化基于扩展定律的优化,并迈向完全端到端的智能体式工作流——包括智能体式模板构建、模型生成、在线评估,以及利用在线信号进行持续优化。我们还需要提高这些工作流的可靠性和可解释性。
但核心理念经受住了实践检验。如果想在大型生态系统中规模化推广机器学习创新,就需要对承载这些创新的基础载体进行标准化。换言之,一次设计、规模化部署不仅是一种提高效率的策略,也是一项关乎如何让大型机器学习生态系统更快学习的架构选择。
阅读论文
“一次设计,规模化部署:面向大型模型生态系统的模板驱动型机器学习开发.”
致谢
Aayush Aggarwal、Saurabh Aggarwal、Anuj Bindal、Nakul Camasamudram、Shouyuan Chen、Wenlin Chen、Kevin De Angeli、Jason Flaks、Luc Kien Hang、Rupinder Khandpur、Santanu Kolay、Nhat Le、Swamy Muddu、Sandeep Pandey、Dhiraj Parashar、Akshay Pardeshi、Jingzheng Qin、Shah Rahman、Shiblee Sadik、Munaf Sahaf、Vibha Sinha、Saied Tahaghoghi、Terry Tang、Alireza Vahdatpour、Fangjing Wu、Haoyu Wu、Wendan Yan 和 Chang Yang。