 AI 热点

今天,我们推出 Model Factory:前沿实验室赖以运转的闭环。现在,任何公司都可以在生产环境中训练、部署并持续改进模型。
Model Factory 将强化学习(RL)、监督微调(SFT)、预训练和推理整合到一个控制平面中。
有两种开始使用的方式:
- 按需托管训练: :提交训练配置,在托管 GPU 上运行,并按 GPU 小时计费。请从 入门指南.
- 专属 Model Factory 部署: 与我们的团队合作,获得预留容量和更深入的控制;除托管训练和推理外,还可直接访问 Slurm 和 Kubernetes。 阅读部署文档 ,或 联系我们的团队 ,立即开始。
我们已经在为从事金融自动化、计算机操作、科学发现、芯片设计等工作的团队部署 Model Factory。
拥有自己的模型工厂,掌握自己的智能。
开始使用
·探索 Model Factory每家公司都应该拥有自己的模型工厂
前沿实验室拥有一种超越任何单一模型的优势:它们掌握着构建和改进模型的完整流程。它们训练模型、部署模型、研究模型的表现,再利用所学成果训练下一个模型。这些步骤紧密相连,数据和知识也始终留在内部。
我们认为,每家公司都应该拥有这一优势。从事科学发现、芯片设计、金融及其他专业领域工作的团队,对自身问题的了解远比任何通用模型提供商深入。它们理应能够利用这一优势,基于自己的任务和数据训练并部署模型。
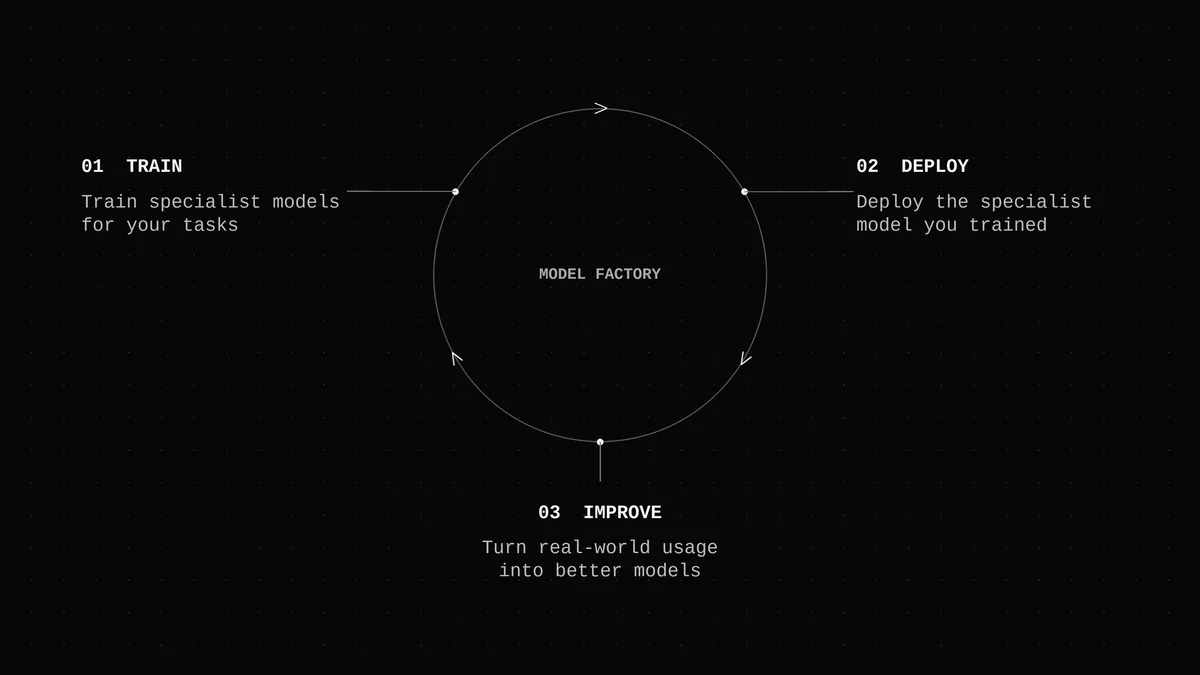
希望为自身领域打造更优秀 AI 的团队有两条路可选:
-
租用模型。 这是最快的起步方式,但会带来三项代价。第一,除了提示之外,你能采取的操作十分有限:由于不拥有模型权重,你无法用自己的奖励信号训练模型。第二,你会把信息交给提供商,使其能够基于你的提示和数据训练模型,并在你的领域取而代之。第三,提供商可以在几乎不作预警的情况下,单方面更改或停用你的产品所依赖的模型版本。
-
拥有模型。 这是唯一能让你拥有权重、数据和生产实践经验的选择。这也意味着你可以训练、部署并改进自己的模型。大多数团队会从开放权重模型入手,对其进行微调或强化学习训练。
直到最近,只有那些能够组装 GPU、开发定制训练框架、维护大规模推理并管理大型沙箱基础设施的团队,才有可能拥有自己的模型工厂。如今,我们降低了准入门槛,让任何团队都能训练模型: Model Factory 是装在盒子里的实验室。
Model Factory 让研究人员和工程师能够专注于只有他们才能完成的实验和产品,而无须应付复杂的基础设施。与前身 Lab 相比,该平台的能力深入得多,可让你对模型进行完整的端到端训练,无论是预训练、中期训练、监督微调,还是大规模强化学习。训练可直接连接大规模生产推理、一键式模型部署、轨迹采集、指标、沙箱和定制智能体运行框架,从而让整个闭环在同一个系统中运行。

开始使用
统一的训练、推理、环境、评估和沙箱使用强化学习训练智能体时,它首先会尝试完成任务,并根据完成质量获得分数。编排器将这些带有评分的尝试批量发送给训练器,以更新模型权重。更新后的模型随后尝试更多任务,如此循环往复。每一轮都将用于生成响应的推理、用于执行代码和工具调用的沙箱,以及用于评估结果的环境结合起来。
Model Factory 通过一个控制面板运行训练、推理、沙箱和编排。研究人员可以定义任务、奖励和训练方案,而无须自行组装底层基础设施。
研究人员可以从一个开源模型和一组编程任务开始,然后检查模型的尝试,以了解其不足之处。它能否找到正确的文件并运行测试?它是解决了问题,还是绕过了问题?这些观察结果会影响下一项实验:研究人员可能为 SFT 制作更好的示范,为 RL 设计不同的奖励信号,或采用难度更高的任务。
在运行期间,研究人员可以跟踪奖励分数,并检查智能体的每一次尝试。如果编程智能体的分数有所提高,他们可以查看其补丁和测试结果,以确认它是否确实修复了更多缺陷。随后,他们可以在另一组任务上评估检查点,判断这种改进是否也适用于训练任务之外的场景。
1. 训练通过强化学习训练智能体
首先,从我们的开源模型目录中选择模型,也可以自带模型。然后,定义智能体将用于训练的任务和环境。该环境会提供智能体尝试每项任务所需的工具和上下文,以及用于评估其表现的奖励信号。
为了使用这些环境开展训练,Model Factory 集成了验证器、 Environments Hub和 Harbor 支持。对于编写代码或使用工具的智能体,它还原生支持在一次运行中集成多达数万个并发 microVM 沙箱。
该平台负责管理训练器、展开推理和编排。
监督微调
托管监督微调(SFT)会使用你所期望行为的示例来训练模型,例如成功完成任务的案例、示范,或来自你所在领域的精选回答。
你可以直接使用微调后的模型,也可以将其作为强化学习训练的起点,让模型通过实践和来自环境的反馈不断改进。
预训练和中期训练
除了强化学习和微调之外,Model Factory 还支持预训练新模型,以及对现有基础模型进行持续训练。你可以按需运行 Model Factory,也可以使用专属部署,以便更深入地控制和定制基础设施。
探索新的架构和目标函数,开展消融实验,或使用编程智能体启动自主预训练实验。对于 MoE 模型, Prime Mega MoE 采用 Qwen 的 235B MoE 架构,在 H200 上实现了 48% 的模型 FLOPs 利用率(MFU)。
2. 部署无论是按需使用 Model Factory,还是在专属 Model Factory 部署中,都可以从控制面板一键启动推理端点。
训练和推理共享同一套基础设施。你开发的模型可以成为应用程序的端点、合成数据的来源,或下一次评估运行所使用的模型。
推理贯穿整个研究过程。你可以在训练前用它建立基线、评估检查点、生成任务和数据,并测试计划发布的模型的行为。
3. 改进Prime Traces 可让你将生产环境中的轨迹转化为下一次训练运行。对于任何一次任务尝试,你都可以记录智能体调用了哪些工具、完成任务时采取了怎样的路径,以及它在哪里失败。
这些失败可以为下一个环境提供依据:确定下一次运行应包含哪些示例、如何对其评分,以及由此得到的模型是否已准备好部署。随后,部署 → 改进 → 训练的循环会继续进行。
由于 Model Factory 将模型开发闭环中的各个步骤连接起来,你可以利用运行过程中生成的数据,结合自身的生产实践持续改进模型。
专属 Model Factory在大规模训练中,硬件故障是训练过程的一部分。Model Factory 为长时间运行的实验提供健康检查、节点自动替换,以及从最新检查点恢复的功能。这些功能可通过 prime factory CLI 使用,它为团队提供统一界面,用于管理算力并在不同工作负载之间调配 GPU。
有些实验需要进行训练配置之外的更改,无论是采用新架构、不同的目标函数,还是自定义展开策略。专属部署允许研究人员修改底层框架,并通过 Slurm 和 Kubernetes 直接使用集群。这样,团队既可以运行托管的训练和推理工作负载,又能直接访问集群,并根据工作需要修改系统。
联系我们的团队
想要专属 Model Factory 部署?请告诉我们你的模型、工作负载和算力需求。我们将帮助你开始使用你的 GPU 或我们的 GPU。