 AI 热点
人工智能
在 Amazon EKS 上使用 NVIDIA Run:ai GPU FractioningGPU 共享并非新事物:多实例 GPU(MIG)、时间切片和多进程服务(MPS)分别满足不同的隔离和利用率需求。NVIDIA Run:ai GPU Fractioning 以 MPS 为基础,提供与 Kubernetes 集成的调度、逐 Pod 显存约定、限制执行和指标。
验证结果: 两个 Pod 共享了一块 NVIDIA A10G Tensor Core GPU。每个 Pod 均在 8 GiB 限制内成功分配了 6 GiB,而超出限制的分配则如预期失败。
NVIDIA Run:ai 是一款面向 Kubernetes 的 AI 工作负载编排软件。其 GPU Fractioning Operator 可帮助多个团队在 Amazon Elastic Kubernetes Service(Amazon EKS)上共享一两块 GPU。即使仍有可用显存,Notebook、模型评估和小型推理服务也可能让团队陷入等待。在本演练的基准配置中,NVIDIA 设备插件将单块 GPU 公开为一个 nvidia.com/gpu 资源,并禁用 GPU 共享。在该节点上,两个分别请求 nvidia.com/gpu: 1 的 Pod 无法同时运行,即使它们的 GPU 显存需求总量可以容纳。
NVIDIA Run:ai GPU Fractioning 为基于软件的共享增加了 Kubernetes 调度集成、强制执行的 GPU 显存限制和逐 Pod 指标。此方法适用于满足 GPU Fractioning Operator 硬件和软件要求的 NVIDIA GPU,包括不支持 MIG 的 GPU。我们使用一台配备 NVIDIA A10G Tensor Core GPU 的 Amazon Elastic Compute Cloud(Amazon EC2) g5.xlarge 实例作为经过验证的示例。其他配置需要进行兼容性检查和验证。
NVIDIA 宣布了 其 NVIDIA Run:ai 开源发布 ,时间为 2026 年 10 月 13 日。本示例使用其四个模块化组件中的两个: KAI Scheduler 和 GPU Fractioning Operator。KAI Resource Management 和 Workload Map 面向组织治理及其他工作负载类型,不在本演练范围内。
本文介绍如何构建自定义 Amazon Linux 2023(AL2023) 镜像,并在 Amazon EKS 上配置 GPU 显存共享。在经过验证的 G5/A10G 示例中,您将建立整块 GPU 基准配置,为每个 Pod 设置 8 GiB 显存约定,并验证 6 GiB 的分配。随后,您将检查逐 Pod 指标,测试拒绝 9 GiB 分配请求的情况,并清理这一临时环境。
选择 GPU 共享方式
MIG 可在 受支持的 GPU. 上提供硬件分区。设备插件时间切片 可共享一块 GPU,但不提供副本间的显存隔离或故障隔离。MPS 允许多个 CUDA 进程并发运行。故障遏制能力取决于具体配置。NVIDIA Run:ai GPU Fractioning 增加了强制执行的逐容器显存限制,并支持时间切片(默认)或 sm-sharing 计算模式。 NVIDIA 文档说明 其默认模式为不同工作负载提供独立的错误域,而 sm-sharing 使用共享错误域。这些并非安全保证。本演练测试的是显存限制,而不是故障遏制能力或计算性能。显存限制并不保留相应比例的计算资源。
Amazon EKS 记录了多种 GPU 共享方案: MIG、使用 NVIDIA 设备插件进行时间切片,以及使用 NVIDIA DRA 驱动程序和 Karpenter进行时间切片。 有关如何在这些方案之间进行选择的指导,请参阅 Amazon EKS 最佳实践指南中的 GPU 共享指南
。如果您需要在不支持 MIG 的 GPU 上强制执行逐 Pod GPU 显存限制,并且可以运行固定规模的 GPU 节点组,请选择 GPU 分片。 动态资源分配(DRA)
提供用于请求和分配设备的 Kubernetes API。GPU 共享和隔离取决于设备驱动程序的实现及其启用的功能。KAI Scheduler 和 GPU Operator 支持 DRA。本演练使用 NvFractions 注解,而非 DRA。
GPU 分片可用于存在空闲时段的交互式 Notebook、短时评估作业、GPU 兼容性测试和小型推理服务。应根据实测峰值用量加上额外开销来确定每项 GPU 显存请求,然后在并发负载下测试延迟。所展示的密度提升并不能证明吞吐量有所增加,也不能证明成本一定会普遍降低。
解决方案概述 下图展示了位于美国东部(俄亥俄)区域(us-east-2)且经过验证的单 GPU 环境。您将使用AWS Command Line Interface(AWS CLI) 、eksctl、Helm 和 Packer 来构建并运行该环境。Amazon EKS 控制平面在 AWS 托管的Amazon Virtual Private Cloud(Amazon VPC)
中运行 Kubernetes 1.36 版,并与客户 VPC 分离。它连接到客户 VPC 私有子网中的 EC2 工作节点。
一个 m7i.large 系统节点承载 Operator 控制器和 KAI Scheduler。KAI Scheduler 将两个 Pod 都调度到一个带污点的 g5.xlarge 节点上,该节点配有一块拥有 23,028 MiB 显存的 A10G。 每个 Pod 的 GPU 显存限制为 8 GiB,并分配 6 GiB GPU 显存。GPU 工作节点使用自定义 AL2023,其中包含NVIDIA R615 驱动程序分支 fractiond 、NVIDIA Container Toolkit 和 containerd。它运行 metricsd ,采用节点资源接口(NRI)集成和 MPS 来实现共享。
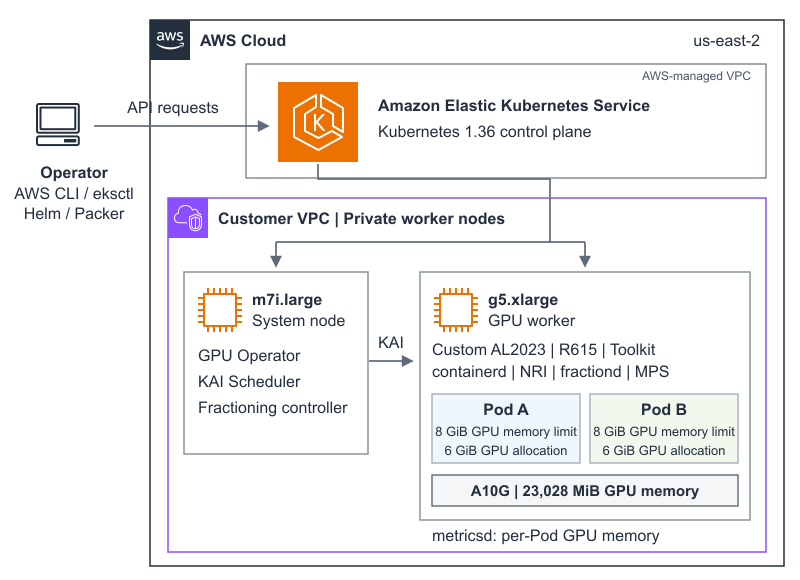
守护进程会导出逐 Pod GPU 显存指标。
图 1:Amazon EKS 中一块 A10G 上两个 GPU 显存约定的验证示例
实施演练
本演练使用 AWS Samples 存储库。请确认前提条件和经过验证的组件版本,然后完成步骤 1 至 10。
前提条件 使用一个拥有以下服务相关权限的 AWS 账户:Amazon EKS、AWS CloudFormation 、Amazon VPC、Amazon EC2、, Amazon Elastic Block Store(Amazon EBS)AWS Identity and Access Management(IAM) 以及 AWS Systems Manager
,后者用于发现 Amazon Machine Image(AMI)。确认 g5.xlarge、系统节点以及临时 m5.xlarge 镜像构建器的配额和容量。安装 AWS CLI v2、eksctl、kubectl、Helm、Packer、Git、jq 和 curl。 使用您常用的 AWS 凭证提供程序:命名配置文件、AWS IAM Identity Center、代入角色或访问密钥环境变量。请优先使用临时凭证。 AWS_SESSION_TOKEN 使用临时访问密钥时需要提供此项。示例使用 us-east-2。其他区域必须支持所选的 Amazon EKS 版本和实例类型。
选择其他 GPU 前,请查看 NVIDIA 的 GPU Operator 硬件列表、所选 驱动程序的硬件支持情况以及 GPU Fractioning Operator 前提条件。仅有硬件支持并不能证明其兼容 GPU 分片。本演练仅验证了 G5/A10G 配置。AMI 构建目标为 x86_64。请检查 CUDA 兼容性和显存余量:两个 8 GiB 约定需要为两个约定及运行时开销留出空间。显存更小的设备需要采用更小的约定并调整探针。
本演练会创建产生费用的资源,包括 Amazon EKS 控制平面、NAT 网关、实例、卷和 AMI 快照。请使用一次性环境,并在验证完成后执行完整清理。
使用经过验证的 AL2023 技术栈
验证时,针对 Amazon EKS 优化的 AL2023 NVIDIA 镜像提供 R580 和 R595 驱动程序分支。GPU Fractioning Operator v0.1.7 要求使用 R615 或更高版本。R615 是短期支持分支,并非 GPU Operator 的默认选项。本示例构建了一个自定义的标准 Amazon EKS 1.36 AL2023 镜像,其中驱动程序和工具包由 AMI 提供。它并未在其他操作系统上使用由 Operator 管理的驱动程序容器。下表记录的是实验室验证结果,并非厂商支持认证。
| 组件 | 已验证版本 |
| Amazon EKS | 1.36 |
| GPU | NVIDIA A10G,23,028 MiB |
| NVIDIA 驱动程序 / Container Toolkit | 615.71.10 / 1.20.1-1 |
| containerd | 支持 NRI 的 2.3.5 |
| GPU Operator / 设备插件 | 26.7.1 / 0.20.1 |
| KAI Scheduler / Fractioning Operator | 0.18.5 / 0.1.7 |
我们于 2026 年 10 月 22 日使用 NVIDIA 驱动程序 615.71.10 验证了本演练。2026 年 11 月 18 日,在更新 GPU 节点污点后,我们使用驱动程序相同的镜像重复执行了除步骤 3 镜像构建之外的所有步骤,结果一致。表中列出的是经过测试的组件版本,并非永久有效的支持矩阵。更改任何组件前,请重新查阅 Amazon EKS AMI 文档和 NVIDIA 前提条件。
步骤 1:克隆并配置
克隆存储库,然后根据提供的示例创建本地配置文件并限制其权限:
git clone https://github.com/aws-samples/sample-code-for-gpu-fractioning-on-eks.git
cd sample-code-for-gpu-fractioning-on-eks
cp walkthrough.env.example walkthrough.env
chmod 600 walkthrough.env
克隆后,使用 walkthrough.env 进行配置,并使用 run.sh 执行各个阶段。生成的文件和 kubeconfig 保存在被忽略的 .state 目录中。 GPU_INSTANCE_TYPE 用于选择实例类型。仅更改此项并不能证明兼容性。
walkthrough.env 中的默认设置和可选身份验证设置
AWS_REGION=us-east-2
CLUSTER_NAME=runai-fractioning-blog
EKS_VERSION=1.36
GPU_INSTANCE_TYPE=g5.xlarge
NVIDIA_DRIVER_VERSION=615.71.10

# Choose a profile or access-key variables, not both.
# AWS_PROFILE=my-profile
# AWS_ACCESS_KEY_ID=YOUR_ACCESS_KEY_ID
# AWS_SECRET_ACCESS_KEY=YOUR_SECRET_ACCESS_KEY
# AWS_SESSION_TOKEN=YOUR_SESSION_TOKEN
切勿提交凭证。本地配置文件已被 Git 忽略。预置资源前,请确认当前使用的身份:
./run.sh check可以分别运行各个阶段以检查结果,也可以使用 ./run.sh walkthrough 一直运行到显存限制测试。清理始终是一项单独的操作。
步骤 2:创建一次性集群
运行以下命令,创建一次性 Amazon EKS 集群及其系统节点:
./run.sh create-cluster该命令会预置一个运行 Kubernetes 1.36 的 Amazon EKS 集群、一个配有单个 NAT 网关的专用 VPC、OpenID Connect(OIDC)集成,以及一个私有 m7i.large 托管节点。
config/eksctl-cluster.yaml.tpl 中的选定字段
iam:
  withOIDC: true
vpc:
  nat:
    gateway: Single
managedNodeGroups:
  - name: system-ondemand
    instanceType: m7i.large
    desiredCapacity: 1
    privateNetworking: true
步骤 3:构建自定义 AL2023 镜像
运行以下命令,构建包含 R615 驱动程序分支的自定义 AL2023 镜像:
./run.sh build-ami该脚本会发现一个公有构建器子网,以及适用于 AL2023 上 Kubernetes 1.36 的 推荐标准 Amazon EKS AMI 。Packer 会安装 R615 驱动程序分支的当前补丁版本和工具包、配置 NVIDIA 运行时、检查软件包状态并创建加密镜像。特定于区域的 AMI ID 存储在 .state/ami-id.
NVIDIA_DRIVER_VERSION 中。该设置选择 R615 分支,而不是精确锁定某个补丁版本。工作流会将发现的驱动程序版本与 AMI ID 一同记录,并在 AMI 和节点组标签中使用该版本。请查看 .state/installed-driver-version ,了解构建中检测到的版本。对于生产环境,请在自己的构建中锁定具体的软件包和基础镜像,并验证受支持的驱动程序分支升级。
仅因为验证时针对 Amazon EKS 优化的 AL2023 NVIDIA AMI 尚未包含 R615 驱动程序分支,您才需要执行此步骤。一旦针对 Amazon EKS 优化的 NVIDIA AMI 为您的 GPU 选择的驱动程序以及其余主机前提条件满足 GPU Fractioning Operator 的要求,就应优先使用该 AMI。请在 GitHub 上的 Amazon EKS AMI 发行版 中检查驱动程序版本。示例脚本目前需要 R615 驱动程序以及镜像构建生成的元数据,因此使用原版 AMI 也需要修改脚本。
ami/eks-al2023-r615.pkr.hcl 中的相关 Packer 设置
source "amazon-ebs" "eks_al2023_r615" {
  source_ami = var.source_ami_id
  region = var.aws_region
  encrypt_boot = true
  metadata_options {
    http_tokens = "required"
  }
}
SOURCE_AMI_ID 和 PACKER_SUBNET_ID 是可选的覆盖项,可用于指定已获批准的基础镜像或构建器子网。当操作系统或 GPU 技术栈发生变化时,请重新构建并测试镜像。
步骤 4:添加 GPU 工作节点
运行以下命令,添加使用自定义镜像的 GPU 托管节点组:
./run.sh add-gpu-node默认情况下,该托管节点组使用自定义镜像,并保持为一个按需 g5.xlarge 实例,即经过验证的 GPU 工作节点。GPU 污点会排除普通工作负载。该脚本会禁用 eksctl 安装 NVIDIA 设备插件的功能 ,因为该组件由 GPU Operator 管理。
config/eksctl-gpu-nodegroup.yaml.tpl 中的选定字段
managedNodeGroups:
  - name: gpu-g5-r615-ondemand
    instanceType: g5.xlarge
    ami: <generated-ami-id>
    amiFamily: AmazonLinux2023
    desiredCapacity: 1
    minSize: 1
    maxSize: 1
    privateNetworking: true
    taints:
      - key: nvidia.com/gpu
        effect: NoSchedule
步骤 5:安装 GPU Operator 并检查主机
运行以下命令,安装 GPU Operator 并检查 GPU 工作节点的主机配置:
./run.sh install-gpu-operatorGPU Operator 26.7.1 提供设备插件和 Kubernetes 集成。其配置会保留镜像自带的驱动程序和工具包:
driver:
  enabled: false
toolkit:
  enabled: false
同一命令还会在 GPU 工作节点上运行一个临时的特权检查 Pod,输出主机配置,然后移除该 Pod。经过验证的节点报告如下:
观测到的主机配置
GPU: NVIDIA A10G, 23028 MiB
Driver: 615.71.10
NVIDIA Container Toolkit: 1.20.1-1
containerd: 2.3.5
cgroup filesystem: cgroup2fs
NRI socket paths:
  /var/run/nri/nri.sock
  /run/nri/nri.sock
在此 AL2023 节点上, /var/run 是指向 /run的符号链接。这两个路径指向同一个套接字。请将特权检查限制在一次性环境内,并确认该 Pod 已被移除。
步骤 6:建立整块 GPU 基准
运行以下命令,在安装分片功能前测试整块 GPU 调度:
./run.sh baseline每个基准 Pod 都将 nvidia.com/gpu 的请求值和限制值设为 1。该测试假设只有一块可用的物理 GPU,并且共享功能已禁用:一个 Pod 会运行,另一个则保持 Pending。这展示了安装分片功能之前的整设备调度约束。在多 GPU 节点上,请调整此基准测试,并验证两个分片工作负载使用同一块 GPU。
实测基准结果
NAME          READY   STATUS    NODE
whole-gpu-a   1/1     Running   <gpu-node>
whole-gpu-b   0/1     Pending   <none>
该脚本会检查此状态并移除两个基准 Pod。
步骤 7:安装 KAI Scheduler 和 GPU Fractioning Operator
运行以下命令安装 KAI Scheduler,其中包括 GPU Fractioning Operator:
./run.sh install-kai固定版本的 KAI Scheduler 0.18.5 Helm Chart 包含 GPU Fractioning Operator 0.1.7。这些配置值会启用 NvFractions 和逐 Pod 指标,同时保留 GPU 技术栈版本检查。可选的 nvidia.com/container.<name>.gpu-compute.mode 注解用于选择计算模式。这些工作负载保持默认设置不变。
helm/kai-values.yaml 中的相关字段
global:
  gpuSharingMode: NvFractions
  nvFractions:
    set: true
gpu-fractioning:
  metricsAgent:
    enabled: true
  skipGpuStackVersionChecks: false
在验证中, FractiondReady, MpsdReady和 Ready 为 True。 DriverUpgradeInProgress 为 False,原因为 NoDriverUpgrade,这与 AMI 继续由驱动程序负责管理的情况一致。
步骤 8:运行共享正向测试
运行以下命令,部署两个具有 8 GiB GPU 显存配额的 Pod:
./run.sh share每个 Pod 请求的显存和限制的显存均为 8 GiB,并选择 kai-scheduler。两者均未请求完整的 nvidia.com/gpu 资源。该存储库会应用这些调度字段,并运行一个分配 6 GiB 显存的 CUDA 探针:
kubernetes/fraction-8gi-pods.yaml 中的关键字段
metadata:
  annotations:
    nvidia.com/container.gpu-workload.gpu-memory.request: 8Gi
    nvidia.com/container.gpu-workload.gpu-memory.limit: 8Gi
spec:
  schedulerName: kai-scheduler
  runtimeClassName: nvidia
实测正向结果
NAME             READY   STATUS    NODE
fraction-8gi-a   1/1     Running   <same-gpu-node>
fraction-8gi-b   1/1     Running   <same-gpu-node>
该脚本会验证节点名称和 GPU UUID 是否一致。在验证中,两个 Pod 均可看到 8,192 MiB,并报告 allocation_succeeded_mib=6144。这些检查确认了两个 Pod 被放置在同一块物理 GPU 上、设备视图受到限制,并且每个 Pod 都能在各自配额内成功分配显存。
每个 Pod 的实测分配输出
NVIDIA_GPU_MEMORY_LIMIT=8192
requested_allocation_mib=6144
allocation_succeeded_mib=6144
在两个 Pod 均保持活动状态时观察显存
./run.sh metrics该 gpu_fractioning_gpu_memory_used_bytes 指标按 Pod 和 GPU UUID 归属显存用量。观测到每个 Pod 使用 6,394 MiB(约 6.24 GiB),比探针分配的 6,144 MiB 多 250 MiB。指标可能包含 CUDA 上下文和运行时开销。本实验未测量这些开销的具体构成。监控共享设备时,请同时保留工作负载标识以及请求值、限制值和使用量。
实测逐 Pod 指标序列
gpu_fractioning_gpu_memory_used_bytes{
  gpu_uuid="<same-gpu-uuid>",
  namespace="runai-fractioning-test",
  pod="fraction-8gi-a"} 6.704594944e+09

gpu_fractioning_gpu_memory_used_bytes{
  gpu_uuid="<same-gpu-uuid>",
  namespace="runai-fractioning-test",
  pod="fraction-8gi-b"} 6.704594944e+09
步骤 9:验证超出限制的分配会被拒绝
运行以下命令,测试超出 8 GiB 配额的分配:
./run.sh limit此命令会移除正向测试的 Pod,并创建一个具有 8 GiB 配额、尝试分配 9 GiB 显存的 Pod。探针报告如下:
实测超限结果
NVIDIA_GPU_MEMORY_LIMIT=8192
requested_allocation_mib=9216
allocation_failed=out of memory
实测负向测试 Pod 状态
NAME                      READY   STATUS      NODE
fraction-8gi-over-limit   0/1     Completed   <gpu-node>
此处, cudaMalloc 返回显存不足错误,探针会处理该错误,然后以代码 0 退出。 Completed 是预期状态,而不是 OOMKilled。这证明的是分配请求被拒绝,而不是容器终止或一般性的故障隔离。
步骤 10:清理
删除集群前,请记录 VPC ID。后续的独立检查使用默认集群名称和区域。如果您更改了这些值,请替换为自己的配置。
记录 VPC ID
VPC_ID=$(aws eks describe-cluster \
  --name runai-fractioning-blog --region us-east-2 \
  --query cluster.resourcesVpcConfig.vpcId --output text)
移除一次性环境
./run.sh cleanup标准清理流程会移除测试命名空间、Helm Release 和一次性集群,同时保留自定义 AMI 及其 Amazon EBS 快照。
验证资源已删除
aws eks describe-cluster \
  --name runai-fractioning-blog --region us-east-2
aws cloudformation describe-stacks \
  --stack-name eksctl-runai-fractioning-blog-cluster \
  --region us-east-2
aws ec2 describe-vpcs --vpc-ids "$VPC_ID" --region us-east-2
对于已删除的资源,应看到明确的“资源未找到”响应。身份验证或权限错误不能证明资源已被删除。还应检查剩余的节点组和带有集群标签的实例。如果清理失败,请检查 CloudFormation 事件并解决所拥有资源的依赖关系,然后重试。Amazon EKS 端点不存在并不能证明其 VPC 也已删除。
仅使用 ./run.sh cleanup-all ,且仅限于不再需要自定义 AMI 及其 Amazon EBS 快照时。如果镜像删除请求被拒绝,请确认 AMI ID 和示例所有权标签。不要绕过此保护措施。
生产环境注意事项
应将此流程视为行为验证。请使用可信工作负载,并对分片请求应用最小权限 IAM、命名空间控制、获批镜像和准入规则。需要更强隔离时,请选择整块 GPU,或在受支持的硬件上使用 MIG。
固定版本的分片守护进程使用特权容器、主机 PID 访问权限以及 NRI/MPS 主机挂载。应仅允许可信管理员部署和配置这些组件。
请为 CUDA 上下文、缓存、批处理和运行时开销预留余量。在并发负载下测量延迟和吞吐量。监控分配失败、MPS 运行状况、NRI 连接和 GPU 错误。将基础 AMI、驱动程序、工具包、设备插件、Operator、Scheduler 和工作负载镜像固定为一套经过测试的组合。推出前请重新构建镜像并测试回滚。
本演练需要预先配置 GPU 容量,不会配置或验证可感知 GPU 分片的自动扩缩。分片 Pod 选择 kai-scheduler,不请求任何 nvidia.com/gpu 资源,并使用一个 nodeSelector ,将目标指向固定为一个节点的节点组。Karpenter 对辅助调度器的支持仍是一个开放的功能请求(issue #742 ,见 GitHub)。该自定义镜像无法在 Amazon EKS Auto Mode 管理的节点上运行,因为 Auto Mode 会选择并管理这些节点的 AMI。一个集群可以 混合使用 Auto Mode 管理的节点和托管节点组,但我们未在此类集群中验证本演练。
使用 Karpenter 的团队可以在 EC2NodeClass中按 ID 引用同一个自定义 AMI。自动扩缩限制仍然适用。我们尚未验证此路径。
KAI Scheduler 是第二调度器,负责对选择它的 Pod 进行排队和放置。如果您已经使用 Kueue,请在采用 KAI Scheduler 前确定由哪个组件负责 GPU 工作负载的排队。
我们建议运行 Amazon EKS 节点监控代理 ,并将其部署在 GPU 节点上。在 2026 年 11 月 18 日的一次回归测试中,该代理在启用了 MPS 共享的自定义 R615 镜像上运行,并在共享测试和限制测试期间持续报告 GPU 状况正常。该次测试未测试故障检测。由于 GPU Operator 已运行 Data Center GPU Manager(DCGM)主机引擎,请将该代理配置为 使用该主机引擎 ,而不是其自带的主机引擎。
结论
本文介绍了如何使用自定义 AL2023 镜像在 Amazon EKS 上配置 GPU 显存分片,并以经过验证的 G5/A10G 为例。在检查先决条件并验证所选配置后,该方法也适用于兼容的 NVIDIA GPU。您建立了整张 GPU 的性能基线,在同一张 GPU 上运行了两个受限工作负载,检查了每个 Pod 的显存使用情况,并验证了超过限制的分配请求会被拒绝。当工作负载所需显存不超过限制时,分片可以提高现有容量的利用率。要在生产环境中采用该方法,还需要实施隔离控制并进行性能测试。
要重复此实验,请克隆 AWS Samples 存储库 ,并将您的结果与其中经过验证的证据进行比较。请查阅 GPU Fractioning Operator 文档 以及 Amazon EKS 加速型 AMI 指南 ,然后再根据您的工作负载调整此示例。
本文的内容和观点仅代表第三方作者,AWS 不对本文内容或其准确性负责。