 AI 热点
发布于 2026 年 11 月 19 日
推出 Together Storage Accelerator:为您的 GPU 集群提供快速、免费的数据缓存每个 GPU 节点均配备分布式缓存:暖缓存读取速度提高约 20 倍,每个集群仅从源站获取一次数据,且无需更改应用。Together GPU Clusters 免费提供。
作者
Pavneet Ahluwalia、Vinamra Jain
目录
GPU 的速度取决于数据管道的速度。每次训练运行都要先花 30 分钟下载模型,每个节点都要从全国另一端重新拉取相同的数据集,每次 Hugging Face 的速率限制导致作业停滞,都会让计算资源闲置,在等待数据的同时仍不断产生费用。
今天,我们正式推出 Together Storage Accelerator(TSA)。这是面向 Together GPU Clusters 的分布式缓存层,可减少从对象存储和 Hugging Face Hub 重复读取数据的需要,大幅加速 AI 数据管道,同时降低数据出站费用。现在,每个 Together GPU Cluster 均可 免费 使用 TSA。
问题:数据距离 GPU 太远
大多数 AI 团队将权威数据源保存在对象存储中(Amazon S3、Cloudflare R2、Together AI 的 T4*),或直接从 Hugging Face Hub 拉取模型。这意味着每次冷启动都要付出广域网代价:跨云或跨区域读取速度慢、费用高(AWS 的数据出站费最高可达 0.09 美元/GB),而且受到速率限制。当数百个节点拉取同一个检查点时,浪费会不断累积,既耗费时间和金钱,还可能因源站限流而导致作业失败。
*T4 是 Together AI 部署在数据中心内、兼容 S3 的对象存储解决方案,目前处于限量预览阶段。如有兴趣试用,请联系销售人员或您的客户团队。
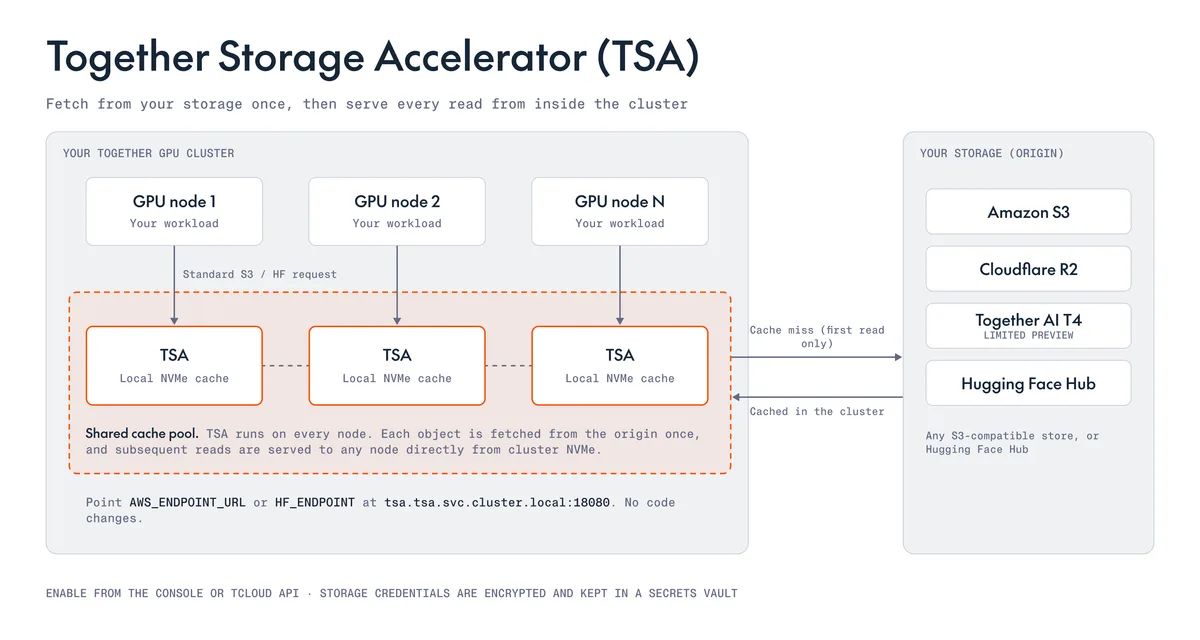
TSA 缓存数据,提升性能、可靠性并降低成本
TSA 为 GPU 集群提供分布式缓存层。它运行在集群的每个 GPU 节点上,并为您现有的存储提供可直接替换使用的端点。任何节点首次读取对象时,TSA 都会将其缓存在集群 NVMe 上。因此,此后来自任意节点的每次读取都会在集群内部以快得多的本地速度完成。
在 Together GPU Cluster 的 H100 节点上测得的结果如下:
- 暖缓存读取速度提高约 20 倍 ,相比从跨云源站拉取数据,每个节点的速度最高可达 3.4 GB/s。从 Cloudflare R2 下载一个 2 GiB 对象需要 13–15 秒,而从缓存读取只需 0.6–0.7 秒
- 冷读取不会产生额外费用:首次通过 TSA 读取的用时与直接下载相比相差不到约 5%
- 每个集群仅从源站获取一次。 由 200 个节点拉取的 70 GB 检查点只会从源站下载一次,而不是 200 次
- 抵御服务中断和速率限制。 即使上游无法提供服务,缓存的数据仍可继续供应。
您可以开始使用 TSA, 而无需对应用进行任何更改。无需新 SDK,也无需重写数据加载器,只需一条命令即可开始使用。
开始使用:
# S3-compatible storage (S3, R2, T4, ...)
export AWS_ENDPOINT_URL=http://tsa.tsa.svc.cluster.local:18080

# Hugging Face Hub
export HF_ENDPOINT=http://tsa.tsa.svc.cluster.local:18080
现有的 boto3 代码、transformers 调用和 CLI 工作流均可照常使用。TSA 使用您配置的凭据处理身份验证。凭据会经过加密,并安全地存储在密钥保管库中。
实测结果
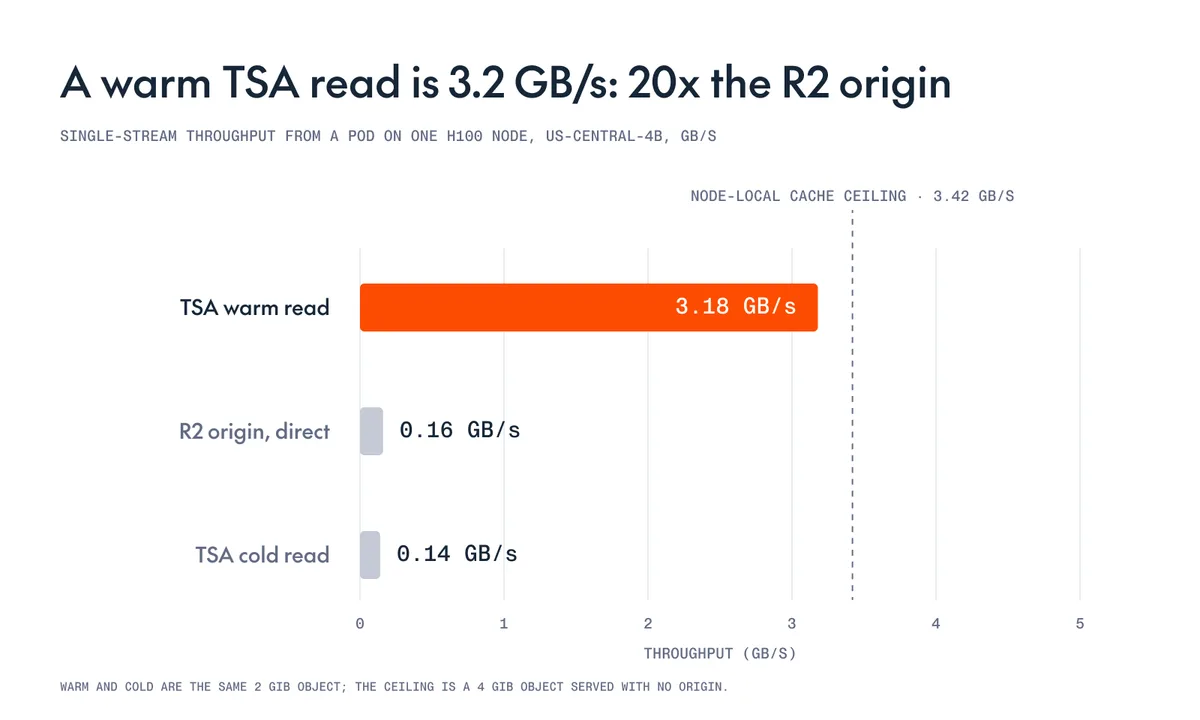
于 2026 年 10 月 28 日在 Together GPU Cluster(us-central)中某个 H100 节点上的 Pod 内测得。除非另有说明,均为单流读取;客户端将数据写入 /dev/null 或节点 NVMe。
- 从跨云存储桶(Cloudflare R2)读取一个 2 GiB 对象: 不使用 TSA 时为 143–169 MB/s(12.7–15.0 秒),使用 TSA 暖缓存时为 3.0–3.4 GB/s(0.64–0.72 秒)。 ~20×
- 从同一个存储桶读取小文件(5 KB、2.4 MB): 不使用 TSA 时分别为 320 毫秒和 680 毫秒,使用 TSA 暖缓存时分别为 5 毫秒和 8 毫秒。 ~60–80× 延迟更低
- 由 200 个节点组成的集群拉取同一个检查点: 不使用 TSA 时从源站获取 200 次,使用 TSA 时仅获取 1 次。 200× 出站流量更少
数据测自 Together GPU Clusters 的预览部署环境(TSA chart 0.6.0);实际结果取决于源站、对象大小和网络路径。源站速度存在地区差异:同一个 Hugging Face 下载任务在 us-central 的速度比 ca-west 快 5 倍,因此源站越慢,TSA 带来的提升越大。测试方法:在 GPU 节点上的 Pod 内使用单流 curl 和 aws s3 cp,重复读取同一个对象,并通过 MD5 与直接下载的数据进行校验。
由 ASTRA 提供支持
TSA 利用了 ASTRA (Accelerated Storage Transport & Retrieval Architecture,加速存储传输与检索架构)。这是我们为向全球一些规模最大的 GPU 机群供给数据而构建的分布式缓存技术,我们自己的推理机群也在使用。我们将在即将发布的工程文章中深入介绍 ASTRA 的技术细节。
与 T4 搭配使用,效果更佳
TSA 可与任何兼容 S3 的存储配合使用,并且能与 T4——Together AI 的托管对象存储解决方案——自然结合。现在,无需迁移数据,只需将 TSA 指向现有的 S3 或 R2 存储桶即可。当您希望暖数据永久存放在 GPU 附近时,只需更改一项配置即可切换到 T4。T4 目前处于 限量预览阶段:请联系销售人员或您的客户团队以申请使用权限。
开始使用
Together Storage Accelerator 现已在 Together GPU Clusters 上推出,无需支付额外费用。您可以在集群的“Settings”页面启用它,也可以参阅 文档 ,在不到十分钟内从零开始启用加速。
→ 创建集群
→ 阅读文档