 AI 热点
- 公告
- 九家创始成员加入 SGLang 联盟
- SGLang v1.0 为生产推理树立下一个里程碑
- Miles v0.2 将强化学习扩展到更多硬件与工作负载
- SGLang 为 NVIDIA NIM 认证微服务提供支持
- 与 Intel 的合作及 AWS Trainium 预览扩展硬件支持
- 征集安全合作伙伴
- 演讲中的主题
- 硬件合作伙伴推动 SGLang 跨平台发展
- 生产经验成为焦点
- AI 领袖探讨下一步发展
- 分组会议:为智能体时代构建引擎
- 动手实践工作坊让 SGLang 和 Miles 投入实际应用
- 与 SGLang 社区共度的时刻
- 展台
- GPU 展区
- 展台之外
- 致谢
11 月 12 日至 13 日,超过 2,000 名开发者、研究人员和行业领袖齐聚旧金山 Fort Mason,参加首届 SGLang 峰会。本次活动汇聚了构建 SGLang 和 Miles 的开发者、在生产环境中运行它们的团队,以及帮助它们拓展到新平台的硬件合作伙伴。在主舞台、技术会议、动手实践工作坊和展区,社区分享了当前行之有效的做法以及下一步需要推进的方向。
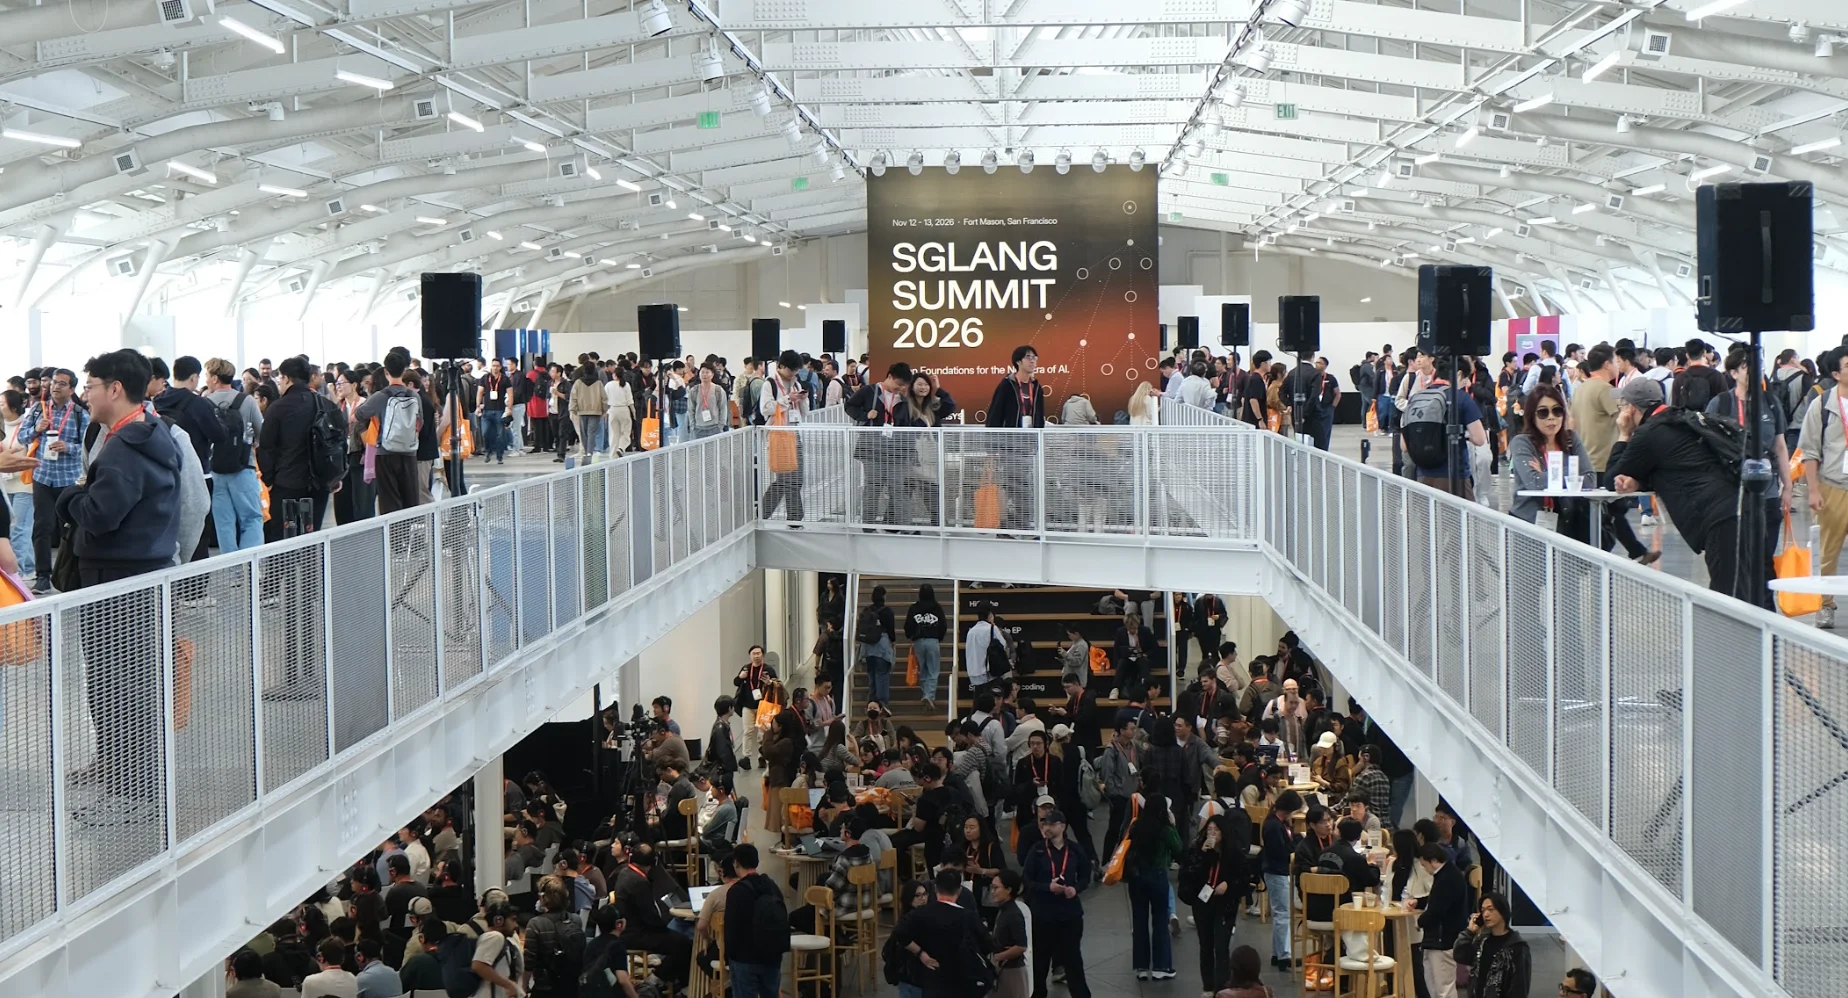
本次峰会标志着多个里程碑:SGLang 联盟成立并迎来九家创始成员、SGLang v1.0 发布,以及 Miles v0.2 发布。同样宝贵的是围绕这些公告的工程经验与交流,从服务前沿模型、扩展强化学习,到为能力日益增强的智能体构建基础设施。以下是两天共同构建与学习的亮点。
公告
九家创始成员加入 SGLang 联盟
在开幕演讲中宣布,NVIDIA、AMD、Intel、Google、Meta、Thinking Machines Lab、Cloudflare、Modal 和 RadixArk 作为创始成员加入 SGLang 联盟。
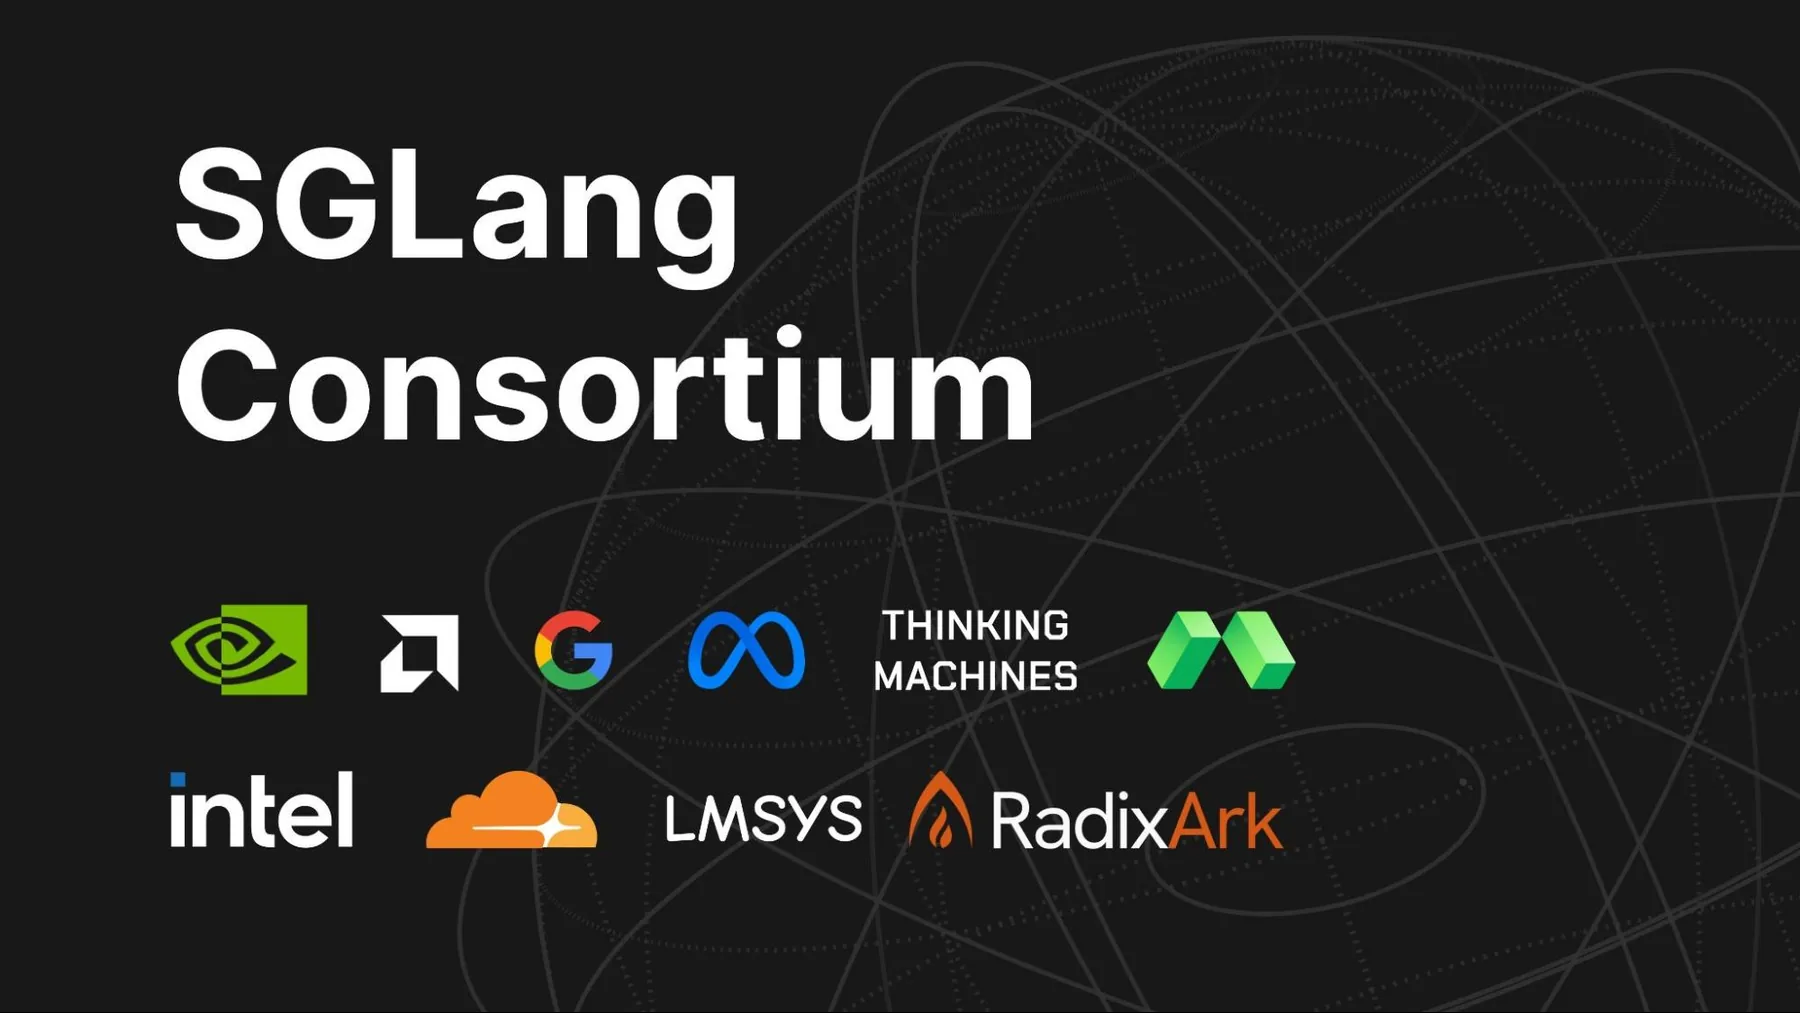
该联盟为成员建立了一个常设论坛,与 SGLang 维护者共同商讨工程优先事项,贡献来自生产部署的经验、测试资源,并开展联合开发。其重点包括前沿模型支持、推理与多模态工作负载、分布式推理以及硬件优化。
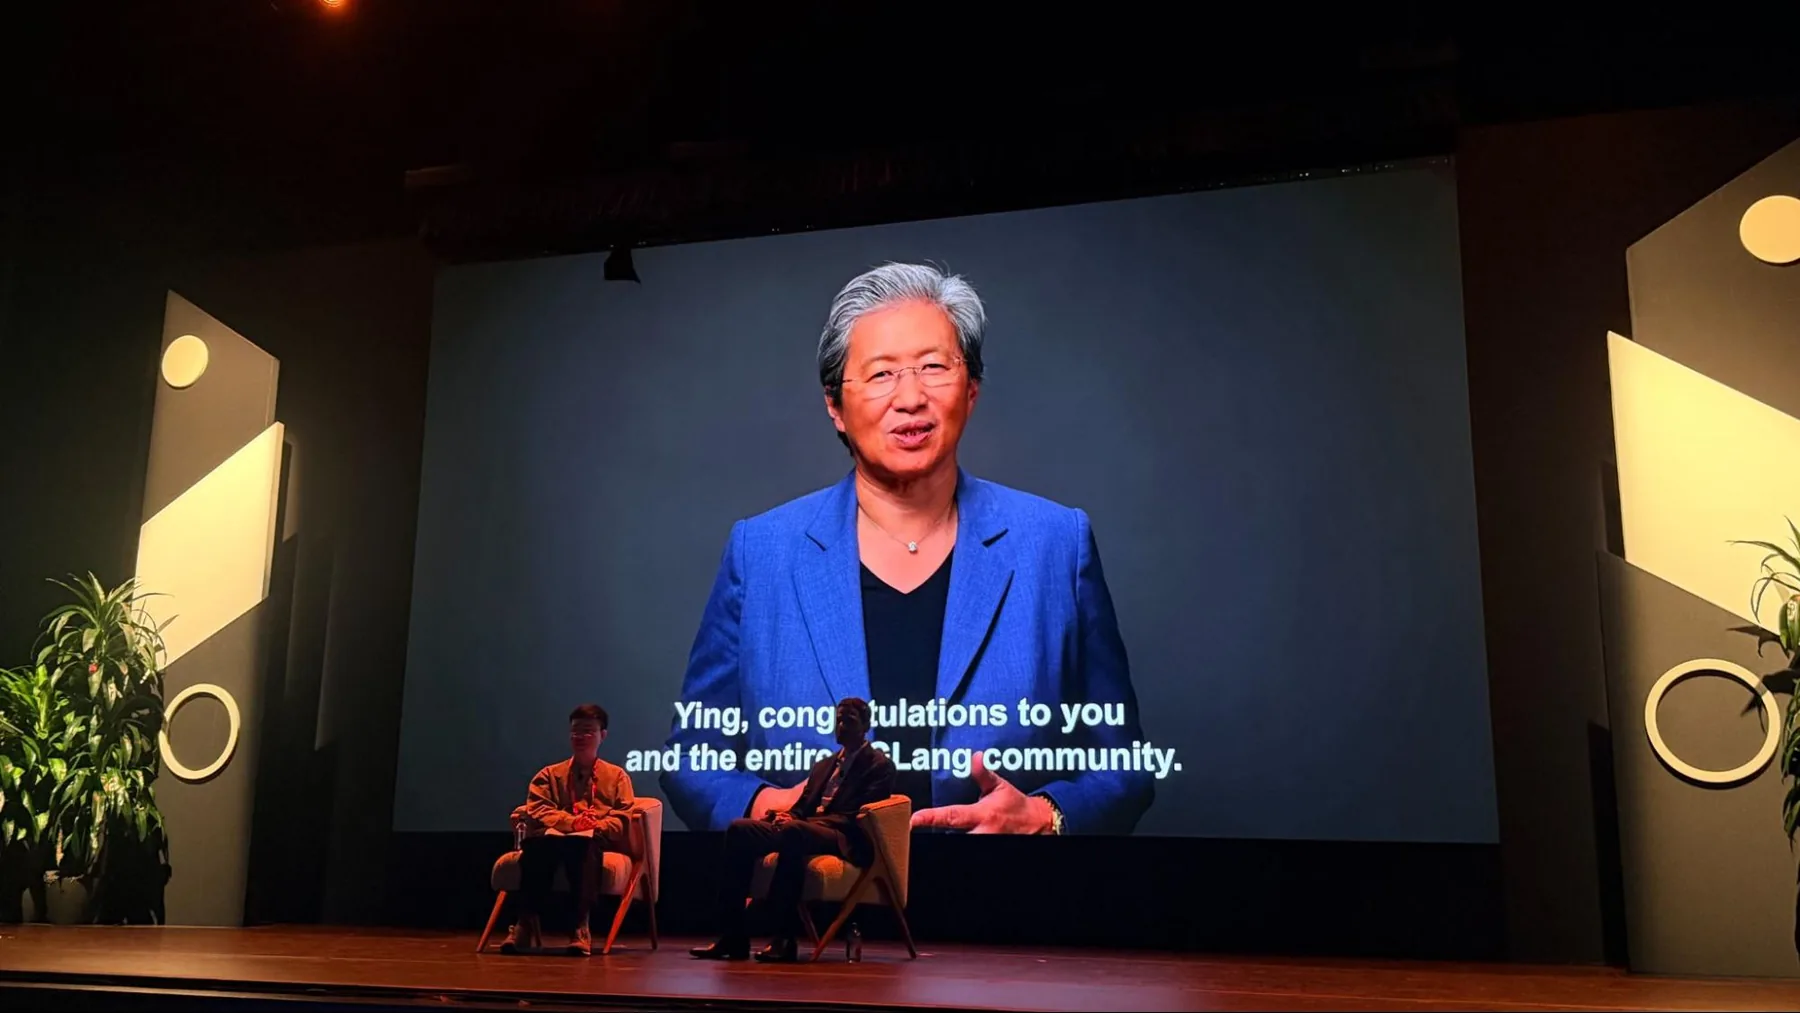
该 联盟公告 还附有 AMD 董事长兼首席执行官苏姿丰博士的视频致辞。
“在 AMD,我们坚信开放,”苏姿丰博士表示。“我们很高兴通过 SGLang 联盟深化与 SGLang 社区的合作。我们期待更直接地为该框架做出贡献,帮助开发者充分发挥其 AMD 平台的潜力。”
成员将任命技术代表并参与定期路线图讨论。SGLang 的维护者保留技术决策和代码接纳的责任,项目仍对更广泛的社区开放。
SGLang v1.0 为生产推理树立下一个里程碑
SGLang v1.0 的发布将效率和生产可扩展性置于项目下一版本的核心。相关工作聚焦于强化现有功能、清晰暴露配置问题,并为 SGLang 的后续发展确立兼容性预期。
开幕演讲将这项工作与更新模型和智能体的需求联系起来。混合模型架构需要同时管理不同类型的状态,而长时间运行的智能体会累积可能超出 GPU 内存的历史记录。统一内存管理和分层缓存通过支持跨不同类型状态和存储的复用,帮助应对这些限制。
SGLang v1.0 也标志着项目向 AI 驱动开发的转变,如今项目中大多数已合并的 PR 由智能体产出。接下来,SGLang 团队将致力于开发能够编写代码、审查 PR、构建测试、管理兼容性甚至提出路线图的 AI 工具。社区正朝着一个不断自我改进的生态系统迈进。
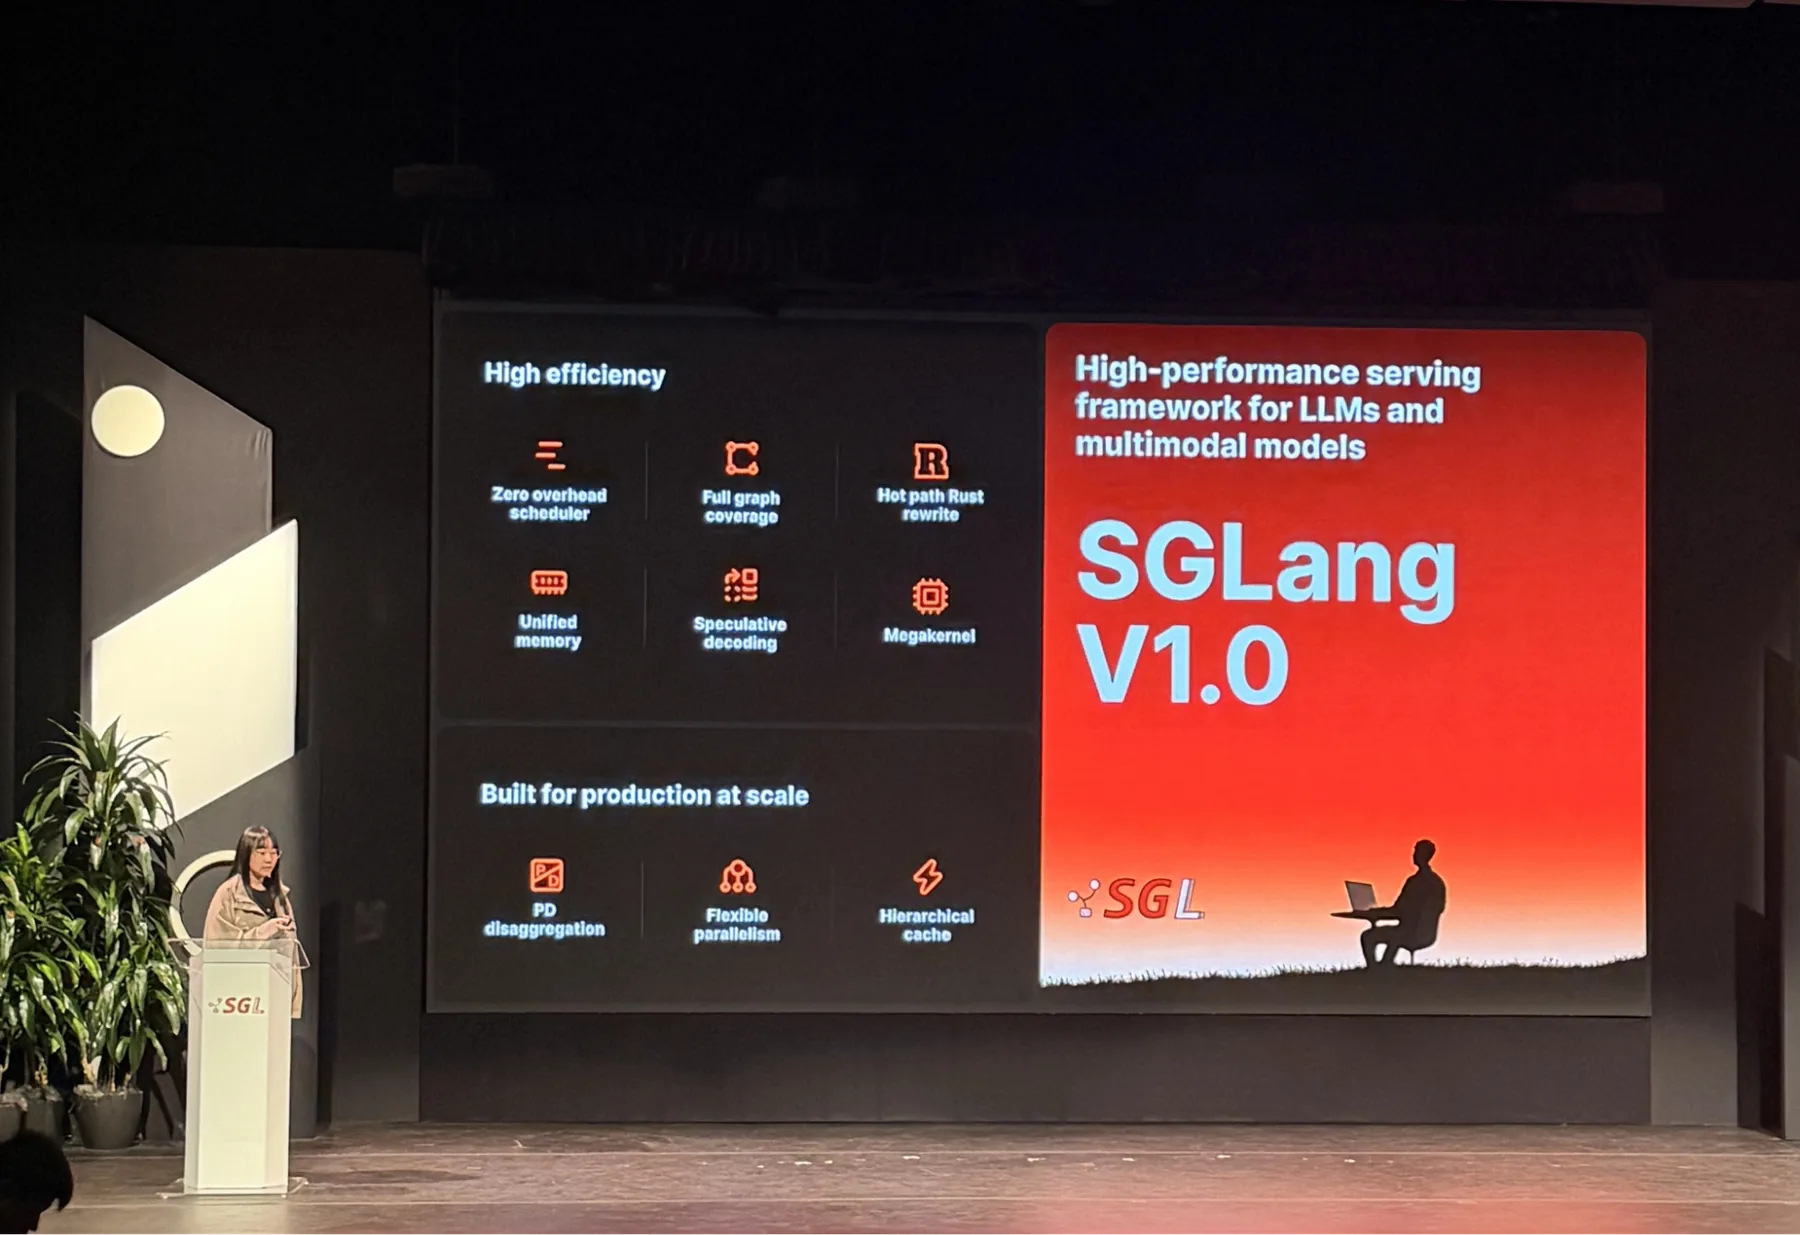
发布进展和迁移指南记录在 SGLang 1.0 发布跟踪器.
Miles v0.2 将强化学习扩展到更多硬件与工作负载
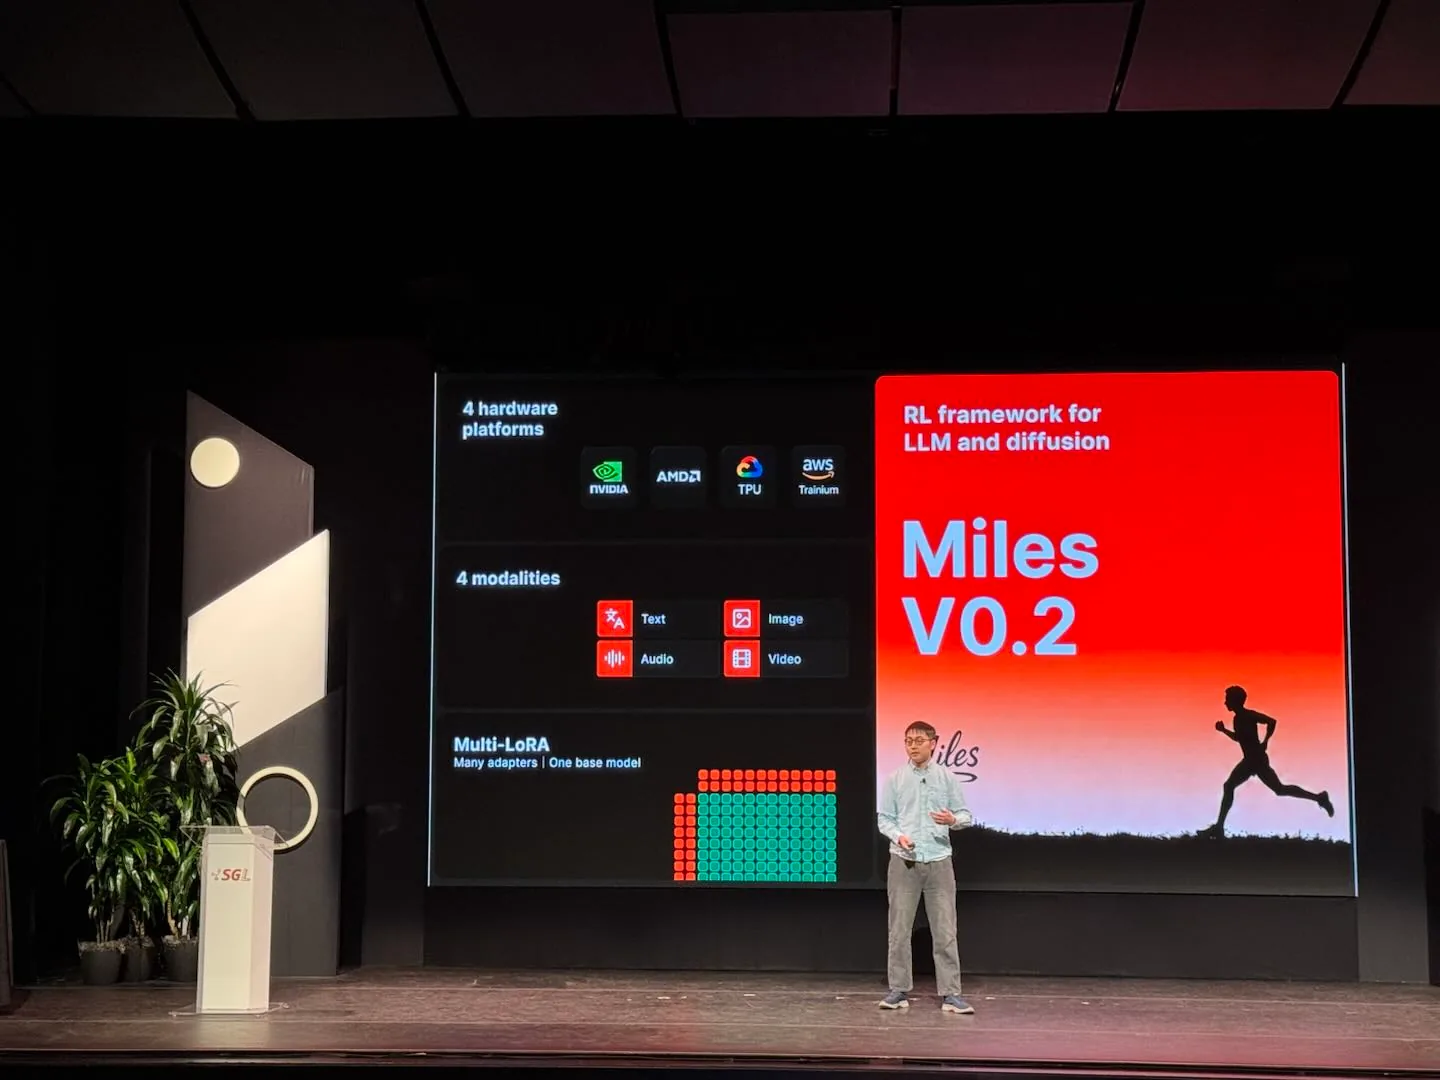
Miles v0.2 将基于 SGLang 的生产级强化学习后训练扩展到更多硬件和更多工作负载。它可在 NVIDIA GPU、AMD GPU 和 Google TPU 上运行,AWS Trainium 支持也即将推出,并可使用 Megatron-LM、FSDP 或 TorchTitan 进行训练。
除文本外,Miles 现在还支持图像、视频和音频的强化学习,Miles-Diffusion 将其扩展到扩散模型。借助 Multi-LoRA,可以切实地针对多个任务同时定制一个基础模型。
代码和实现细节可在 Miles v0.2 发布说明.
SGLang 为 NVIDIA NIM 认证微服务提供支持
NVIDIA 与 SGLang 团队宣布,SGLang 现为 NVIDIA NIM 认证微服务提供支持。NIM 将推理引擎与经过验证的容器、针对受支持模型和 NVIDIA GPU 的优化配置以及持续的安全维护打包在一起,为企业团队提供经过测试的部署起点。可通过有效的 NVIDIA AI Enterprise 订阅获得可选的企业支持。
阅读 NVIDIA NIM 公告.
与 Intel 的合作及 AWS Trainium 预览扩展硬件支持
Intel 与 RadixArk 宣布合作 ,针对 Intel 平台(包括 CPU、GPU 和加速器)优化 SGLang。这项工作强调将优化直接贡献给开源框架,通过 SGLang 为开发者提供更多部署选择。
该合作将特定硬件的工程工作引入共享软件栈,旨在让 Intel 基础设施上的生产推理更高效、更具成本效益。
另外,SGLang-Neuron v0.1.0 已开源并进入公开预览阶段。该 PyTorch 原生插件由 RadixArk 的 SGLang 团队与 Amazon Annapurna Labs 共同开发,将 SGLang 的服务栈引入 AWS Trainium,支持相应的语言模型和扩散模型。
该预览版包含异步运行时、优化内核和缓存能力。开发者可以通过 SGLang-Neuron 的 AWS Deep Learning Container 以及公开版本发布公告开始使用。 公开版本发布公告.
呼吁安全合作伙伴
随着 AI 加速软件开发,安全审查也需要同步跟进。主题演讲重点介绍了 Cloudflare 和 NEAR AI 报告的漏洞、由此推动的修复,以及为加强请求之间的隔离和保护管理访问权限而正在开展的工作。
演讲主题
硬件合作伙伴推动 SGLang 跨平台适配
硬件合作伙伴分享了他们如何让 SGLang 适配不同架构和智能体工作负载。
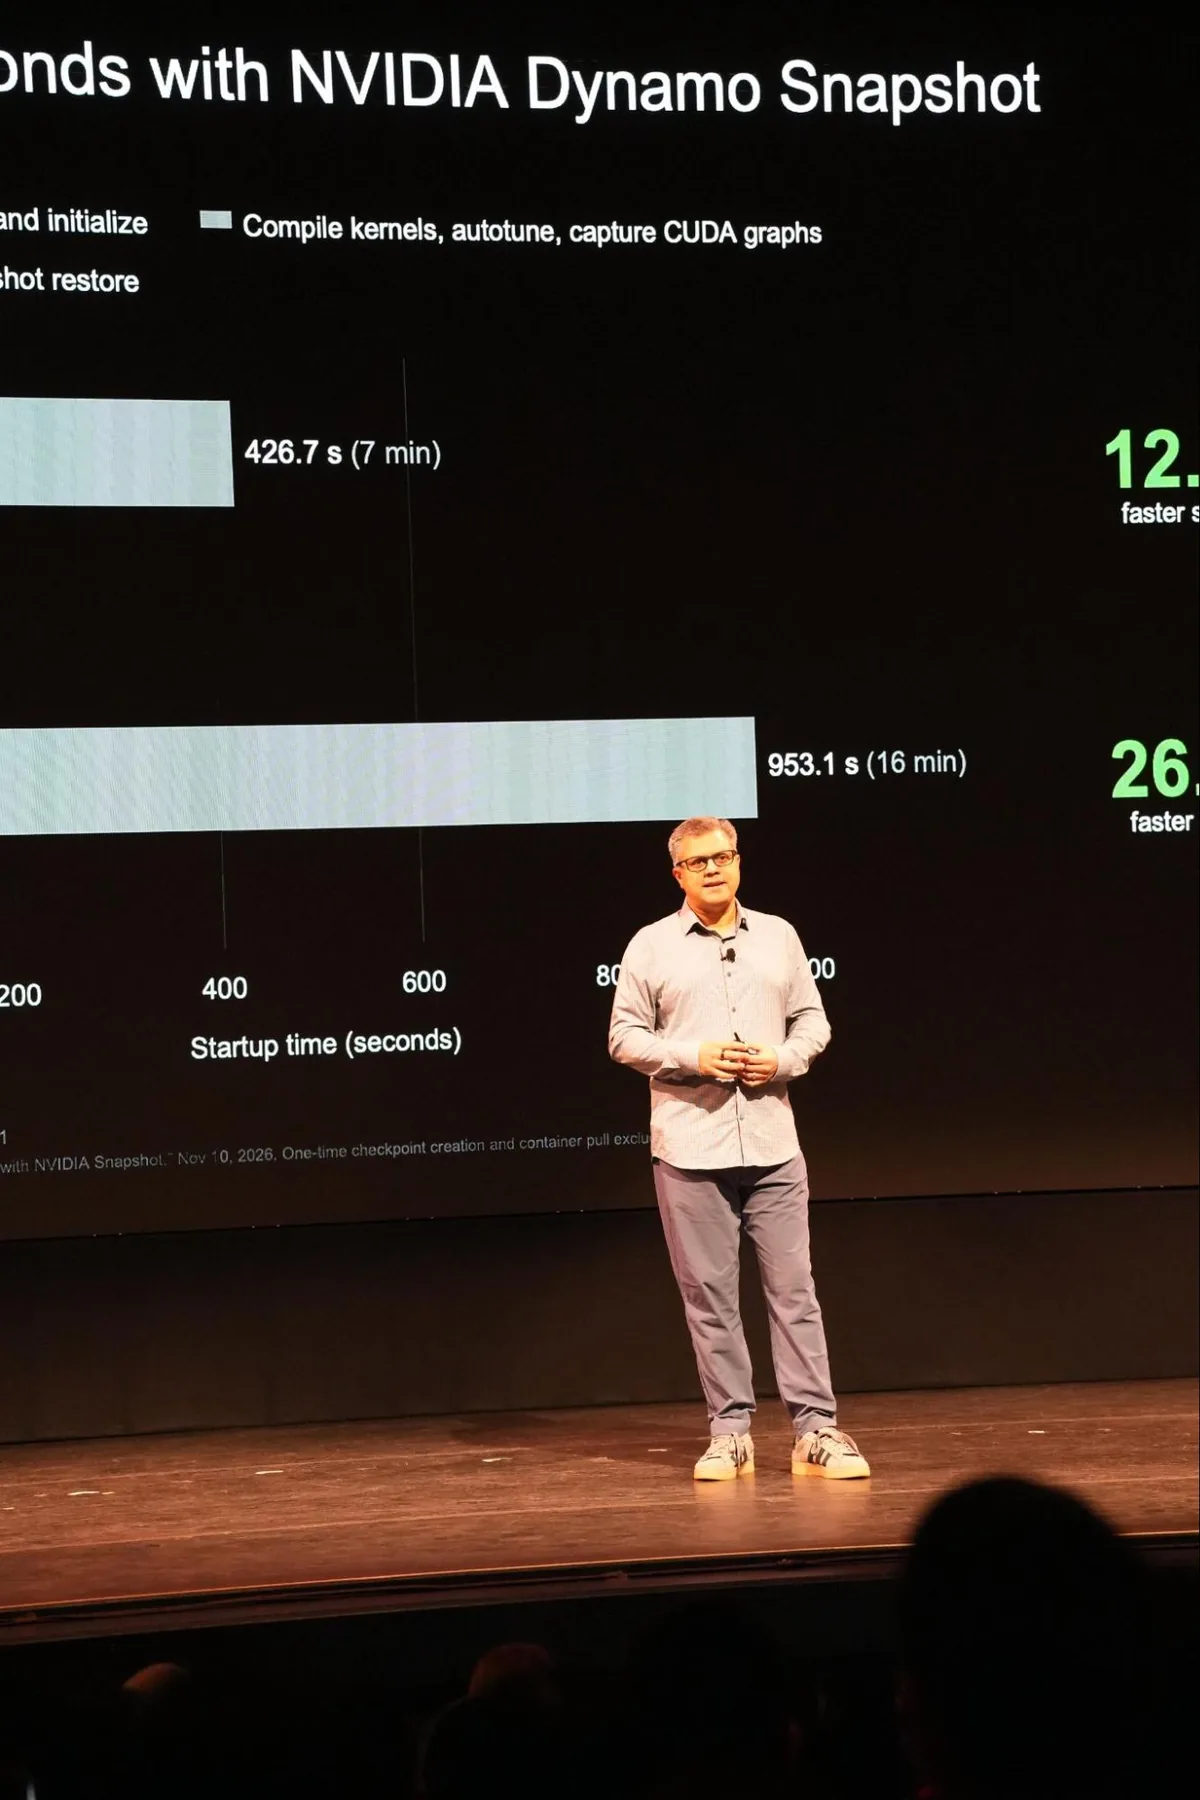
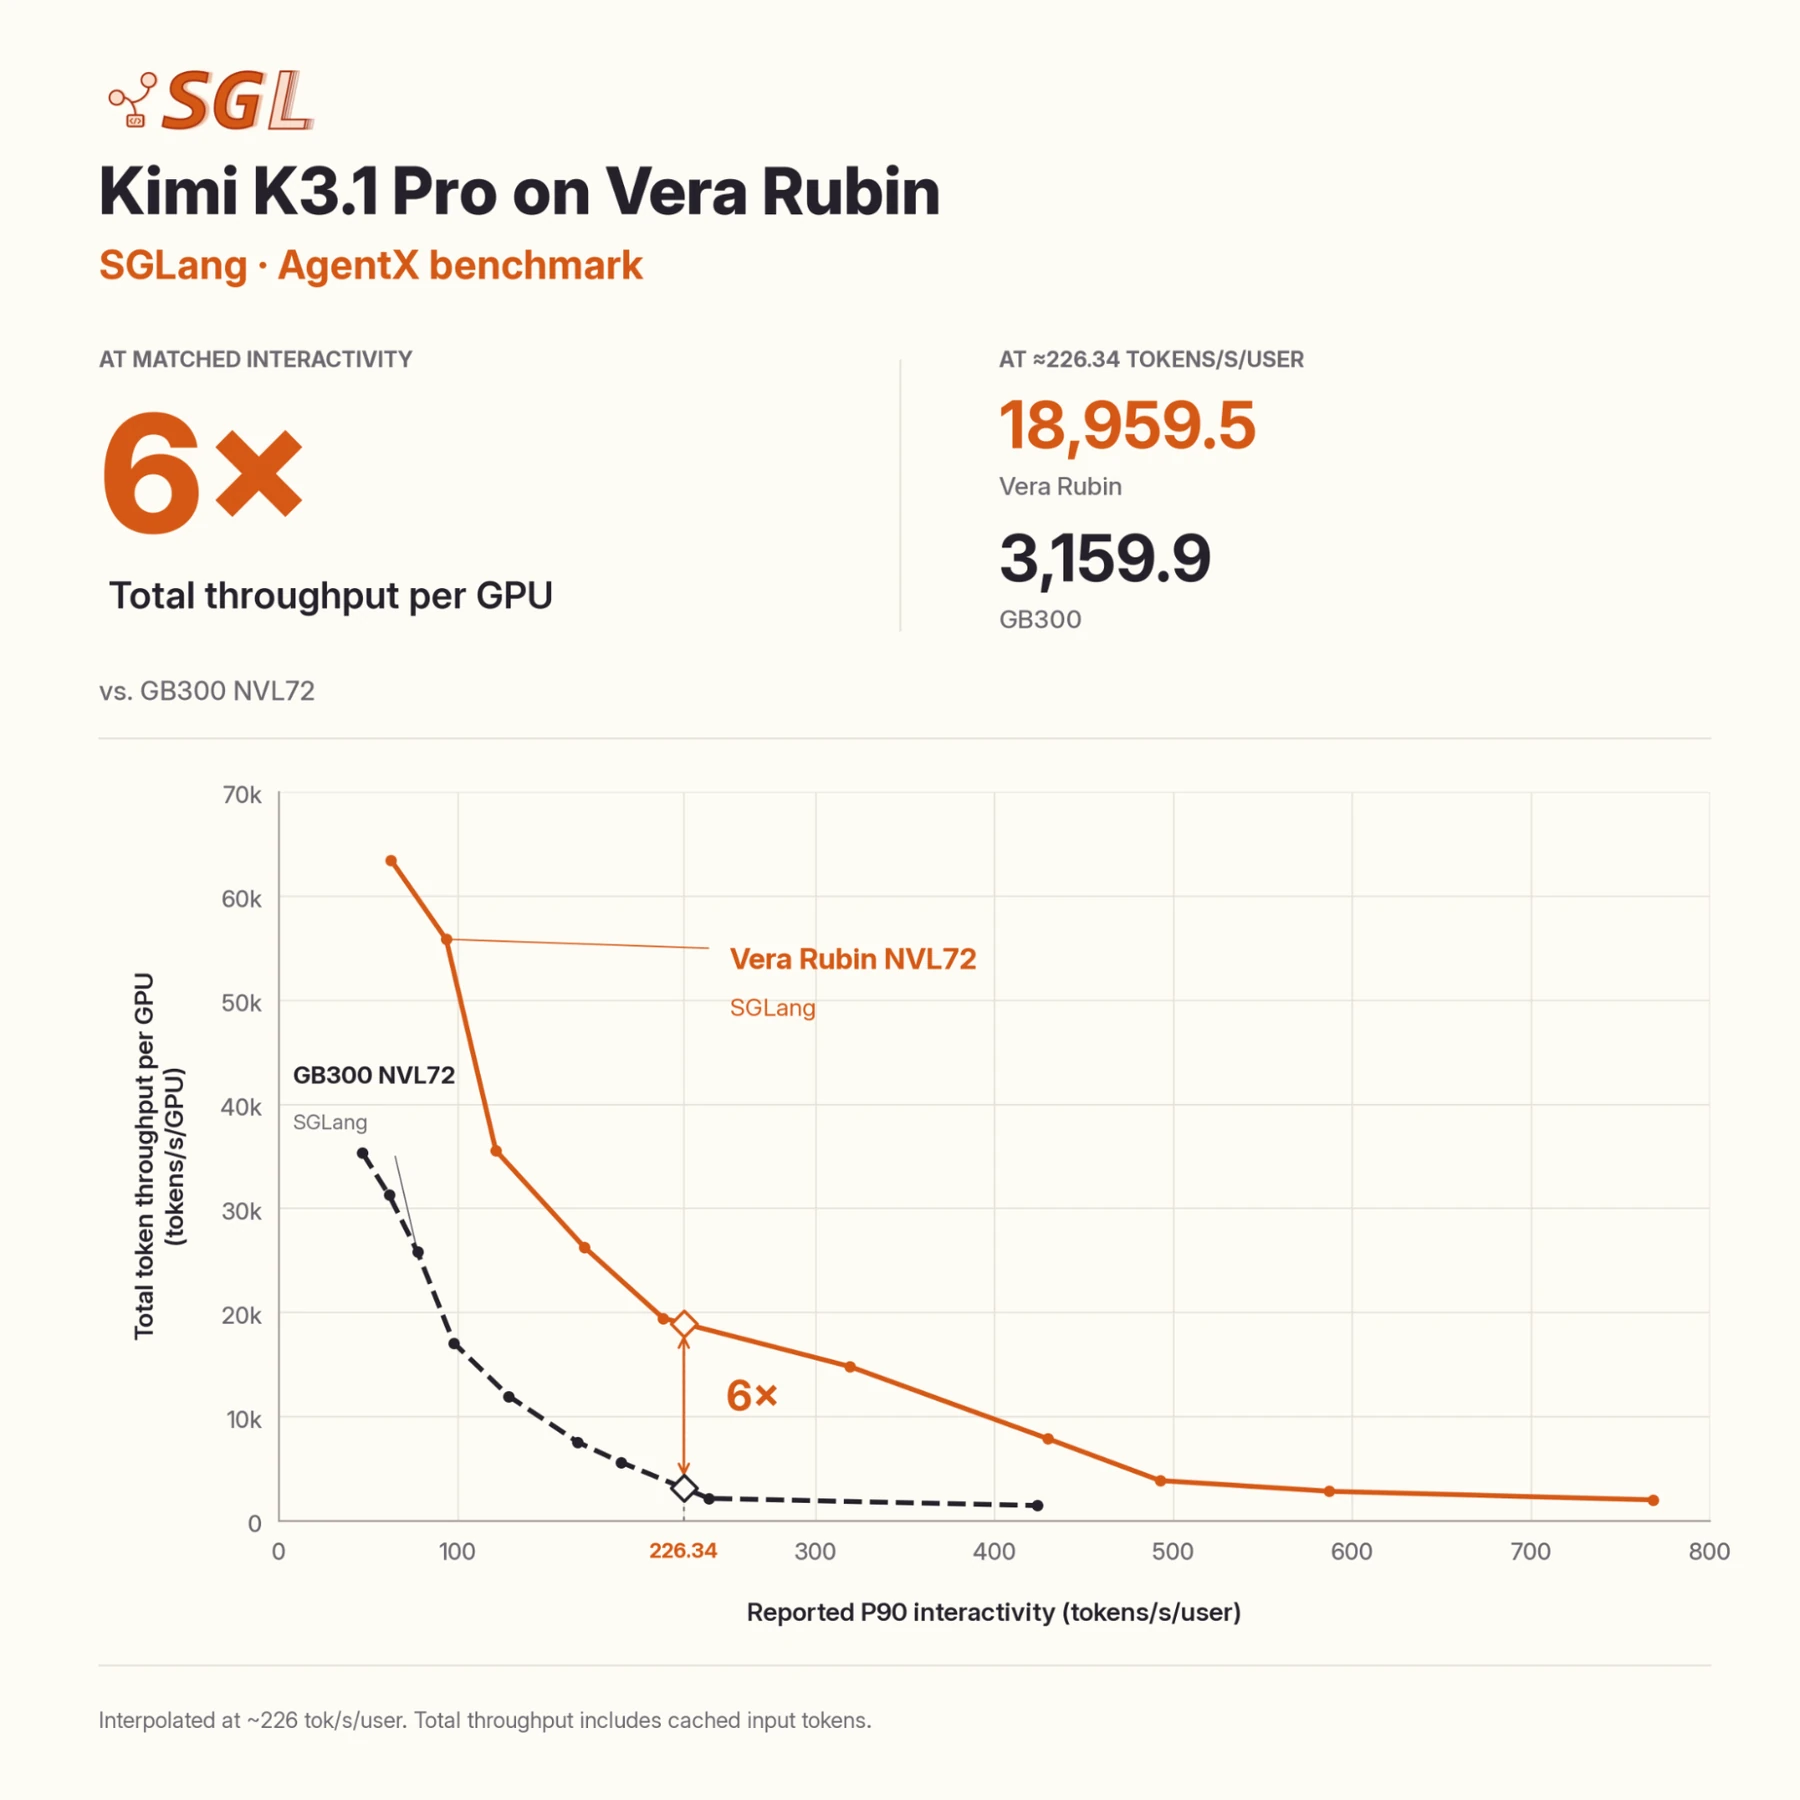
NVIDIA 的 AI 与 HPC 框架及库副总裁 Ujval Kapasi 重点介绍了在 Vera Rubin 上的工作、用于缓存感知路由和分布式服务的 Dynamo 集成,以及通过 Dynamo Snapshot 和 Model Express 加快副本启动。他还讨论了用于智能体沙箱和强化学习工作负载的 Vera CPU。
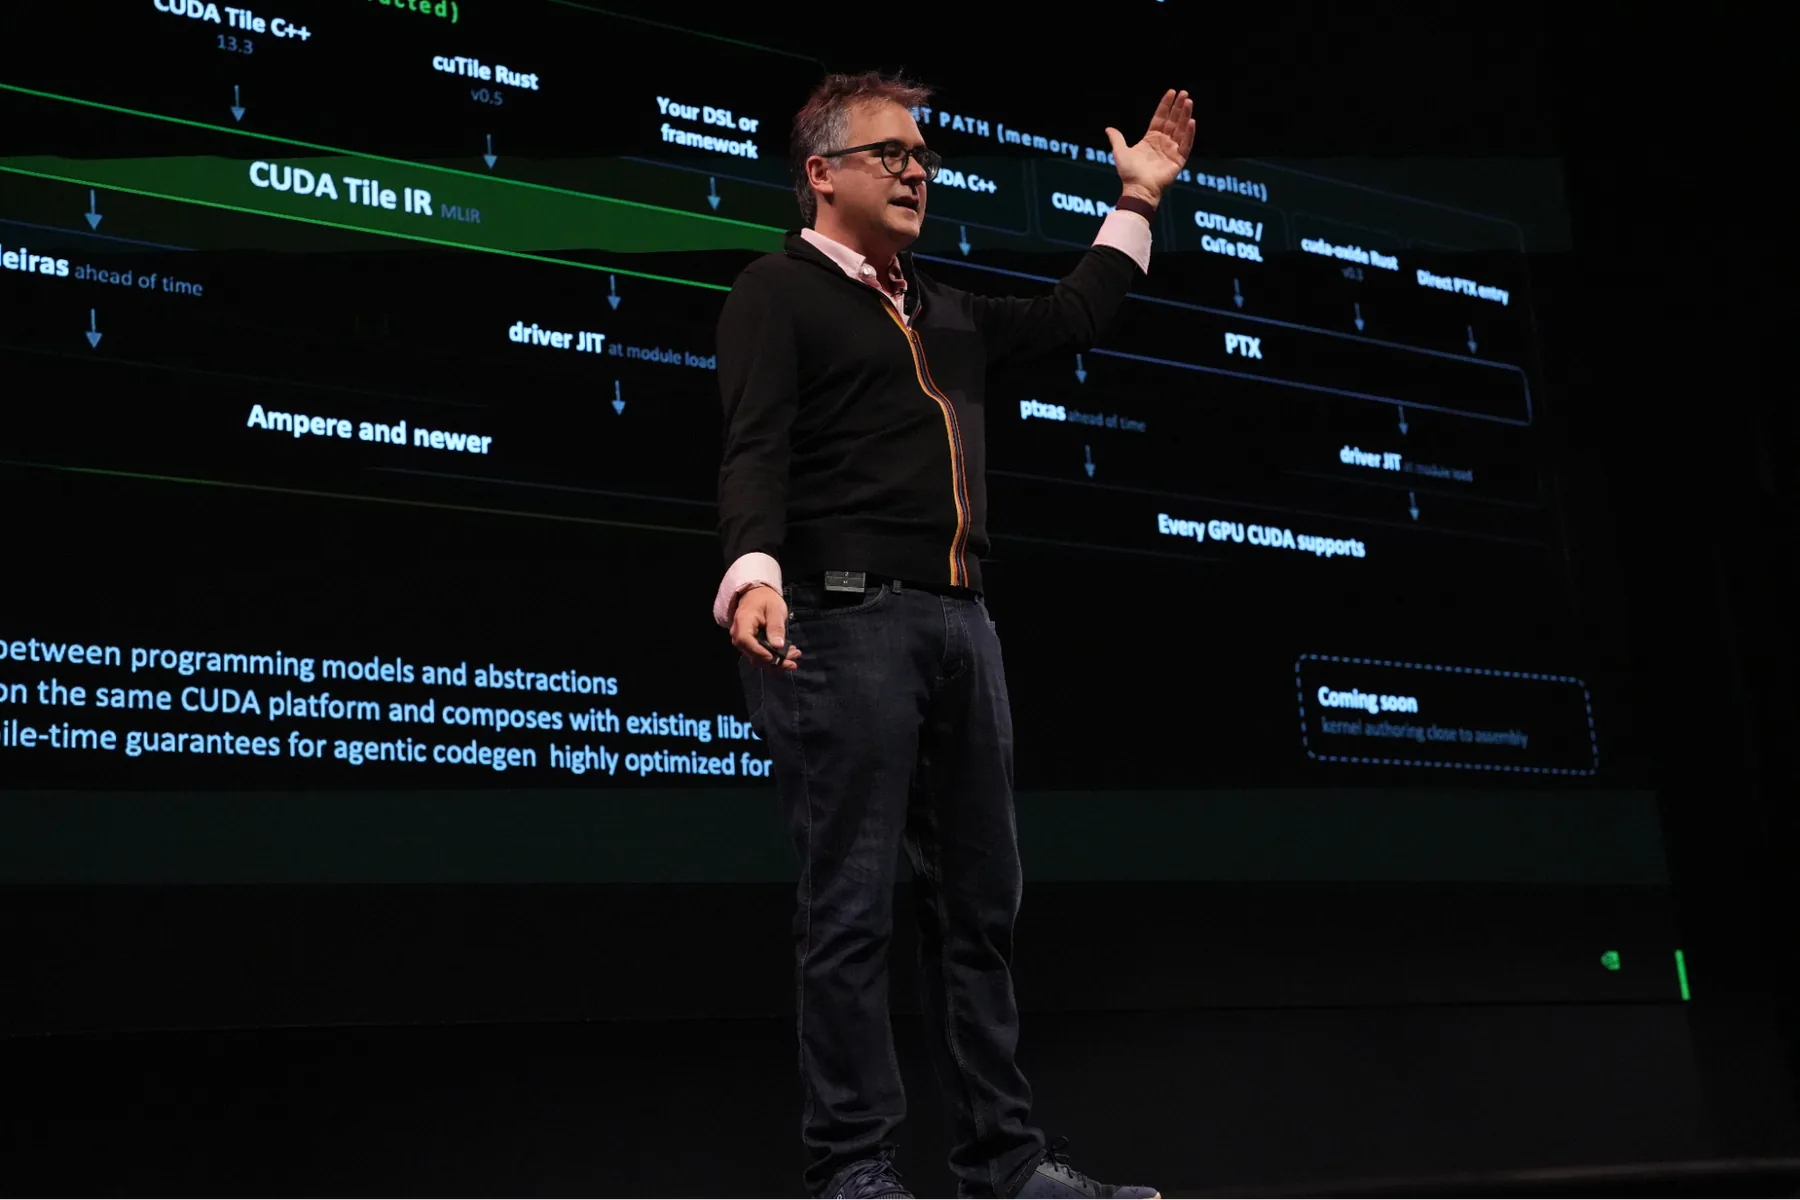
NVIDIA AI 系统软件与编译器副总裁 Luis Ceze 探讨了智能体如何加速内核优化,由编译器反馈和独立的正确性检查来指导开发,而 FlashInfer 则将改进后的内核引入 SGLang。
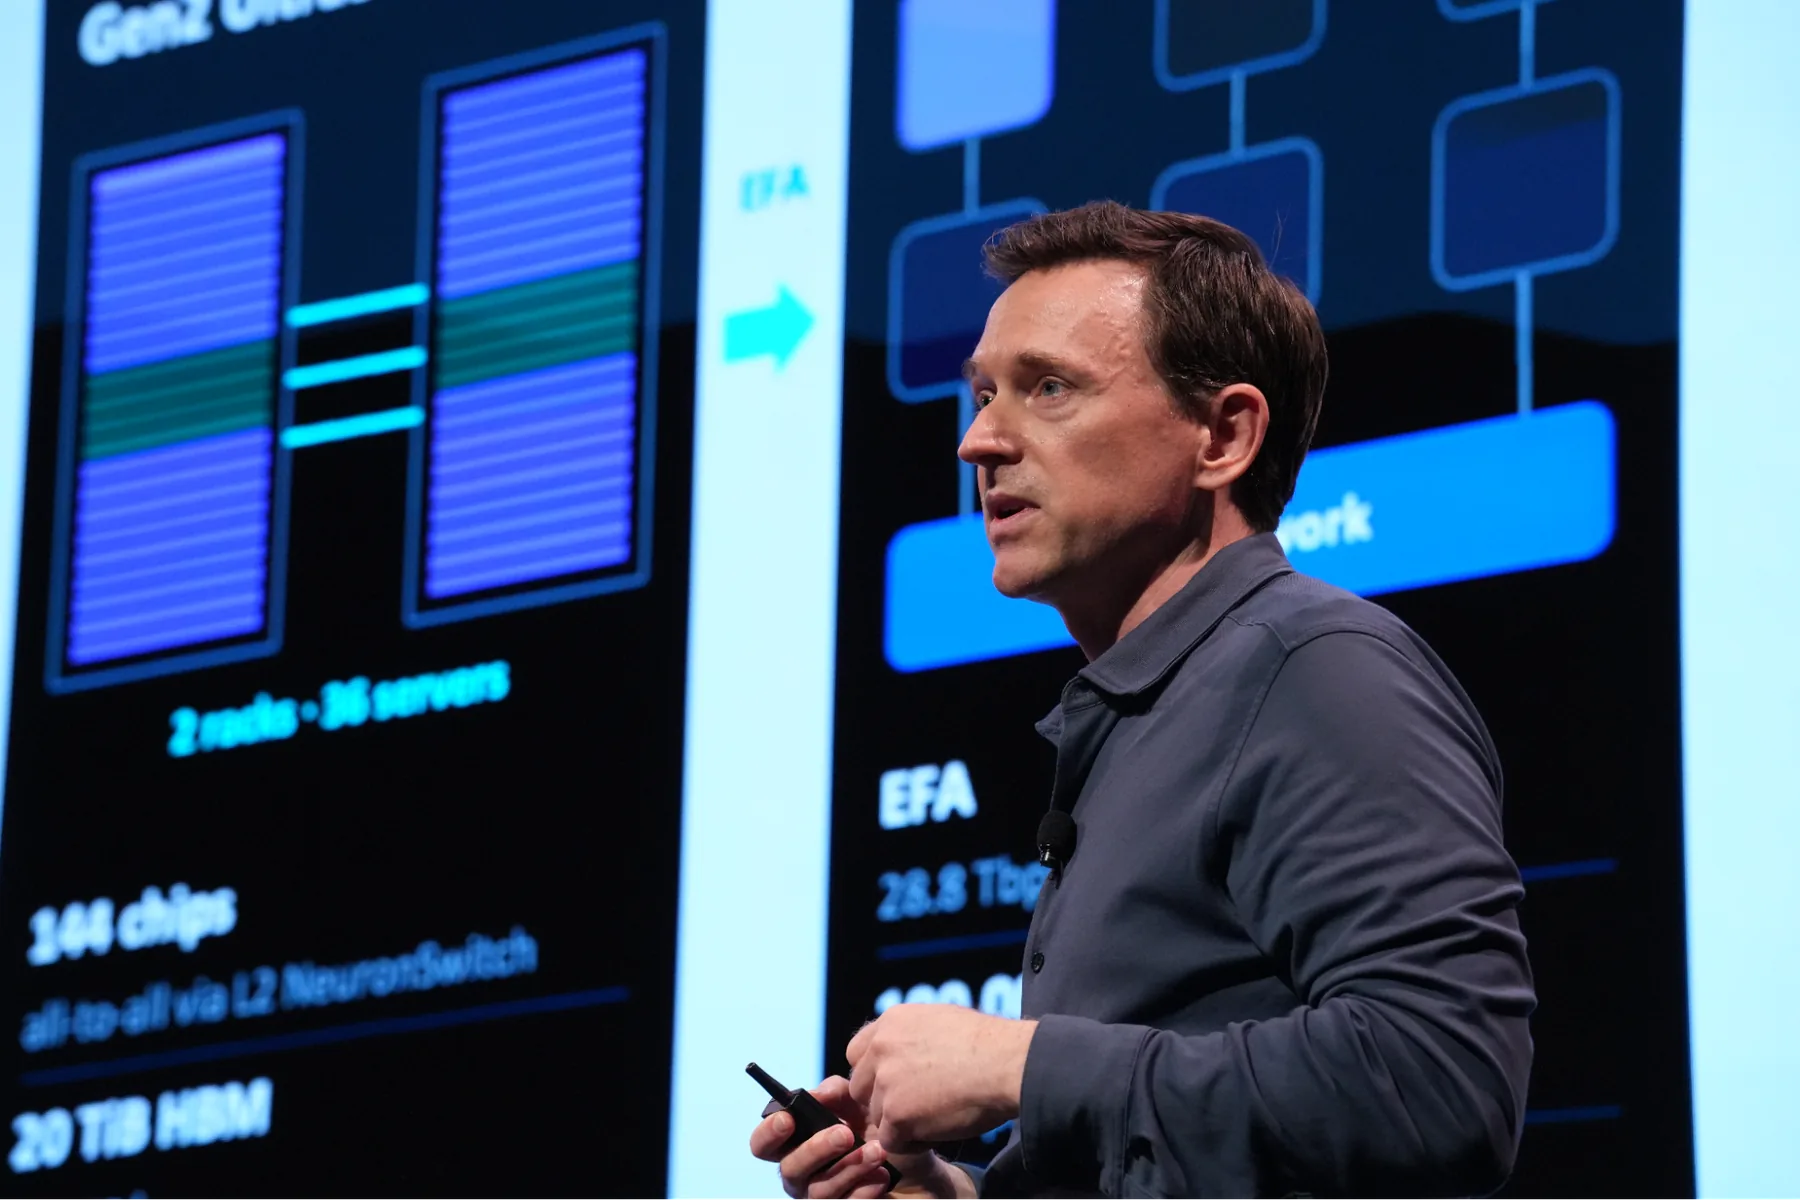
AWS Annapurna Labs 技术与软件副总裁 Colin Brace 介绍了在 Trainium 上原生运行的 SGLang,该版本由 RadixArk 使用 PyTorch 和优化的 Neuron 内核开发,并包含对 Kimi K3.1 Pro 的首日支持。Cerebras 负责推理工程的副总裁 Nancy Zheng 展示了如何将 GPU 预填充与晶圆级解码相结合,以应对推理对计算和内存的不同需求,从而将高效的输入处理与快速的 token 生成结合起来。
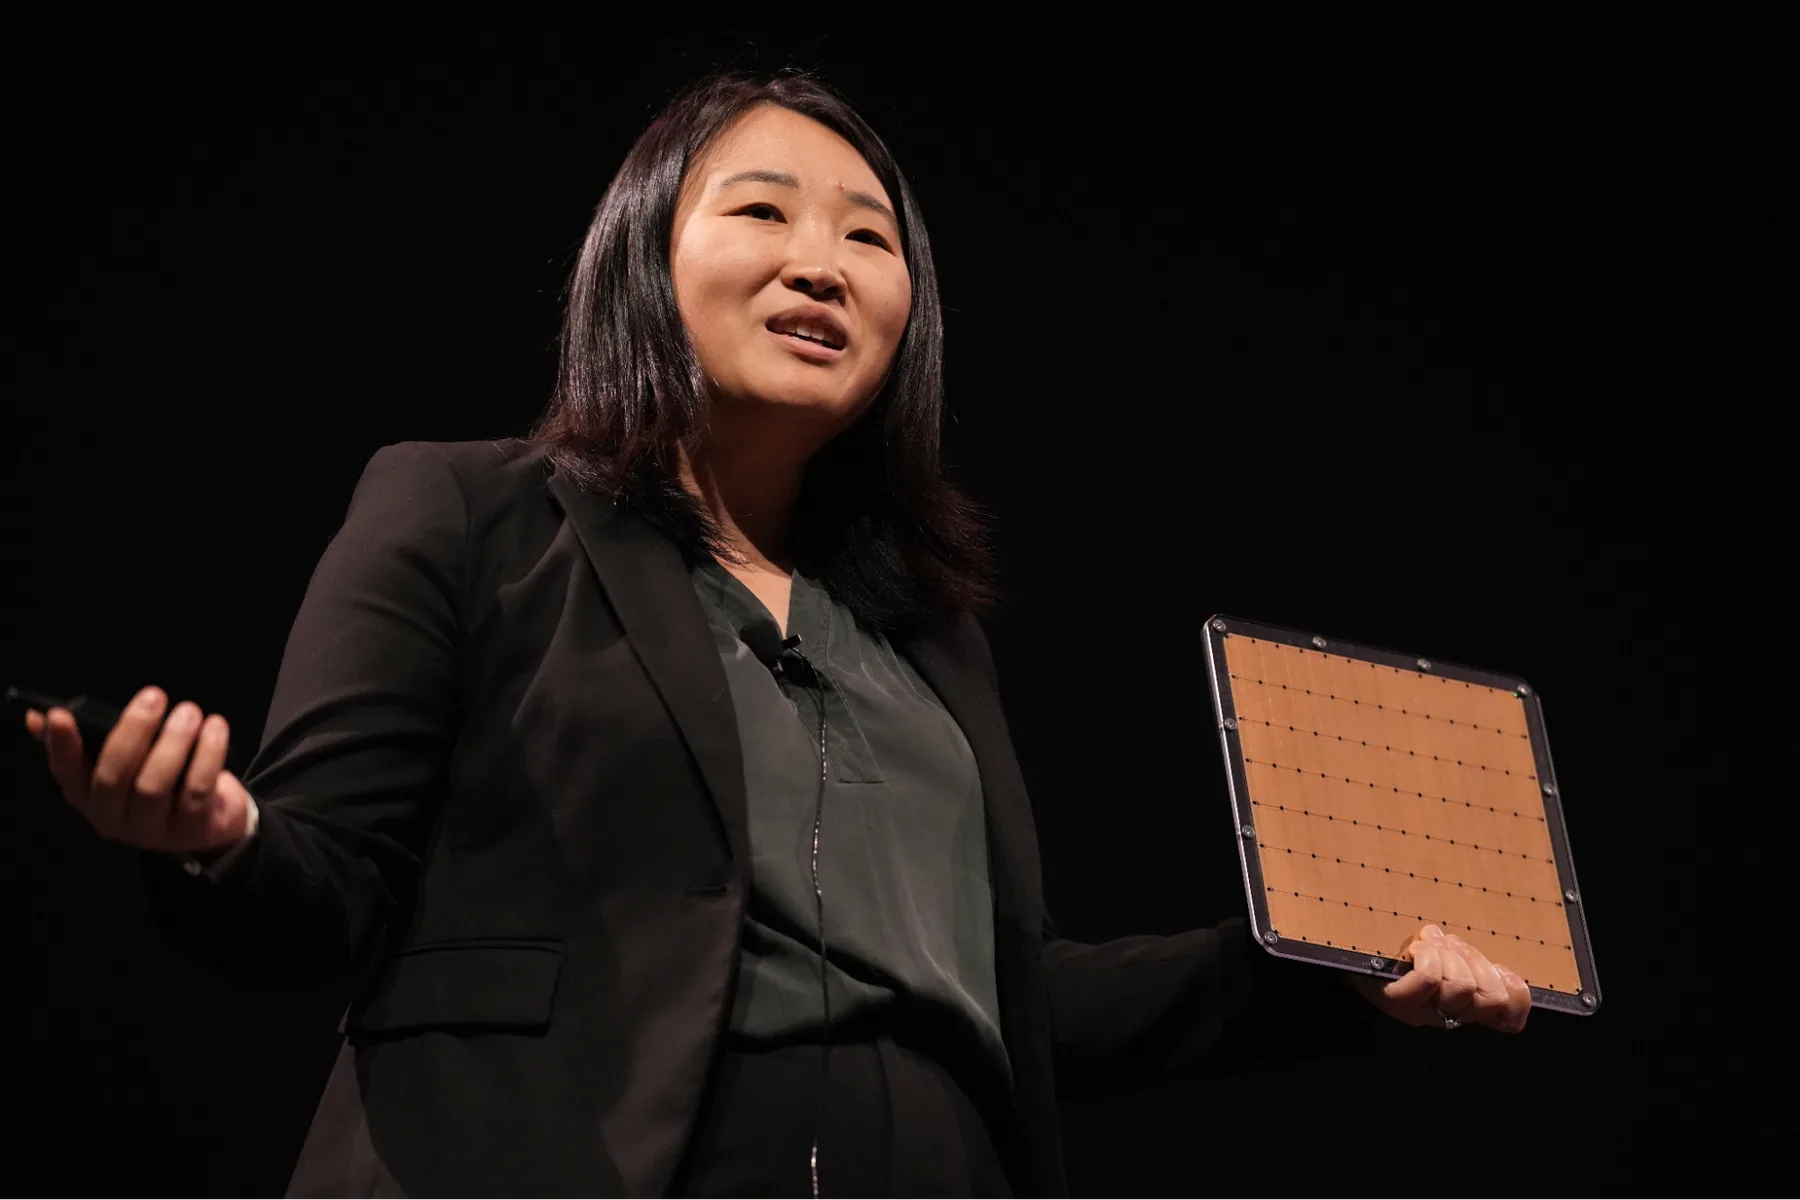
AMD 人工智能高级副总裁 Vamsi Boppana 重点介绍了 Muse Spark Open 优化以及在 AMD GPU 上对 Kimi K3.1 Pro 的首日支持,同时还介绍了在 MI455 和 Miles 上的合作。在与 Google 核心机器学习/人工智能工程副总裁 Bill Jia 的炉边对话中,双方探讨了 TorchTPU 与 SGLang 和 Miles 的合作、针对特定工作负载的 TPU 设计以及 AI 生成的内核。
这些会议共同凸显了开放软件与联合工程如何让开发者在模型的训练和部署方式上拥有更大的灵活性。
生产经验分享成为焦点
过去一年里,SGLang 从少数早期采用者成长为覆盖 AI 生态系统中 332 家组织的项目。这一增长离不开持续的工程投入:帮助团队启动新的工作负载、共同调试生产环境问题、支持更多硬件,并在一次次部署中赢得信任。每一个给 SGLang 机会、分享反馈或贡献修复的团队,都推动了这一进展。
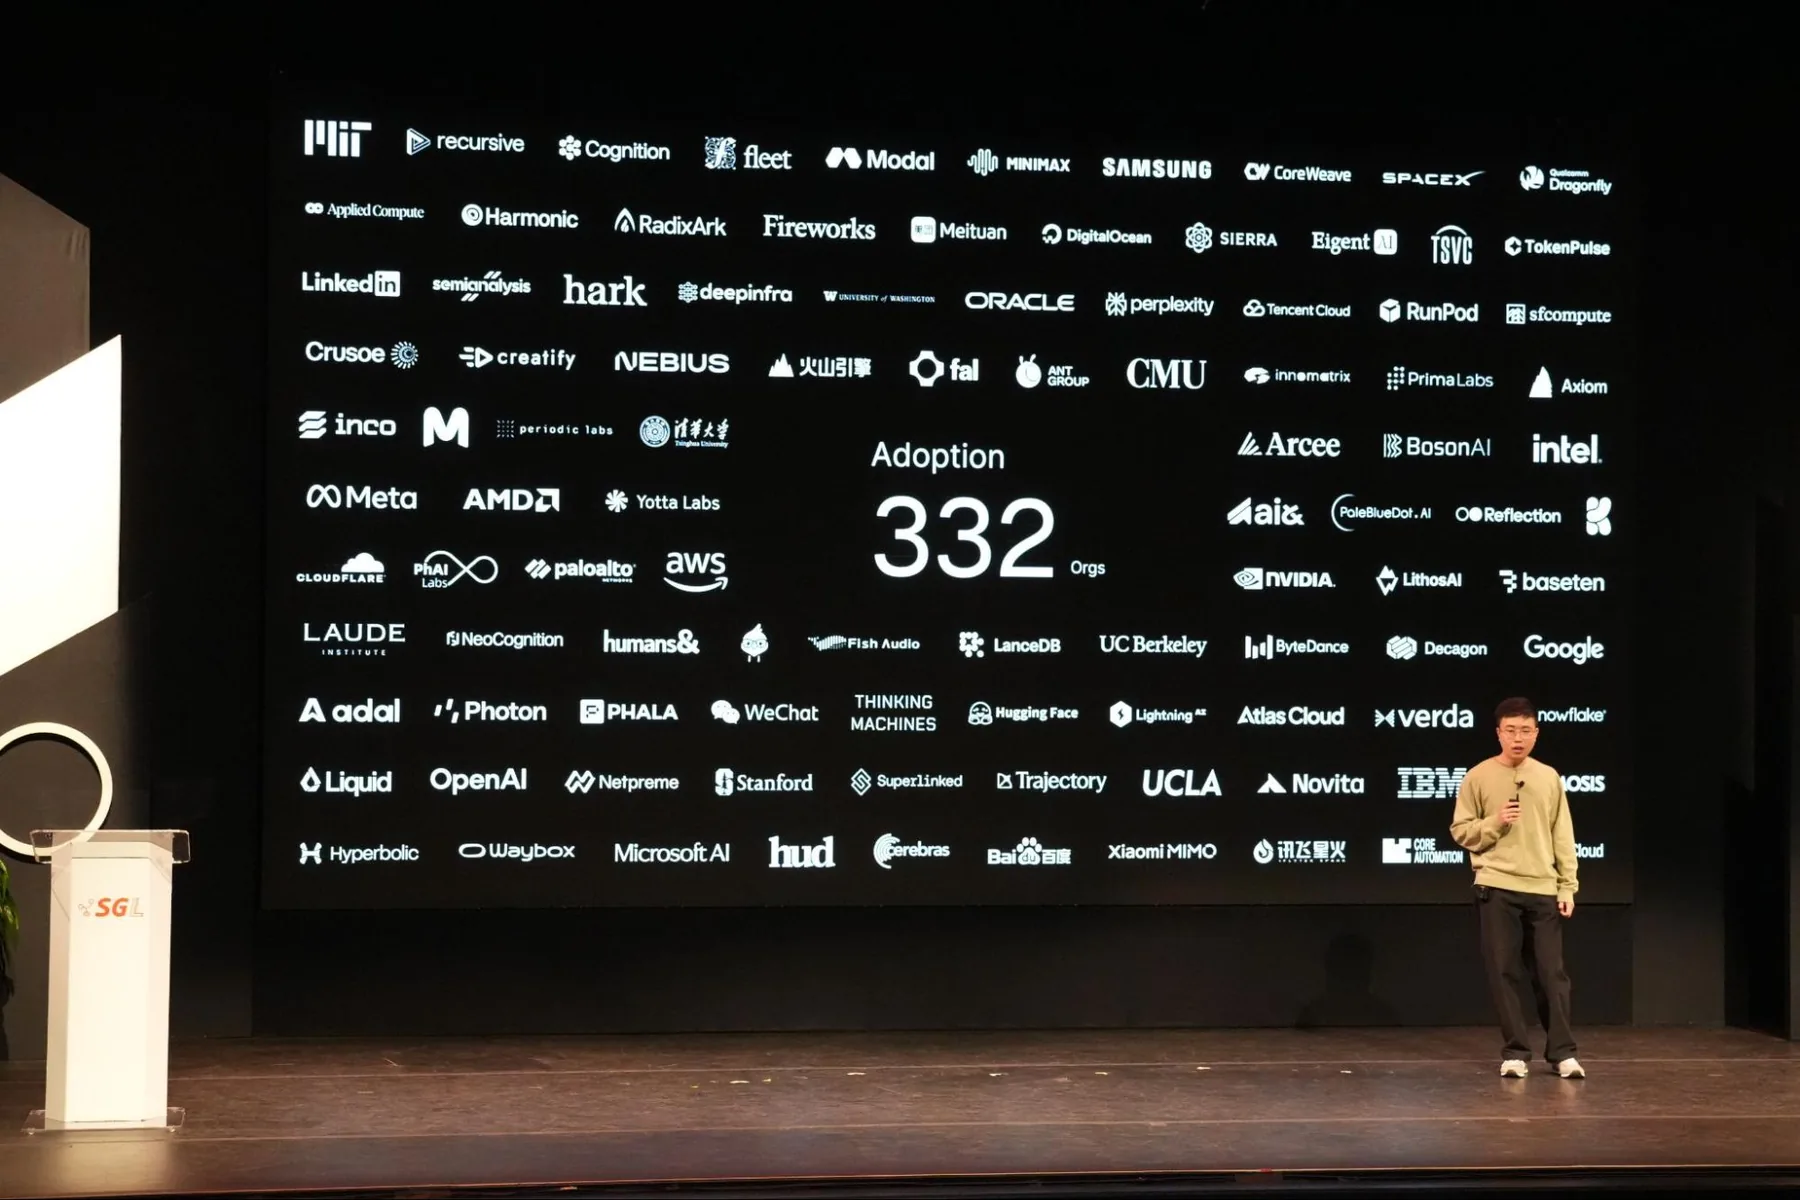
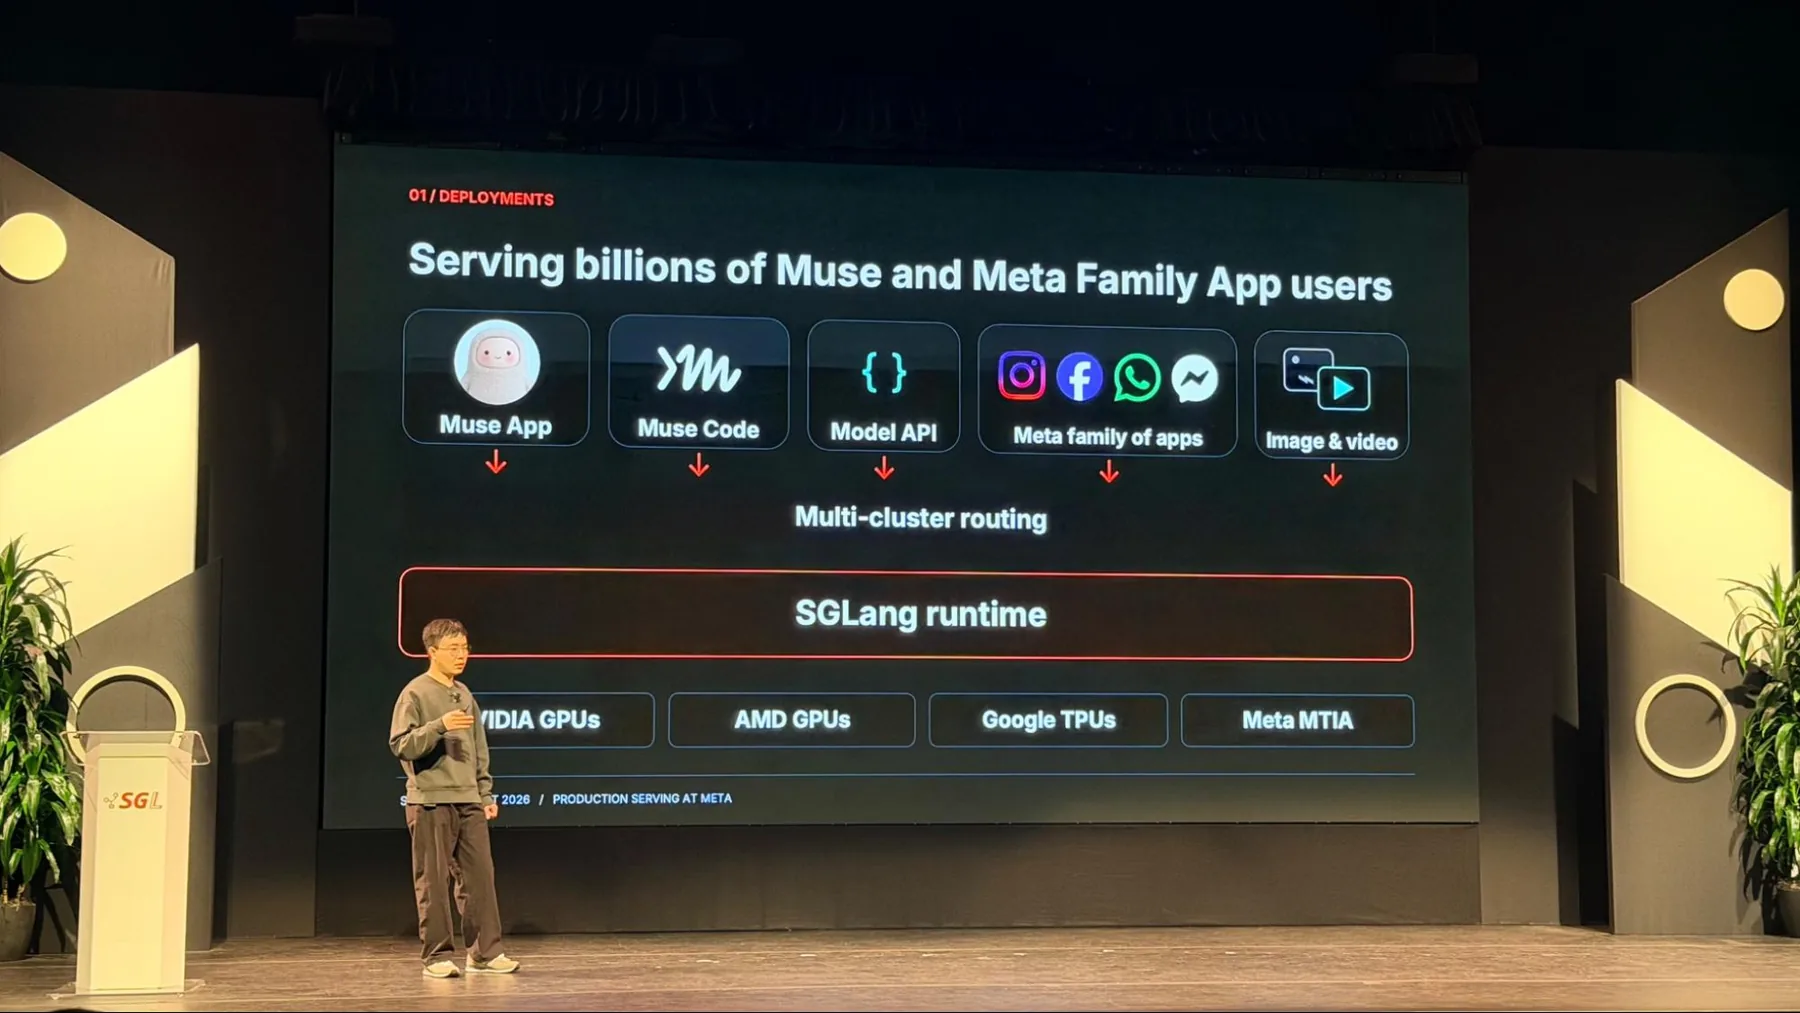
在 Meta,SGLang 为服务数十亿用户的产品提供生产推理支持。在主舞台上,Meta 的 Lianmin Zheng 展示了 SGLang 运行时如何支持 Muse App、Muse Code、Model API、Meta 系列应用以及图像和视频工作负载,其基础设施横跨 NVIDIA GPU、AMD GPU、Google TPU 和 Meta MTIA。
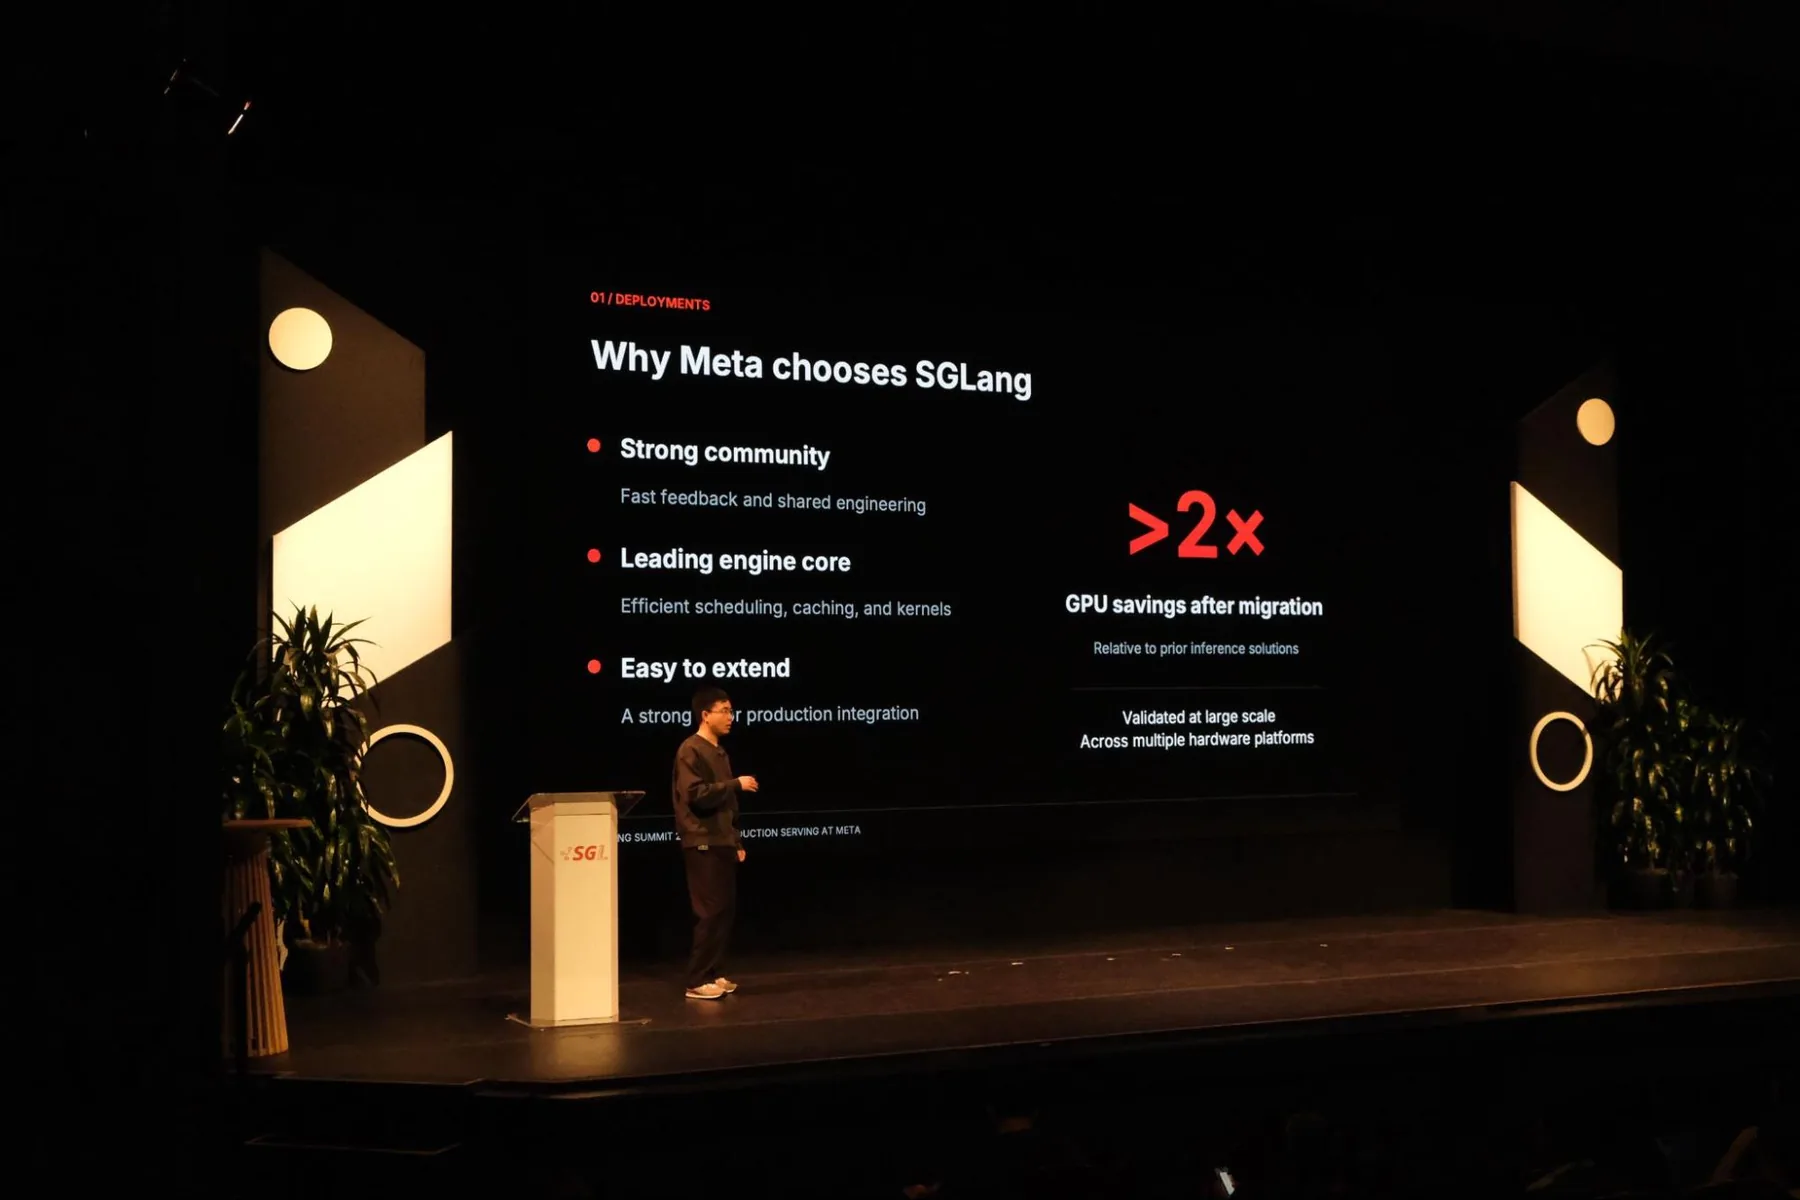
Meta 还报告称,在从先前的推理解决方案迁移后,GPU 开销节省超过 2 倍,并已在多个硬件平台上经过大规模验证。团队强调了选择 SGLang 的三个原因:拥有强大且反馈迅速、共享工程实践的社区;围绕调度、缓存和内核构建的高效引擎核心;以及可灵活扩展以满足生产集成需求。
这些结果共同表明,在大规模生产的需求下,SGLang 能够带来怎样的表现:在多样化的应用和硬件上实现可衡量的基础设施成本节省。
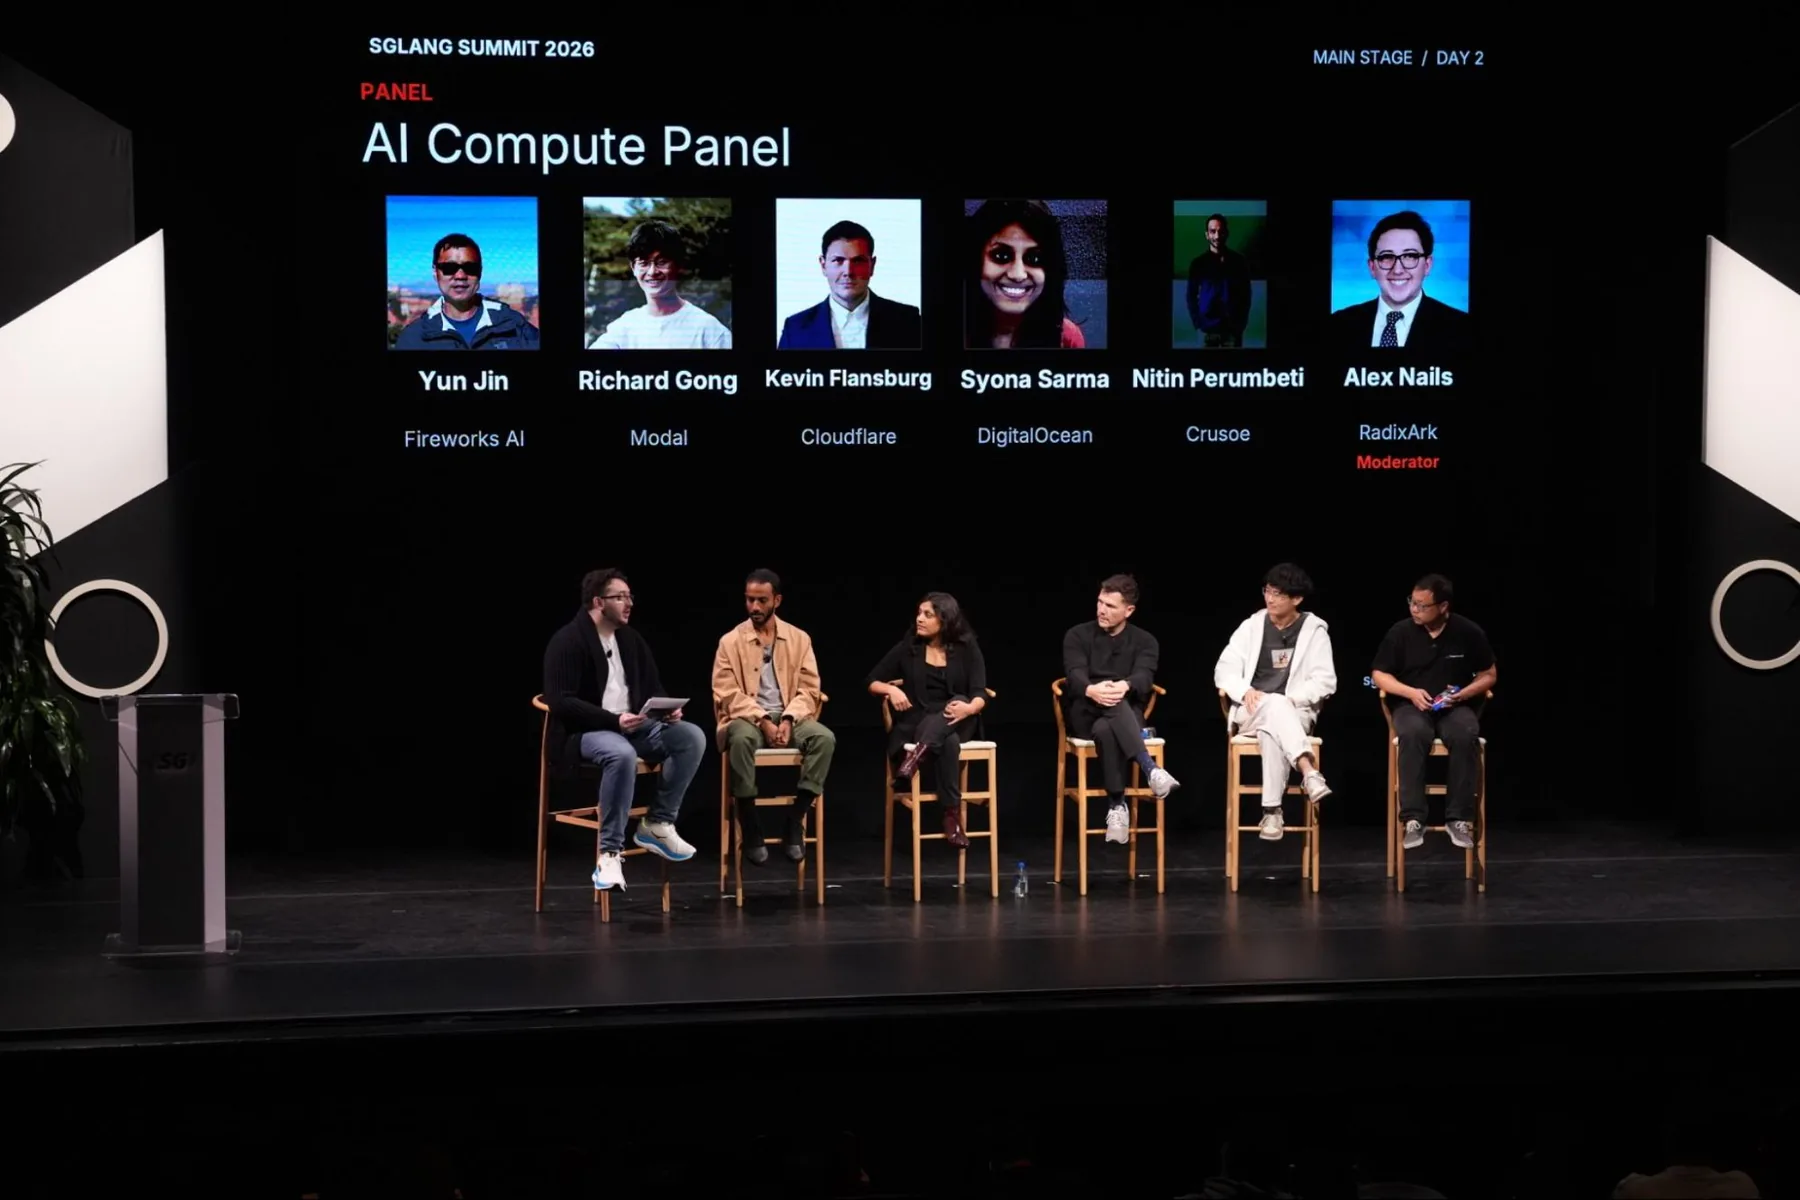
在这两天里,来自 Modal、Cloudflare、Crusoe、Fireworks、Baseten、DigitalOcean、LinkedIn 等公司的团队分享了各自生产环境的视角。他们的会议聚焦于实际的工程问题:如何服务高要求的工作负载、如何将推理集成到完整应用中,以及如何在真实运行条件下保持性能。
生产讨论从推理延伸到训练和后训练,将 SGLang 的服务能力与围绕 Miles 开发的强化学习工作流连接起来。关于 Meta 在 TorchTitan 和 Miles 方面工作的会议探讨了这些工作流背后的训练基础设施。
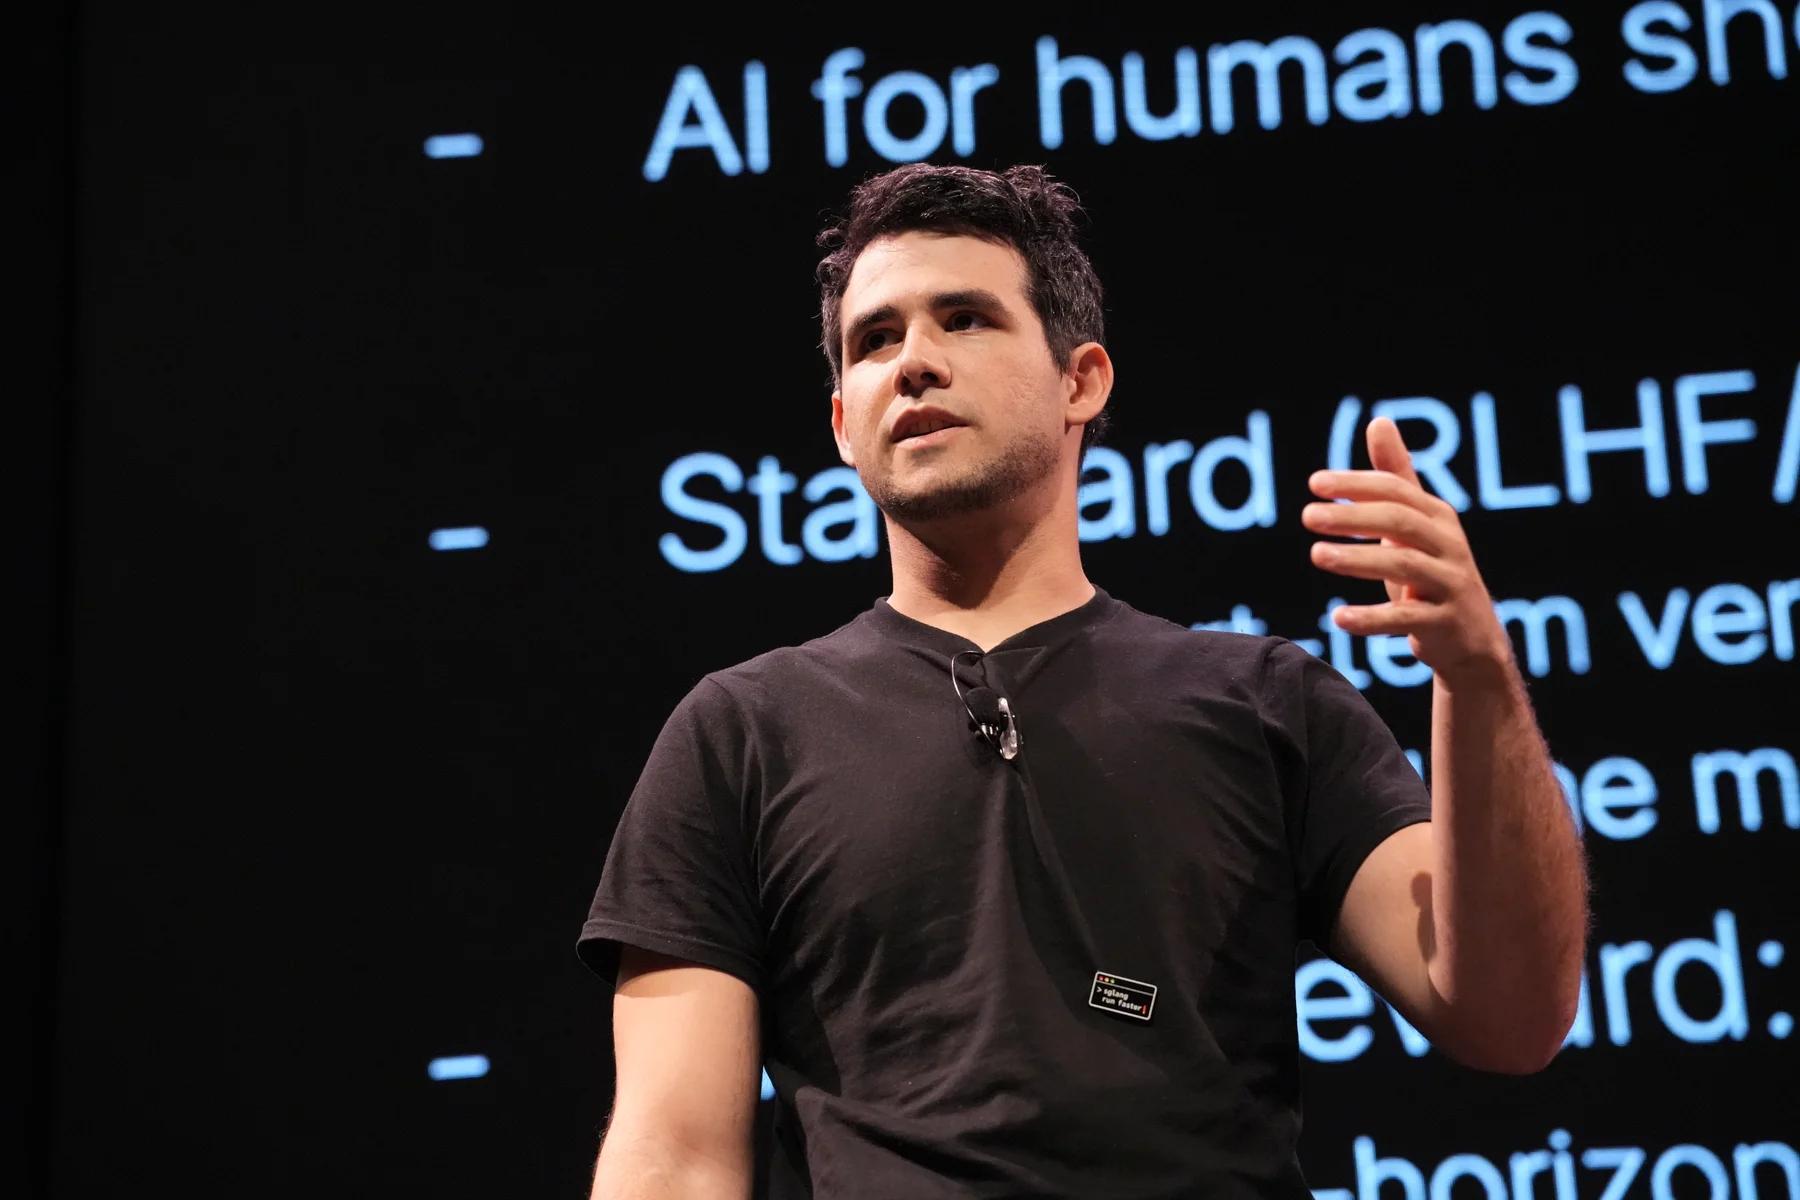
与此同时,humans& 首席执行官 Eric Zelikman 探讨了构建能够长期与人协作的 AI 所需的训练与基础设施。来自 humans&、Applied Compute 和 Mercor 的演讲者探讨了后训练领域的进展,涵盖从扩展强化学习基础设施到为真实世界工作训练智能体。
这些示例有助于塑造 SGLang 和 Miles 的工程议程。生产经验将具体需求带回项目:改进必须在完整应用、多样化硬件、不断变化的工作负载和完整训练运行中经受住考验。感谢每一个既分享成果、又分享背后工程经验的团队。
AI 领袖探讨下一步发展
主舞台环节包括与英特尔 CEO 陈立武、OpenAI 的 Lilian Weng、Thinking Machines Lab CTO Soumith Chintala 以及 Periodic Labs 联合创始人兼联合 CEO Liam Fedus 的炉边对话,此外还有 Perplexity 联合创始人兼 CEO Aravind Srinivas 的演讲“构建下一代计算机”。
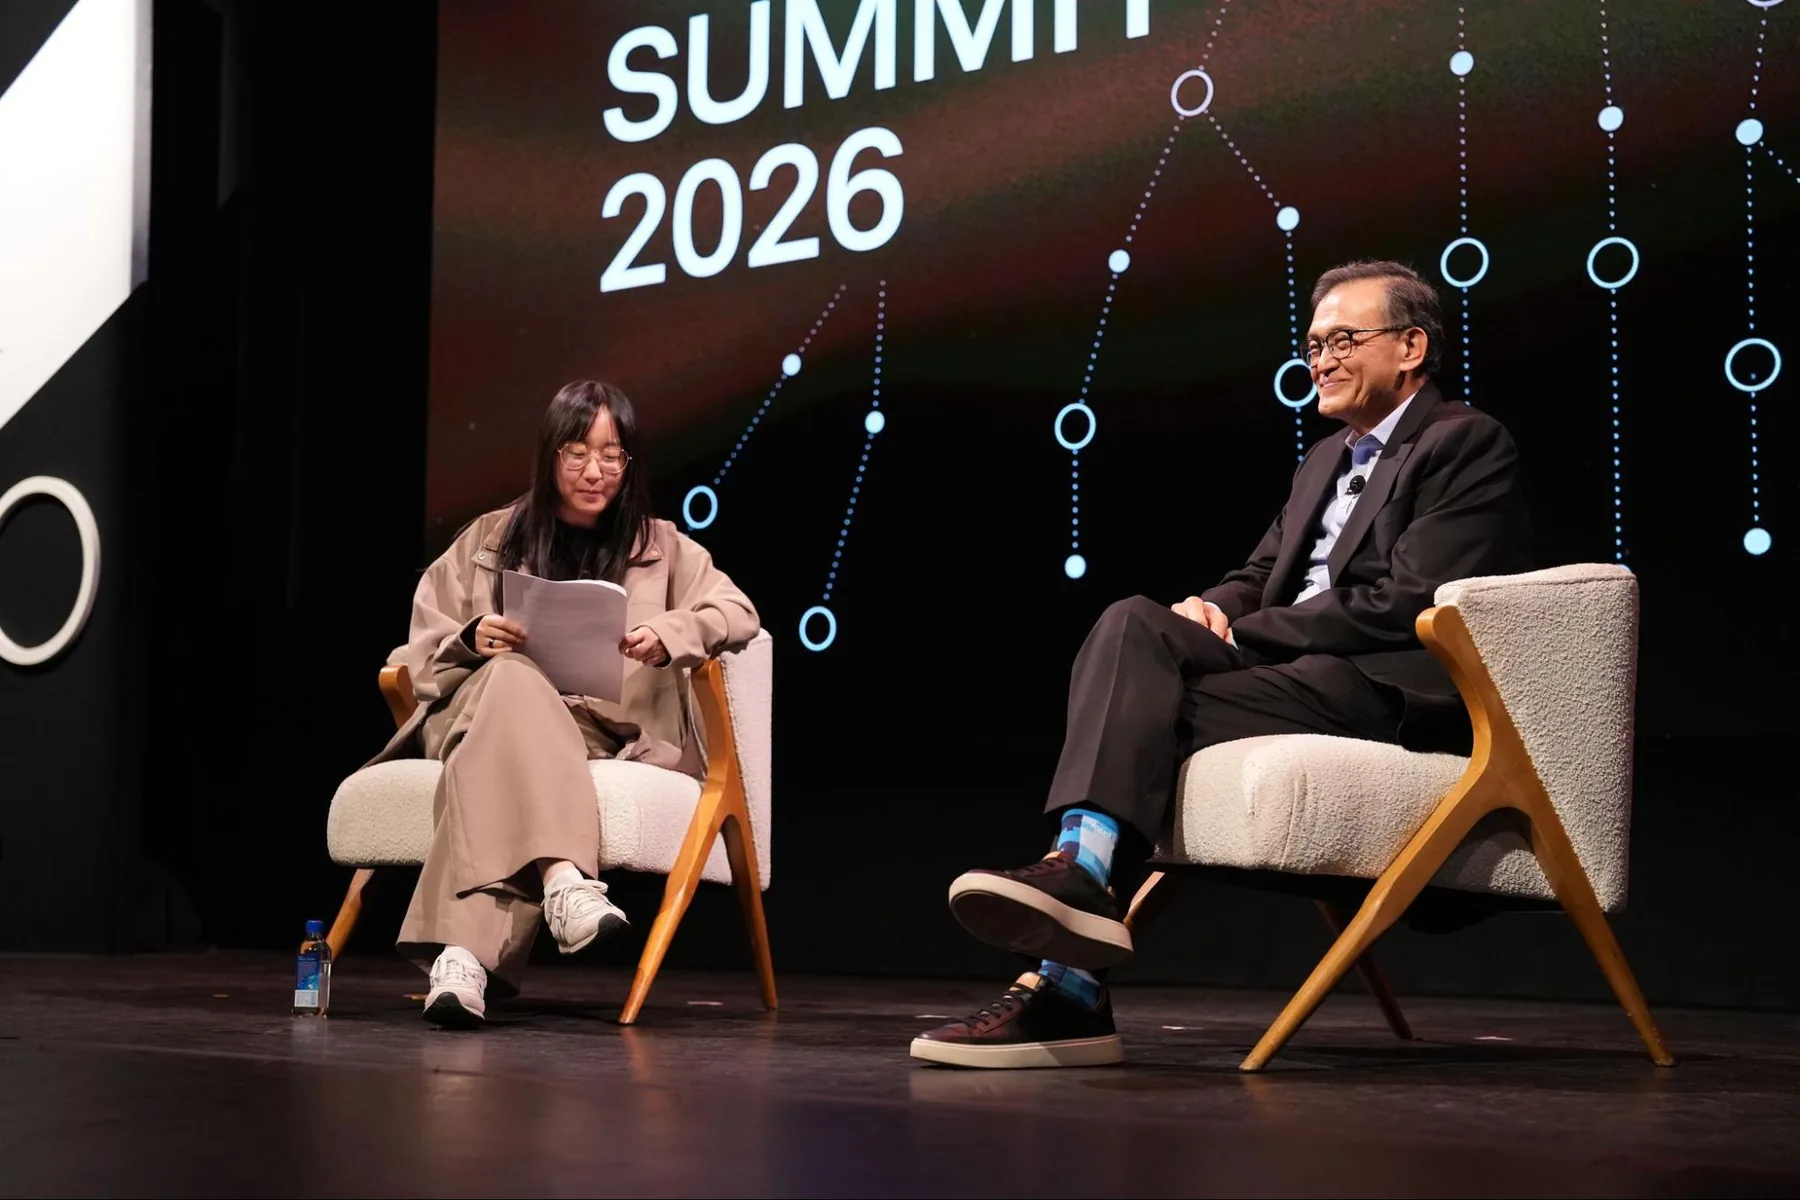
英特尔 CEO 陈立武谈到了需要新的芯片架构来降低 AI 的功耗需求。他将大型计算系统所需的能量与人脑进行了比较,并指出人脑的功耗约为 20 瓦。在未来 10 到 15 年内,他希望帮助开发超越 CPU 和 GPU 的架构,并提出神经形态计算是实现以远更低功耗提供更高性能的一种可能途径。
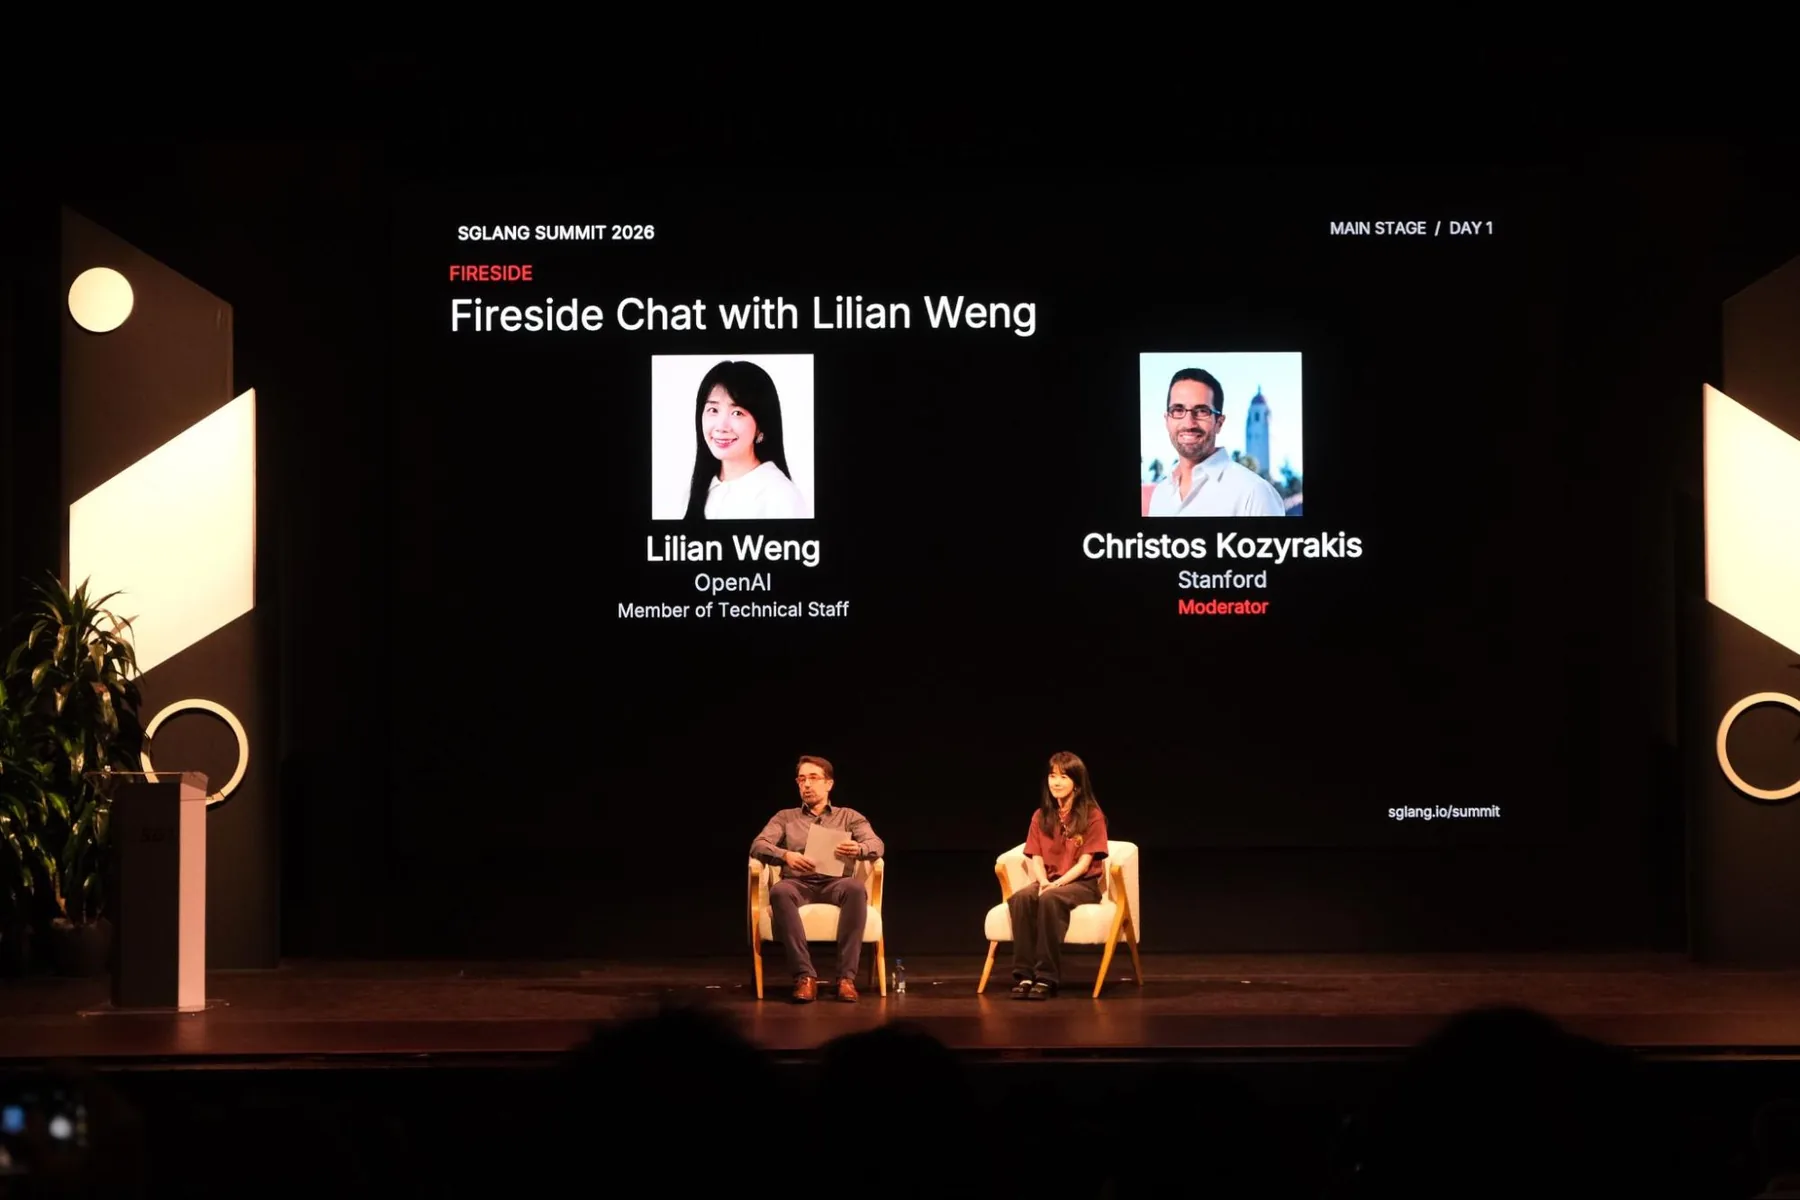
Lilian Weng 描述了编程智能体如何改变研究人员的工作方式。过去因时间或资源有限而不得不搁置的想法,如今可以更快地得到验证。她将研究人员的角色比作团队负责人:指导智能体完成实现工作,从而有更多时间去探索更高层次的问题。
Thinking Machines Lab 首席技术官 Soumith Chintala 讨论了前沿模型能力可能如何演进,包括超越人类能力的可能性。他反思了预测那样的未来会是什么样子有多困难,以及以往的技术革命是否能提供有用的指引。
Periodic Labs 联合创始人兼联合 CEO Liam Fedus 讨论了开源基础设施如何帮助加速科学发现。在他的炉边对话中,他探讨了新兴 AI 实验室将模型能力进步转化为科学进展的机遇,以及能够支持这项工作的共享工具和基础设施。
Aravind Srinivas 阐述了一个愿景:智能体能够在本地和云端环境中持续执行工作。他的演讲将这一愿景与具体需求联系起来:将工作建立在搜索之上、保留可恢复的状态,并对执行施加边界约束。演讲还描述了本地智能体在保留控制权的同时,有选择地向云端寻求帮助。
分组会议:为智能体时代构建引擎
AI 正从回答问题转向把事情办成,而 SGLang 正在成为这一转变背后的引擎。在三个分组会议室和 90 多场技术演讲中,结果本身就说明了一切。在速度方面,一个经过优化的 SGLang 部署为单个用户以约每秒 1,800 个 token 的速度服务了一个领先的开源模型,比标准方案快 1.8 倍,且推理准确率保持不变。在可靠性方面,一个生产团队报告称,SGLang 已运行 500 天,历经八次重大升级,未观察到性能回退。对于必须在每一步重新读取不断增长的历史记录的智能体,SGLang 的 HiCache 会复用已存储的上下文,而不是重新计算, 在多轮基准测试中将首 token 延迟中位数缩短了 60%在强化学习方面,由 SGLang 驱动的 Miles 框架使用 32 个训练节点和 32 个 rollout 节点,缩短了万亿参数 Kimi-K2 模型的权重更新暂停时间, 从53秒缩短到约7秒.
更令人兴奋的是,AI 开始帮助改进 SGLang 本身。由 AI 智能体编写的 GPU 巨型内核让解码速度最高提升至 2 倍,其输出已对照原始内核进行验证。两名工程师与 AI 智能体合作,在不到一周内将 SGLang 移植到另一款 AI 加速器上,性能达到生产水平的 1% 以内。当 AI 开始帮助构建运行 AI 的引擎时,进步只会加速。一个运行更快、更加开放、可在任何地方运行的 SGLang 正在到来,而这仅仅是开始。
动手实践工作坊让参会者亲自上手 SGLang 和 Miles
在主舞台之外,六场由合作伙伴主导的工作坊让参会者有机会亲自运行整套技术栈。NVIDIA 带领参与者从 Miles 入门直接进入可运行的强化学习循环,每位参会者都在 Jupyter notebook 中于两块 H100 上运行真实训练。AMD 展示了在 Instinct MI355X 上进行智能体强化学习时时间花在哪里,以及一系列优化如何将吞吐量提升 3.5 倍,随后参会者亲自启动了多轮强化学习训练。
在推理方面,由 SGLang 和 NVIDIA 团队主办的本地 AI 编程实验室让参与者使用完全本地的编程智能体,该智能体由单块 RTX PRO 6000 Blackwell 上的 Qwen3.8-27B 驱动,用于调试和修复 Mini-SGLang 中的优化。Nebius 讲解了贯穿整个技术栈的推理优化,从 Vera Rubin 硬件特性和模型压缩,到 GB300 服务以及由智能体编写的 CUDA 内核。Crusoe 让参会者在托管 Kubernetes 上部署 SGLang,并在负载下对其进行调优。Modal 提供了“为什么”,从第一性原理出发推导当今模型和服务系统的设计方式。
与 SGLang 社区共度的时光
SGLang 通过全栈协作不断成长。这种广度在峰会的整个议程中得到了体现,从 AI 硬件和推理基础设施,到训练、智能体、实时 AI、科学和机器人技术。
将这些社区汇聚在一起,为跨团队、跨学科的对话创造了空间:分享生产挑战、比较不同方法,并寻找合作机会。
展台
这些对话在展区各处持续进行。赞助商展台让团队与参会者围绕演示、技术问题以及构建 AI 系统的实际挑战聚在一起。对于通过代码、issue 或线上讨论结识彼此的人来说,这次峰会也是一次终于能面对面见面的机会。
看到这么多团队齐聚一堂,让人真切感受到 SGLang 生态的广度。从硬件、云基础设施到模型和应用,大家围绕共同挑战带来了不同视角,也获得了直接相互学习的机会。
感谢每一位参展商和工作坊主持人,你们把自己的工作带进现场,带领参会者观看演示,并抽出时间回答问题。这些交流是推动这一生态向前发展的重要组成部分。
GPU 展区
GPU 展区让生态系统的硬件层面成为关注焦点,让参会者更近距离地了解 AI 训练和推理背后的 GPU。除了峰会的技术会议之外,它还提供了另一种方式来探索支撑着用 SGLang 构建的模型和应用的基础设施。
展台之外
峰会也为人们留出了放松、结识新朋友、共度美好时光的空间。在会议间隙,参会者可以从 Kyoto Matcha 或 Hedge Coffee 取一杯饮品,品尝糖葫芦,并在早餐和午餐时继续交流。
赞助商和社区合作伙伴围绕峰会组织了25场社区活动,共有约3000人参加。
峰会期间,大家还一起喝咖啡聊天、与新朋友合影,并分享零食。感谢每一位帮助营造出这一友好氛围的人,让 SGLang 社区得以在此共度两天。
谢谢
我们感谢所有赞助商和社区合作伙伴,正是他们的帮助让这次聚会得以实现。他们的支持为这场以分享与协作为核心的活动带来了场地、资源和专业知识。
感谢我们的白金赞助商:Google、Intel、RadixArk、NVIDIA、Meta 和 AMD;我们的黄金赞助商:AWS、Crusoe、DigitalOcean、Fireworks AI、Inco AI、LanceDB、Modal、Nebius 和 Snowflake;以及我们所有的白银、Star、Spark 和社区合作伙伴。
最重要的是,感谢每一位加入我们的人。感谢分享经验的演讲者、改进软件的贡献者、用 SGLang 构建应用的团队,以及帮助这场活动顺利举办的志愿者:你们每个人都为这两天带来了独特的东西。
本次峰会汇聚了广泛的生态系统。相关工作仍在跨团队、跨组织和跨时区持续推进,我们很高兴能继续共同建设。
感谢你们成为 SGLang 的一员。
访问 sglang.io/summit 的演讲录像和演示幻灯片,这些内容将很快提供。