 AI 热点
人工智能
Amazon SageMaker AI 实时端点现已支持 KV cache 感知路由今天,Amazon SageMaker AI 推出 KV cache 感知路由(KV-aware routing),这是一种面向实时端点的新路由策略。它利用模型容器上报的缓存状态,将每个请求发送到已为其提示词持有较长缓存匹配且负载不过高的实例。该策略适用于为大型语言模型(LLM)提供多轮对话、长共享提示词或高负载服务的团队。您需要在两处启用它:为模型添加一个环境变量,使容器上报其缓存内容;并在端点配置中将 RoutingStrategy 设置为 KV_AWARE 。客户端仍使用与之前相同的 API 调用端点。
它解决的问题是:聊天助手、检索增强生成(RAG)以及带有长系统提示词的智能体等 LLM 应用会发送大量以相同文本开头的请求。模型会将针对提示词已完成的工作保存在 GPU 内存中,即 KV cache,当相同的开头再次到达同一实例时便跳过这部分工作。在 本系列第 1 部分, 我们介绍了 Amazon SageMaker AI 的前缀感知路由,它将开头相同的请求发送到同一实例。前缀感知路由仅根据请求本身推断前缀缓存的位置,因此无法判断实例何时已驱逐该缓存。
前缀感知路由仅根据请求本身来选择实例。它对请求的开头部分(最多到您配置的字节数,对于 OpenAI 兼容的 Chat Completions API 则为消息文本的字符数)进行哈希,并将开头相同的请求发送到同一实例。 PrefixLength 您配置的字节数(对于 OpenAI 兼容的 Chat Completions API,则为消息文本的字符数) InvokeEndpoint (即 OpenAI 兼容 Chat Completions API 的消息文本字符数),并将开头相同的请求发送到同一实例。它永远无法看到实例实际缓存了什么。当每个请求都以相同的共享文本开头时,这种方法效果很好;但在以下两种情况下效果较差:
实例上的缓存会随时间变化。当 GPU 内存占满时,实例会驱逐较旧的 KV 缓存条目,但路由器仍会像缓存依然有效一样,继续将匹配的请求发送到该实例。
一段对话一开始很短。在多轮聊天中,每一轮都会增加历史记录。当请求仍然短于 PrefixLength,每一轮新对话都会改变路由器所哈希的文本,因此下一轮可能落到与缓存了先前轮次的实例不同的实例上。只有当请求增长到超过 PrefixLength.
在本文中,我们将说明 KV 感知路由的工作原理、适用场景,以及如何在单模型端点和推理组件端点上启用、调用和验证该功能。
KV 感知路由的工作原理
KV 感知路由由三部分组成:模型容器上报其已缓存的内容,SageMaker AI 为该端点维护一份记录此状态的托管缓存索引,端点则利用该索引为每个请求选择实例。
当您启用事件时, SM_VLLM_KV_EVENTS_CONFIG,容器每次存储或驱逐缓存条目时都会发布一个 KV 缓存事件,SageMaker AI 利用这些事件保持索引最新。索引只保存指针:缓存内容的单向、截断哈希,每个哈希映射到持有该内容的实例或推理组件副本。它从不存储提示词、token ID、请求负载或 KV 张量。当请求到达时,端点会对提示词进行分词,并在索引中查找这些 token。索引会返回在其缓存中持有该提示词一部分的实例或推理组件副本,以及每个实例或副本持有多少内容。例如,如果实例 A 持有某段对话已缓存的起始部分,那么该对话的下一轮就会发送到 A。由于索引按 token 而非固定字节数进行匹配,多轮历史在增长过程中可以完整匹配。 只共享部分提示词的请求仍会发送到匹配长度最长的实例。
随后,端点会权衡每个候选实例已缓存提示词的比例及其繁忙程度,从这些候选中进行选择。过于繁忙的候选会被跳过,因此如果匹配最长的实例正忙,请求就会转到下一个可用的最佳实例。如果没有任何候选具有有用的匹配,或者所有候选都繁忙,请求就会回退到负载感知路由,如“路由开销与回退”中所述。与前缀感知路由不同,你无需为此配置并发阈值。该索引也会跟随实例集群的变化。当你缩容时,被移除实例的条目会被删除。当你扩容或更新替换实例时,新实例会以空缓存启动,因此延迟可能会在短时间内升高。
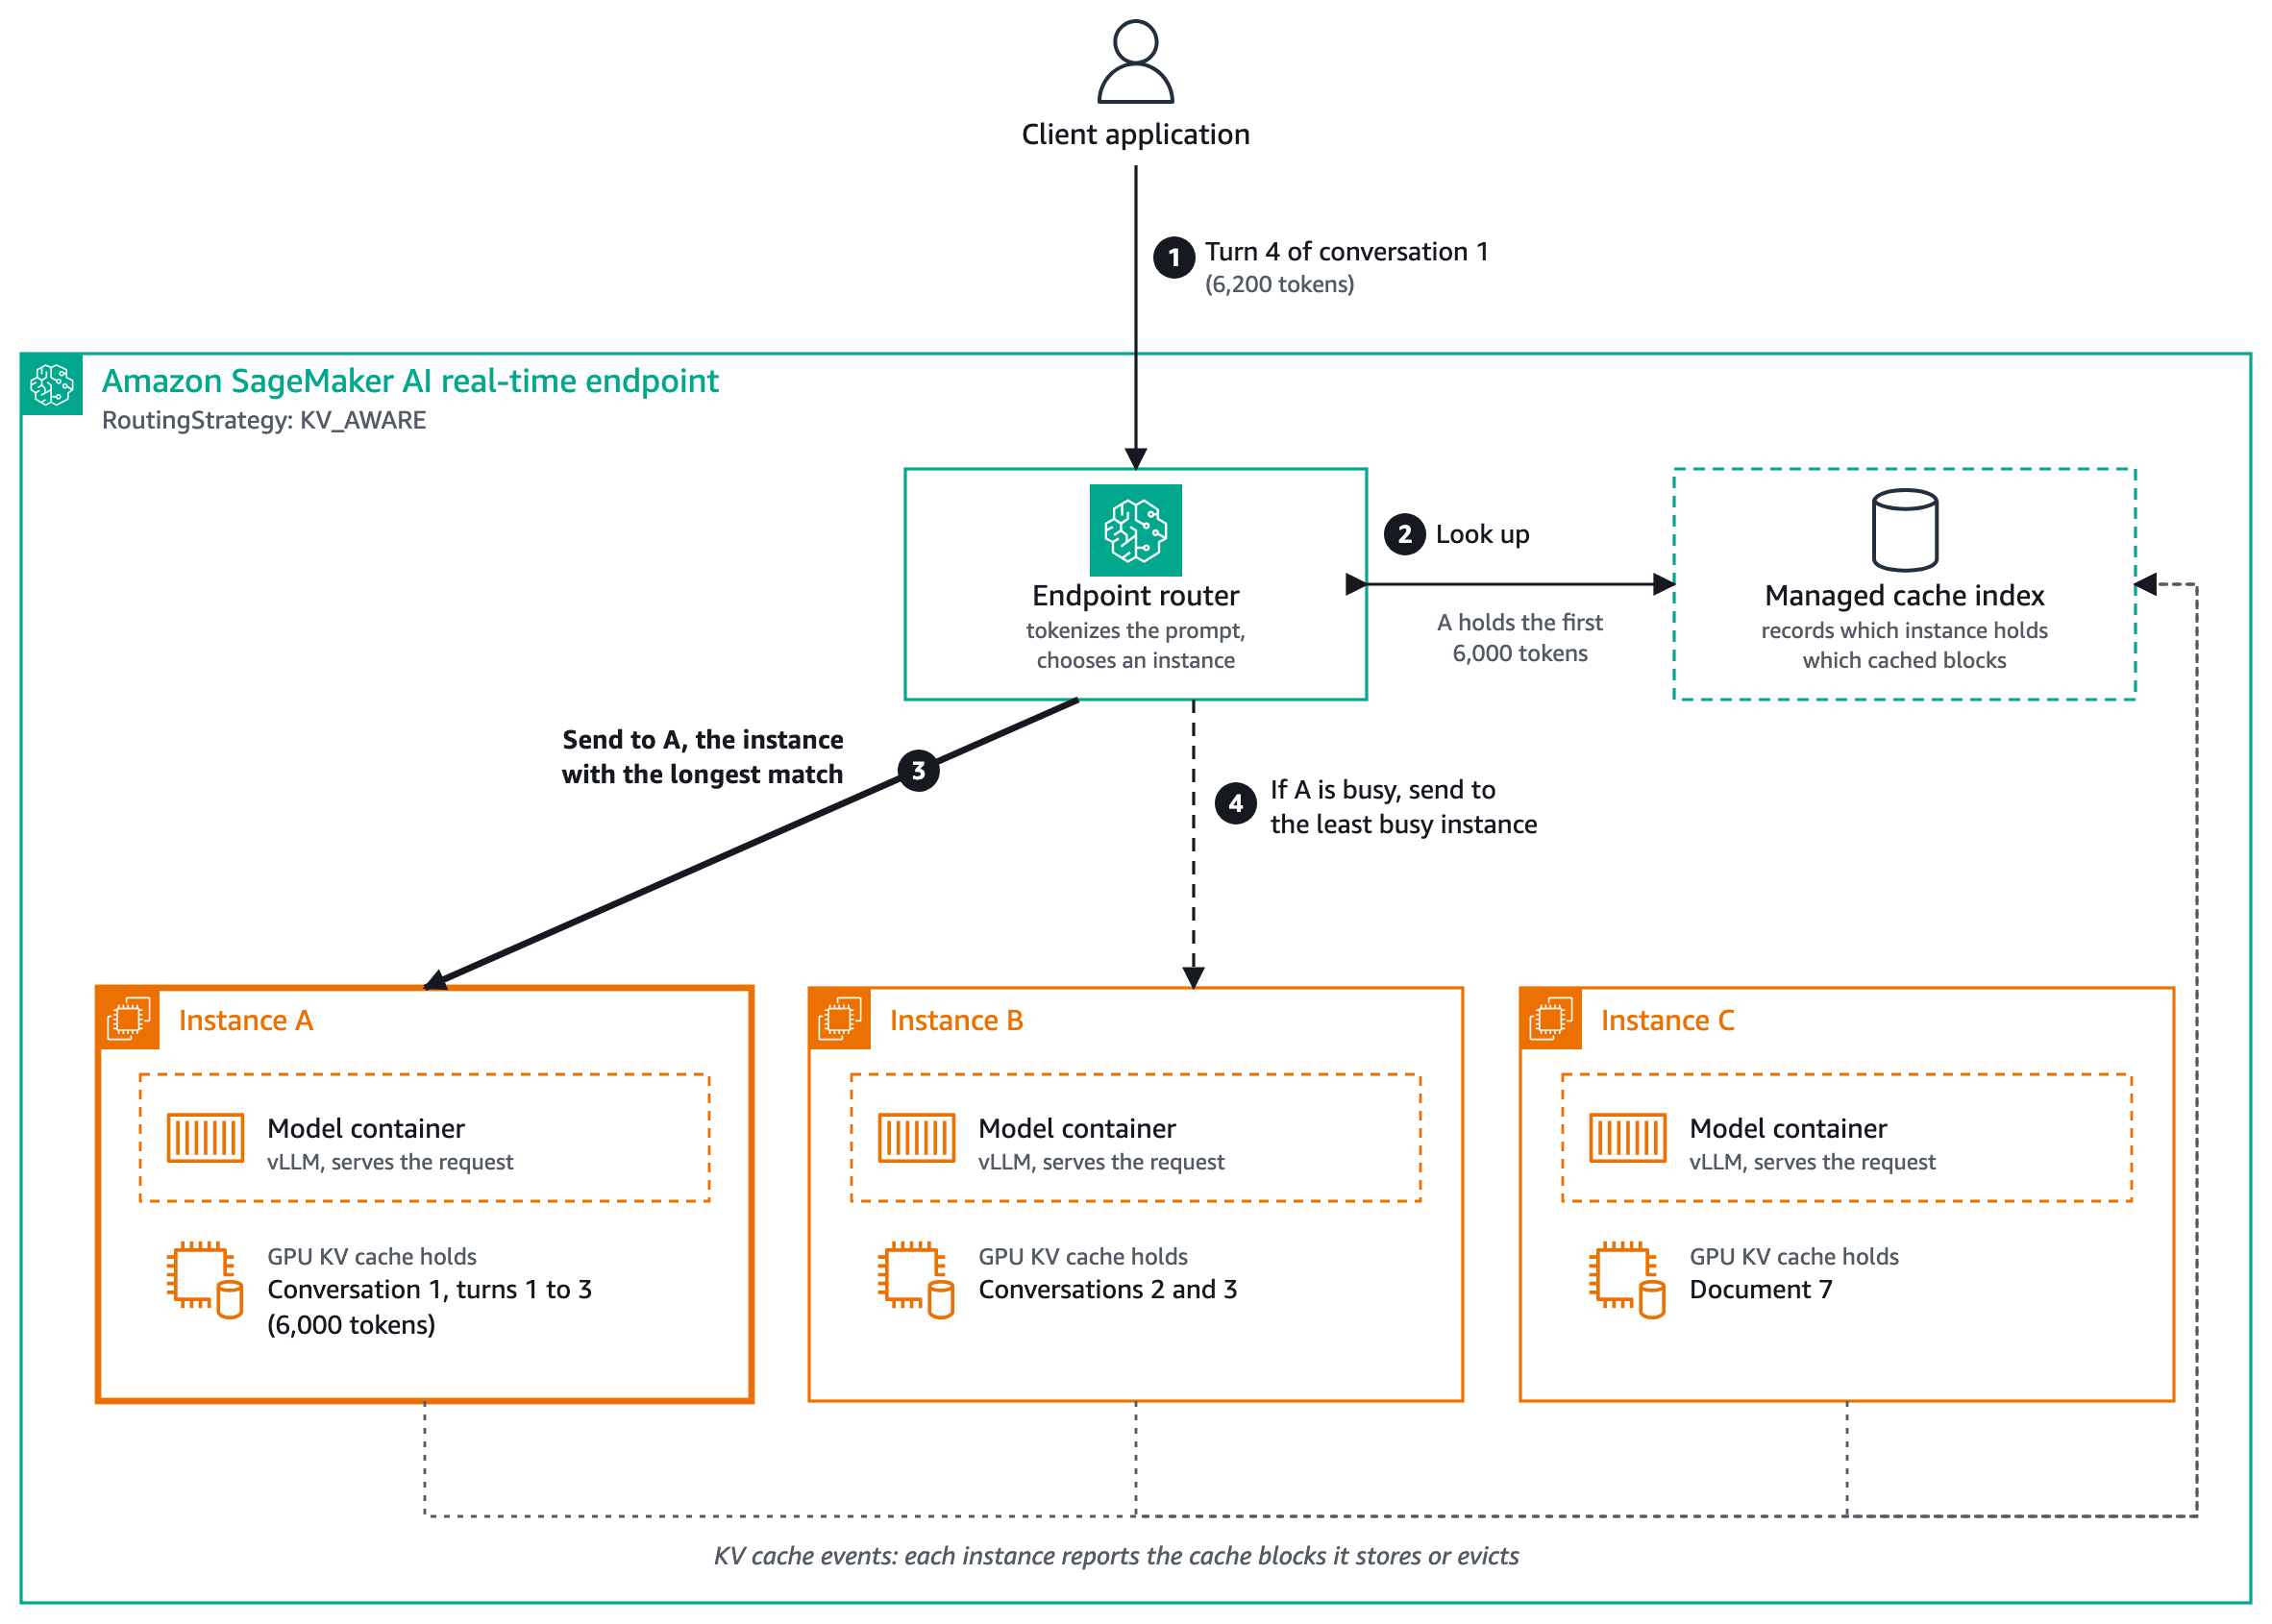
图 1:SageMaker AI 端点上的 KV 感知路由。路由器查询托管缓存索引,并将请求转发到持有最长缓存匹配的实例。每个实例都会将 KV 缓存事件上报回索引。
在图 1 中,端点有三个实例:A、B 和 C。每个实例都在自己的模型容器中运行相同的模型(即“要求和限制”中列出的 AWS vLLM 深度学习容器),并在 GPU 内存中拥有自己的 KV 缓存,因此每个实例保存的缓存内容各不相同:A 保存对话 1 的第 1 到第 3 轮,B 保存对话 2 和对话 3,C 保存文档 7。当对话 1 的第 4 轮到达时(步骤 1),路由器会对其进行分词,并在托管缓存索引中查找(步骤 2)。索引显示,A 持有该请求 6,200 个 token 中的前 6,000 个,因此路由器将请求发送给 A(步骤 3),A 只需计算剩余的 token。如果 A 正忙,路由器会将请求改发给最不繁忙的实例(步骤 4)。KV 感知路由需要可选的多个目标,因此只有在至少有两个实例,或至少有两份推理组件副本时才会生效。 只有一个实例时,所有请求都会发送到该实例,此设置不起作用。
SageMaker AI 上的路由策略
通过本次发布,SageMaker AI 为实时端点提供四种路由策略。你可以在端点配置的每个生产变体中设置策略。 RoutingConfig 的端点配置中设置。
| 策略 | 它如何路由 | 推荐用于 |
| RANDOM(默认)将每个请求发送到随机选择的实例。适用于通用工作负载、非 LLM 模型以及可互换的请求。LEAST_OUTSTANDING_REQUESTS将每个请求发送到在途请求数最少的实例。适用于处理时间各不相同、且希望让所有实例保持同等繁忙程度的工作负载。PREFIX_AWARE将共享相同提示前缀(最多到 PrefixLength)的请求发送到同一实例。超过 ConcurrencyThreshold 时溢出到另一个实例。适用于具有共享文本的 LLM 工作负载 | 将每个请求发送到随机选择的实例。 | 适用于通用工作负载、非 LLM 模型以及可互换的请求。 |
| LEAST_OUTSTANDING_REQUESTS | 将每个请求发送到在途请求数最少的实例。 | 适用于处理时间各不相同、且希望让所有实例保持同等繁忙程度的工作负载。 |
| PREFIX_AWARE | 将共享相同提示前缀(最多到 PrefixLength)的请求发送到同一实例。超过 ConcurrencyThreshold 时溢出到另一个实例。 | 适用于在任何支持前缀缓存的 serving 框架上、请求开头固定位置共享文本的 LLM 工作负载。 |
| KV_AWARE(新增) | 根据容器上报的缓存状态,将每个请求发送到持有匹配缓存前缀的实例,并权衡匹配长度与负载。若无可用匹配,则回退到负载感知路由。 | 适用于在受支持的容器上运行、具有多轮对话、频繁缓存驱逐,或请求之间仅共享部分起始内容的 LLM 工作负载。 |
前缀感知或 KV 感知
两种策略都会将请求发送到其前缀可能已被缓存的位置。它们的区别在于如何得知该位置,以及需要从你的容器获取什么信息。
| 前缀感知路由 | KV 感知路由 | |
| 缓存位置的来源 | 根据请求前缀推断 | 容器上报的缓存状态 |
| 每个请求增加的延迟 | 第 1 部分为 1.3–1.9 毫秒 | 短提示只需几毫秒,长提示则更久,主要耗时在分词上 |
| 匹配 | 前 PrefixLength 个字节(Invoke API)或字符(OpenAI 兼容 API) | Tokens,最长缓存匹配 |
| 参数 | PrefixLength、ConcurrencyThreshold | 无需 |
| 容器 | 任何启用了前缀缓存的容器 | 一个受支持的容器,并启用前缀缓存和 KV cache 事件(参见“要求与限制”) |
| 请求负载 | 容器上报的前缀缓存状态;每个请求增加的延迟:第 1 部分为 1.3–1.9 毫秒;短提示只需几毫秒,长提示则更久,主要耗时在分词上;匹配:前 PrefixLength 个字节(Invoke API)或字符(OpenAI 兼容 API);Tokens,最长缓存匹配;参数:PrefixLength、ConcurrencyThreshold;无需;容器:任何启用了前缀缓存的容器;一个受支持的容器,并启用前缀缓存和 KV cache 事件(参见“要求与限制”);请求负载 | OpenAI 兼容的 Completions 或 Chat Completions 格式 |
性能
我们通过两种方式将 KV 感知路由与随机路由进行了对比测量:在生产规模实例上进行的大规模基准测试,以及一个规模较小、可复现的对比测试,你可以在“验证 KV 感知路由是否正常工作”中跟随操作。
基准测试结果
在我们使用 Llama 3.1 70B Instruct 进行的基准测试中,在七个 ml.p5.48xlarge 实例上,我们运行了30分钟的测试,使用20或100个模拟用户进行多轮对话和文档问答会话,提示长度最高约为64,000个token。与随机路由相比,在负载下使用长提示时,KV感知路由将p50首token时间(TTFT)最多降低了97%,并将吞吐量最多提高了234%。它将KV缓存命中率从3–48%提升到了80–93%。长提示即使在较低负载下也能获益。短提示的收益最小,因为可节省的预填充较少。结果取决于你的工作负载。要针对你自己的流量进行测量,请使用“验证KV感知路由是否正常工作”中的检查方法。
路由开销与回退机制
在路由请求之前,端点会对提示进行分词,并在托管缓存索引中查找。对于短提示,查找只需几毫秒;对于长提示则耗时更长,主要花在分词上,但与缓存命中节省的时间相比仍然很小。对于使用标准选项的纯文本请求,它计算出的 token 会传递给模型,因此提示不会被分词两次。
如果查找速度慢、找不到有用的匹配项,或者所有匹配的实例都处于忙碌状态,端点会使用负载感知路由来转发请求,其行为与 LEAST_OUTSTANDING_REQUESTS 策略。请求仍会被处理,但无法享受缓存带来的好处。当端点无法对请求进行分词时也会发生同样的情况,但“调用端点”中描述的两个错误情况除外。这些回退机制在发布时不会在 SageMaker AI 控制台或指标中报告,因此请使用“验证 KV 感知路由是否正常工作”中的检查来确认路由对你的流量是否有效。
对于非常短的提示,可节省的预填充较少,因此前缀感知路由可能就足够了。
何时使用 KV 感知路由
前缀感知路由无需对容器做任何更改,但它无法看到实例实际持有的内容。KV 感知路由会向容器询问其持有的内容,因此更为精确。当有大量可复用的缓存上下文、且该缓存承受压力时——例如长提示、高负载,以及实例的 GPU 内存不足以容纳 KV 缓存——它就能发挥作用。在这种情况下,容器会逐出缓存中最近最少使用的部分,包括共享提示和对话历史的部分内容。
例如,一个支持助手运行在三个实例上,每段对话都以相同的6,000 token知识库摘录开始。对话1从实例A开始,A缓存了该摘录。流量上升,A内存不足,容器逐出了该摘录的大部分内容。实例B最近处理过另一段使用同一摘录的对话,并且仍保留着其前4,000个token。当对话1的下一轮到达时,前缀感知路由会再次将其发送到A,A会重新计算该摘录。而使用KV感知路由时,A的容器已经上报了逐出事件,因此索引显示B持有最长的匹配,请求会被发送到B,B只需重新计算剩余的token。在低负载下,A不会逐出任何内容,两种策略都会将请求发送到A,且缓存保持完好。
当请求以固定长度前缀无法捕捉的方式复用缓存上下文时,KV 感知路由最能发挥作用:
多轮对话: 每一轮都会发送完整的对话历史,因此缓存前缀会随着每一轮而增长。KV 感知路由会匹配整个已缓存历史,并将每段对话保留在持有该缓存的实例上。这对长对话尤为重要。当托管缓存索引反映出某次逐出后,路由器不会继续把该对话发送到已经丢弃其缓存的实例。
使用共享上下文进行高吞吐量推理: RAG 应用会在前面附加检索到的文档,而助手会在每次请求时发送很长的系统提示。当这些提示很长且实例面临内存压力时,KV 感知路由就适用。在共享前缀稳定且负载适中的情况下,前缀感知路由也适用。请把共享内容放在最前面,并保持相同顺序:如果相同的文档以不同顺序出现,这些提示就不再共享相同的开头,因此无法匹配。
前缀长度难以调优的工作负载: 通过前缀感知路由,你可以选择一个 PrefixLength 足以覆盖你的共享文本,而不会把本应保持在一起的请求分散开。KV 感知路由无需调优前缀长度,因为它依据实际缓存的内容进行匹配。
如果你的请求在开头共享一段稳定的系统提示或文档、提示较短,或者负载适中,那么前缀感知路由是合适的选择,且无需更改容器。在这些情况下,实例有足够的 GPU 内存来缓存共享文本,因此两种策略都能找到它。如果你的容器不支持 KV 感知路由,前缀感知路由也是首选,因为它适用于任何已开启前缀缓存的容器。如果你的请求较短且可以互换,或者你的模型不是 LLM,那么可复用的缓存上下文很少,因此请使用 RANDOM 或 LEAST_OUTSTANDING_REQUESTS.
如果你不确定哪种策略适合,请先从前缀感知路由开始,用你自己的流量对端点进行测试,并按照“验证 KV 感知路由是否正常工作”中所述,比较首 token 时间、吞吐量和命中率。要求与限制在启用 KV 感知路由之前,请检查你的容器、端点和请求是否满足以下要求:容器:启动时,KV 感知路由支持适用于 SageMaker AI 的 AWS vLLM 深度学习容器:vLLM 0.33.0 或更高版本的镜像,或 Amazon Linux 构建版本或更高版本。前缀缓存必须开启(这是默认设置),并且 KV 缓存事件 KV_AWARE 端点,并按照“验证 KV 感知路由是否正常工作”中所述,比较首 token 时间、吞吐量和命中率。
要求与限制
在启用 KV 感知路由之前,请检查你的容器、端点和请求是否满足以下要求:
容器: 启动时,KV 感知路由支持适用于 SageMaker AI 的 AWS vLLM 深度学习容器:vLLM 0.33.0 或更高版本的镜像,或 Amazon Linux 构建版本 server-sagemaker-cuda-v2.8.0 或更高版本。前缀缓存必须开启(这是默认设置),并且必须通过 SM_VLLM_KV_EVENTS_CONFIG 环境变量来开启,如“如何启用”中所示。SageMaker AI 不会为你设置该变量。
端点和实例: GPU 实例类型上的实时单模型端点和推理组件端点,包括动态低秩适配(LoRA)适配器。你还可以使用 AWS CloudFormation 配置 KV 感知路由。仅当单个模型端点至少有两个实例,或推理组件至少有两份副本(可位于同一实例上)时,路由才会生效。若数量更少,你仍可设置 KV_AWARE 且端点不会被拒绝,但每个请求都会发往单个实例或副本。
请求: OpenAI 兼容的 Completions 或 Chat Completions 请求负载,随 InvokeEndpoint, InvokeEndpointWithResponseStream,或 SageMaker AI 的 OpenAI 兼容 Chat Completions API。 InvokeEndpointWithBidirectionalStream 则不受支持。如果你设置了该 model 字段,它必须与以下值匹配: SM_VLLM_MODEL.
SDK 版本: 详细的可观测性(用于跟踪 KV 缓存命中率)需要 AWS Command Line Interface (AWS CLI) 2.35.6 或更高版本,或 Boto3 1.43.31 或更高版本。
SageMaker AI 会在端点开始处理流量之前检查这些要求。如果某项检查未通过,请求或部署就会失败,并返回一条说明缺少什么的消息。有关完整的设置列表、验证行为和配额,请参阅 SageMaker AI 文档。
如何启用
你需要在两个地方开启 KV 感知路由:模型和端点配置。 示例笔记本 对单个模型端点和推理组件端点,都会端到端地执行每一个步骤。
1. 在模型中开启 KV 缓存事件 – 创建模型时,请将 SM_VLLM_KV_EVENTS_CONFIG 到容器环境。没有它,端点就没有可用于路由的缓存状态。此设置中的端口仅在实例内部使用,因此你无需将它们开放到你的网络。
"Environment": {
    "SM_VLLM_MODEL": "<model-id-or-/opt/ml/model>",
    "SM_VLLM_KV_EVENTS_CONFIG": "{\"enable_kv_cache_events\": true, \"publisher\": \"zmq\", \"endpoint\": \"tcp://*:5557\", \"topic\": \"kv-events\", \"replay_endpoint\": \"tcp://*:5658\"}"
}
2. 在端点配置中选择 KV 感知路由 – 将 RoutingStrategy 到 KV_AWARE 中, RoutingConfig 生产变体中:
"RoutingConfig": {
    "RoutingStrategy": "KV_AWARE"
}
如果你的容器镜像为 CUDA 13 构建,还需设置 InferenceAmiVersion 到支持该功能的 AMI,例如 al2023-ami-sagemaker-inference-gpu-4-1否则容器可能无法启动。请参阅 推理 GPU 驱动程序.
请检查你的账户是否有足够的端点配额来支持你所选的实例类型和数量,如有需要,请在 Service Quotas 中申请提高配额。
同样的 RoutingConfig 该设置适用于推理组件端点,包括动态 LoRA 适配器。对于适配器,KV 感知路由会在已加载该适配器的实例中进行选择。
调用端点
调用端点的方式没有任何变化。发送一个 Chat Completions 请求负载,其中包含 InvokeEndpoint,或使用 InvokeEndpointWithResponseStream 以及 "stream": true 在请求体中:
{"messages": [{"role": "user", "content": "What is your return policy?"}]}你也可以通过 SageMaker AI 的 OpenAI 兼容 Chat Completions API,使用 OpenAI Python 客户端调用该端点。 通过 SageMaker AI 使用 OpenAI 兼容 API GitHub 上的 notebook 展示了如何对单个模型端点和推理组件执行这些操作。
KV 感知路由不会应用第 1 部分中的多租户前缀隔离:它会忽略前缀感知 ID 标头以及 prompt_cache_key 字段的请求。将顶层 cache_salt 字段设置为非空值的请求会被拒绝,并返回 400 错误。
KV 感知路由新增两种错误情况:请求的 model 字段指定了容器不提供服务的模型,则会失败并返回 ModelError,而一个请求如果其非空 cache_salt 会被拒绝并返回 400 错误。推理本身产生的错误仍会像以前一样返回,而你的模型容器在 Amazon CloudWatch 中的日志可以帮助你找到原因。端点不会向你的账户发送有关其 KV 感知路由决策的日志,因此请使用“验证 KV 感知路由是否正常工作”中的检查方法,例如 cached_tokens 按请求和 KV 缓存命中率,来观察路由的行为。
验证 KV 感知路由是否正常工作
KV 感知路由本身不会添加自己的指标,因此你需要检查它对模型的影响。有三种方法可以做到这一点。
检查每个请求的缓存命中情况—— 容器默认不会报告提示词 token 的详细信息,因此请设置 SM_VLLM_ENABLE_PROMPT_TOKENS_DETAILS 。 true 在模型环境中。随后每个响应都会包含 usage.prompt_tokens_details.cached_tokens,即由 KV 缓存提供的提示词 token 数量。当你发送后续轮次,或发送另一个与先前请求开头相同的请求时,非零值表明该请求到达了持有其前缀的实例。
在 Amazon CloudWatch 中检查模型指标 – 通过添加以下内容开启详细可观测性: --metrics-config '{"EnableDetailedObservability": true}' 在创建端点配置时,请使用“要求与限制”中列出的 SDK 版本。随后,SageMaker AI 会发布模型容器的指标,包括 KV 缓存命中率和 TTFT。请按照以下说明查询这些指标: 使用 PromQL 进行详细可观测性分析.
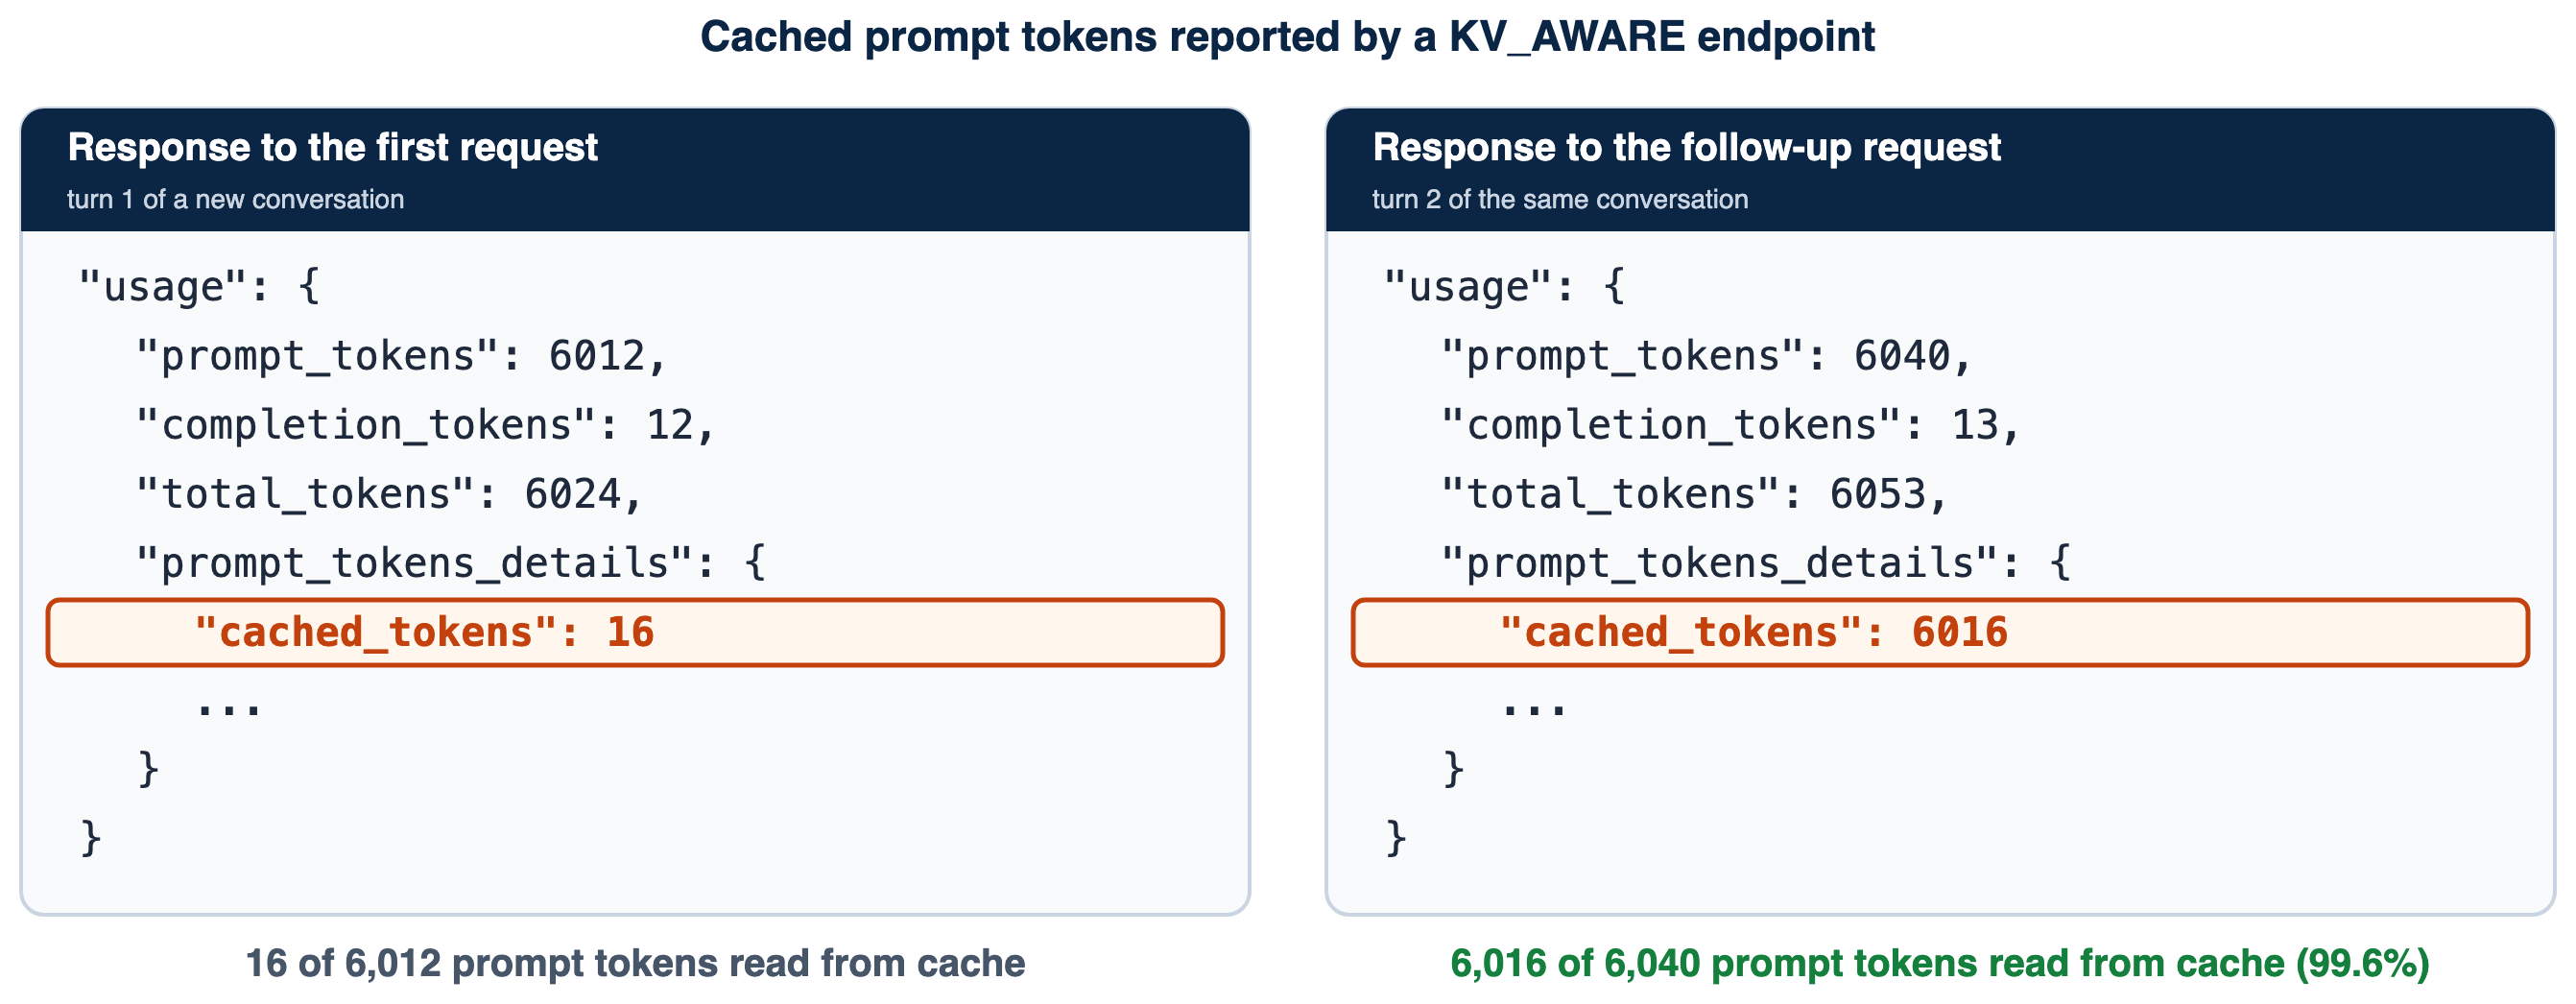
图 2:验证 KV 感知路由。(a) 后续请求显示大部分提示词 token 由 KV 缓存提供。(b) SageMaker AI Insights 仪表板中同一端点的 KV 缓存命中率
与你原本会采用的策略进行比较—— 对于大多数 LLM 工作负载,真正的选择是在 KV_AWARE , PREFIX_AWARE,因此请比较这两者,并添加一个 RANDOM 端点作为基线。对每个端点使用相同的模型、实例类型和实例数量,并以相同的并发度、在相同时长内发送相同的提示词,从而确保唯一的差异是路由策略。请确保你的测试像生产流量那样复用上下文,例如采用多轮对话或共享文档。如果 KV_AWARE , PREFIX_AWARE 在你的流量下表现大致相同时,前缀感知路由是更简单的选择。
作为这种比较的一个示例,我们在一个小型端点上比较了 和 。我们向两个仅在路由策略上不同的端点发送了相同的多轮工作负载。每个端点都有两个 实例,在受支持的容器上提供 服务。每次运行发送 128 个请求:32 个模拟用户,每个用户就一份从 12 份约 7,400 个 token 的文档中选出的文档提出 4 个问题。每个问题都会重新发送到目前为止的对话,因此第一个问题之后的每个问题都可以复用缓存的上下文。我们运行了两对运行,第 1 对中 在前,第 2 对中 在前, RANDOM 和 KV_AWARE 在一个小型端点上。我们向两个仅在路由策略上不同的端点发送了相同的多轮工作负载。每个端点都有两个 ml.g5.xlarge 实例上提供 Qwen3-4B-Instruct-2507 在受支持的容器上提供服务。每次运行发送 128 个请求:32 个模拟用户,每个用户就一份从 12 份约 7,400 个 token 的文档中选出的文档提出 4 个问题。每个问题都会重新发送到目前为止的对话,因此第一个问题之后的每个问题都可以复用缓存的上下文。我们运行了两对运行,其中 RANDOM 第 1 对中先运行 KV_AWARE 第 2 对中在前,并且每对都使用新文档,因此两个端点都从空缓存开始。表 1 以第 1 对 / 第 2 对的形式显示结果。
| 指标 | KV_AWARE | KV_AWARE |
| CloudWatch ModelLatency 平均值(毫秒) | 4,124 / 5,100 | 1,235 / 1,314 |
| CloudWatch ModelLatency p50(毫秒) | 3,153 / 4,083 | 656 / 700 |
| CloudWatch ModelLatency p90(毫秒) | 8,334 / 10,746 | 3,213 / 3,535 |
| CloudWatch ModelLatency p99(毫秒) | 17,779 / 16,249 | 6,876 / 7,238 |
| 首个 token 时间 p50,问题 2–4(毫秒) | 1,284 / 1,632 | 237 / 245 |
| 首个 token 时间 p90,问题 2–4(毫秒) | 5,039 / 6,101 | 456 / 367 |
| 首个 token 时间 p90,所有请求(毫秒) | 5,003 / 5,683 | 1,465 / 1,759 |
| 从缓存提供的提示 token 占比 | 0.761 / 0.701 | 0.903 / 0.903 |
| 运行时长(秒) | 31.1 / 36.9 | 17.9 / 18.0 |
| CloudWatch OverheadLatency 平均值(毫秒) | 13.1 / 8.1 | 27.1 / 27.5 |
表 1:相同工作负载下的 RANDOM 和 KV_AWARE 路由。每个单元格显示第 1 对 / 第 2 对。ModelLatency 和 OverheadLatency 是端点的 Amazon CloudWatch 指标。客户端测量了首个 token 时间和运行时长。缓存占比是一次运行中 cached_tokens 之和除以 prompt_tokens 之和。
在这两对中, KV_AWARE 其 CloudWatch ModelLatency 更低(平均为 1,235 和 1,314 毫秒,对比 4,124 和 5,100 毫秒),问题 2–4 的首个 token 时间也更低(p50 为 237 和 245 毫秒,对比 1,284 和 1,632 毫秒)。其缓存占比更高,在两对中均为 90%,对比 76% 和 70%。OverheadLatency,即 SageMaker AI 在模型容器之外花费的时间,平均高出 14 到 19 毫秒, KV_AWARE这是一个模型、一种实例类型和一种具有长共享文档的工作负载,因此请按本节前面所述测量你自己的流量。图 3 显示了 SageMaker AI 控制台为这两个端点显示的模型延迟图表。
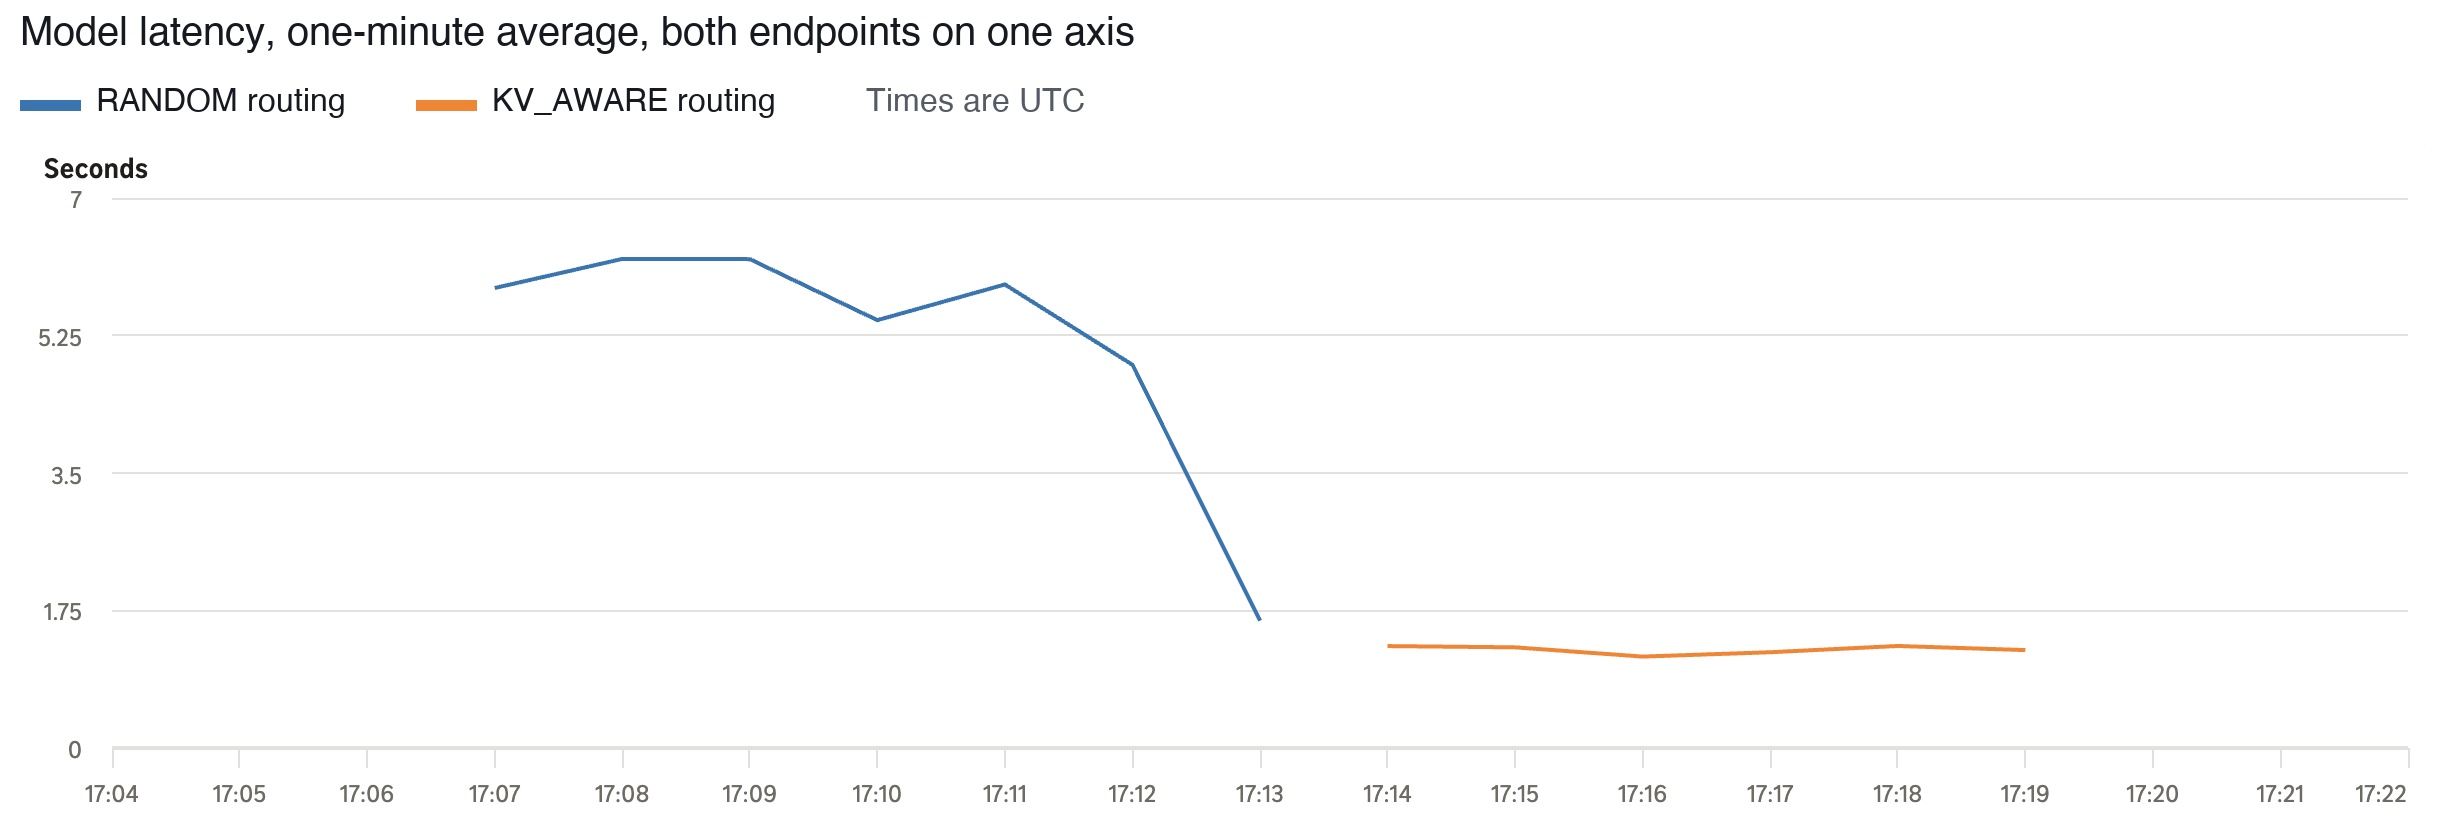
图 3:Amazon CloudWatch 中 RANDOM 端点(蓝色)和 KV_AWARE 端点(橙色)的一分钟平均模型延迟,共用 0–7 秒坐标轴。每个端点在新文档上连续运行同一工作负载七次,先运行 RANDOM。RANDOM 的平均模型延迟为 4.9–6.2 秒,KV_AWARE 为 1.2–1.3 秒。最后一个 RANDOM 数据点较低,因为该分钟只包含该次运行的最后 20 个请求
如果两者都没有更好的表现, RANDOM,请检查容器中是否已开启前缀缓存和 KV cache 事件,具体如“要求与限制”中所述。
示例笔记本
示例 笔记本 将本文中的步骤应用于 Qwen/Qwen3-4B-Instruct-2507 两个 ml.g5.xlarge 个实例上,这是单个模型端点所需的最低数量,以及在一个具有两份副本的推理组件端点上。它用两个 API 调用该端点,在随后的容器日志中显示后续请求由 KV 缓存提供服务,并且不比较路由策略。最后运行其清理单元格,以避免持续产生费用。
清理
为避免持续产生费用,请删除你创建的资源。对于推理组件端点,请先删除推理组件(delete-inference-component),然后是端点、端点配置和模型(delete-endpoint, delete-endpoint-config, delete-model).
实用指导
以下三项实践有助于你在启用 KV 感知路由后保持其有效性。
持续监控 KV 缓存命中率—— 在启动后保持详细的可观测性,并在 SageMaker AI Insights 仪表板(图 2b)中随时间观察 KV 缓存命中率,或如“验证 KV 感知路由是否正常工作”中所述,使用 PromQL 查询它。
为冷启动做好规划—— 首次带新上下文的请求(例如新文档或对话的第一轮)在任何实例上都没有缓存。KV 感知路由加速的是后续请求,而不是第一个请求。
为扩缩容和更新期间的缓存重建做好规划—— 如“KV 感知路由的工作原理”中所述,新实例启动时缓存为空。为缓解延迟增加,请对单模型端点使用滚动更新或蓝绿更新,或对推理组件使用 RollingUpdatePolicy 的推理组件。
结论
KV 感知路由为 SageMaker AI 实时端点提供了第二种方式,可将请求发送到其提示已被缓存的位置。它使用模型容器上报的缓存状态,因此当实例在内存压力下逐出缓存时,它也能跟随缓存变化。来自 本系列第 1 部分 对于稳定的共享提示、短上下文和中等负载,它仍然是更简单的选择。SageMaker AI 在端点内部为这两种策略处理路由,因此你无需自行构建或运行路由层。你只需在模型中通过一个环境变量将其开启,并在 "RoutingStrategy": "KV_AWARE" 在端点配置中。
KV 感知路由目前已在所有支持 SageMaker AI 实时推理的商业 AWS 区域中可用,适用于使用受支持容器的端点。它不收取额外费用。SageMaker AI 会为你运行并管理缓存索引,你只需为端点使用的实例付费。 KV_AWARE 是现有 RoutingStrategy 字段,因此你不需要新的配置对象,并且旧版本的 AWS CLI 和 Boto3 也接受它。要开始使用,请阅读 文档,运行示例 notebook 在一个小型端点上,然后比较 KV_AWARE 在支持 SageMaker AI 实时推理的所有商业 AWS 区域中可用,适用于使用受支持容器的端点。它不收取额外费用。SageMaker AI 会为你运行并管理缓存索引,你只需为端点使用的实例付费。 PREFIX_AWARE 在您自己的流量副本上。