 AI 热点
人工智能
利用分布式 KV 缓存智能体技能降低自托管 LLM 的成本和延迟越来越多的客户选择在 GPU 上自托管大型语言模型(LLM),以便控制成本、准确性和延迟。然而,自托管往往意味着要为重复的 GPU 计算付费,因为每台服务器上的缓存容量较小且彼此隔离,无法容纳或共享 AI 智能体和聊天应用不断重复发送的日益增长的上下文。以法律 AI 助手为例,每次对话都可能积累数十万个词元的案件历史记录。当律师午餐后返回某个对话线程时,LLM 可能需要几分钟才能响应。接手请求的 GPU 服务器内存中没有任何相关历史记录。因此,在输出第一个字之前,GPU 必须为所有这些词元重新计算键值(KV)注意力状态,这一步称为预填充(prefill)。同样的模式也会拖慢恢复运行的编码智能体、智能体式 AI 助手和文档问答助手。使用 Amazon ElastiCache 的分布式 KV 缓存可以将自托管 LLM 的推理成本降低最高 40%,并将首词元时间(TTFT)缩短最高 80%。分布式 KV 缓存通过在 GPU 集群旁增加一个共享层来扩展 GPU 本地缓存,使任何服务器都能跨会话、路由变更和服务器故障,在数天内重复使用 KV 状态。“宣布推出适用于自托管 LLM、基于 Amazon ElastiCache 的分布式 KV 缓存”一文深入介绍了相关技术细节和性能基准测试结果。
本文详细介绍了 Agent Toolkit for AWS 中的 分布式 KV 缓存技能 。借助此技能,只需在编码智能体中输入几个提示,即可评估和设置分布式 KV 缓存。该技能会引导智能体检查您的工作负载能否从分布式 KV 缓存中受益、为测试或生产工作负载设置缓存集群,以及排查 LLM 推理缓存问题。该技能适用于 Kiro、Claude Code、OpenAI Codex,以及其他支持 Agent Skills 的编码智能体。我们将通过四段对话介绍该技能的工作方式:诊断首词元响应缓慢的问题、确定缓存规模并估算价格、设置缓存,以及修复传输失败问题。
为什么要为 KV 缓存开发一项技能,它能做什么?
分布式 KV 缓存对您的工作负载有多大帮助,取决于所使用的 LLM 模型、用户流量模式和提示路由选择等特征,因此估算过程可能十分复杂。我们开发了 KVTrace 工具 ,让您在部署任何基础设施之前,就能根据自己的模型和流量较为准确地估算工作负载可获得的收益,且不收取额外费用。该技能简化了评估和设置流程,并会引导您的编码智能体在进行任何更改之前遵循以下最佳实践:
- 在产生任何支出之前检查适用性。 智能体通过只读
describe-instances调用读取您的 GPU 集群并统计 Elastic Fabric Adapter(EFA)接口的数量。它只会询问自己无法查看的信息:引擎、模型、张量并行(TP)大小、KV 数据类型、服务器价格,以及提示重复出现的频率。如果存在不适用的情况,它会停止操作并说明原因。 - 使用您的工作负载数据进行计算。 对于较短的提示,加载 KV 状态可能比重新计算花费更长时间。当提示长度超过某个阈值(切换点)后,读取缓存才更有优势。这个切换点和提示的重复频率决定了缓存是否物有所值。智能体使用 KVTrace 根据您的实际流量估算节省金额,不收取额外费用;如果节省金额不足以覆盖缓存成本,它就会停止操作。每个数字都会注明其来源。
- 使用您现有的技术栈管理所有推理服务器的配置。 智能体会将 LMCache 连接器添加到您现有的 vLLM 或 SGLang 引擎中,其中也包括 llm-d 和 Ray Serve 等服务框架下的 vLLM 工作器。它会保留您的路由和引擎设置,并将推理集群中的服务器统一配置为同一种 KV ID 机制(哈希和种子)以及明确的 KV 数据类型。匹配的设置可以避免键不一致,即每台服务器写入的 KV 状态都无法被其他服务器找到。
- 实施最佳实践。 在接入生产流量之前,智能体会清空本地缓存层,并检查两次从缓存加载的运行是否产生相同的输出,因为布局不匹配可能导致命中计数器看似正常,却给出错误答案。该技能会引导智能体在执行创建、更改或删除资源等高影响操作前,先获得明确批准。
先决条件
从收益估算到设置,这些流程需要满足以下条件:
- 支持 Agent Skills 的编码智能体,例如 Kiro 或 Claude Code。
- 支持 EFA RDMA 写入的 GPU 实例,例如 p5。
- LMCache 0.5.8rc1 或更高版本,以及 vLLM 0.11.1 或更高版本(SGLang 0.5.13 或更高版本)。
- ElastiCache for Valkey 9.1 或更高版本,运行于 cache.i8ge.48xlarge 节点上(如果需要设置缓存)。
流程 1:分布式 KV 缓存能否发挥作用?
我们向智能体提供了以下提示: “我的 vLLM 集群运行在 p5 实例上,为一款上下文长度达 64K 词元的法律助手提供服务。用户返回已有对话时,首词元响应需要 13 秒,因为 GPU 每轮都要重新计算完整的对话历史记录。我该如何解决这个问题?”
智能体将该请求与这项技能匹配,并在 Kiro 中加载技能之前请求批准。回答指出,延迟是由冷预填充造成的;对于实际部署而言,回答中的三点尤为重要。第一,它会先检查无需新增基础设施的解决方案。如果您关闭了前缀缓存,重新启用它可以加快连续轮次的响应。如果在启用会话亲和性的情况下,GPU 前缀缓存命中率已经超过 90%,您可能不需要共享 KV 缓存。第二,它会识别这款法律 AI 助手特有的约束。共享 KV 缓存可能使一个租户通过响应时间判断另一个租户是否发送过相同文本。必须保持隔离的案件应使用独立缓存,而共享缓存的租户则应将自己的 ID 加入 KV 哈希。第三,它不会猜测所需规模,而是会询问模型和 TP 大小、KV 数据类型、副本数量和路由方式,以及用户在各轮对话之间的等待时长。
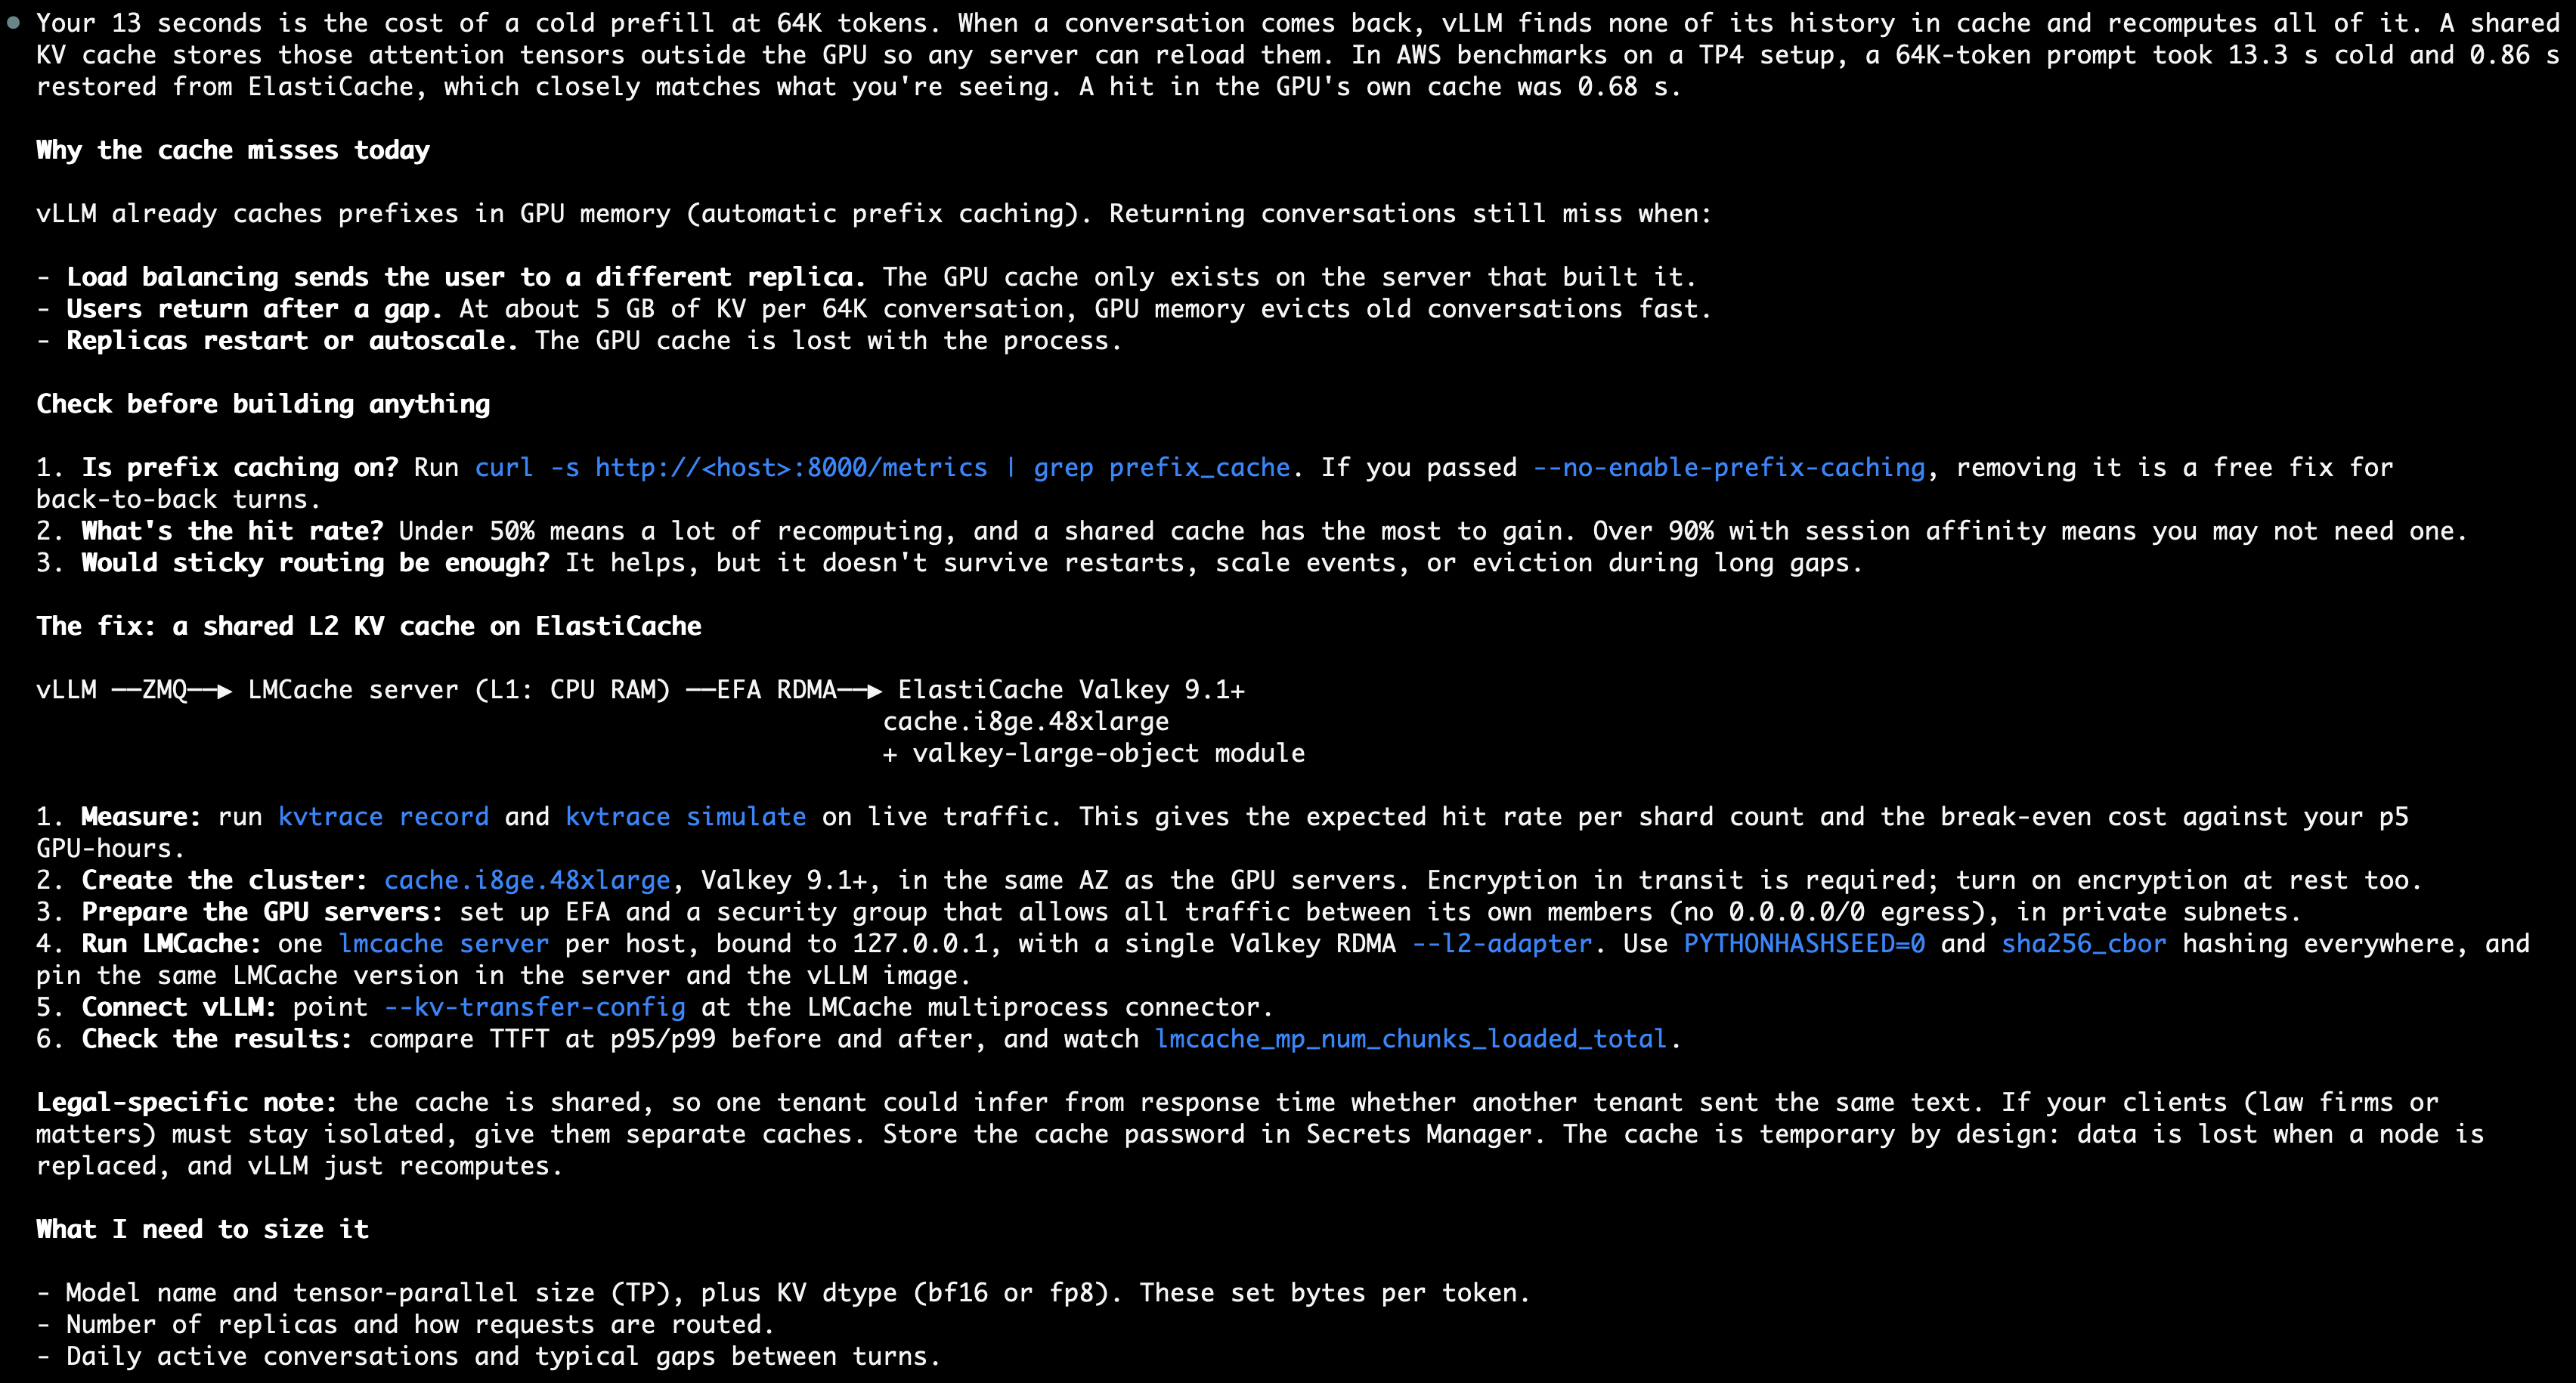
图 1:法律助手的诊断结果和建议架构
流程 2:估算节省金额
为了估算节省金额,我们向智能体提供了一个示例集群:8 个 p5 实例,为多轮检索增强生成(RAG)助手处理长度为 64,000 词元的提示。智能体查询了 GPU 和缓存节点的价格,并根据基准测试推导出预填充速率和 KV 大小。最后,智能体建议使用两个 cache.i8ge.48xlarge 节点进行分布式 KV 缓存。下图展示了智能体的总结及其使用的输入数据。
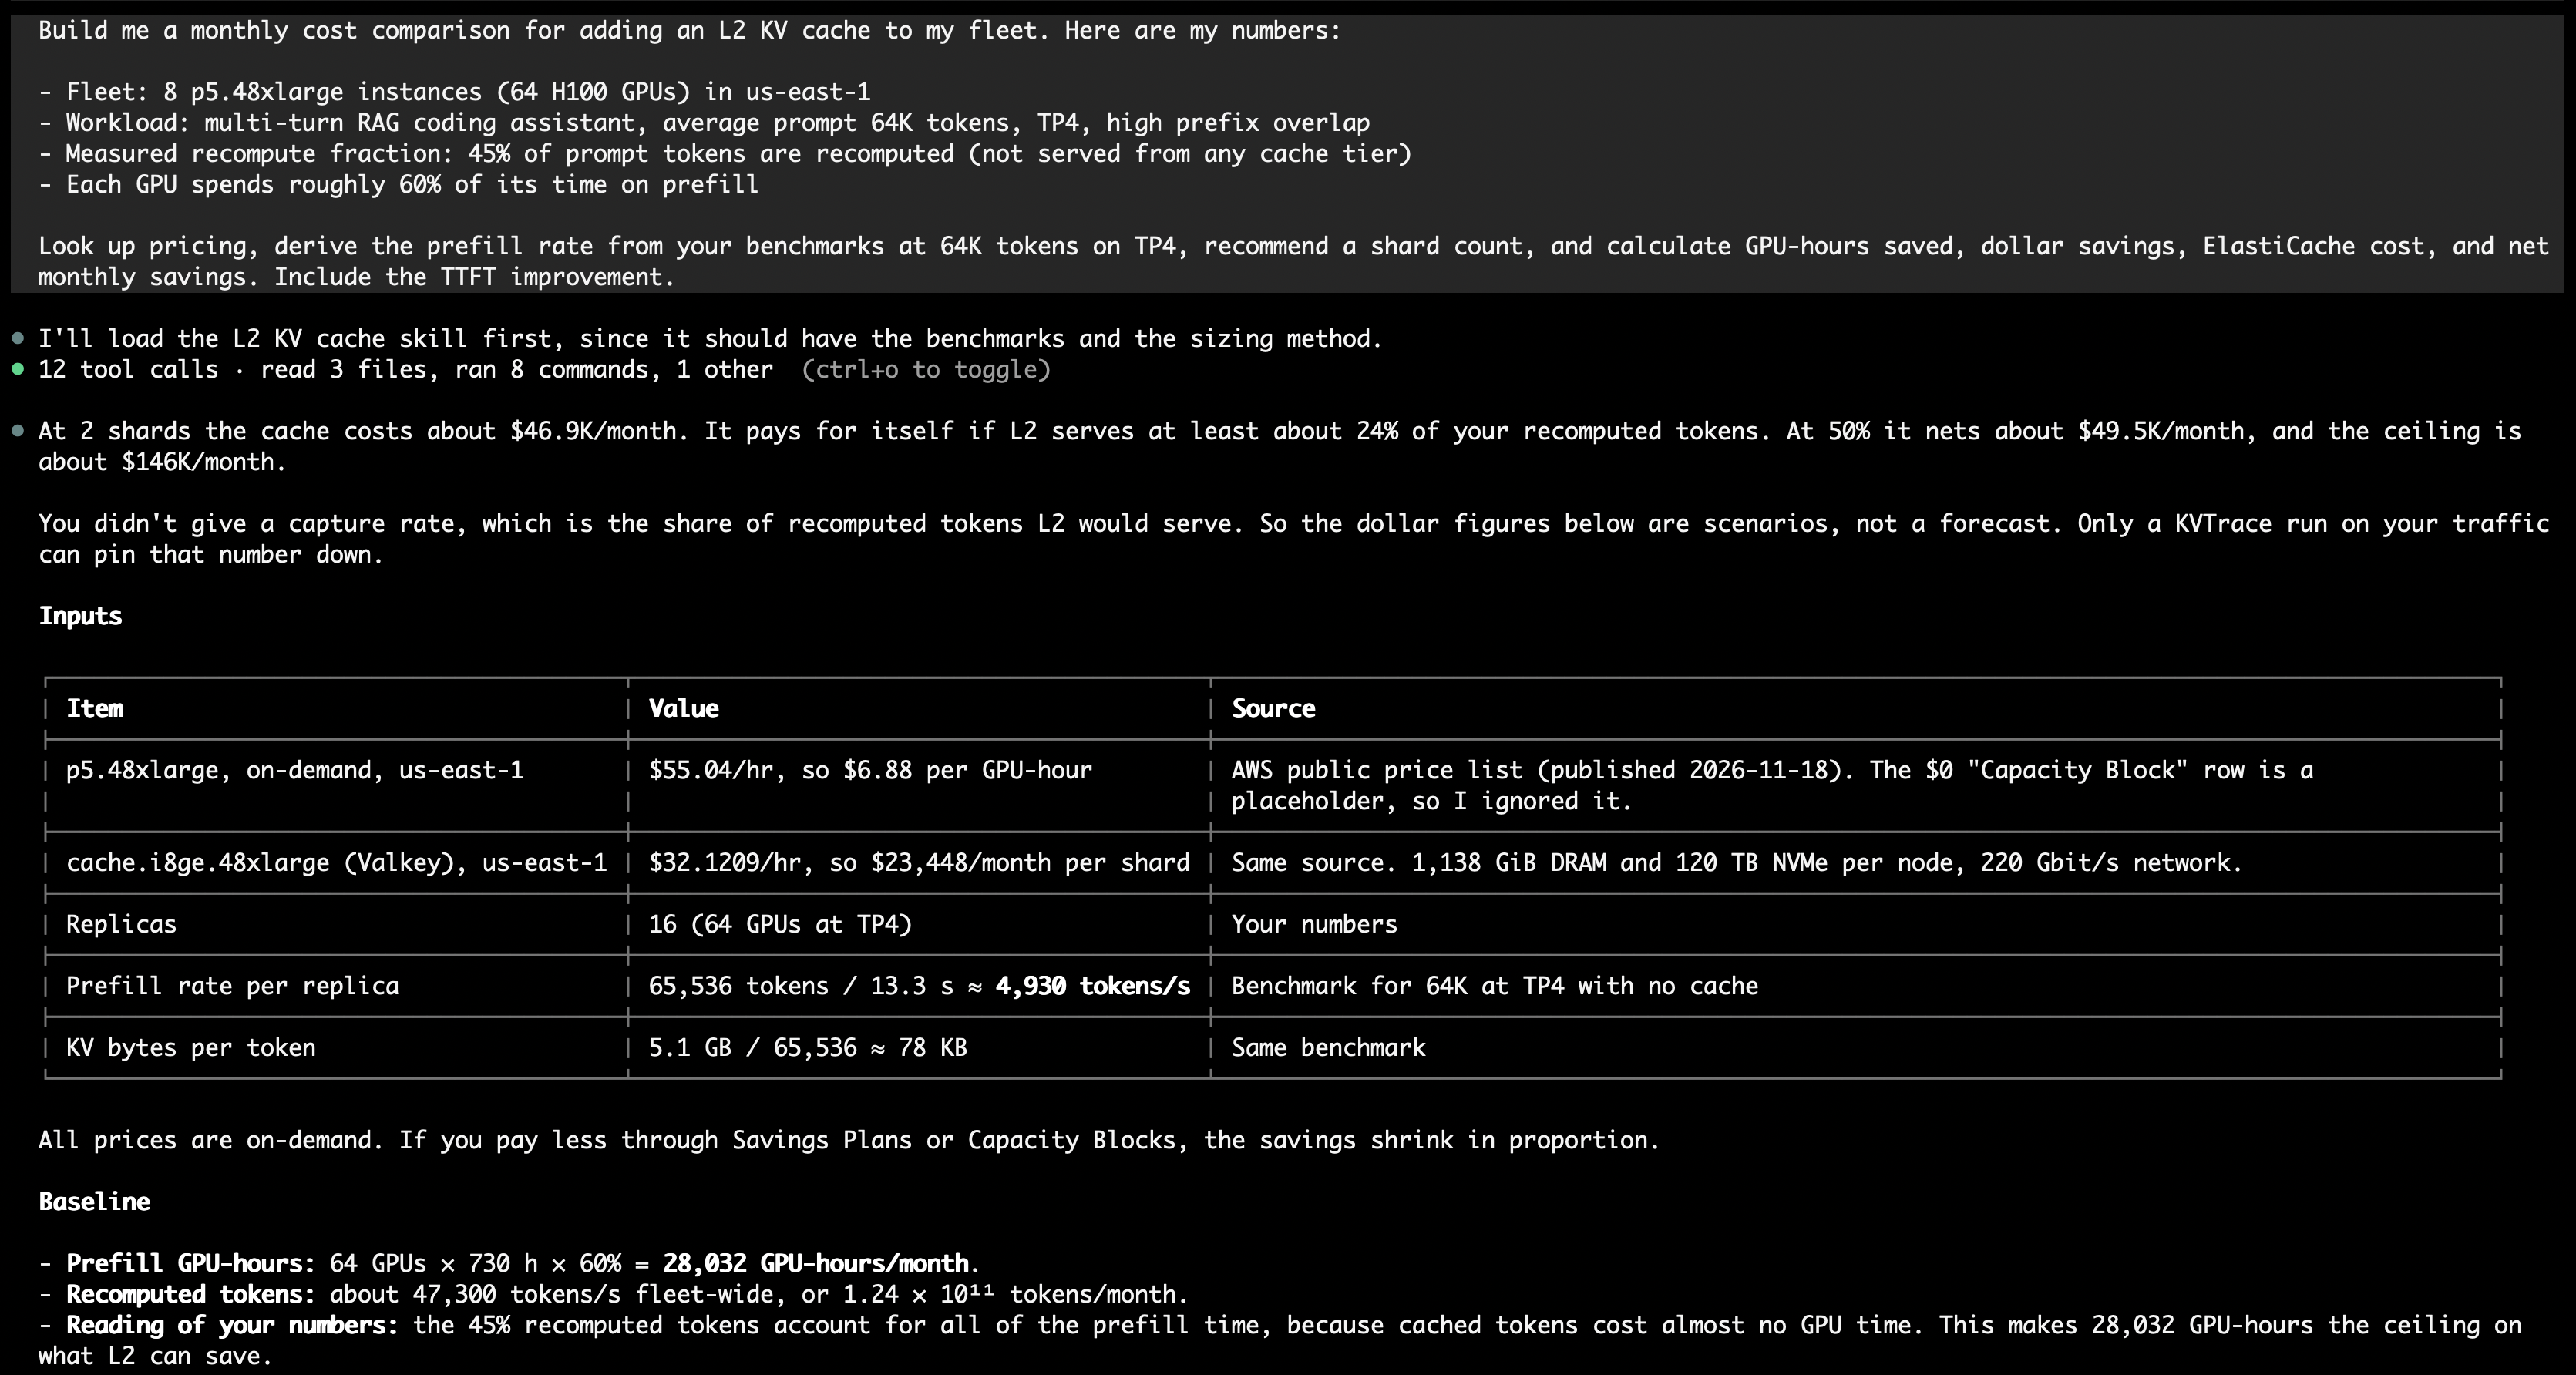
图 2:智能体的总结和输入数据。它在 AWS 价格表中查询了两项价格,并解释了如何得出重新计算估值
我们没有提供缓存命中率,即缓存能够处理的重新计算词元占比。因此,智能体给出了多种情景,并建议运行 KVTrace 以确定缓存命中率。KVTrace 记录 KV 缓存事件 ,这些事件来自 vLLM 或 SGLang。随后,它会离线重放这些事件,针对每种候选容量的共享 KV 缓存进行测试。记录器绝不会写入词元 ID 或提示文本。跟踪数据仅包含数据块哈希和词元数量。数据块哈希源自词元内容,因此请传入 --anonymize-key-file 当您的提示包含敏感内容时。这项技能会在每台 GPU 服务器上记录一个具有代表性的时间窗口,例如完整的一个工作日。智能体还指出,只有当您减少服务器数量,或使用相同数量的服务器处理更多流量时,释放出的 GPU 时间才能转化为实际的资金节省。
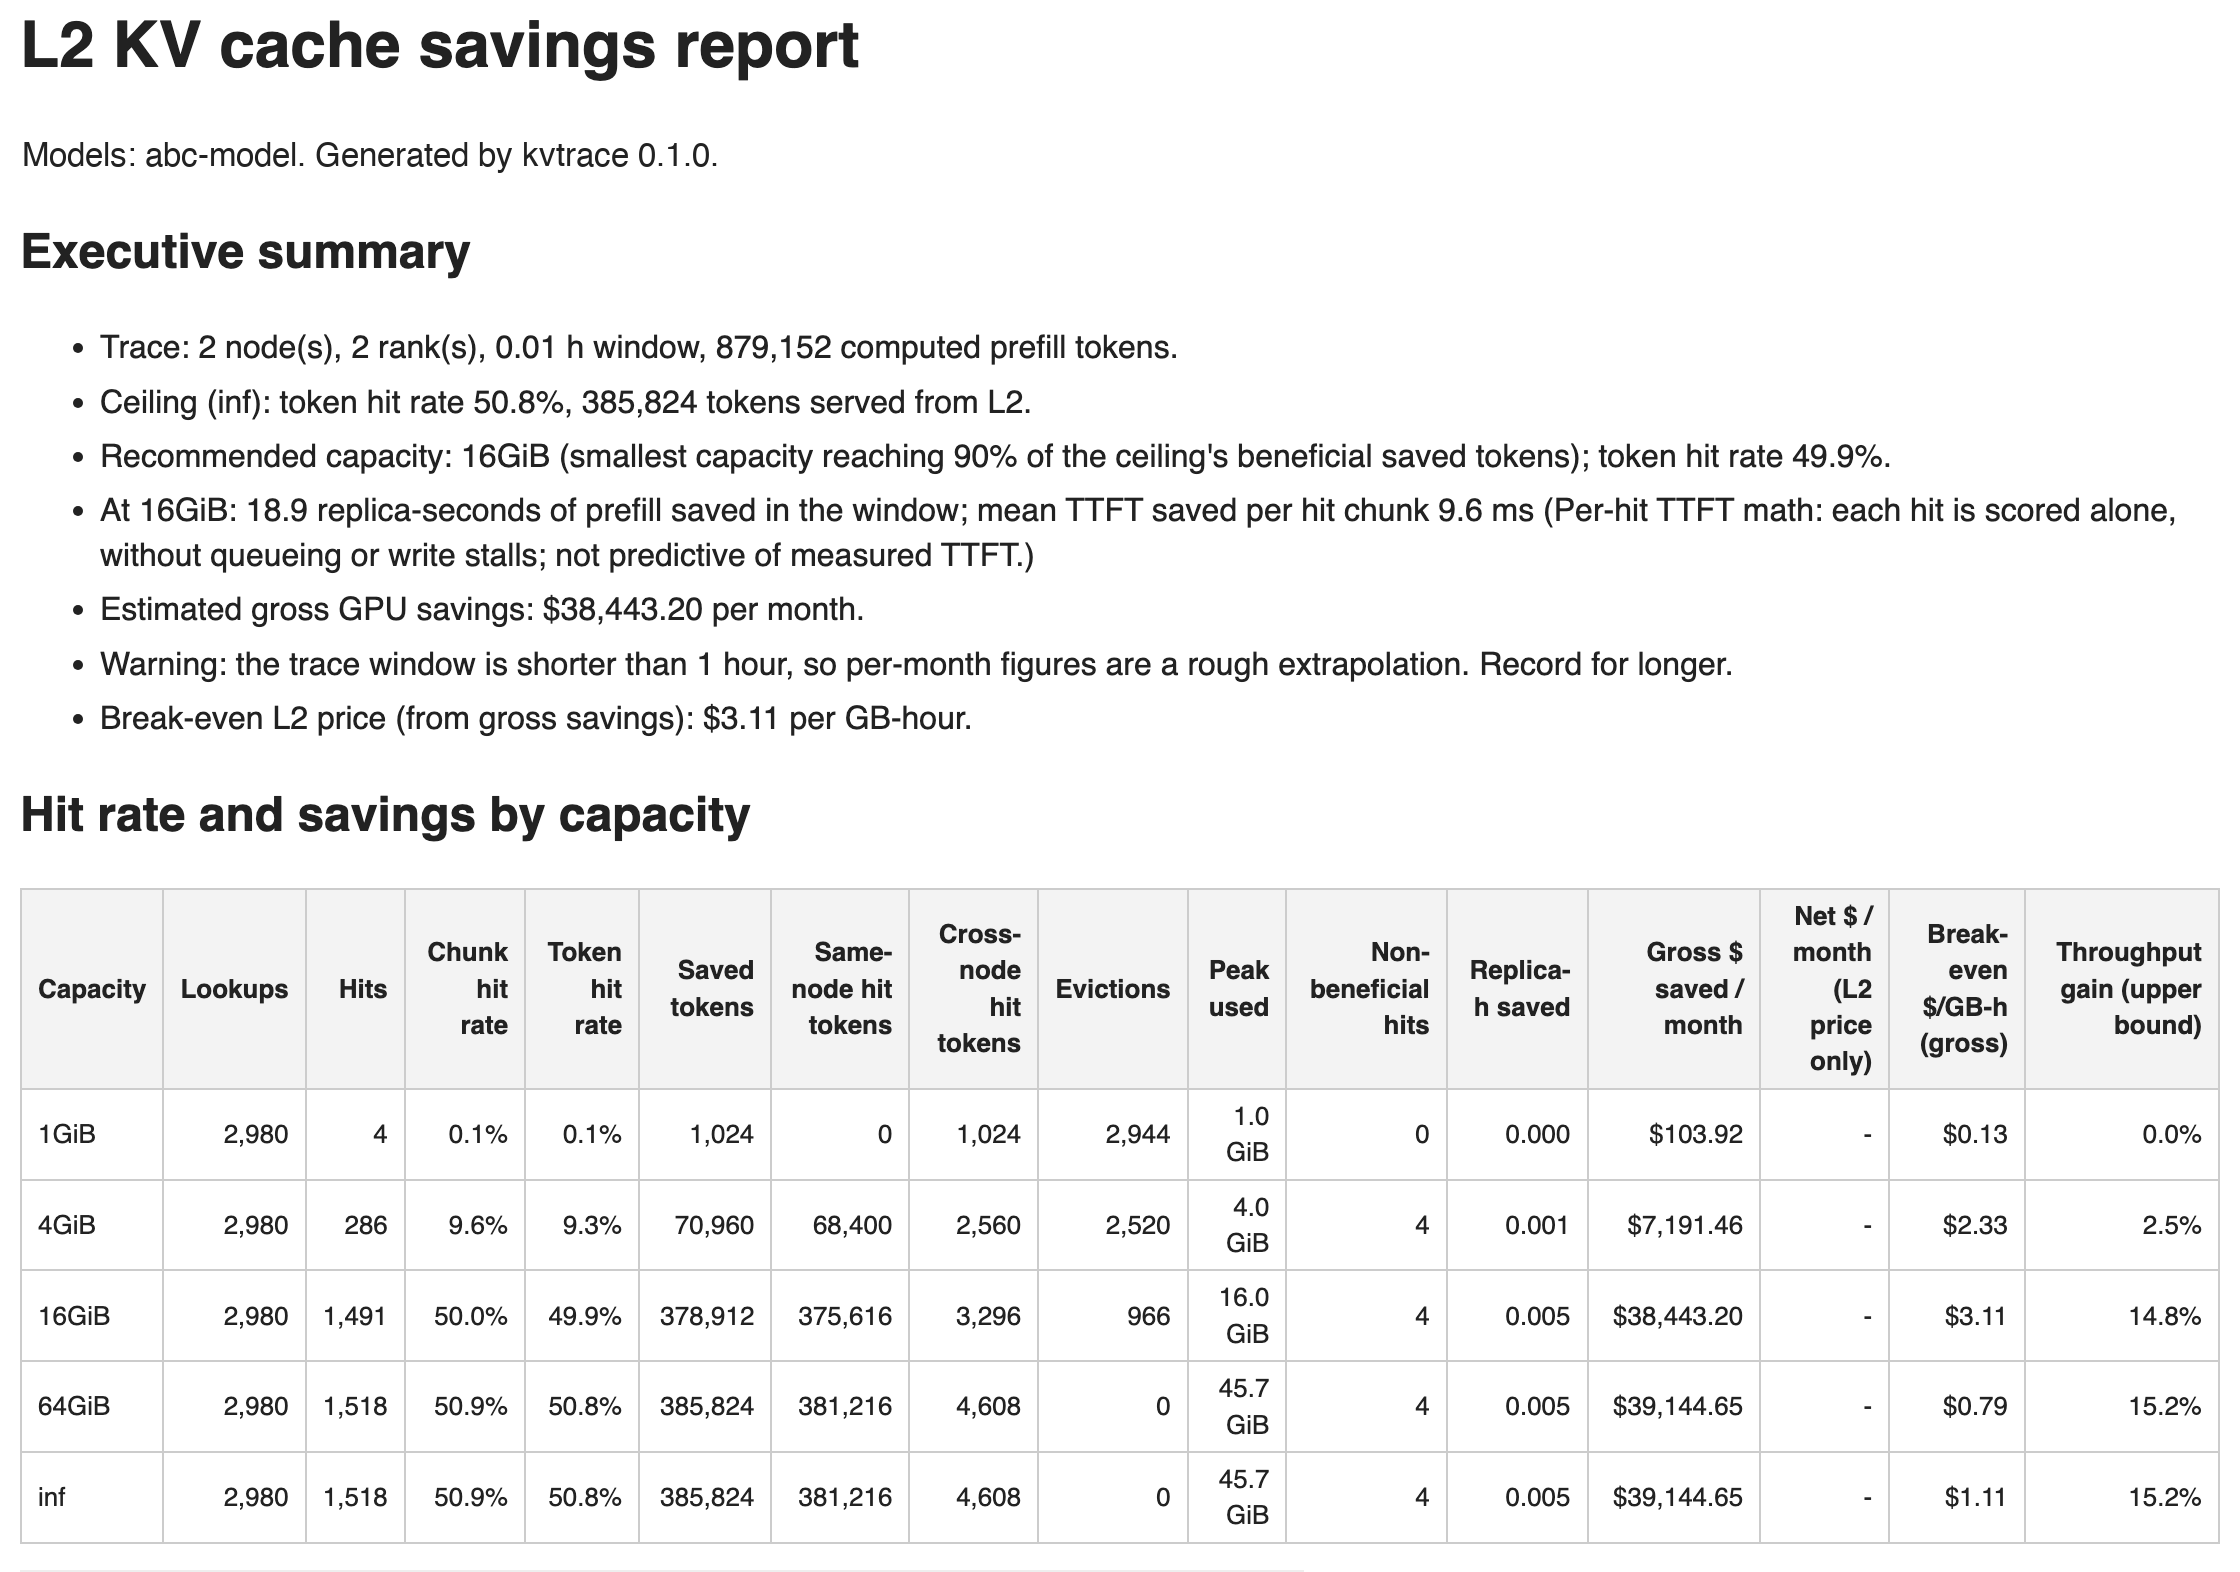
图 3:基于合成演示流量生成的 KVTrace 报告顶部。报告会推荐能够达到节省金额上限 90% 的最小容量。
流程 3:设置分布式 KV 缓存
我们向智能体发出提示:“从零开始为 LLM 推理设置共享 L2 KV 缓存。”在创建任何资源之前,智能体会请求您确认按估算价格在您的可用区中设置建议数量的缓存节点。确认后,它会创建具备 EFA 权限的正确安全组,以及一个使用自定义参数组和缓存淘汰策略的 Valkey 9.1 集群。LMCache 会获得 专属缓存用户,其密码存储在 AWS Secrets Manager中。智能体会准备 GPU 服务器,并在每台 GPU 服务器上启动一个 LMCache 服务器。随后,它使用一个小型测试对象检查集群,并确认重复提示会通过远程直接内存访问(RDMA)从缓存中加载其 KV 状态。对于 GPU 集群,这项技能会将测得的 L2 共享率与 KVTrace 的预测结果进行比较。有关包含每条命令的完整设置说明,请参阅 Amazon ElastiCache 文档中的 分布式 KV 缓存入门 。
流程 4:故障排除
提示:“我的 LMCache 服务器已连接到 ElastiCache 集群,且 BLOB.RDMA_HELLO 成功,但实际数据传输失败。INFO largeobj 显示 rdma_write_errors 持续增加。出了什么问题?”
智能体遵循该技能的故障排除指南,根据这一症状模式进行推理,并判断可能的原因是安全组阻止了其成员之间的 EFA 流量。它会提供用于检查和修复该规则的命令。
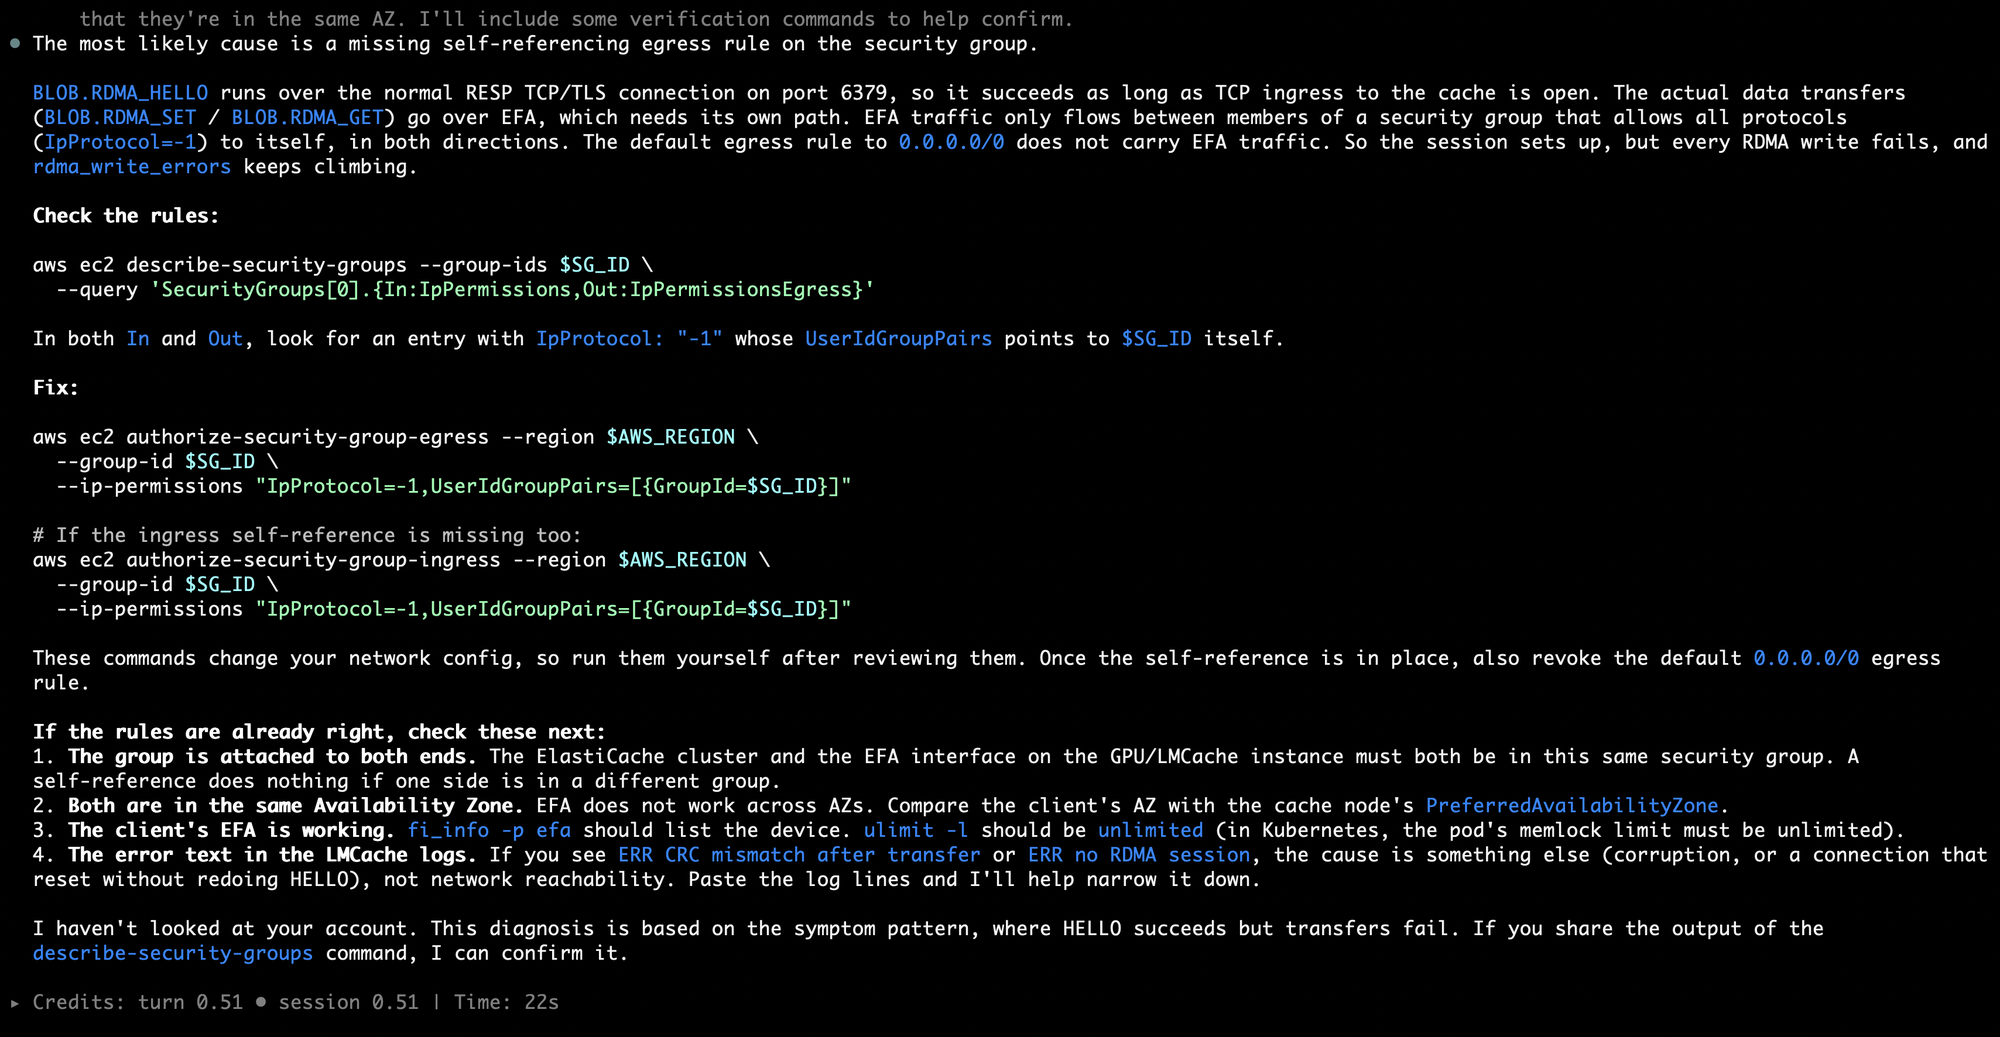
图 4:智能体解释相关症状,然后给出用于检查和修复安全组的命令
开始使用
您可以从 分布式 KV 缓存 技能或 AWS MCP Server,获取地址为 Agent Toolkit for AWS。然后描述您的问题,或要求您的 AI 智能体降低 GPU 集群的成本和延迟,即可开始使用。要详细了解使用 ElastiCache 的分布式 KV 缓存及其性能基准,请参阅 AWS 博客。您可以在以下页面了解如何开始使用 AWS Command Line Interface(AWS CLI): Amazon ElastiCache 文档 ;还可以在以下页面进一步了解 KVTrace: GitHub 仓库.