 AI 热点

- 本系列上一篇文章介绍了 排序工程师智能体(REA),这是一个能够生成假设、设计实验,并在广告排序模型上验证新机器学习(ML)技术的自主系统。
- 现在,我们将介绍如何在庞大且多样化的广告排序模型群中,高效推广排序模型改进,例如架构进步和训练优化。
- 本文将详解这一被我们称为“技术传播”的流程,以及我们如何利用 AI 智能体优化该流程。
- 自 2026 年 3 月起由智能体开始推动执行以来,我们估计,超过 60% 的技术传播工作由 AI 智能体承担。与采用智能体之前的同类工作相比,早期结果显示,工程生产力提升至 3 倍;在部分技术与模型组合中,训练算力中位数降低至原来的四分之一;预计到年底可节省超过 4500 万美元的算力成本。
Meta 的广告推荐系统由大量不同的广告排序模型提供支持,每个模型服务于不同的产品场景和广告主目标,并拥有各自的架构、训练数据及服务约束。
在这一模型组合中,ML 研究人员和工程师正通过我们称为“技术”的创新,不断推进业界前沿。一项 技术 是指任何能够改进排序模型的方法,例如架构层面的进步,包括 Wukong 分解层、 Interformer 交互网络、更丰富的数据表示、训练优化,以及训练和推理方面的效率改进。
然而,由于每个模型都有自己的架构、数据以及训练和服务约束,在一个模型上得到验证的技术几乎从来无法直接复制到另一个模型。同时,速度至关重要,因为 ML 技术具有时效性。今天能够带来收益的创新,可能在几个模型开发周期内就会被取代。经过验证的技术越快覆盖整个模型群,就越能在下一代技术到来之前创造更多价值。
那么,我们如何在尽量减少工程人力和算力消耗的同时,以最快速度将一项技术推广到多样化的模型群中?
规模化技术传播
将日益增多的已验证技术推广到庞大的多样化模型群,会形成一个组合式扩张、需要探索的技术—模型组合空间,而工程人力和算力都会成为显著制约因素。
适配一项技术的标准做法,是由领域专家工程师手动完成适配。工程师会研究该技术如何与特定模型的架构相互作用,对其进行泛化,并根据该模型的约束加以调优。这种方法能产生最优效果,目前仍用于我们营收最高的模型,但无法扩展到这一空间中的所有模型。每次适配都需要投入大量精力,并要求工程师深入熟悉技术和目标模型。因此,处理量受限于工程人力,而适配机会的增长速度要快得多。
传播面临的第二项制约是算力。每次适配尝试都需要进行一次训练,而在算力预算有限的情况下,问题不仅在于尝试哪些技术,还在于如何探索配置的组合空间,避免将预算耗费在大多数只能产生次优收益的尝试上。
这两项制约都指向同一个要求:要将技术快速传播到大量多样化模型中,传播流程必须实现标准化、自动化,并具备作出判断的能力。
我们首先对模型设计进行标准化并实现传播自动化:一种由模板驱动的方法将模型组织为少量可复用、可组合的构建模块,因此,一项技术只要在模板层面完成一次验证,就会自动传播到使用该模板构建的每个模型。在过去两年中,我们通过标准化和自动化,已在庞大且多样化的模型群中上线超过 5000 个技术—模型组合,同时将单个模型所需的工程时间减少了 92%。更多内容可参阅我们关于 标准模型模板(SMT)的文章。.
标准化和自动化能够处理确定性步骤,但要成功且高效地传播技术,仍需作出判断,例如:哪项技术值得传播到哪个模型、超参数搜索范围应有多大、模型为何未能取得收益,以及如何检测并解决故障。这些决策仍需要投入大量人力,使我们无法进一步扩大规模,也无法达到让所有技术在得到验证后几周内覆盖全部适用模型的状态。
这正是 AI 智能体发挥作用之处。
利用 AI 智能体规模化技术传播
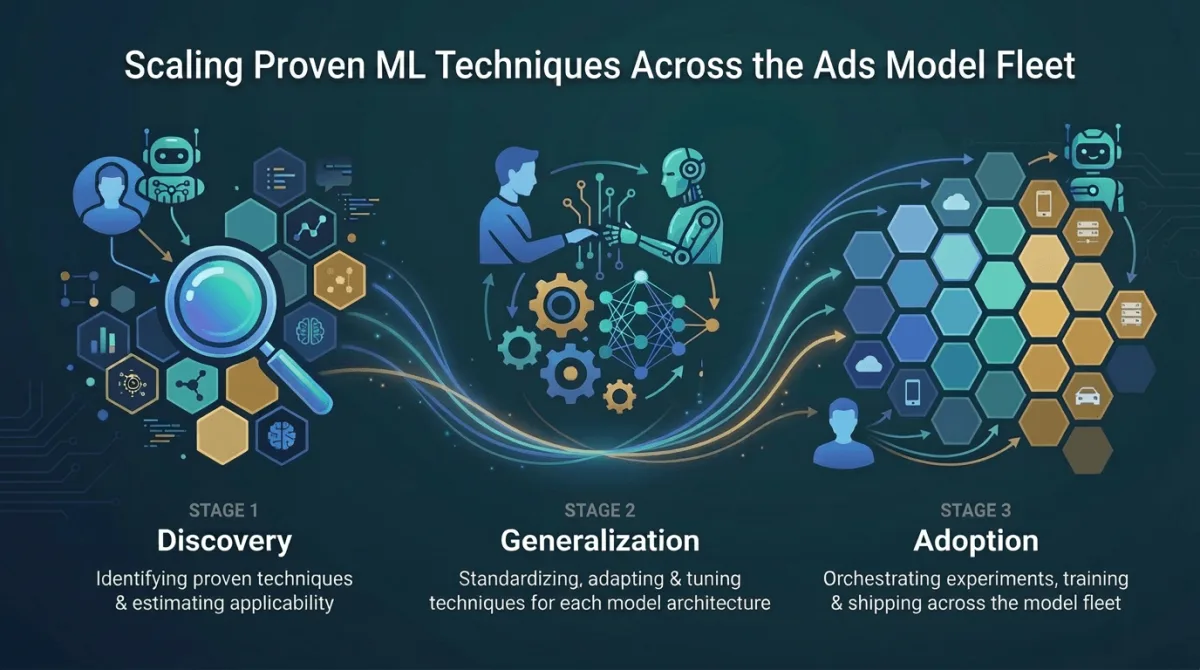
我们的技术传播系统围绕三项能力构建:
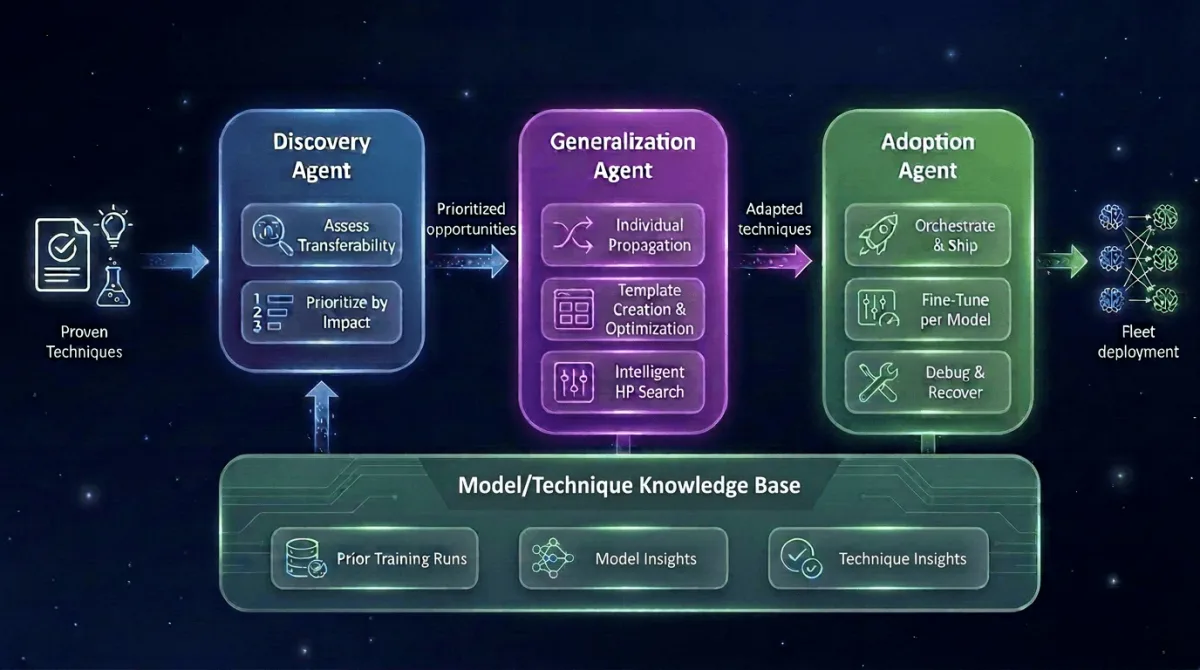
- 发现: 实时掌握哪些技术已经得到验证,并评估每项技术的迁移效果,从而生成按预期影响排序、具有优先级的技术—模型候选组合。
- 泛化: 将经过验证的技术泛化,使其能够用于最初并非为之设计的模型。对于采用共享模板构建的模型,一项技术只需针对每个模板泛化一次,就能覆盖使用该模板构建的所有模型。对于模板覆盖范围之外的模型,每个模型都需要单独适配,而这正是需要最深入技术推理的环节。
- 采用: 将经过验证的适配方案转化为已上线模型,并可同时处理多个模型:启动实验、管理持续数天的异步训练任务、监控收敛情况、诊断故障并从中恢复,以及整理能够落地的提案。
如今,AI 智能体通过承担需要大量判断的非确定性决策,为上述所有能力注入强大动力,并为系统带来深度智能。它们将基于大语言模型的推理与专用机器学习工具相结合,负责决定尝试哪些适配方案、诊断失败原因并自动缓解问题、高效探索超参数搜索空间,以及管理数百个并发任务的算力容量。智能体共享一个公共知识库,其中积累了以往训练任务、模型架构和技术效果的记录,因此它们能够基于已有经验继续推进,而不是从头开始。
智能体如何加快发现过程
发现环节要回答两个问题:有哪些已经验证的技术,以及它们对模型群中的各个模型有多大适用性?直到最近,这两个问题都由领域专家逐一评估模型来回答。他们跟踪整个组织内的研究和成果,找出值得推广的技术,并依靠自己的领域知识判断其适用性。
智能体不受领域专家所面临的知识或工程带宽限制。它们并不依赖某一位专家掌握的知识,而是利用共享知识库,并且能够一次评估整个模型群,而非逐个评估模型。它们系统地识别已有的成熟技术,估算这些技术在模型群中的可迁移性,并生成按预期影响排序的技术优先级列表。如今,工程师只需审核智能体的评估结果,并据此作出决定。
智能体如何提高泛化的计算效率
泛化是指重新实现一项已在某个模型上得到验证的技术,使其适用于架构、特征表示、训练数据和服务约束均不相同的模型。核心理念通常可以迁移,但具体实现几乎从来无法直接沿用。所需的定制取决于技术和目标模型,可能包括重新调优超参数、调整特征以适配目标模型已有的输入或调整架构规模以满足其推理预算,乃至彻底重新设计这项技术。判断特定模型需要什么以及调整到何种程度,需要凭借专业判断。
根据模型是由标准化模板构建还是逐个定制,泛化分为两种类型,而智能体都能提供协助:
- 模板泛化: 对于采用 标准化模板构建的模型,智能体协助构建、评估和改进模板本身。它们根据经过验证的技术提出模板优化假设,在具有代表性的模型集合上启动实验、评估结果、诊断故障,并进行多轮迭代,帮助管理模板开发所需的数天周期。在模板层面一次性验证一项技术,所需算力远低于分别适配每个模型。
- 定制化泛化: 对于收入贡献最高的模型,我们仍会为每个模型单独定制技术。在最初将某项技术应用于少量模型时,智能体会与机器学习工程师协作并逐步学习。当工程师作出调整配置、调优超参数或解决故障等适配决策时,智能体会跟踪每项变更及其结果,记录哪些方法有效、哪些无效,以及哪些决策是模型特有的、哪些可以泛化。有了这些基础,智能体便会为其余模型提出并测试适配方案,而工程师只需审核和指导,无须亲自推动每一个模型的适配。
智能体利用数百万次既往训练任务的数据和每个目标模型自身的特性,从最有可能奏效的配置入手,利用每轮训练任务的结果缩小下一轮的超参数搜索空间,并决定哪些实验值得继续、哪些应当提前停止。因此,在部分技术—模型组合中进行衡量时,我们观察到训练算力中位数 降至四分之一 。
智能体如何加快采用过程
在采用阶段,智能体逐个模型上线已完成泛化的技术。它们启动实验、管理持续数天的异步训练任务、微调每个模型、监控收敛情况、从故障中恢复,并整理经过验证的提案。
微调方式因技术的引入途径而异。对于逐个应用的技术,智能体会帮助寻找最适合特定模型的技术组合配置。对于采用共享模板构建的模型,自动研究循环会在模板基础上进行搜索,针对仅靠共享配置无法实现的增益对每个模型进行调优。
发生故障时,无论是基础设施问题、训练发散还是数据流水线错误,集成式调试与恢复机制都会诊断根本原因,并实施有针对性的修复或重试。
同时运行数百个此类工作流,会带来哪些任务应当优先、哪些训练值得继续或应当提前停止的问题。如何充分利用固定的算力预算是一个全局优化问题,也是我们目前正在投入资源解决的方向。智能体会监控并发训练任务,根据收入重要性、技术潜力和截止日期临近程度对其排序,并从停滞或低价值的训练任务中回收算力,使 GPU 始终用于价值最高的工作,而不是闲置或排在优先级较低的实验之后等待。
过去,工程师必须监视每次训练,手动分诊每项故障并重启任务,因此每名工程师最多只能处理少数几个模型。如今,他们只需在关键决策点进行监督、批准方案并设定优先级,生产力可提升至 3 倍 (即每名工程师现在可以处理三倍数量的技术—模型适配),从而缩短一项成熟技术从验证完成到模型上线所需的时间。
我们如何评估由智能体驱动的技术传播
智能体传播的技术与工程师传播的技术采用相同的评估方式。一项技术必须在预测性能的离线指标(如归一化熵(NE))上有所提升,同时不得导致训练或推理成本等关键护栏指标退步。之后,它还必须在在线 A/B 测试中取得具有统计显著性的优势,才能上线。
但仅在最后进行一次评估,为时已晚,无法指导一个需要跨越多个阶段、连续工作数天的智能体。每个阶段都会产出不同的成果,因此都需要各自的指标。我们正是通过这种方式验证智能体的工作。
发现: 我们会衡量智能体所选技术—模型候选组合的精确率和召回率。对于某项技术,精确率是最终上线该技术的模型占所有入选模型的比例;召回率则是智能体发现的适用模型占该技术所有可行模型的比例。在这一阶段,召回率更为重要,因为此时遗漏的模型不会再有第二次机会;精确率则作为护栏,避免将算力浪费在无法奏效的技术上。
泛化: 我们会在广泛的模型中评估由智能体泛化的技术,确保每项技术都能在最初验证它的模型之外带来增益。我们首先在模型的缩小版本上测试每项泛化技术,以较高的算力使用效率广泛筛选技术—模型适配方案。随后,通过筛选的技术会在一组具有代表性的全尺寸模型上接受评估;它们必须改善 NE 并满足所有护栏指标,才能进入采用阶段。
采用: 在这一阶段,我们继续使用与此前相同的预测性能和护栏指标评估正确性。但采用也是运营工作最繁重的阶段,实验往往持续数天,因此我们也会评估智能体的生产力。其中最重要的两个指标是:完成一项实验所需的人工干预次数,这反映每项实验仍需投入多少工程时间;以及智能体自行诊断并缓解的问题所占的百分比。
在整个传播过程中,人类始终是关键利益相关者,负责审核关键决策、确认需要判断的事项,并最终批准上线内容。
让智能体驱动的传播成为 Meta 的标准方式
鉴于早期成果,我们正在扩大智能体驱动工作流的应用,使其成为在整个模型群中传播技术的主要方式。
目前,每项经过验证的技术要覆盖所有适用模型,可能需要一年多时间。我们的目标是将其缩短到三个月。要实现这一目标,就需要将智能体驱动工作流的端到端吞吐量提高到 5 倍,使技术传播跟上创新步伐,而不是滞后于创新。
为此,我们正继续提升智能体自身的智能水平,通过自我演进式学习改善泛化质量、容量效率和执行能力。在这种学习方式下,智能体会根据积累的结果优化自身策略,而不是仅仅依赖人类提供的启发式方法。
在各个模型间传播技术只是更宏大愿景的一部分。我们正在对排序 AI 领域端到端模型开发生命周期的各个环节进行智能体化改造,涵盖从探索和假设生成,到传播、实验和生产上线的全过程。这些智能体构成了该系统的规模化扩展层,确保每项经过验证的创新都能在整个模型群中充分发挥潜力。
致谢Babak Behsaz、Anuj Bindal、Wenlin Chen、Jae-Woo Choi、Kapil Dontula、Jason Flaks、Ali Gowani、Umut Gunduz、Varun Jalan、Annapurna Kala、Anika Karpurapu、Santanu Kolay、Sundeep Mallela、JP Owed、Rudresh Rajnikant Panchal、Sandeep Pandey、Dhiraj Parashar、Ray Qin、Shah Rahman、Munaf Sahaf、Alex Sandrovskii、Matt Steiner、Vivienne Sung、Ritwik Tewari、Alireza Vahdatpour、Jacky Wang、Hitesh Yalamanchili、Fan Yang、Shuting Zhao、Wenhan Zhao 和 Peng Zhong。