Odyssey一手模型发布
AI 评分62Odyssey 发布基础世界模型 Odyssey-3
#模型发布#具身智能#多模态
#模型发布#具身智能#多模态
Google DeepMind 发布 Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking 两款实时对话模型,即日起通过 Gemini API、Google Workspace 和 Gemini 应用开放。Gemini 3.8 Live Extended Thinking 在 Artificial Analysis 语音到语音质量指数得 82.6 分排名第一,τ-Voice 智能体任务完成率 68.6%,Big Bench Audio 得 97.7%;Gemini 3.8 Live 在 Speech Agent Arena 排名第二。两款模型支持近实时视觉输入、对话中自动切换 97 种语言,并可在后台执行工具和 API 调用而不打断对话。
#模型发布#语音#推理
#产品更新#图像生成#OpenAI
Fireworks 发布 DeepSeek-V4.1-Flash,在 DeepSWE 上 pass@1 为 74.34%,与 GPT-6-Astra 的 74.12% 处于同一水平,单任务成本 0.43 美元,约为 Astra 的 1/15。该模型为 552B 参数 MoE,采用输入 8B、输出 16B 的分离激活预算,KV Cache 的 HBM 占用降至上一代 V4 的 1/4。在 HLE 上它得分 34.52%,低于 Astra 的 50.40%,作者认为它更适合智能体编码而非高难推理。
#评测/基准#编码#推理
DeepSeek 本周发布并开源 DeepSeek-V4.1-Flash,这是一个 552B 参数、8B 激活参数用于 prefill、16B 用于 decode 的多模态 MoE 模型,支持 1M token 上下文窗口,已上线 HuggingFace 与 Baseten Model APIs。它采用 Causal Encoder-Decoder 架构,prefill 只跑 20 层编码器,decode 跑完整模型,官方称全局 KV cache 内存仅为 V4-Flash 的四分之一。在编码与智能体基准上,V4.1-Flash 以约三分之一的总参数量超过 V4-Pro,长程智能体任务提升达两位数,但 Automation-Bench 得分 54.8,复杂工作流仍有约一半失败。

#模型发布#DeepSeek#开源生态
ElevenLabs 发布 Music v2.5,并将其设为 ElevenMusic 提示词生成和参考生成的默认模型,歌曲乐器更自然、层次和动态更丰富。在覆盖 47,885 组结果的同提示词盲测中,v2.5 获得多数偏好,优势在以人声和原声乐器为主的曲风中最明显。所有套餐均支持无损下载,Free 每日可下载 5 次,Pro 每月可下载 400 次,但引用其他艺人歌曲生成的曲目不可下载。
#模型发布
OpenAI 在 API 中推出 GPT-Live-1,开发者可用它构建自己的语音应用。该模型采用新版 ChatGPT 语音所用的双工技术,支持语音智能体边说边听,并搭配开发者选择的模型与工具体系。
GPT-Live-1 is now available in the API. Bring ChatGPT’s natural back-and-forth to your app, with voice agents that listen while they speak and work with the models and harness you choose. https://t.co/gIl1gwsBDV
#产品更新#语音#Agent
Cohere 发布混合专家机器翻译模型 North Small Translate,支持 50 多种语言,在 WMT26 全语言基准中获得 83.6 分。该模型可在 Hugging Face 下载多种近无损量化权重,并以 CC BY-NC 4.0 许可开放研究和非商业使用;Cohere 称其相同并发和硬件配置下的输出吞吐量最高比 Gemma 4 31B TP1 高 1.4x。
#模型发布#开源生态#Hugging Face
Cognition 发布编码模型 SWE-2,在 FrontierCode 1.1 Main 上得分 50.0%,比 Fable 5.1 低不到 1 分而成本便宜 64%。SWE-2 基于 2.8T 参数的 Kimi K33 后训练,首次把 RL 扩展到数万亿参数规模,并用单次 RL 训练覆盖全部推理档位。该模型即日起在 Devin Desktop 和 CLI 上线,随后在 Devin Web 和 Fusion 推出。
#模型发布#编码#Agent
Sakana AI 发布 Fugu Max 和 Fugu Ultra v2 两款编排模型,均通过 OpenAI 兼容 API 提供,已有 Fugu 用户只需改一行参数即可升级。Fugu Max 整合包括 NVIDIA Nemotron 系列在内的开放权重与专用模型池,在 Terminal Bench 2.1、GPQAD、AA-LCR、GDP.pdf、AutomationBench 和内部基准 SWEFish 六个基准上取得最佳总分,定价为每百万输入 token 2 美元、每百万输出 token 6 美元,输出价格比 Sonnet 5、GPT 5.6 Terra 和 Kimi K3 低 40-60%。Fugu Ultra v2 面向复杂多步任务,在 Chartography 上得分 48.3,高于 Opus 5 的 27.3 和 Fable 5 的 29.5,在 DeepSWE 上得分 74.3,且其智能体池中不含 Fable 5、Fable 5.1 或 GPT-6-Astra。
#产品更新#Agent#部署/工程
#模型发布#语音#开源生态
#模型发布#多模态#DeepSeek
V4.1-Flash 的 KV cache 相比上一代仅需 1/4 的 HBM 和 1/8 的 SSD 存储。由于缓存命中费用通常占智能体成本的较大部分,压缩缓存可显著降低相关成本。
#模型发布#Agent#部署/工程
#模型发布#数据/训练#DeepSeek
DeepSeek 推出 DeepSeek-V4.1-Flash,这是其新架构模型族中最小的模型,具备原生视觉理解能力。该模型旨在增强能力、加快推理、提高吞吐量,并支持扩展至更大模型。
#模型发布#多模态#推理
Suno 发布新一代音乐模型 v6,称其为迄今最好的模型,速度更快、表现力更强、质量更高,并与 Warner Music Group、BMG、Believe 等行业伙伴共同开发。v6 首次提供三款模型以覆盖专业音乐人、新兴创作者和音乐爱好者,支持用自然语言修改歌曲局部、跨曲目混搭、采样与分离音轨、按氛围或参考生成,以及用文本、音频、图像和视频创作音乐。Suno 表示 v6 铺开后旧模型将退役,平台整体迁移到 v6 代际,后续还将推出围绕单个艺人、艺人可选择参与并获得收益的新产品。

#产品更新#语音#模型发布
#开源/仓库#视频#Agent
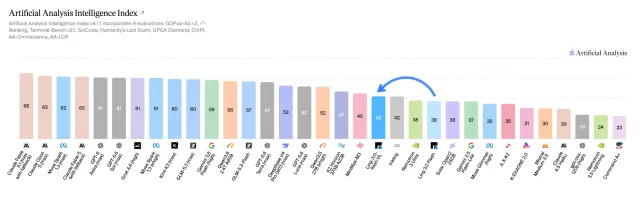
蚂蚁百灵发布并开源百灵系列首个原生多模态大模型 Ling-3.0-flash-VL,基于 Ling-3.0-flash 的 MoE 架构拓展,总参数 124B、单次推理激活 5.5B,原生支持图像、文本与视频输入,上下文窗口 256K Token。官方称原生多模态联合训练使模型在 Artificial Analysis Intelligence Index v4.1.1 上较纯文本版本提升 4 分,并引入观察、行动、验证、修正的视觉反馈闭环用于前端复刻、GUI Agent 和医疗报告解读。模型已在 Ling Studio 上线免费体验,BF16 和 FP8 版本已在 Hugging Face 与 ModelScope 开源。
#模型发布#多模态#开源生态
OpenAI 发布 Astra,作者称其为 GPT-6 家族的开端,在 ARC-AGI-3 上表现突出,并在 Zapier 的 AutomationBench 上得分最高,定价与 Fable 5.1 相同。作者周末试用时消耗了 40 亿 token,认为它能力波动明显,是展示型而非稳定干活的模型。Codex 中的 Astra 现在可以在不等待回答的情况下继续推进任务,OpenAI 还称已达成自动化研究实习生目标,下一个目标是 2028 年 3 月前做出自动化 AI 研究员。
#行业动态#OpenAI#Anthropic
#大佬观点#数据/训练#OpenAI