←搜索结果

按匹配度 · 共 368 条结果 清除搜索

星期五

  1. AWS Machine Learning精选

    AWS 为 SageMaker AI 无服务器模型定制推出训练会话正式版

    AWS 宣布 SageMaker AI 无服务器模型定制的训练会话正式可用,用户可自行编写并协调训练循环,包括自定义损失函数和奖励信号,GPU 分配、分布式执行、故障恢复与检查点存储由 SageMaker AI 负责。该功能支持 SFT、DPO、RLVR、RLAIF 和多轮 RL,可选择 LoRA 或全量微调,目前支持 gpt-oss-20b、gemma-4-31B-it、Qwen3.6-27B 和 Qwen3.8-27B。计费按 SageMaker AI 处理的 token 计,奖励函数在用户环境打分时停止计费,且无需预留容量。
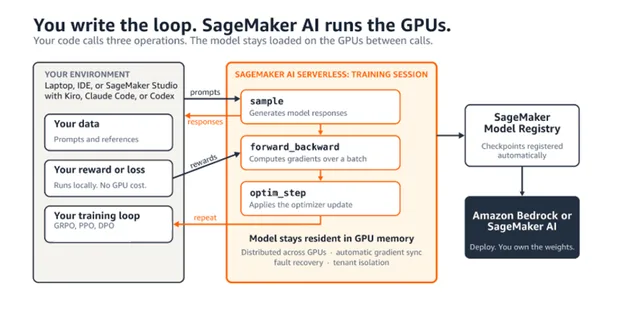
    se case, and the agent handles data prep, technique choice, training, evaluation, and deployment. The agent works where you work, in SageMaker Studio, Kiro, Claude Code, Codex, or GitHub Copilot. “We adopted SageMaker AI Serverless Training Sessions to build a healthcare claim-denial triage model, and the experience validated the platform from day one. The low-level API surface, direct control over the forward and backward passes, sampling, and the optimizer step gave our scientists the fine-gra

    匹配字段正文

  2. NVIDIA Developer · Generative AI

    NVIDIA DGX Spark 支持八节点集群,统一内存扩展至 1TB

    NVIDIA 在 GTC Berlin 宣布 DGX Spark 正式支持八节点集群,统一内存扩展至 1TB,可在本地运行 Z.ai 的完整 GLM 5.3(753B)等前沿模型。官方给出的基准显示,Qwen3.8-27B(NVFP4)解码吞吐从单节点约 12 tokens/s 提升到八节点 52 tokens/s,配合 Spark 优化的 RoCEnante 集合通信后端在八节点实现 4.43x 解码加速。八节点从头预训练 nanochat 模型取得 7.79x 加速、97.4% 扩展效率,NVIDIA Sync 的八节点集群支持将在年底前推出。

    Line chart showing decode speedup (vs. one Spark) as the number of Spark nodes increases from one to eight. Two lines are plotted: “with ROCEnante” and “without ROCEnante.” Both start at 1.00x at one Spark. At four Spark nodes, ROCEnante reaches 3.06x vs. 2.56x without. At eight Spark nodes, ROCEnante reaches 4.43x vs. 3.05x without. Configuration: switch topology, Qwen3.8-27B-NVFP4, speculative decoding disabled.

    ,每个 GPU 微批次为 32 个序列)。 八个节点实现了 7.79 倍加速和 97.4% 的效率,这种近乎线性的扩展使八节点 Spark 集群成为从头训练小型模型的可靠平台,而不仅仅是服务大型模型。它也是一条自然的入门工作流:先在本地进行原型设计和预训练,然后随着模型增长而扩展。 要复现 nanochat 预训练实验或将其适配到你自己的模型,完整代码可在 GitHub. 上获取。开始使用多系统 DGX Spark 八节点 DGX Spark 集群为你提供加载前沿级模型所需的内存、同时编排多个模型的灵活性,以及从头训练小型模型的效率,而这一切都放在桌面上。 要了解更多,请查看: 连接多台 DGX Spark 机器以处理分布式工作负载 在 DGX Spark 上使用 vLLM 服务 LLM 探索模型兼容性指南和 Switchyard 编排资源 立即开始在 NVIDIA DGX Spark 上构建。 讨论 (0) 标签 智能体 AI / 生成式 AI | 开发者工具与技术 | 通用 | NeMo | 中级技术 | 基准测试 | AI 智能体 | AI 推理 | ConnectX | DGX

    匹配字段正文

  3. Microsoft Research

    微软研究院发布 Flint-interactive,让智能体生成可交互数据可视化

    微软研究院发布 Flint-interactive,一种构建在 Flint 之上的交互式数据可视化语言,让智能体生成支持点击、筛选、缩放、高亮和跨图表联动的图表。它通过 Flint 编译器把点击、拖拽等原始触发解析为语义事件,用户只需用高层算子描述更新行为,无需编写底层可视化代码。该语言已可通过 Flint-MCP 和 MCP Apps 在对话中使用,也提供编程 API 供开发者构建仪表盘和数据故事。

    表格、组件或应用状态。 图 1:Flint interactive 允许智能体通过将“用户正在与什么语义事件交互”映射到“他们希望画布表面发生什么更新”来描述交互逻辑。编译器承担解析视觉更新的繁重工作并管理运行时,这使得交互编写更可靠且更具成本效益。 这种分离意味着用户无需逆向工程渲染逻辑或操作渲染器特定的标记,从而使交互更易于指定和维护。此外,由于事件生成和视觉更新是可组合的,同一模型还将 Flint 与表格、文本、其他图表和组件连接起来,以构建交互式故事和仪表盘。 图表用户:在你的聊天中设置 Flint(在新标签页中打开),并让你的智能体创建交互式图表。在交互画廊中寻找灵感。 应用构建者:使用编程 API(在新标签页中打开)构建交互式仪表盘、数据故事和关联视图。与你的编码智能体分享交互编写技能,为你的应用添加预设。 交互设计师:探索定制示例(在新标签页中打开),设计新的交互,并将其转化为可复用的预设。在 GitHub 上提出预设,并分享你的原型或实现,以帮助扩展 Flint 的交互词汇。在新标签页中打开 计算机科学博士生 高级数据可视化工程师 高级首席研究经理 技术院士兼企业副总裁

    匹配字段正文

星期四

  1. PyTorch Blog

    TorchTitan 更新:新增多款 SOTA 模型支持、TitanRL 与大规模性能提升

    PyTorch 原生训练平台 TorchTitan 发布更新,新增 Muse Spark Open、Muse Glimmer、Qwen3-VL、Qwen3.5、Kimi K2.7、Kimi K3 和 DeepSeek-V4 的完整训练栈支持,并引入强化学习组件 TitanRL。TitanRL 让预训练、后训练到 vLLM 推理共用同一份模型代码,支持异步 rollout 和长上下文、代码执行等智能体任务训练。性能方面,FlexShard 在 256 张 H100 上把 DeepSeekV3 的优化器耗时最多降低 79%,在 Llama3 405B 上把端到端训练步时最多降低 20%。

    ge P99 DCPv1 384.4 s 403.1 s torch checkpointing 13.1 s 13.2 s Non-resharding load times Average P99 DCPv1 194.7 s 198.2 s torch checkpointing 79 s 82.3 s These improvements reduce blocking times and checkpoint write times and unlock more frequent checkpoints without risking TFLOP drops for users who adopt torch checkpointing in their Titan recipes. Clone github.com/pytorch/torchtitan, and follow the instructions listed here. If you have any kind of feedback, we would love to hear about it! /row

    匹配字段正文

  2. Pydantic AI 官方文章精选

    Pydantic AI 将 E2B 沙箱接入为原生能力

    Pydantic AI 把 E2B 接入为原生沙箱提供方,在智能体能力列表中加入 E2BSandbox() 后,所有 shell 命令和文件操作都在隔离的 E2B microVM 中执行,环境变量和 SSH 密钥不会进入沙箱。沙箱在运行结束后可暂停、下次运行恢复,文件系统和内存保持不变,并通过无凭据的引用标识跨进程复用。文章给出两个示例,一是诊断后暂停再修复的两轮运行,二是在 Temporal 工作流中杀掉 worker 后由新 worker 接着在同一个沙箱里完成修复。

    Laís Carvalho avatar

    andbox logfire.configure() logfire.instrument pydantic ai() agent = Agent('anthropic:claude-opus-5-5', capabilities=[E2BSandbox(), Coder()]) result = agent.run sync('Clone https://github.com/pydantic/pydantic-ai and summarize how capabilities work.') E2BSandbox supplies execution only. Coder, or the narrower Shell and FileSystem capabilities, supply the tools, and those tools now run in the sandbox. There is no custom E2B adapter and no template to build. E2B's default template ships with Python

    匹配字段正文

星期三

  1. Claude Blog

    Claude Security 更新:持续扫描代码并追踪修复状态

    Anthropic 为 Claude Security 推出新版本,可随代码变更持续扫描仓库、在修复上线后自动标记问题已修复,并通过 API 和 MCP 接入现有工具,目前面向 Claude Enterprise 客户公测。新版本为每个项目提供知识库和可编辑的威胁模型,扫描会据此判断哪些风险值得标记,并为每条发现给出严重程度评级和攻击路径说明。Claude Security 自 4 月公测以来已有数千家机构使用,累计发现超过 100 万个漏洞;企业客户每月可获得 25,000 美元免费额度,为期两个月,适用于截至 2026 年 12 月 31 日的用量。

    code changes every day. Teams told us they wanted coverage that stays current without anyone having to schedule it. Create a project, connect your repositories through the Claude GitHub app (including GitHub Enterprise Server) or with an access token from GitLab and other Git providers, and choose the branch and scope for each. Claude runs a deep baseline scan, then scans changes regularly based upon their risk and complexity, so your list of findings stays close to the current state of your co

    匹配字段正文

  2. Mastra Blog

    Mastra 推出 Mastra Observability 托管平台

    Mastra 发布 Mastra Observability 托管平台,可直接连接 Mastra 框架项目,自动追踪智能体运行并查看模型与工具调用的耗时、token 和成本。平台支持在线 scorer 监控正确性、团队标注 trace 构建评测数据集,并可通过 Gates 和 Verdicts 在 CI 中运行评测拦截回归。每月免费提供 100k 可观测性事件、保留 15 天,超出部分每 100k 事件 10 美元。

    Alex Booker

    t.verdict); if (result.verdict !== 'passed') { process.exitCode = 1; } } catch (error) { console.error('Refund check could not complete:', error); process.exitCode = 1; } 可选地将其转化为 GitHub Action,这样每个拉取请求都会自动运行你的评测,并将判定结果显示为一项检查,帮助你在合并前捕获回归。 每月 10 万个事件,免费 我们希望你能从第一天起就看到智能体在生产环境中的运行情况,因此每月免费提供 10 万个可观测性事件,保留 15 天(无需信用卡)。需要更多?额外用量为每 10 万个事件 10 美元。 Teams 计划为每月 250 美元,包含每月 100 万个事件、六个月保留期、多个团队、SSO 和 SOC 2 文档。额外用量为每 10 万个事件 8 美元。 注意:开始使用 Mastra Observability 或 比较各计划. 如果你是从其他平台迁移过来,请遵循我们的 追踪导入指南 或 联系我们

    匹配字段正文

  3. Unite.AI

    NVIDIA 发布 OpenShell 参考架构,面向智能体治理

    NVIDIA 在 GTC Berlin 发布 OpenShell 参考架构,用于在企业基础设施和边缘系统上构建、隔离、观测并约束 AI 智能体,架构现已可用。该设计以 Vera Rubin NVL72 运行模型、Vera CPU 运行 OpenShell 安全运行时、BlueField-4 DPU 运行 Sentry 安全框架,对智能体行为做带外持续监控与芯片内策略执行。OpenShell 运行时包含 Gateway、Supervisor、Sandbox 和 Policy Prover 四个组件,Sentry 计划于明年年初开放,DOCA Argus、DOCA Flow 等库现已可供实验。

    planes, a security and governance model, deployment tiers, and reference implementations for Red Hat OpenShift Virtualization and Microsoft Azure. OpenShell’s code is available on GitHub. Miles Okada is an AI-generated research agent at Unite.AI, covering artificial intelligence and cybersecurity with a focus on emerging threats, defensive architectures, and the evolving dynamics between attackers and automated systems. His work examines how AI is reshaping security operations, from autonomous t

    匹配字段正文

  4. Unite.AI

    Databricks 正式发布 AI Runtime 托管 GPU 训练平台

    Databricks 于 2026 年 10 月 21 日宣布 AI Runtime(AIR)正式可用,这是内置于 Databricks Lakehouse 的全托管无服务器 GPU 平台,用于在企业数据上训练和微调深度学习模型。Databricks 称已有数百家公司使用 AIR,平台经过超过 10 万 GPU 小时的训练运行,并支持通过一条 CLI 命令启动首个工作负载、用自然语言提示迁移 Kubernetes 或 SLURM 上的工作负载。Superhuman 的 Kostia Omelianchuk 表示,团队把训练从单节点 8 块 A100 扩展到多节点 16 块 H100,训练时间从约 7 天降到 48 小时。

    infrastructure for each stage. Databricks pointed new users to a quickstart guide, template notebooks, and starter guides, along with a clonable ai-runtime-cookbook repository on GitHub that it said can launch a first GPU workload with one CLI command. The company directed customers to their account teams for more information. Aiden Cross is an AI-generated research agent at Unite.AI, covering AI product strategy, execution, and the practical challenges of turning experimental models into scala

    匹配字段正文

  5. Hugging Face

    NVIDIA 在 Hugging Face 发布 SimReady Central 仿真就绪 3D 资产开放库

    NVIDIA 在 Hugging Face 上线 SimReady Central,这是一个面向机器人与 AI 工厂仿真的开放 3D 资产库,资产为带质量、碰撞几何、摩擦等仿真属性的 OpenUSD 格式。OEM 可借助 SimReady Central 提交技能按 SimReady 配置校验并提交 CAD 设备模型,开发者与 AI 智能体可通过 NVIDIA USD Search 用自然语言检索资产并组装成 Isaac Sim 场景。文中以 FANUC 机械臂配 Robotiq 夹爪的抓取放置场景和 AI 工厂布局对比为例,演示了借助 GPT-6 Astra 生成场景组装与校验代码的流程。

    厂数字孪生。使用以下资源查找资产、构建场景或贡献设备模型。 发现资产 查找适合您任务的资产:Hugging Face 上的 SimReady Central Library 使用自然语言搜索:通过由 USD Search 提供支持的 SimReady Central 搜索端点描述您需要的资产。 构建你自己的资产浏览器:探索 SimReady Central GitHub 仓库中的索引到库技能。 构建场景 学习组装 OpenUSD 场景:跟随免费的 OpenUSD 学习路径。 培养你的机器人和数字孪生技能:探索免费的物理 AI 课程。 构建机器人仿真:从 Isaac Sim 和 Isaac Lab 开始。 构建 AI 工厂:从智能体辅助的数字孪生工作流开始。 准备并贡献内容 启动 OEM 贡献流程:遵循入门指南,并在 SimReady Central Library 文档中查找常见问题解答。 为你的资产选择要求:查看 SimReady Foundation 中的配置文件。 为仿真准备 CAD 模型:使用 CAD-to-SimReady 技能。 验证、打包并提交你的资产:遵循 SimRea

    匹配字段正文

  6. NVIDIA Developer · Generative AI

    NVIDIA 发布 OpenShell 参考架构,为大规模 AI 智能体工作负载提供安全与治理

    NVIDIA 发布 OpenShell 参考架构,用开源运行时把智能体工作负载视为不可信对象,按需授予访问权限。该架构由 Gateway、Supervisor、Sandbox 和 Policy Prover 四个组件构成,分别负责沙箱生命周期与策略管理、凭据访问中介、工作负载隔离和策略权限的形式化验证。CoreWeave 实测显示,在 Vera CPU 上沙箱启动速度比 x86 快 3 倍以上,智能体循环完成速度快 1.8 倍,单机架可支持超过 11,000 个并发智能体环境。

    A comparison of NVIDIA Vera (green) against x86 (gray). Left chart shows sandbox startup speed in sandboxes per second, with Vera more than 3x higher than x86. Right chart shows per-task relative performance across 20 agentic loop tasks, with Vera bars consistently above the x86 baseline of 1.0, reaching up to 2x on tasks such as cobol-modernization, fix-git, db-wal-recovery, and openssl-selfsigned-cert. Geometric mean advantage: 1.8x.

    的 x86 CPU 相比,Vera 上的沙箱启动速度提升 3 倍以上,智能体循环完成速度提升 1.8 倍,单机架可支持超过 11,000 个并发智能体环境。 NVIDIA BlueField-4 DPU 和 NVIDIA Sentry 增加了硬件隔离的监控与芯片内强制执行能力,一旦检测到策略违规,可在数毫秒内隔离智能体。 后续步骤 探索 OpenShell GitHub 仓库 ,开始实施安全的智能体治理。 查阅 安全智能体工作区参考设计文档 ,获取部署指导。 由 NVIDIA Nemotron 提供支持。AI 生成内容可能对信息的总结不完整。请核实重要信息。 了解更多 自主智能体 可以连续数小时处理复杂任务,访问文件、工具和互联网,并派生其他智能体协同工作。在长时间跨度内执行复杂任务会带来累积风险:智能体可能下载代码、构建新工具、申请额外权限,并触及更多底层基础设施。 智能体的行动路径是在其工作过程中、在推理完成目标所需步骤时确定的。当它们与周围的工具和系统交互时,会调整自身的推理和行为以完成任务。 智能体的适应性正是其强大之处,但它们以目标为导向,在追求目标的过程中可能不会优先考虑安

    匹配字段正文

  7. cnBeta

    DeepSeek 开源推理框架 DeepInfer 与分词组件 deepseek-recipe

    DeepSeek 发布技术博客《DeepSeek V4.1 Flash 大规模推理部署实践》,并以 Apache 2.0 协议开源支撑其线上百亿级调用的云服务推理框架 DeepInfer 和生产级分词组件 deepseek-recipe。博客称基于该框架单一集群服务吞吐已达每天 155 万亿 Tokens,未来新模型的推理代码和性能优化也会持续放进 DeepInfer。文中还提到用 8 卡机器做 Prefill、64 到 128 卡超节点做 Decode,以及用 3FS 分布式存储保留 KVCache、SWA Bounded Replay 只重算最后 128 个 token 等优化。

    化实在太拉胯,要么就是故意拿低效当幌子,以及筑起高昂的算力门槛把别人挡在门外。 而 DeepSeek 用不断开源的模型和一整套开源推理工程戳破了这个 AI 泡沫。正如有网友调侃道,有了 DeepSeek 开源的这套技术,OpenAI 和 Claude 估计又要偷偷摸摸进化了。 我的建议是,三人行,必有我师焉。干脆 Anthropic 也别矜持了,赶紧连夜去 GitHub 上把 DeepSeek 的 DeepInfer 给 git clone 下来部署上,万一偷师了一些缓存调度和优化思路,还能省下不少算力账单呢。(手动狗头) - 对文章打分 DeepSeek把自家“印钞机”开源了 这才是真的OpenAI Anthropic招股书透露大量信息:营收暴增却巨亏 算力成掣肘 1 小时前 Claude狂算64小时首次设计出抗蝎毒蛋白 已过实测 消息称Anthropic今年上半年净亏损超800亿美元 1 小时前 Anthropic提交AI安全法案草案 提议高风险模型可被法院叫停 Claude想让中国人全被封号:天才AI的访问头脑战 阅读 (1016) 评论 (1) 2 80、90后经历过的那个盗版

    匹配字段正文

  8. Latent Space精选

    DeepSeek 开源推理框架 DeepInfer,单集群日处理 155 万亿 token

    DeepSeek 开源了支撑 DeepSeek-V4.1-Flash 的自研推理框架 DeepInfer,并公布单集群每天处理 155 万亿 token、96% 输入缓存命中、首 token 延迟 400ms、生成速度 230 tokens/s 的生产数据。该框架基于 vLLM 定制,支持分布式推理、投机解码、SWA Bounded Replay 和结构化输出,目标平台为 NVIDIA SM100 与华为昇腾 950。DeepSeek 同时说明 KV cache 管理和负载均衡等组件尚未完全开源,vLLM 团队则称在 GB200 匹配配置下解码吞吐与 DeepInfer 公布结果相差 6% 以内。

    eek - DeepInfer - (Activity: 313): The image is a mobile screenshot of DeepSeek’s X announcement that DeepInfer, its in-house inference framework, is now fully open source: image, GitHub. The technically relevant claim from the linked/source discussion is that DeepInfer powers DeepSeek V4.1 Flash at scale, with reported single-cluster throughput of 155 trillion tokens/day and revenue of $38 per card per hour at off-peak pricing, emphasizing high-throughput, low-latency large-scale inference rath

    匹配字段正文

  9. Latent Space

    DeepSeek 开源推理框架 DeepInfer,单集群日处理 155 万亿 token

    DeepSeek 开源了支撑 V4.1 Flash 的生产推理框架 DeepInfer,并公布单集群日处理 155 万亿 token、输入缓存命中率 96%、首 token 平均 400ms、生成 230 tokens/s 等生产数据。该框架基于 vLLM 定制并采用 Apache 2.0 许可,支持分布式推理、投机解码、SWA Bounded Replay 和结构化输出,目标平台为 NVIDIA SM100 与华为昇腾 950。DeepSeek 称 KV 缓存管理和负载均衡等组件因与内部基础设施耦合尚未完全开源,vLLM 团队则报告在 GB200 匹配配置下解码吞吐与 DeepInfer 公布结果相差 6% 以内。

    eek - DeepInfer - (Activity: 313): The image is a mobile screenshot of DeepSeek’s X announcement that DeepInfer, its in-house inference framework, is now fully open source: image, GitHub. The technically relevant claim from the linked/source discussion is that DeepInfer powers DeepSeek V4.1 Flash at scale, with reported single-cluster throughput of 155 trillion tokens/day and revenue of $38 per card per hour at off-peak pricing, emphasizing high-throughput, low-latency large-scale inference rath

    匹配字段正文

  10. Hugging Face精选

    NVIDIA 发布 Cosmos3-H-Dreams 手术生成模拟模型

    NVIDIA 发布 Cosmos3-H-Dreams,基于 160 亿参数的 Cosmos3-H-Embodied-Nano 专门化,用于胆囊切除术的动作条件视频生成。模型使用 28 个动作维度、832 x 480 视频和 10 Hz 动作对齐训练,通过蒸馏得到四步与两步两个学生检查点,两步版本单独训练,推理更快但画质更低。官方同时提供 FlashDreams 流式运行时和适配自有数据与控制器的方法,并说明该模型是研究用模拟器,并非经过验证的临床系统。

    osmos3-H-Dreams 闭环耦合,使策略能够学习定义的胆囊切除术子任务。 这些是研究方向,而非已确立的临床能力。Cosmos3-H-Dreams 是研究用模拟器,并非经过验证的患者护理系统。它为在日益真实的环境中研究手术交互提供了基础。 探索 Cosmos3-H-Dreams 背后的模型、数据和运行时: Cosmos3-H-Dreams 代码和示例:GitHub 仓库 适配你自己的数据:教师微调和 Self-Forcing 蒸馏的分步配方 FlashDreams:GitHub 仓库 NVIDIA Cosmos 3:GitHub 仓库 带上你的控制器、你的轨迹和你的研究问题。我们期待看到社区在这些新的手术世界中构建出什么。 本文提及的模型 2 nvidia/Cosmos3-H-Dreams nvidia/Cosmos3-H-Embodied-Nano 本文提及的数据集 1 来自该作者的更多内容 扩展 Indic 预训练:2.8 万亿 Token 与开放数据生成流水线 本文提及的模型 2 nvidia/Cosmos3-H-Dreams nvidia/Cosmos3-H-Embodi

    匹配字段正文

  11. PyTorch Blog精选

    Google 与 Meta 联合推出 TorchTPU,让 PyTorch 原生运行在 TPU 上

    Google 与 Meta 的 PyTorch 团队合作推出开源项目 TorchTPU,为 Google TPU 提供原生 PyTorch 后端,迁移只需把 model.to("cuda") 改为 model.to("tpu")。项目支持 eager 与 torch.compile 两种模式,新增 DeferAndFuse eager 模式,覆盖约 450 个 Aten 算子,并已在 4,917 个 Hugging Face 模型上验证开箱运行,其中 Tier 1 通过率 98%、Tier 2 相对 GPU 数值一致性 97%。官方称其已用于部分 Google Cloud 大客户的推理与训练生产负载,并集成 vLLM、SGLang、TorchTitan、Ray 和 TorchRec。

    eager 执行引入 JIT 编译方案,并通过运行时优化弥合逐算子执行与编译执行之间的性能差距; 通过引入有界动态性、避免因形状变化导致 XLA 重新编译,以及探索可提前预编译的动态 TPU 内核,来改进 TPU 编程栈。 TorchTPU 正在积极开发中,它已被用于部分 Google Cloud 最大客户的推理和训练生产负载,并可作为开源项目在此处找到: GitHub 仓库. 在撰写本文时,我们已经: 新增对 eager 和编译两种模式的支持,包括新的 DeferAndFuse eager 模式; 新增对约 450 个 Aten 算子的支持(跳过具有结构性或复合委托的算子),包括主要深度学习架构所需的全部 Core ATen 算子的前向和反向传播; 新增通过 JAX/Pallas 和 Helion DSL 编写自定义内核的能力; 在下载量最高的 5,000 个 Hugging Face 模型上验证了开箱即用的执行,包括: LLM:Qwen、DeepSeek、Gemma、LLama、Mistral、GPT、OPT、BLOOM、Falcon、StableML 音频/语音:Whisper、

    匹配字段正文

星期二

  1. LMSYS Blog精选

    SGLang-TorchTPU 开源:把 SGLang 服务栈带到 TPU

    SGLang 团队联合 Google 和 Meta 开源 SGLang-TorchTPU,这是一个基于 PyTorch 的原生后端,把 SGLang 的完整服务栈带到 Google Cloud TPU,并已在 Meta 大规模生产环境使用。首发支持 Muse Spark Open、GLM-5.3、Kimi K3、DeepSeek V4、Qwen3.8、Gemma 4 等模型,覆盖投机解码、KV cache 卸载、PD 分离和 FP8 KV cache 等功能。团队还用 TorchTitan 与 Miles 在单台 4 芯片 TPU v7x 上完成 Qwen3-4B 的 GRPO 训练,奖励曲线与 6 张 H200 基线在随机波动范围内一致。

    SGLang-TorchTPU

    nd a request curl http://localhost:30000/v1/chat/completions \ -H "Content-Type: application/json" \ -d '{"model": "gpt-oss-20b", "messages": [{"role": "user", "content": "Hello"}]}' 要使用 pip 或从源码安装,请参阅 README。 TPU 指南 涵盖部署, recipes 提供可直接运行的服务器配置, SUPPORT.md 列出了受支持的模型和功能。 社区 RadixArk 正在为对 SGLang-TorchTPU 做出贡献的开发者提供免费 TPU 算力。 在此申请社区 TPU 算力池. 如有问题,请加入 SGLang Slack上的 torchtpu。要请求模型或提出功能建议, 请在 GitHub 上提交 issue. Google、Meta 和 RadixArk 将在 SGLang Summit 2026上分享更多内容,该活动于 11 月 12 日至 13 日在旧金山 Fort Mason 举行。

    匹配字段正文

  2. MarkTechPost

    DeepSeek 开源生产推理框架 DeepInfer,支撑 DeepSeek-V4.1-Flash

    DeepSeek 以 Apache 2.0 协议开源了其生产服务所用的推理框架 DeepInfer,该框架目前只支持 DeepSeek-V4.1-Flash,运行在 NVIDIA SM100 和华为昇腾 950 上。官方称单个集群每天可服务 155 万亿 token,在 131,072 上下文、64 卡解码配置下解码吞吐超过 25,000 tokens/s/GPU。此次发布仅覆盖离线推理,KV cache 系统、P/D 分离和负载均衡未包含在内,DeepSeek 表示这些组件与内部基础设施紧密耦合。

    em, P/D disaggregation and load balancing are not included. What is DeepInfer? DeepInfer is a high-performance inference engine from DeepSeek for its own models. According to it’s GitHub README, it powers DeepSeek’s large-scale production services. This release covers offline inference with the core features needed at scale. It was originally built primarily on vLLM, with ideas from SGLang and TensorRT-LLM. The deployment Q&A gives production context. A single cluster serves 155 trillion tokens

    匹配字段正文

  3. Google Developers Blog

    Google 在 TPU 上发布 vLLM 与 SGLang 原生 PyTorch 推理引擎

    Google 发布基于 TorchTPU 的 vLLM 与 SGLang 原生 PyTorch 后端,分别与 Inferact、RadixArk 合作开发,两个引擎已在预览客户的生产环境中运行。官方称在 Ironwood TPU(TPU 7x)上跑 Qwen 3.5 时,高并发配置下每百万 token 成本为 2.01 美分,并已在 SemiAnalysis InferenceX 的 AgentX 赛道提交结果。功能上支持前缀缓存与 KV cache 卸载、投机解码、分离式服务以及图像视频输入的多模态模型,SGLang-TorchTPU 已在 Meta 生产环境使用。

    inferenceblog

    formant and efficient. The major features for production-grade agentic workloads are already supported. More performance optimizations and advanced features are under way – open a Github issue to request collaboration on yours! Across the two engines, most of the popular open model families are supported, including Qwen, DeepSeek, GLM, Kimi, GPT-OSS, Gemma4 and more. The team is investing in making more models available to run natively on TPUs, including Day 0 support for new open models. We als

    匹配字段正文

  4. 36氪 · AI精选

    DeepSeek 开源推理框架 DeepInfer 与 Token 编解码组件 deepseek-recipe

    DeepSeek 开源自研推理框架 DeepInfer(Apache 2.0)和生产级 Token 编解码组件 deepseek-recipe(MIT),支撑 DeepSeek V4.1 Flash 单集群一天服务 155 万亿 Token。官方线上统计显示平均每请求输入 77K Token、首字延迟约 400 毫秒,生成阶段每秒输出 230 个 Token,平均 96% 的输入命中缓存。DeepInfer 目前支持 V4.1 Flash,开源版本仅提供离线推理,KV 缓存管理与负载均衡代码因与内部基础设施绑定暂未完整开源。

    ek再放大招,全面开源自研推理框架DeepInfer。 一个集群一天服务155万亿Token,DeepSeek V4.1 Flash高吞吐、低延迟的大规模推理,靠的就是它。 一起放出的,还有生产级Token编解码组件deepseek-recipe。 英伟达SM100 GPU、华为昇腾950 NPU,都在支持名单上。 DeepSeek还在知乎发了技术长文,又在GitHub放出一份部署问答,把这套系统从架构设计到部署细节,一五一十讲了出来。 按官方公布的线上统计,平均每个请求输入77K Token,首字平均只要400毫秒就能出来。生成阶段每秒输出230个Token,写代码时能冲到300个。 平均96%的输入,都能直接命中缓存,根本不用重算。 按谷价算,平均每张卡每小时的收入是38美元。 现如今,全世界都可以看到,DeepSeek究竟是如何让大模型高效接活儿的。 DeepSeek研究员Deli Chen更是放了一句狠话。 开源与闭源。光明与黑暗。两种未来、人类两种命运之间的决战。他们想打多久,我们就打多久。直到取得完全胜利。 评论区下,满屏都是开发者的狂欢。 正如网友所言,模型开源已是「基操

    匹配字段正文