←搜索结果

按匹配度 · 共 356 条结果 清除搜索

星期二

  1. UCSD Hao AI Lab精选

    Hao AI Lab 开源 Minecraft 智能体 Jev,1,795 轮后胜率 70%

    Hao AI Lab 开源了在 Minecraft 中作战的 LLM 智能体 Jev,经过 1,795 轮对局,它在 Block UHC 中战胜真人玩家的比例为 70%。该智能体不做训练,而是由带人工监督的 SOTA LLM 智能体根据自身日志进化提示词;据其说明,面对满技能脚本对手时 v1 全败,不到两小时后 v9 全胜。每次决策为 DJev 在 DiffusionGemma 上的一次前向传播,不生成 token,在 NVIDIA Blackwell 上耗时 24 ms,比某领先推理引擎快 2.5 倍,其开源引擎 DJev-serve 在 NVIDIA GB200 NVL72 和 B200 上以单个 CUDA graph 执行每次决策。

    匹配字段摘要、正文
星期五

  1. The Rundown AI

    Tavus 预览 Griffin 实时视频交互模型

    AI 初创公司 Tavus 预览了 Griffin,一个可在实时视频中观看、聆听、说话并作出反应的 Human Interaction Model。Tavus 称在面对面测试中,48% 的参与者认为对话对象是真人,此前模型这一比例仅为 2.4%;该模型在 NVIDIA 的 VideoFDB 视频聊天测试中与真人相差 0.09 分,并领先次优 AI 模型超过 1 分。目前仅 Griffin-Lite 向受信任测试者开放,用于继续完善安全与披露功能,后续再公开推出。

    匹配字段摘要、正文

  2. The Decoder

    Tavus 推出实时视频对话模型 Griffin,48% 测试者误认其为真人

    Tavus 推出名为 Griffin 的 Human Interaction Model,可在实时视频通话中同时接收和生成语音、面部表情、语气、手势与停顿。Tavus 研究显示,48% 的参与者在一次一分钟视频通话后认为 Griffin 是真人,此前系统最高为 2%。在 Tavus 称为 Nvidia 独立测试的拟人度评分中,Griffin 得 3.83 分,真人为 3.92 分,此前最佳 AI 模型为 2.80 分。名为 Griffin-Lite 的预览版已向部分测试者开放,能力更强的版本将在安全问题解决后推出。

    匹配字段摘要、正文

星期六

  1. MarkTechPost

    Prime Intellect 推出 Prime Inference,为前沿开源模型提供无服务器与预留推理服务

    Prime Intellect 发布 Prime Inference,为前沿开源模型提供无服务器端点和预留 GPU 容量,支持 OpenAI SDK 接入 https://api.pinference.ai/api/v1,并具备跨数据中心自动故障转移。该平台在公开发布前内部日均处理近一万亿 token,负载来自 RL rollout、合成数据生成、评测和长时间运行的编码智能体。其服务栈结合 NVIDIA Dynamo、vLLM、Mooncake 和 FlashInfer,采用预填充与解码分离部署,测试中 p90 词元间延迟降低近 40%,GLM-5.3 在 GB200 NVL72 上以 1:4 预填充解码比实现每组 66 个会话、每用户 101 tok/s。

    匹配字段摘要、正文

星期四

  1. Ai2 Blog

    Ai2 发布 Olmo-core 3:面向大规模 MoE 的开源可扩展训练基础设施

    Ai2 发布 Olmo-core 3,这是其大语言模型开发框架的一次重大升级,核心是重新设计的开源 MoE 训练系统,目标是把 MoE 训练扩展到万亿参数级别并保持计算效率。在八块 NVIDIA B300 GPU 的初步测试中,470 亿参数 MoE 达到每 GPU 每秒 52,000 tokens,约为此前 FSDP 实现 19,400 的 2.7 倍;该基础设施已在超过 1 万亿总参数规模上完成基准测试。Olmo-core 3 从 FSDP 转向基于 DDP 的系统,让专家常驻 GPU 并把数据路由过去,同时采用 rowwise expert parallelism、GPU-resident routing、grouped GEMM 和 MXFP8 低精度格式,其中 MXFP8 在四块 B300 上的端到端吞吐比 BF16 高约 21%,峰值活动显存从 103 GiB 降至 95 GiB。Ai2 表示下一代 Olmo 将采用 MoE 架构,Olmo-core 3 完全开源,研究者可用于训练自己的 MoE。

    匹配字段摘要、正文

  2. Hugging Face

    AI2 发布 Olmo-core 3:面向大规模 MoE 的开源可扩展训练基础设施

    AI2 发布 Olmo-core 3,一套面向大规模 MoE 模型的开源训练基础设施,从早期基于 FSDP 的实现改为基于 DDP 的系统,让专家常驻 GPU 并把数据路由到对应专家。在八块 NVIDIA B300 GPU 的初步测试中,470 亿参数 MoE 达到每 GPU 每秒 52,000 tokens,约为旧实现 19,400 的 2.7 倍;在四块 B300 上启用 MXFP8 后吞吐比 BF16 高约 21%,峰值活跃显存从 103 GiB 降至 95 GiB。该栈支持专家并行、流水线并行、分布式优化器、行级专家并行、GPU 常驻路由与分组 GEMM,并已在 512 块 GPU 上测试 1.2 万亿参数模型,最高观测吞吐 858 TFLOP/s/GPU。

    匹配字段摘要、正文

星期三

  1. Data Center Knowledge

    CoreWeave 推出 Forge 平台,从 GPU 基础设施转向全栈 AI 云

    CoreWeave 在旧金山 Fully Connected 活动上发布 CoreWeave Forge,一个用于开发、运行和持续改进 AI 模型与智能体的集成软件平台,即日起提供 Free、Pro、Enterprise 三个版本。Forge 把训练、推理、评估、可观测性和智能体开发整合为围绕 AI 循环的软件栈,并推出包含 VAST Data、CrowdStrike、ClickHouse 的合作伙伴网络。硬件方面,Nvidia Vera Rubin NVL72 已在其云平台上线,Cognition 成为首个客户并在两天内跑起负载;Nvidia Vera CPU 面向 AI 智能体处于早期开放阶段。

    匹配字段摘要、正文

星期二

  1. Inception Labs Blog

    Inception 发布 Mercury 2,面向搜索流水线每步延迟最快

    Inception Labs 发布 Mercury 2,称其在标准 NVIDIA GPU 上解码速度超过 1000 tokens/秒,在 WideSearch 基准的搜索流水线每一步都最快,查询规划比 Gemini 3.1 Flash Lite 快近 2 倍、比 Claude Haiku 4.5 快 4.7 倍、比 GPT-5 Mini 快 10 倍。定价为 $0.25/M 输入、$0.75/M 输出,作者称更深的流水线运行成本约为前沿速度优化模型的 2 倍便宜。在 FRAMES 上四款模型得分接近,DeepSearchQA 上 GPT-5 Mini 以 0.44 高于 Mercury 2 的 0.34,但 Mercury 2 完成 FRAMES 查询耗时 10.8 秒、单次正确回答成本最低。作者还发现 WideSearch 任务可被模型凭记忆作答,重建为训练截止后事件的任务后,Gemini 得 0.929、Mercury 2 得 0.923。API 已在 platform.inceptionlabs.ai 上线。

    匹配字段摘要、正文

  2. Artificial Analysis 完整文章

    Artificial Analysis 开源 AA-AgentPerf-Local,测试笔记本与工作站本地智能体推理性能

    Artificial Analysis 开源 AA-AgentPerf-Local,通过回放真实智能体会话在笔记本和工作站上测试本地模型推理性能,并发布配套榜单。默认负载为 8 个记录任务、168 个模型轮次,上下文增长至约 56K tokens,默认跳过工具执行以隔离推理速度。首批硬件包括 NVIDIA DGX Spark(128 GB)、AMD Ryzen AI Halo(128 GB)、MacBook Pro M5 Pro(64 GB)和 NVIDIA GeForce RTX 5090(32 GB),首批模型为 Qwen3.5-9B、Qwen3.8-27B、Qwen3.6-35B-A3B 和 Ling 3.0 Flash(124B / 5B active),均采用 4-bit 量化。

    匹配字段摘要、正文

星期一

  1. TechCrunch AI

    英伟达发布 Open Agent Safety Platform,用独立硬件层管控失控 AI 智能体

    英伟达 CEO 黄仁勋发布 Nvidia Open Agent Safety Platform,将开源软件 OpenShell 与运行在 BlueField-4 DPU 上的独立监控系统 Sentry 组合,为 AI 智能体加上软硬件两层安全边界。英伟达称 Sentry 独立于智能体所在的 CPU 或 GPU,可持续监控行为并在毫秒级隔离试图越界的智能体。Anthropic、Arm、Microsoft、Oracle、SpaceX 等数十家公司表示支持,OpenAI 未在名单中。

    匹配字段摘要、正文

星期五

  1. 量子位

    Skild AI 发布人形机器人 Messinator,靠自我对弈学会踢足球

    美国具身智能公司 Skild AI 展示人形机器人 Messinator,其大脑基于旗舰机器人基础模型 S1,并在 NVIDIA Isaac Sim 搭建的虚拟足球场中通过强化学习和 self-play 自我对弈训练,只设定进球这一个目标,盘带、护球、抢断和倒地起身等行为均为自行习得。团队称机器人在虚拟世界累计踢了 140 年,最终能把足球策略迁移到真实人形机器人上,完成带球、护球、抢断并在真人对抗中调整位置。Skild AI 成立于 2023 年,脱胎于卡内基梅隆大学机器人研究体系,此前推出过跨硬件机器人基础模型 Skild Brain,并公开过约 10 万种身体结构、约 1000 个仿真年的 omni-bodied 训练成果。

    匹配字段摘要、正文

星期二

  1. gihyo.jp

    White Circle 发布后训练框架 Halo,为 Hugging Face 模型加入分布式训练

    White Circle 于 9 月 21 日发布后训练框架 Halo,可在 Hugging Face 既有模型上加入多 GPU 分布式训练,无需重写模型实现,新模型系列适配代码约 100 行,权重仍以 SafeTensors 格式保存。在 8 基 NVIDIA B300 上对 gpt-oss-20b 的实测中,Halo 的吞吐最高达到 TRL 的 2.8 倍,峰值显存随配置变化,约 26GB 至 60GB。用 Halo 对 GLM-4.7-Flash 做监督微调后,GLM-4.7-Flash-Coder 在 SWE-rebench-V2 上的单次尝试解决率从 33.15% 提升到 41.65%。

    匹配字段摘要、正文

星期四

星期三

  1. The Rundown AI

    OpenAI 首款 AI 芯片 Jalapeño 公布基准测试

    OpenAI 公布与 Broadcom 合作开发的首款自研推理芯片 Jalapeño,其内部测试显示,这款 700 瓦芯片比 NVIDIA 旗舰系统最高快 3.6 倍,每瓦工作量最高多 1.9 倍。该芯片不会对外销售,计划于今年晚些时候进入 OpenAI 数据中心,并在 2027 年扩大生产。

    OpenAI 公布与 Broadcom 合作开发的首款自研推理芯片 Jalapeño,其内部测试显示,这款 700 瓦芯片比 NVIDIA 旗舰系统最高快 3.6 倍,每瓦工作量最高多 1.9 倍。该芯片不会对外销售,计划于今年晚些时候进入 OpenAI 数据中心,并在 2027 年扩大生产。 · OpenAI released internal benchmark results for Jalapeño, its first in-house inference chip developed with Broadcom, showing that the 700-watt chip ran up to 3.6x faster than NVIDIA’s flagship systems and delivered up to 1.9x more work per watt. The chip will not be sold externally and is planned to reach OpenAI’s data centers later this year, with

    匹配字段摘要、正文

星期二

  1. LMSYS Blog精选

    LMSYS 发布 Miles v0.1 生产级后训练系统

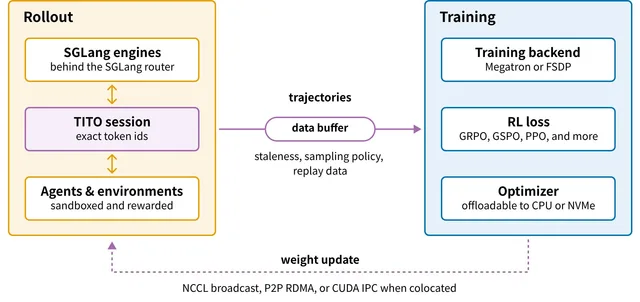
    LMSYS 发布 Miles v0.1,定位为面向前沿模型后训练的全栈生产级系统,是首个 Miles 版本的后续。它把 RL 训练循环拆成 SGLang 生成、训练器更新与权重同步三段,支持完全异步 RL、TITO 精确 token 记录、R3 路由重放,以及 NVFP4、MXFP8、FP8 等低精度训练配方。官方给出在 64 张 NVIDIA GB300 上训练 GLM-5.2 744B-A40B 终端任务的参考运行,稳定完成 100 步 rollout,单步训练约 4.5 分钟,前缀缓存命中率 96%。

    The Miles fully async RL loop

    匹配字段摘要、正文

星期三

  1. LMSYS Blog精选

    SGLang 与 Miles 为 Qwen3.8-2.4T-A95B 提供 Day-0 支持

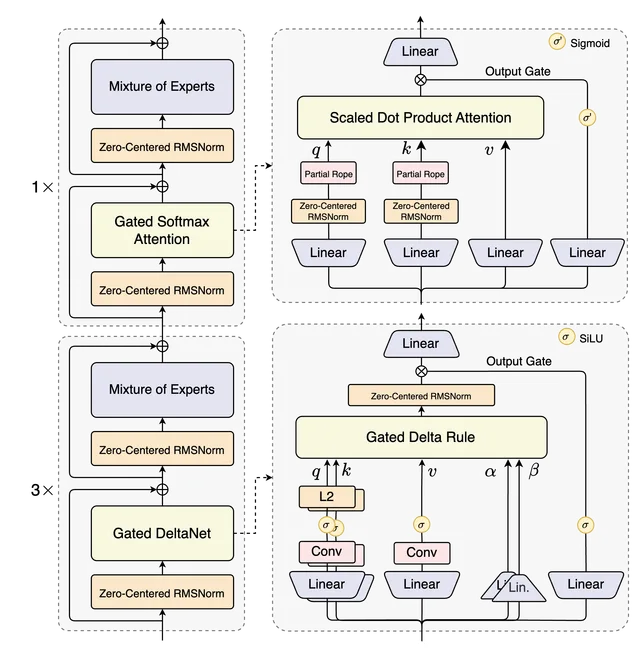
    SGLang 与 Miles 宣布在发布当天支持 Qwen3.8-2.4T-A95B,该模型总参数 2.4T、每 token 激活 95B,采用 69 层 GDN 线性注意力与 23 层 GQA 全注意力 3:1 交错的混合架构。团队与 Qwen、阿里百炼、NVIDIA、AMD 合作,Day-0 放出 NVFP4 量化检查点 RadixArk/Qwen3.8-2.4T-A95B-NVFP4,并在 B300 上以 TP8 实现 batch size 1 下 346 tok/s 的 MTP 解码。Miles 侧支持在原生 NVFP4 基座上进行 LoRA 协同训练,用 GRPO 在 GSM8K 上验证了奖励稳定与 train/rollout KL 平稳。

    Qwen3.8-2.4T-A95B model architecture

    匹配字段摘要、正文

星期二

  1. Unsloth精选

    Unsloth 发布桌面应用 Unsloth Desktop,支持本地运行与训练模型

    Unsloth 发布 Unsloth Desktop,称其为首个可在本地运行和训练模型的桌面应用,已上线官网和 GitHub。该应用开源,支持 Mac、Windows 和 Linux,覆盖 MLX、扩散图像/视频、音频、GGUF,可将 Claude Code 和 Codex 接入本地 LLM,并支持 CPU 与多 GPU 环境(NVIDIA、AMD、Intel、Mac)。官方称训练速度提升 2 倍、显存占用减少 70%,工具调用准确率提高 50% 并支持自愈与沙箱化代码执行,同时提供私有网页搜索、深度研究、RAG、MCP 以及 NVFP4、GGUF 导出。

    匹配字段摘要、正文

星期一

  1. LMSYS Blog精选

    SGLang 为 Meta 多模态模型 Muse Glimmer 提供 Day-0 支持

    LMSYS 宣布与 Meta Superintelligence Labs 合作,为 30B 参数多模态模型 Muse Glimmer 在 SGLang 上提供 Day-0 支持,并针对本地智能体工作流推理做了专门优化。在 NVIDIA GeForce RTX 5090 上,SGLang 以 NVFP4 加 DFlash 实现最高 1,452 tok/s 总输出吞吐和 236 tok/s 单用户解码速度,DFlash 将 batch-1 交互性提升 1.9 至 4.3 倍。模型可在 RTX 5090、RTX PRO 6000、DGX Spark 的 SM120 后端以及 Apple Silicon 的 MLX 后端部署,提供 BF16、NVFP4+MXFP8、NVFP4 及 GGUF 等多种 checkpoint 格式。

    匹配字段摘要、正文

星期五

  1. LMSYS Blog

    腾讯混元 HPC-Ops 的 Attention、Router GEMM 与 MoE 算子并入 SGLang 主分支

    腾讯混元开源算子库 HPC-Ops 的 Attention、Router GEMM 和 MoE 三个算子已并入 SGLang 主分支,面向 NVIDIA Hopper(SM90)GPU,并已用 Qwen3、Hy3 和 LongCat 工作负载验证。在 8× H20 上以 Hy3-FP8 同时启用 Attention 与 MoE,batch size 4–64 时 TPOT 降低 15.1–48.8%,batch size 4–16 时 TTFT 降低 3.3–6.0%;LongCat-Flash-Lite-FP8 启用 Router GEMM 后输入吞吐提升 5.5–6.1%。这些算子已在腾讯大规模生产服务中部署,其中 Dynamic Attention 与 Fused MoE 使 Hy3 模型的 TPOT 最多降低 48.8%。

    匹配字段摘要、正文

星期一

  1. LMSYS Blog精选

    SGLang 与 Miles 为 Kimi K3 提供 Day-0 支持

    SGLang 与 Miles 宣布在 Kimi K3 发布当天提供 Day-0 支持,前者负责推理、后者负责 RL 训练,与 Moonshot AI、NVIDIA 团队合作完成。K3 是首个 3 万亿参数级别的开源模型,实际为 2.8T 参数、1M token 上下文窗口并具备原生视觉理解,其 69 层 KDA 线性注意力与 24 层 MLA 交织的混合架构打破了常规服务栈的多项假设。文中给出统一显存池、DSpark 投机解码与 ReplaySSM、分阶段并行等方案,并报告在 16 节点 × 4 GB300 上做 DAPO 数学 RL 训练,AIME-2024 贪心评测在 12 小时内从 43.3% 升至 76.7%。

    The three KDA state moves, copy-on-write, snapshot and donate, and where each sits relative to the serial forward stream.

    匹配字段摘要、正文