antirez 发布面向 LLM 与编码智能体的 Redis 模式文档
antirez 发布了一份面向 LLM 和编码智能体的 Redis 文档,内容涵盖 Redis 命令与数据类型的详尽说明、常用模式、配置提示,以及可用 Redis 命令实现的算法。作者称发布此文是为了让搜索引擎收录,并提到有用户认为这份文档对真人也有用。
匹配字段标题
antirez 发布了一份面向 LLM 和编码智能体的 Redis 文档,内容涵盖 Redis 命令与数据类型的详尽说明、常用模式、配置提示,以及可用 Redis 命令实现的算法。作者称发布此文是为了让搜索引擎收录,并提到有用户认为这份文档对真人也有用。
匹配字段标题
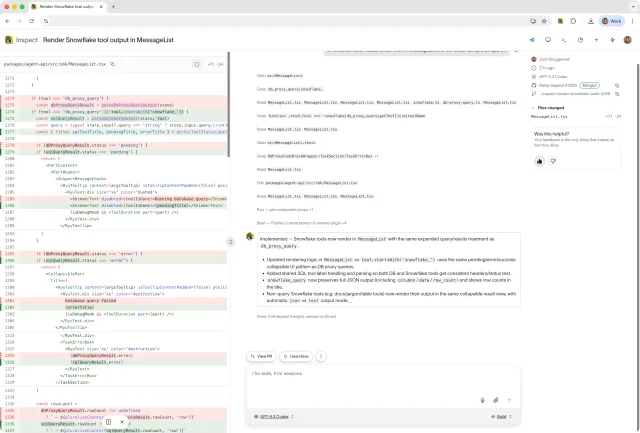
Ramp 基于 Modal Sandboxes 构建内部后台编码智能体 Inspect,目前 Ramp 前后端仓库约一半的已合并 PR 由它发起,Inspect 自身超过 80% 的代码也由它编写。每个会话运行在包含 Postgres、Redis、Temporal、RabbitMQ 等完整开发环境的沙箱中,OpenCode 作为编码智能体,配合 VS Code server、Web 终端和带 Chromium 的 VNC 做前端可视化验证。Modal 的 Cron 每 30 分钟克隆仓库并生成文件系统快照,会话从最新快照启动,几秒内即可开始处理提示词,并支持 Slack、Web、Chrome 扩展等多客户端与多人协作。
匹配字段标题
Anthropic 在 Terminal-Bench 2.0 上发现,仅基础设施配置差异就能带来 6 个百分点的分数差距(p < 0.01):从严格按任务规格限制资源到完全不设上限,基础设施错误率从 5.8% 降至 0.5%。在 3 倍资源以内,分数波动仍在噪声范围内(p=0.40),超过 3 倍后额外资源开始让智能体完成此前无法完成的任务,说明资源限制会改变评测实际测量的内容。SWE-bench 上的交叉实验也复现了同一方向但幅度更小的效应,5 倍 RAM 仅比 1 倍高 1.54 个百分点。Anthropic 建议评测同时公布资源保障值和硬性上限两个参数,并认为在配置未标准化前,榜单上低于 3 个百分点的差距值得存疑。
匹配字段标题
Ollama 发布新命令 ollama launch,可自动设置并运行 Claude Code、OpenCode、Codex、Droid 等编码工具,支持本地或云端模型,无需环境变量或配置文件。用户需下载 Ollama v0.15+,推荐将上下文长度设为至少 64000 tokens;本地模型包括 glm-4.7-flash、qwen3-coder、gpt-oss:20b,云端模型包括 glm-4.7:cloud、minimax-m2.1:cloud、gpt-oss:120b-cloud、qwen3-coder:480b-cloud。此次更新还提供更长的 5 小时编码会话窗口。
匹配字段标题
Block 推出的开源 AI 编码智能体 Goose 提供与 Claude Code 相近的功能,但可完全在本地运行,无需订阅费、无速率限制。Goose 在 GitHub 上已获得超过 26,100 颗星,有 362 名贡献者和 102 个版本,最新版本 1.20.1 于 1 月 19 日发布。它支持任意 LLM,可通过 Ollama 搭配 Qwen 2.5 等开源模型本地运行,并集成 MCP 连接外部服务;代价是模型质量、上下文窗口和速度仍不及 Claude 4.5 Opus 等商业方案。
匹配字段标题
LMSYS 在 SGLang 中推出 Encoder-Prefill-Decode(EPD)分离架构,将视觉编码从语言处理中拆出,编码器可独立横向扩容,并支持 ZMQ、Mooncake 等传输后端与视觉嵌入向量缓存。在 8× H20、Qwen2.5-VL-72B、每请求约 4 张 1080p 图像的测试中,图像密集场景下 1 QPS 时 TTFT 比同机部署低约 6–8 倍,0.8–1.0 QPS 吞吐约翻倍;图像较少的场景则可能因跨节点传输嵌入向量而变慢。
匹配字段标题
Johann Rehberger 在汉堡 39C3 演讲《Agentic ProbLLMs: Exploiting AI Computer-Use and Coding Agents》,分享针对智能体系统漏洞的安全研究及 Month of AI Bugs 项目,并附大量演示。演讲视频可在 media.ccc.de 观看,英文版已上传至 Embrace The Red YouTube 频道,幻灯片提供 PDF 下载。
匹配字段标题
Mario Zechner 发布自研极简编码智能体 pi-coding-agent,由统一 LLM API 层 pi-ai、智能体循环 pi-agent-core 和终端 UI 框架 pi-tui 组成。pi-ai 支持 Anthropic、OpenAI、Google、xAI、Groq、Cerebras、OpenRouter 及任意 OpenAI 兼容端点,并处理跨提供商上下文交接与 token 成本追踪。pi-coding-agent 默认 YOLO 模式,不含内置待办、计划模式、MCP 支持、后台 bash 和子智能体。
匹配字段标题
OpenHands 与 AMD 合作,演示如何在 AMD Ryzen AI Max+ 395 处理器上本地运行编码智能体:该处理器提供 16 个 Zen 5 CPU 核心、Radeon 8060S 集成 GPU 和 XDNA 2 NPU,合计最高 126 AI TOPS。借助 AMD 的 Lemonade Server 软件栈(兼容 OpenAI API),可本地运行 Qwen3-Coder-30B-A3B-Instruct 模型(约 18.6GB),并通过 uvx tool install openhands 安装 OpenHands CLI 接入。该方案主打隐私、无按 token 计费、合规与离线可用。
匹配字段标题
Transluce 与 SWE-bench 团队合作,将智能体轨迹公开在 Docent 上,用户现可通过 SWE-bench 排行榜上的链接查看完整记录。双方先从 SWE-bench Verified 的 "bash only" 设置入手,该子集包含 500 个经人工审核的 PR,上月从 HuggingFace 下载超 130 万次。Docent 还构建了检测"作弊"行为的评判器,可识别智能体通过 git 读取未来提交或 gold patch 等非预期解题路径。

匹配字段标题
Cognition 发布面向软件工程的 SWE-1.5 模型,参数量达数千亿,在 SWE-Bench Pro 上接近前沿水平,并已上线 Windsurf。该模型与 Cerebras 合作部署,推理速度最高 950 tok/s,比 Haiku 4.5 快 6 倍、比 Sonnet 4.5 快 13 倍。Cognition 称其基于数千块 GB200 NVL72 芯片训练,并在自建 Cascade agent harness 与高质量编码环境中做端到端强化学习。
匹配字段标题
MiniMax M2 已在 Ollama 云端上线,定位编码与智能体工作流。该模型总参数 230B、激活参数 10B,据 Artificial Analysis 基准其综合得分在开源模型中排名第一,在 Terminal-Bench 与 (Multi-)SWE-Bench 类任务上表现较强。Ollama 同时给出在 VS Code、Zed、Droid 中调用 minimax-m2:cloud 的配置步骤,并支持通过 ollama.com 云 API 直接访问。
匹配字段标题
MiniMax 正式开源并发布 MiniMax M2,定位为面向 Agent 与编码的模型,API 定价为每百万输入 token $0.30、每百万输出 token $1.20,约为 Claude 4.5 Sonnet 的 8%,在线推理 TPS 约 100。模型权重已在 Hugging Face 开源,支持 SGLang 与 vLLM 部署,推荐推理参数为 temperature=1.0、top_p=0.95、top_k=20,免费试用延长至 11 月 7 日 00:00 UTC。同时上线由 M2 驱动的 MiniMax Agent,提供 Lightning 与 Pro 两种模式,目前限时免费。

匹配字段标题
安全研究者 Johann Rehberger 发布 AgentHopper 概念验证,用一个通用提示注入载荷在多个编码智能体间自我传播。载荷先感染开发者智能体,再扫描 Git 仓库注入指令并推送回 GitHub,其他开发者拉取被感染代码后触发注入,形成循环传播。攻击路径涉及 GitHub Copilot、Amp Code、Amazon Q Developer 和 AWS Kiro,相关漏洞均已由厂商修复。作者建议为 SSH 和签名密钥设置口令、启用分支保护并遵循最小权限原则。
匹配字段标题
Mario Zechner 构建了 terminalcp 的 MCP server 与对应 CLI,用三个终端控制任务对比 terminalcp MCP、terminalcp CLI、tmux 和 screen 四种工具,评估成本、耗时、成功率,以及模型对标准 CLI 工具的固有知识是否胜过对未见工具的上下文学习。作者认为多数 MCP 只是 CLI 调用的薄封装,如 GitHub MCP Server 往往不如让智能体直接调用 GitHub CLI。
匹配字段标题
Anthropic 发布 Claude Opus 4.1,在智能体任务、真实编码和推理上较 Opus 4 升级,SWE-bench Verified 达 74.5%。现已向付费用户、Claude Code、API、Amazon Bedrock 和 Google Cloud Vertex AI 开放,价格与 Opus 4 相同。GitHub、Rakuten 和 Windsurf 反馈其在多文件重构、精准修复和初级开发者基准上均有显著提升。
匹配字段标题
Mistral AI 与 All Hands AI 推出 Devstral Small 1.1 和 Devstral Medium,二者在 SWE-Bench Verified 上分别获得 53.6% 和 61.6%。Small 1.1 采用 Apache 2.0 许可证;Medium 通过 API 提供,并支持私有部署和定制微调。API 输入/输出价格分别为 $0.1/$0.3 和 $0.4/$2 每百万 Token。

匹配字段标题
Cognition 发布《Coding Agents 101》指南,基于 Devin 及客户经验总结高效使用编码智能体的方法。指南建议明确指定实现方式而非仅描述目标、告知智能体任务起点、提供 CI、测试、类型检查和 linter 等反馈回路,并指出高级到资深级别工程师上手这类工具最快。
匹配字段标题
The Gradient 文章讨论文本嵌入能否被逆向还原为原文,并引用 EMNLP 2023 论文《Text Embeddings Reveal As Much as Text》。作者用 32 token 输入、768 维嵌入做实验,训练 Transformer 从嵌入还原文本,BLEU 约 30/100,精确匹配接近零。
匹配字段标题
FutureHouse 发布 WikiCrow,一个基于其 PaperQA 智能体平台的自动合成系统,可为技术主题生成带引用的维基百科式摘要。团队用它为 15616 个尚无条目或仅有残篇的人类蛋白编码基因生成草稿,每篇约 8 分钟,50 个实例并行,几天内完成,估计人工需约 60000 小时。评测显示 WikiCrow 约 9% 的陈述不正确,但引用来源的一致性明显优于人类编辑;PaperQA 在 PubMedQA Blind、MedQA-USMLE 及自建 LitQA 基准上优于 GPT-4、Perplexity 等系统。
匹配字段标题