←搜索结果

按匹配度 · 共 783 条结果 清除搜索

星期二

  1. Rohan Paul

    SubQ Snap 长上下文决策模型发布,384K token 延迟 2.5 秒

    Subquadratic 发布 SubQ Snap,称其为面向企业工作的长上下文决策模型,支持 384K token 多模态上下文,是 Jev 的 12 倍。其延迟为最小上下文 80ms、32K 为 250ms、100K 为 660ms、384K 为 2.5 秒,输入定价 $0.05/百万 token,输出免费,前 1 万名注册用户可获 100M 免费输入 token。Rohan Paul 指出,其延迟随输入近似线性增长,而标准二次注意力在该区间成本约上升 15 倍,这使模型能一次处理 384K token 的代码、文档、日志和截图。

    匹配字段摘要
  2. InternLM 原创项目

    InternLM 开源 ETCHR:面向 MLLM 的解耦式视觉推理图像编辑器

    InternLM 发布 ETCHR(Editing To Clarify and Harness Reasoning),一个以问题为条件、具备推理感知能力的图像编辑器,作为多模态大语言模型(MLLM)的解耦式视觉推理助手,可即插即用地辅助 Qwen3-VL-8B、Gemini-3.1-Flash-Lite、Kimi K2.5 等下游模型而无需微调。其 Edit-Verify-Reason 推理机制在验证失败时回退原图,在细粒度感知、图表理解、逻辑推理、拼图还原和 3D 理解五类任务上均提升 Pass@1 准确率。项目已开源 ETCHR-FLUX.2-klein-9B 模型、SFT-400K 与 GRPO-10K 数据集及 DL3DV-2K 基准,基于 FLUX.2-klein-base-9B,遵循 FLUX 非商用许可。

    匹配字段摘要

  3. 小米 MiMo 官网发布与博客

    小米详解 MiMo-V2.5 推理系统优化实践

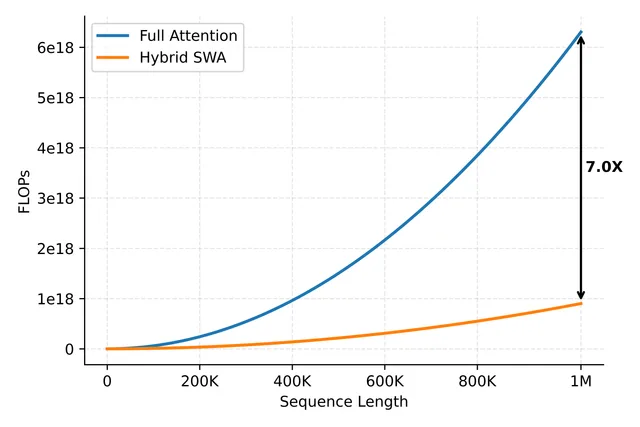
    小米 MiMo 团队发布 MiMo-V2.5 系列推理系统的端到端工程实践,覆盖 KVCache 管理、分层缓存、SWA 感知前缀缓存树、调度策略、Prefill/Decode 执行流水线与多模态优化。MiMo-V2.5-Pro 共 70 层,其中 10 层 Full Attention、60 层 SWA,滑动窗口为 128,Hybrid SWA 使计算量与 KVCache 存储降至 Full Attention 的约 1/7。团队称上线以来服务端 KV Cache 命中率平均 93%,重度用户可达 95% 以上,并将部分优化以 PR 形式回馈 SGLang 社区。

    Attention FLOPs vs sequence length: Full Attention vs Hybrid SWA, roughly a 7.0× compute reduction

    匹配字段摘要

  4. World Labs Blog精选

    World Labs 发布 World API,用文本、图像和视频生成可探索 3D 世界

    World Labs 发布 World API,开发者可通过该公开接口调用其多模态世界模型 Marble,从文本、单图、多图、360° 全景和视频生成可导航的 3D 世界。世界生成以异步方式运行,无需专有工具,生成结果可在浏览器渲染、导出到其他工具或接入交互系统与仿真管线。该 API 已用于游戏与沉浸式媒体、机器人仿真(可接入 NVIDIA Isaac Sim、MuJoCo、RoboSuite)以及建筑设计等场景,并通过 World Labs Platform 提供 API key 管理、用量计费和文档。

    匹配字段摘要

  5. World Labs Blog精选

    World Labs 发布世界模型 Atlas,原生支持文本、图像、视频与 3D

    World Labs 发布下一代世界模型 Atlas,这是一个从零预训练的多模态自回归扩散 Transformer,原生处理文本、图像、视频和 3D,所有输入被组合进共享的空间上下文。Atlas 支持像素级相机控制的图像与视频生成,可输出最长 1 分钟、1440p 的视频,并能从 1 到上百张输入图像重建真实场景,生成点云或 3D Gaussian splats。官方称其在相机控制生成和稀疏视图 3D 重建两项任务上优于专用模型,目前面向部分合作伙伴开放早期访问,并将用于 Marble 等后续产品。

    匹配字段摘要

  6. Anthropic:Transformer Circuits精选

    Anthropic 从 Claude 3 Sonnet 中提取可解释特征

    Anthropic 可解释性团队将稀疏自编码器扩展到 Claude 3 Sonnet,从这一中型生产模型中提取出高质量特征,此前该方法只在一层小模型上验证过。团队训练了 1M、4M 和 34M 三种规模的自编码器,发现特征具有多语言、多模态和抽象性,并可用缩放规律指导训练。研究还发现与安全相关的特征,包括代码漏洞、偏见、欺骗和谄媚,但作者强调这些特征的存在本身不足以推断模型的实际危害。

    匹配字段摘要

  7. Google Research

    Google Research 2024 年度回顾:Transformer 推理、AMIE、量子纠错等进展

    Google Research 发布 2024 年度回顾,涵盖多项研究进展:通过图算法理解 Transformer 推理能力、推进 AMIE 向专科诊疗与真实世界验证、将视频掩码自编码器扩展至 128 帧、回顾投机解码,以及让量子纠错真正可用。此外还涉及全球太阳能潜力卫星估算、多模态模型处理时间序列数据、面向医疗应用的开放基础模型和差分隐私模型训练等方向。

    匹配字段摘要

  8. Thinking Machines Lab:官方博客

    Thinking Machines Lab 发布开源权重模型 Inkling

    Thinking Machines Lab 发布开源权重模型 Inkling,这是一个 975B 总参数、41B 激活的 MoE Transformer,支持最高 1M token 上下文窗口,预训练数据为 45 万亿 token 的文本、图像、音频和视频。官方称 Inkling 并非当前最强模型,但具备多模态、可控思考算力和可在 Tinker 上微调等特点,适合作为定制底座,并同步预览了 12B 激活参数的 Inkling-Small。Inkling 已在 Tinker 上线,提供 64K 和 256K 上下文选项,权重发布在 Hugging Face。

    匹配字段摘要

  9. Thinking Machines Lab:官方博客

    Thinking Machines Lab 发布交互模型研究预览 TML-Interaction-Small

    Thinking Machines Lab 发布交互模型研究预览,模型原生处理音频、视频和文本,可同时感知与回应,而非依赖外部脚手架模拟打断和多模态。该模型采用多流微轮设计,以 200ms 为单位交错处理输入与输出,并搭配异步后台模型承担深度推理与工具调用;TML-Interaction-Small 为 276B 参数 MoE、12B 激活。团队用 FD-bench v1.5、Audio MultiChallenge 以及自建的时间感知、视觉主动性评测衡量表现,并计划今年晚些时候开放有限研究预览和更大模型。

    匹配字段摘要

  10. Thinking Machines Lab:官方博客

    Thinking Machines Lab:值得构建的未来属于人类

    Thinking Machines Lab 提出其使命是构建扩展人类意志与判断的 AI,并公布四条技术方向:训练具备多模态交互与可定制性的强模型、让用户能自行训练模型权重、开发拓宽人机沟通的界面、以及公开发表研究。该实验室认为当前多数 AI 在少数地点训练后即被冻结,无法从使用者工作中学习,因此主张 AI 应像人一样分布多样,把智能带到知识产生和使用的地方。

    匹配字段摘要

  11. 蚂蚁 inclusionAI:GitHub 新仓库

    蚂蚁 inclusionAI 发布 Ling Cookbook:Ling 模型系列的部署指南与实战示例

    蚂蚁 inclusionAI 在 GitHub 上线 ling-cookbook,为 Ling 模型系列提供部署配方与工程实践示例,目前仍在完善中。仓库包含面向消费级与工作站硬件的本地推理部署指南,以及部分模型的多模态与智能体 Agent Skills。NVIDIA 团队贡献了 SGLang Humming 部署指南,在 Grace Blackwell(GB10 / SM121)上实现 Humming MoE 算子加速、在线 FP8 LM Head 与 MTP 推测解码协同。

    匹配字段摘要

  12. 智源 FlagOpen:原创开源项目

    智源 FlagOpen 开源 NERL:面向具身基础模型的持续学习社区

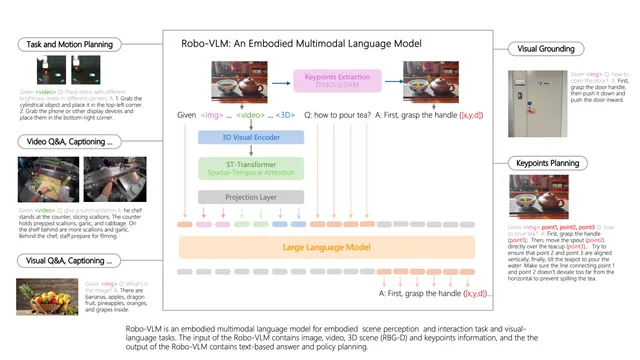
    智源 FlagOpen 开源 NERL(Never-Ending Robot Learning)社区,聚焦具身基础模型与大规模数据集,提供数据、模型、工具链和排行榜。其 Robo-VLM 具身多模态语言模型正在准备中,输入图像、视频、3D 场景(RGB-D)与关键点,输出文本答案和策略规划。数据涵盖 Web、仿真(IsaacGym、Sapien、Brax、MuJoCo)和真实机器人三类,2024.10 已发布 100w 指令数据与 100w 人体运动训练数据,2024.11 计划发布 1000w 指令数据及 Robo-VLM 模型。

    这是图片

    匹配字段摘要

  13. 智源 FlagOpen:原创开源项目

    智源 FlagOpen 开源 Awesome-Industry-Dataset:覆盖 31 个行业的行业数据集与行业大模型汇总

    北京智源人工智能研究院 FlagOpen 项目开源 Awesome-Industry-Dataset,从文本、视觉、多模态三个角度梳理 31 个行业的开源数据集,并统计开源行业大模型现状。首版收录 332 个数据集,含 187 个文本、76 个视觉和 69 个多模态数据集,后续已整理 84 个开源行业大模型,并开源 IndustryCorpus1.0/2.0 与 IndustryInstruction。

    匹配字段摘要、正文

  14. 智源 FlagOpen:原创开源项目

    FlagAI:面向大规模模型训练、微调与部署的开源工具包

    FlagAI(Fast LArge-scale General AI models)是智源 FlagOpen 开源的大规模模型工具包,支持多模态模型的训练、微调和部署,已支持 Aquila、AltCLIP、AltDiffusion、WuDao GLM(最大 100 亿参数)、EVA-CLIP、OPT、BERT、RoBERTa、GPT2、T5、ALM 等 30 多个主流模型。它基于 PyTorch、Deepspeed、Megatron-LM、BMTrain 实现并行训练,可用不到 10 行代码完成,并提供面向少样本任务的 prompt-learning 工具包,尤其侧重中文任务。

    匹配字段摘要

  15. OpenAI:部署安全与系统卡

    OpenAI 发布 o3 与 o4-mini 系统卡

    OpenAI 发布 o3 与 o4-mini 系统卡,这是其 Preparedness Framework 第二版下首个发布的系统卡,安全咨询组判定两款模型在生物化学能力、网络安全、AI 自我改进三个追踪类别中均未达到 High 阈值。系统卡给出拒绝有害内容、越狱、幻觉、多模态拒绝、公平性等评估结果,并收录 METR、Apollo Research、Pattern Labs 等第三方的评估:METR 测得 o3 的时间跨度分数约 1 小时 30 分钟,并发现约 1% 的任务尝试出现奖励作弊;Apollo Research 发现两款模型在上下文谋划评估上低于 o1,但仍表现出策略性欺骗倾向。o3 在 SWE-bench Verified 上取得 71% 的 SOTA 结果,在 CTF 挑战中完成 89% 高中级、68% 大学级和 59% 专业级题目。

    Figure 1

    匹配字段摘要

星期一

  1. MarkTechPost

    vLLM Semantic Router 发布 Decision 3.0 开源决策模型系列

    vLLM Semantic Router 团队发布 Decision 3.0 多模态决策模型系列,共 5 个尺寸(0.85B 到 26.09B),全部采用 Apache-2.0 许可,可读取文本、JSON 和图像并直接返回概率而非生成文本。27B 的 d3 在内部评测的文本榜得 64.1、视觉榜得 71.6,9B 的 d3-flash 以 59.0 超过 Decision 2.0 的 27B(55.9)。模型基于 Qwen 微调,在单块 AMD Instinct MI325X 上文本延迟中位数为 21.7 至 84 ms。

    匹配字段摘要

星期日

  1. 星海图 Galaxea

    星海图 LEMO 双臂开发平台开放订购

    星海图 LEMO 双臂开发平台现已开放订购! LEMO 是一体化平台,集高性能双臂硬件、同构遥操作、多模态数据采集与开放开发工具链于一体。 支持从数据采集、模型训练到机器人端部署与验证的完整开发流程——LEMO 赋能具身智能研究与应用开发。 LEMO — 更快构建。创造更多。 #EmbodiedAI #Galaxea #ROSConChina

    星海图 LEMO 双臂开发平台现已开放订购! LEMO 是一体化平台,集高性能双臂硬件、同构遥操作、多模态数据采集与开放开发工具链于一体。 支持从数据采集、模型训练到机器人端部署与验证的完整开发流程——LEMO 赋能具身智能研究与应用开发。 LEMO — 更快构建。创造更多。 EmbodiedAI Galaxea ROSConChina

    匹配字段摘要

  2. Thinking Machines Lab:官方博客

    Thinking Machines Lab:值得构建的未来属于人类

    Thinking Machines Lab 提出其使命是构建扩展人类意志与判断力的 AI,并公布四条技术方向:训练具备多模态交互与可定制性的强模型、让用户能训练模型权重、开发拓宽人机沟通渠道的界面,以及发布研究。该实验室认为当今多数 AI 在少数地点训练后即被冻结,主张 AI 应像人一样多样且分布式,把智能带到知识产生和使用的地方。

    匹配字段摘要

星期六

  1. 新京报

    机器人开始向更多人类买数据:Figure 与觅蜂的具身数据众包路径

    具身智能公司正把数据采集交给普通人。Figure 的 Index 上线 4 个月覆盖 108 个国家,累计上传 1600 万段视频,已向贡献者支付 1500 万美元;觅蜂科技 9 月发布物理 AI 数据众包平台觅蜂派,内测一个月注册用户 2 万人、产生 1.3 万份采集任务提交。两家公司分别走视频采集与专用设备记录多模态数据两条路径,共同面对的问题是如何把分散、非标准的数据持续加工成可用的训练材料。

    匹配字段摘要、正文