←搜索结果

按匹配度 · 共 680 条结果 清除搜索

星期五

  1. 蚂蚁百灵:Developer Blog

    蚂蚁百灵发布原生混合推理模型 Ling-3.0-flash

    蚂蚁百灵发布新一代原生混合推理模型 Ling-3.0-flash,总参数量 124B、激活参数 5.1B,官方称在多项指标上对标甚至超越上一代 1T 级旗舰 Ring-2.6-1T。模型从预训练起采用 5:1 交替堆叠 KDA 与 MLA 的混合线性注意力架构,专家激活比例由 1/32 降至 1/64,原生支持 256K 上下文并可扩展至 1M。官方同时开放 OpenRouter 与百灵官方平台限时免费 API 调用,免费期截至 8 月 3 日 23:00,权重将在免费期结束后开源。
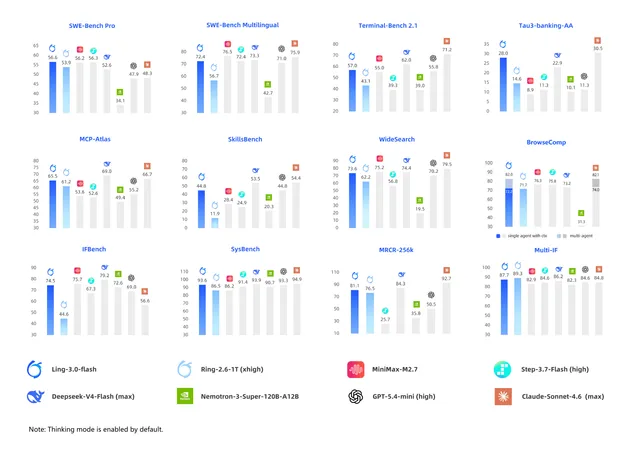
    Ling-3.0 核心能力对比

    匹配字段标题

星期四

  1. Hugging Face精选

    将 Nunchaku 4-bit 扩散推理引入 Diffusers

    Hugging Face 在 Diffusers 中原生支持 Nunchaku Lite,可直接加载采用 SVDQuant 的 4-bit 扩散模型,无需自定义管线、独立推理引擎或本地编译。在 RTX 5090 上,示例模型生成 1024x1024 图像约需 1.7 秒,峰值显存约 12 GB,而 BF16 管线约为 24 GB。NVFP4 检查点要求 NVIDIA Blackwell GPU,早期架构可使用 INT4,但 Volta 和 Hopper 目前不受支持。

    匹配字段标题

  2. Together AI Blog

    Together AI 更新开源权重模型推理平台并开启自定义训练内测

    Together AI 发布 Dedicated Model Inference 推理平台更新,支持在同一稳定端点后运行多个部署,并提供 canary、蓝绿和滚动更新及按阈值自动回滚、A/B 与影子流量测试、按 inflight 请求或 GPU 利用率等指标自动扩缩容。平台重建了模型缓存与分发层,内部测试中多个前沿模型的冷启动速度约提升 4 倍,同时提供组织级 Prometheus 端点接入自有可观测工具。Together AI 还开启自定义训练内测,涵盖全权重与 LoRA 强化学习及监督微调,checkpoint 可直接部署到推理服务,内测名额有限。

    匹配字段标题

星期三

  1. Sakana AI:Blog

    Sakana AI 提出 UnMaskFork:让多个掩码扩散语言模型协作提升推理性能

    Sakana AI 在 ICML 2026 论文 UnMaskFork(UMF)中提出,让多个掩码扩散语言模型(MDLM)通过模型切换协作完成同一个答案,并用蒙特卡洛树搜索寻找不同模型负责不同阶段的顺序。该方法无需额外训练或改动模型,在编码基准上持续优于现有推理时扩展方法,在数学任务上也随计算量增加稳步提升。

    匹配字段标题

星期六

  1. Ahead of AI

    如何控制大语言模型的推理力度

    文章解释了大语言模型如何通过不同推理力度,在回答质量、token 消耗、成本和延迟之间进行权衡。其实现通常结合混合 SFT 数据、按模式调整的 RL 奖励、长度惩罚、独立专家模型或硬性 token 预算;DeepSeek V4、Nemotron 3 Ultra、Kimi K3、GLM-5、Qwen3 和 Inkling 采用了不同组合。模型规模与推理力度是两套独立控制方式,较小模型提高推理力度有时可达到与较大模型降低推理力度相近的基准成绩。

    匹配字段标题

星期五

  1. Andrew Ng

    Andrew Ng 与 Cerebras 推出快速推理 LLM 应用课程

    Andrew Ng 与 Cerebras 合作推出新课程,教开发者用为快速推理设计的硬件构建 LLM 应用。课程使用 Cerebras 的 Wafer-Scale Engine,通过让模型权重靠近计算单元,使 token 生成速度比典型 GPU 设置快数倍。学员将对比 GPU、TPU 与 Wafer-Scale Engine 处理内存到计算瓶颈的方式,并构建网页个性化和市场信号分析等实时应用。

    匹配字段标题

星期四

  1. Together AI Blog

    Together AI 解读:推理服务的 99.9% 可用性意味着什么

    Together AI 发文拆解推理服务 99.9% 可用性背后的架构含义,指出 GPU 推理的故障模式与常规服务不同,需按节点、单数据中心、多设施、多区域逐层应对。Together AI 为 Cursor、Decagon、Cartesia、Yutori 等团队提供推理服务,并称其可用性在推理完成时而非网关处计量,可用性与性能是两份不同的合约。

    匹配字段标题

星期三

星期三

  1. Together AI Blog精选

    Together AI 推出 Provisioned Throughput 预留推理容量

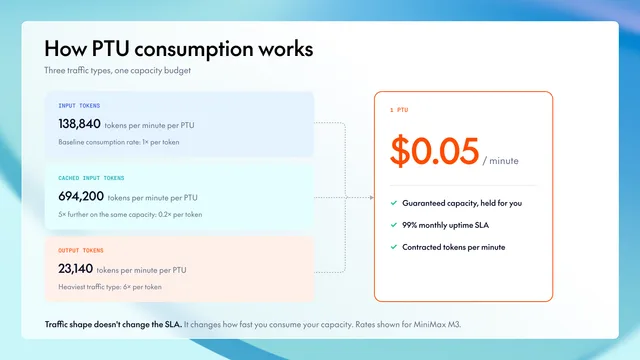
    Together AI 推出 Provisioned Throughput,为前沿开放模型提供预留推理容量,采用按 token 计费并附带 99% 可用性 SLA,成本最高比 Claude Opus 4.8 标价低 90%。该产品今日起支持 MiniMax M3 和 GLM-5.2,容量覆盖北美、EMEA 等地区,最短承诺期一个月。用户按 Provisioned Throughput Units(PTU)购买,每个 PTU 每分钟 0.05 美元,在 MiniMax M3 上单个 PTU 每分钟可提供 138,840 输入 token、694,200 缓存输入 token 或 23,140 输出 token。

    匹配字段标题

星期五

  1. DeepLearning.AI · Andrew Ng 来信精选

    DeepLearning.AI 周报:GPT-5.6 家族受限发布、Sakana 模型编排与微软自研推理模型

    DeepLearning.AI 周报汇总多项进展:OpenAI 发布 GPT-5.6 Sol、Terra、Luna 三款闭源视觉语言模型,目前仅向约 20 家美国政府批准的机构开放,价格从每百万 token 输入 5 美元到 1 美元不等,OpenAI 称未来几周扩大开放。Sakana AI 发布 Fugu 与 Fugu-Ultra 两款编排其他模型和智能体的模型,称在 Terminal-Bench 2.1、GPQA-Diamond 等基准上超过 Claude Fable 5、Claude Mythos Preview 和 GPT-5.5。微软推出首个未蒸馏或微调自其他厂商的推理模型 MAI-Thinking-1,采用 MoE 架构,总参数 1 万亿、每 token 激活 350 亿,称在 AIME 2025 上以 97.0% 超过 Claude Sonnet 4.6。周报还介绍了斯坦福与伯克利团队的 RoboReward 机器人奖励模型。

    匹配字段标题

星期三

  1. Berkeley AI Research (BAIR) Blog

    2026 BAIR 博士毕业生展示:从机器人到 LLM 推理的 AI 研究全景

    BAIR 公布 2026 届博士毕业生名单,其研究覆盖机器人、具身智能、大语言模型与推理、计算机视觉、生成模型、AI 安全、人机交互及 AI for Science 等方向。毕业生去向包括 OpenAI、Mistral AI、Physical Intelligence、Amazon 研究岗、普林斯顿 CITP 博士后以及自主创业。

    Baifeng Shi

    匹配字段标题

星期二

  1. Air Street Press

    ElevenLabs 工程师解析如何缓解 AI 推理算力短缺

    ElevenLabs 研究工程师 Angelos Perivolaropoulos 介绍了如何通过标准工程优化,将语音推理的单 GPU 服务能力从 1 名用户提升至 70 名,架构级改造则可达到约 140 名。连续批处理、FP8 量化、多 token 预测和经蒸馏适配的 FP8 KV cache 是主要手段,其中 KV cache 缩小 2.5x 后,吞吐量从 28 名用户增至 70 名。各项技术会引入延迟、内存上限或质量损失,实际选择取决于具体工作负载。

    匹配字段标题

星期六

星期四

  1. Google Research

    Google Research:推理如何解锁 LLM 参数化知识回忆

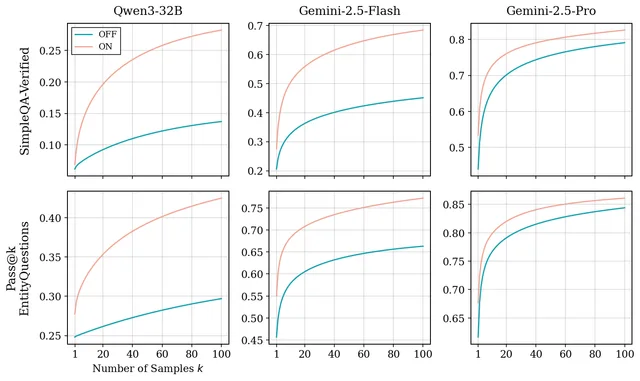
    Google Research 在 COLM 2026 论文中揭示,推理能帮助 LLM 回忆简单事实,机制包括用生成的推理 token 进行隐式计算,以及生成相关事实来激活正确答案。研究在 Gemini-2.5 Flash/Pro 和 Qwen3-32B 上,用 SimpleQA Verified 与 EntityQuestions 数据集对比推理开关模式,发现开启推理后模型能回忆起关闭时几乎无法获取的答案。

    Thinking to recall: How reasoning unlocks parametric knowledge in LLMs

    匹配字段标题

星期三

  1. Modal 官方工程博客

    Modal 如何用推测解码实现 SOTA 推理延迟

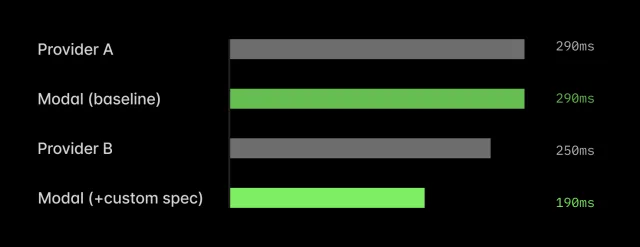
    Modal 本周推出 Auto Endpoints,结合 Blackwell GPU、SGLang 和 Modal Servers,通过推测解码优化延迟。在 Decagon Voice 案例中,基线 p50 延迟约 290ms,优化后削减 100ms,比专有推理提供商的最佳延迟快 60ms 以上。推测解码带来的加速与接受长度近似线性,是降低解码延迟的关键手段。

    匹配字段标题

星期二

  1. Modal 官方工程博客精选

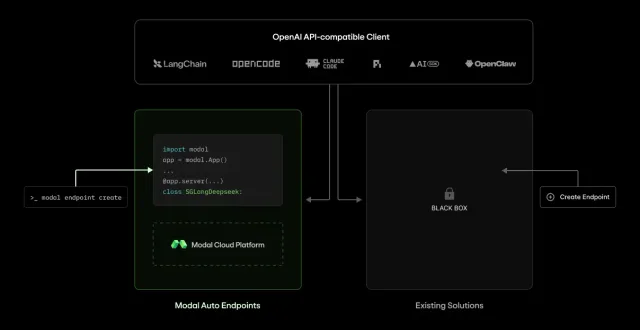
    Modal 发布 Auto Endpoints,一条命令部署自有 LLM 推理服务

    Modal 发布 Auto Endpoints,提供 OpenAI API 兼容、生产可用的推理服务,底层是用户可见可控的 Modal App,可通过 CLI 或点击部署 GLM 5.2 等开放模型。官方称不隐藏代码与指标,自动提供投机解码接受长度、每副本引擎侧 token 延迟分位数等数据,并同步推出面向超低延迟路由的 Modal Servers,HTTP 请求开销约 5ms。其部署配方基于 SGLang、FlashAttention-4 等开源引擎的补丁与上游贡献,并采用 Z Lab 的 DFlash 块扩散 drafter 架构。

    匹配字段标题

星期三

  1. Saito 硬地骇客

    百度美研早期投资 Cerebras 的十年复盘:推理需求为异构芯片打开窗口

    百度美研在十年前投资晶圆级芯片公司 Cerebras,以降低 AI 计算中的通信成本并减少对英伟达的依赖。文章回顾了其流片、散热、电源和编译器等工程难题,并认为 CUDA 生态使训练迁移成本较高,而推理需求增长正为 Cerebras 等异构芯片带来新窗口。

    匹配字段标题

  2. The Next Platform

    Tensordyne 发布 Napier 推理芯片,用对数运算替代矩阵乘法

    Tensordyne 公布其 Napier AI 推理引擎架构,核心思路是把数据转成对数后用加法替代矩阵乘法,官方称相比 Nvidia 和 AWS 的混合架构性能提升一个数量级以上,价格与功耗更低。Napier 采用 3nm 工艺、1380 亿晶体管,支持 NVFP4、FP8、FP16,FP8 稠密算力 2.1 petaflops,配备 144 GB HBM4 和 256 MB SRAM,单芯片功耗 300 瓦,对比 B300 GPU 的 1200 瓦。公司计划 2026 年底开放云端访问,2027 年第一季度向客户交付 beta 版 TDN Pod 系统,2027 年第二季度末开始出货。

    匹配字段标题

星期四

  1. Modal 官方工程博客

    Modal 如何让 FlashAttention-4 更适合 LLM 推理

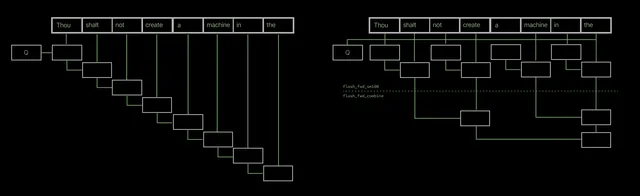
    Modal 对 FlashAttention-4 内核做了一系列改动以适配 LLM 推理,尤其是解码阶段:PR 2109 支持 FP8 输入(e4m3/e5m2),相对 bf16 基线吞吐最高提升 1.16 倍;PR 1999 与 PR 2104 支持任意 KV page size 并优化性能,小 page size 下吞吐最高提升 2.40 倍。改动还包括调整并行策略(从 query 并行转向 key/value 并行)以及用 cp.async 加载替代 TMA 的 cp.async.bulk 加载以支持不规则全局内存访问。

    Diagram showing output tile generation without and with KV parallelism

    匹配字段标题

星期二

  1. Microsoft AI Blog

    微软 MAI 发布七款新模型,含首个推理模型 MAI-Thinking-1

    微软 MAI 在 Build 2026 主题演讲中发布七款新模型,覆盖图像、语音、转录、推理和编码。首个推理模型 MAI-Thinking-1 为 35B 激活参数 MoE,256K 上下文窗口,AIME 25 得分 97%,SWE Bench Pro 53%,官方称未做知识蒸馏。编码模型 MAI-Code-1-Flash 仅 5B 参数,SWE Bench Pro 51%,今日起在 VS Code 中逐步向约 10% 个人用户推送。

    匹配字段标题