←搜索结果

按匹配度 · 共 3158 条结果 清除搜索

星期二

  1. Microsoft AI Blog

    微软 AI 发布七款新 MAI 模型,覆盖推理、编码、图像、语音与转录

    微软 AI 发布七款自研 MAI 模型,覆盖图像、语音、转录、编码与推理,包括旗舰推理模型 MAI-Thinking-1、面向 GitHub Copilot 的 MAI-Code-1-Flash、MAI-Image-2.5、MAI Transcribe-1.5 和 MAI-Voice-2。MAI-Thinking-1 在盲测人工对比中优于 Sonnet 4.6,MAI Transcribe-1.5 支持 43 种语言且速度是竞品的五倍,MAI-Image-2.5 的 Arena 分数超过 Nano Banana Pro。模型将在 Foundry、OpenRouter、Fireworks 和 Baseten 上提供,开发者首次可以自行微调模型权重;微软同时宣布与 Mayo Clinic 合作共建医疗前沿模型。

    匹配字段标题、摘要

星期一

  1. LMSYS Blog

    LMSYS 用异构 CPU + GPU EPD 分离提升 VLM 推理服务

    LMSYS 通过 Dynamo 与 SGLang 实现异构 Encode-Prefill-Decode(EPD)分离,将 VLM 的视觉编码任务卸载到 CPU(如头节点 CPU),在负载下 TTFT、TPOT 和吞吐量均获提升。在 Intel Xeon 6747P 与 5x L40S 配置、8 张 1080p 图像、QPS 1.0-2.0 下,P99 TTFT 和请求吞吐量提升约 1.2x-1.3x,P99 TPOT 降低约 1.3x-30x。Dynamo 路由器新增设备感知加权路由模式(PR #7215),以能力比 R 在 CPU 与 GPU 池间分配请求。

    匹配字段标题

星期六

星期五

  1. Zyphra Research

    Zyphra 在 AWS Inferentia2 上实现 Domino 式推理通信重叠

    Zyphra Research 与 AWS 合作,在 AWS Neuron 推理栈中实现了 Domino 式张量并行通信重叠,并在 Inferentia2 上对 Llama 3-8B 进行不同 NeuronCore 数量的基准测试。结果显示聚合输出吞吐量提升,首 token 时间和每输出 token 时间均下降,在张量并行度更高、集合通信占关键路径更大时收益最明显。

    匹配字段标题、摘要

星期四

  1. LMSYS Blog

    AMD Instinct MI355X 借助 SGLang 与 MoRI 实现成本可竞争的分布式推理

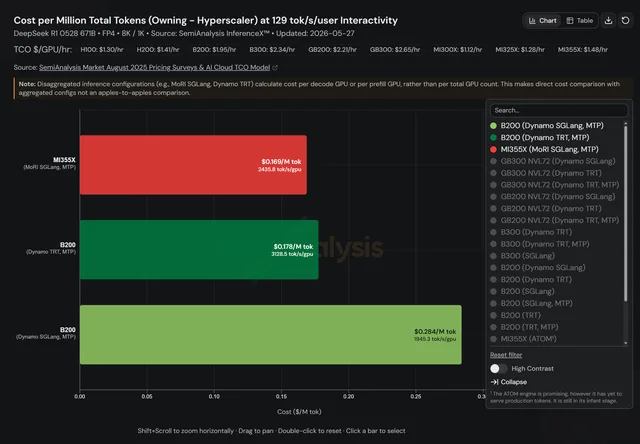
    SGLang 与 AMD 团队合作,在 AMD Instinct MI355X 上通过 SGLang 与 MoRI 通信库优化 DeepSeek-R1 分离式推理,在 129 tok/s/user 交互性下达到每百万 token 0.169 美元,比 B200 TRT-LLM 低 5%、比 B200 SGLang 低 40%,每 GPU 吞吐 2,436 tok/s(24 GPU),比 B200 SGLang 高 1.25 倍。优化包括 MoRI 量化 all-to-all(往返带宽最多降低 2.56 倍)、MoRI-IO KV cache 后端(吞吐比 Mooncake 高约 10%)、SDMA 双批次重叠、ROCm 上的 Specv2 MTP 以及 CPU 流式优化。结果已开源并通过 SemiAnalysis 的 InferenceX 持续验证。

    匹配字段标题、摘要

星期二

  1. LG AI Research 官方博客

    LG AI Research 如何用闲置推理 GPU 池调度训练任务

    LG AI Research 提出“GPU Job Scheduling using an idle inference GPU pool”方案,把 LLM 服务夜间闲置的推理 GPU 用于训练和研究任务。其基于 vLLM 内部指标做自动扩缩容,分析显示单副本占 4 张 GPU 时,平均约 52 张 GPU 每天闲置约 12 小时;任务以 best-effort 方式运行,服务流量上升时可随时被中断回收。

    Yeonsoo_Lim_37ff19a01.png

    匹配字段标题、摘要

星期一

  1. antirez 原创博客

    antirez 谈 DwarfStar 中的 LLM 分布式推理

    antirez 在 DwarfStar 项目中探讨本地 LLM 推理的分布式方案:Mac Studio M3 Ultra 512GB 可跑 DeepSeek v4 PRO,约 150 t/s prefill、10-13 t/s 解码;M5 Max 128GB 跑 2-bit 量化的 DeepSeek v4 Flash 和 Mimo V2.5 可达约 500 t/s prefill、35-40 t/s 解码。他提出层切分、基于 Apple RDMA 的专家并行,以及共享无关的 LLM ensemble 三种思路,认为 ensemble 是被低估的第三方向。

    匹配字段标题、摘要

星期二

  1. Together AI Blog

    大规模推理基准测试:编码智能体

    Together Inference Engine 在 Kimi K2.5 编码智能体负载下,以相同的 4× NVIDIA B200 硬件实现了比 TensorRT-LLM 高 31% 的 TPS,并在饱和时保持约 2 倍更优的 TTFT。测试采用约 45k–200k Token 的长提示词和平均 450 Token 的输出;SGLang 因 TP4 内存不足改用 8× B200。性能提升来自 ThunderMLA、定制内核重写及真实流量下的端到端分析。

    Bar chart titled Coding agents with pink and orange bars on dark background with code snippets behind.

    匹配字段标题

星期一

  1. Zyphra Research

    Zyphra 在 AMD MI355X 上推理性能基准测试:对比 B200

    Zyphra 发布 Zyphra Inference 在单节点 AMD Instinct MI355X GPU 上的首批端到端基准,覆盖 Kimi K2.6、GLM-5.1 和 DeepSeek V3.2,并与 AMD MI355X 与 Nvidia B200 基线配置对比。MI355X 每卡提供 288 GB HBM3E(B200 为 180 GB),两者 HBM 带宽均约 8 TB/s,但 MI355X 采用全连接 xGMI 点对点互联,8 路集合通信峰值 537.6 GB/s。测试使用 ShareGPT 与 LMSYS-Chat-1M,仅限 vLLM 框架、单节点且无真实流量。

    匹配字段标题

星期五

  1. antirez 原创博客

    antirez 谈 DS4:本地推理为何突然变得可用

    Redis 作者 antirez 发文谈 DwarfStar 4(DS4)项目意外走红的原因,认为准前沿模型的发布加上 2/8 bit 非对称量化方案,让 96 或 128GB 内存足以在本地运行,同时 GPT 5.5 也加快了开发。他表示这是自己第一次把本地模型用于原本会交给 Claude 或 GPT 的正式工作,并称 DeepSeek v4 Flash 表现令人印象深刻。后续项目将聚焦质量基准、内置编码智能体、本地 CI 硬件、更多移植以及串行与并行分布式推理。

    匹配字段标题、摘要

星期一

  1. Together AI Blog精选

    服务 DeepSeek-V4:为何百万 Token 上下文是推理系统问题

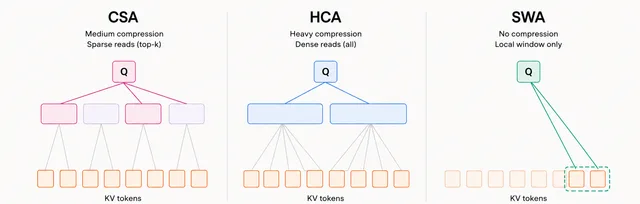
    DeepSeek-V4 通过 CSA、HCA 与 SWA 混合注意力在 KV 存储前压缩上下文,支持 1M-token 上下文窗口,但实际效率取决于推理引擎的缓存管理。Together AI 在 NVIDIA HGX B200 上调整 SWA 缓存策略后,将单节点 KV 缓存容量从约 1.2M tokens 提升至 3.7M tokens。长上下文、解码密集型任务最先受益,短上下文任务仍更依赖预填充优化与内核成熟度。

    Three diagrams comparing CSA, HCA, and SWA methods with different compression and KV token reads.

    匹配字段标题、摘要

星期五

  1. Sakana AI:Blog

    Sakana AI 与 NVIDIA 提出 TwELL 稀疏格式,让稀疏 Transformer 推理提速超 20%

    Sakana AI 与 NVIDIA 合作发布 ICML 2026 论文,提出 TwELL(Tile-wise ELLPACK)稀疏打包格式及配套 CUDA kernel,将 99% 高稀疏 token 走快速路径、以稠密备份矩阵兜底重 token,从而适配 GPU 的规则计算。在十亿参数规模上训练与评测稀疏 LLM,推理和训练提速超过 20%,峰值内存与能耗节省更高。

    匹配字段标题、摘要

  2. Berkeley AI Research (BAIR) Blog

    自适应并行推理:高效推理扩展的下一个范式

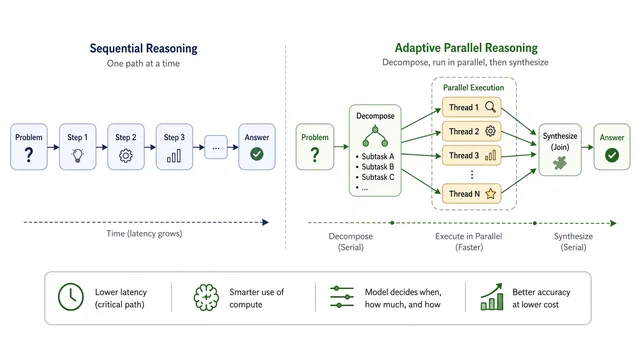
    伯克利 AI 研究(BAIR)博客梳理了并行推理领域的最新进展,重点讨论自适应并行推理(APR)这一范式:让模型在推理时自行决定何时并行、生成多少线程以及如何协调。相比 Tree-of-Thoughts 无需领域启发式分解,相比 BoN 避免冗余计算,相比非自适应方法可选择不并行。文中提到 ThreadWeaver(Lian et al., 2025)与 Pan et al.(2025)提出的 APR 方法。

    Adaptive Parallel Reasoning overview

    匹配字段标题、摘要、正文

  3. Together AI Blog

    如何在 Together DCI 上部署任意 Hugging Face 模型并运行推理

    Together AI 展示了如何用 Goose 和 together-dedicated-containers 技能,在单次会话中将 Netflix 的 void-model 部署至 Dedicated Container Inference。智能体可自动生成推理服务与容器配置;该模型能移除视频中的对象及其引发的阴影、反射和物理交互,推理任务以异步方式返回结果。

    Terminal screen showing void-byoc goose session ready with deployment note and URL to huggingface.co.

    匹配字段标题、摘要

星期三

  1. Zyphra Research

    Zyphra 发布 ZAYA1-8B 推理模型,基于 AMD 全栈训练

    Zyphra 发布 MoE 语言模型 ZAYA1-8B,激活参数不到 10 亿,在数学、编码和推理任务上对标 Nemotron-3-Nano-30B-A3B、Mistral-Small-4-119B 等更大开源模型。该模型在 1024 张 AMD MI300X 集群上完成预训练,采用压缩卷积注意力 CCA 与新型 MLP 专家路由,并配套提出 Markovian RSA 测试时计算方法。模型已在 Zyphra Cloud 提供免费 serverless 端点,权重上线 Hugging Face,采用 Apache 2.0 许可。

    匹配字段标题、摘要

星期一

  1. Together AI Blog

    支撑大规模高效推理的基础研究

    Together AI 介绍其通过算法、系统工程和硬件协同优化大规模推理的方法,旨在提升速度与成本效率,同时维持输出质量和可靠性。生产 AI 系统的推理约占全生命周期成本的 80–90%,尽管 GPT-3.5 水平的推理成本曾下降逾 280 倍,总支出仍随用例扩张而增长。其技术包括可实现 1.5–3x 加速的推测解码,以及 ATLAS 和开源 RL 框架 Aurora 所支持的自适应推测解码。

    匹配字段标题、摘要

  2. Zyphra Research

    Zyphra 推出 AMD 优先的 Zyphra Inference 云推理服务

    Zyphra 发布 Zyphra Cloud 平台的首个组件 Zyphra Inference,这是一项 AMD 优先的推理服务,基于 AMD MI355X GPU 并与 TensorWave 合作,面向长上下文智能体工作负载,托管 Kimi K2.6、DeepSeek V3.2 和 GLM 5.1 等开放模型。以 Kimi K2.6 为例,单台 8x-MI355X 节点提供 2,304GB HBM,可容纳约 184 个 256K 上下文的活跃智能体,而 8x-B200 节点约为 100 个。平台后续将扩展至后训练、强化学习环境和智能体原生基础设施。

    匹配字段标题、摘要

  3. Modal 官方工程博客

    Modal 用一个 Python 字典将 SGLang 多模态推理性能提升超 10%

    Modal 在 H100 上对 Qwen2.5-VL-3B-Instruct 做多模态推理基准测试时,发现 SGLang 调度器在 hash_feature 中反复调用 torch.UntypedStorage._new_shared_cuda,造成主机端开销。他们用简单的 Python 字典实现 CUDA IPC Pool Handle Cache,避免重复打开共享内存句柄,使吞吐量提升 16%、延迟降低 10%。该改进已合并进 SGLang v0.5.10。

    Diagram of processes in SGLang, identifying the scheduler process as the key component that might block the GPU.

    匹配字段标题、摘要

星期六

  1. LMSYS Blog精选

    SGLang 与 Miles 为 DeepSeek-V4 提供 Day-0 推理与 RL 训练支持

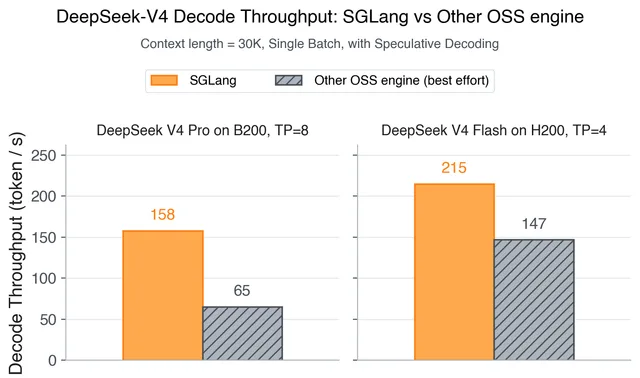
    LMSYS 宣布 SGLang 与 Miles 在 DeepSeek-V4 发布当天提供推理与 RL 训练支持,覆盖 1.6T Pro 和 284B Flash 两个版本。针对 DeepSeek-V4 的混合稀疏注意力、mHC 和 FP4 专家权重,团队引入 ShadowRadix 前缀缓存、HiSparse CPU 扩展 KV、MTP 投机解码等机制,并集成 FlashMLA、FlashInfer TRTLLM-Gen MoE、DeepGEMM Mega MoE 等内核。RL 侧 Miles 支持 DP/TP/SP/EP/PP/CP 六种并行策略与 FP8 训练,已在 32 张 GB300 上完成 285B 模型训练,首步 rollout 与训练 log-prob 偏差约 0.023。

    DeepSeek-V4 decode throughput on Day-0 launch: SGLang vs other OSS engine

    匹配字段标题、摘要