←搜索结果

按匹配度 · 共 2011 条结果 清除搜索

星期三

  1. LMSYS Blog

    SGLang 在 NVIDIA GTC 2026 的亮点回顾

    SGLang 在 NVIDIA GTC 2026 上参与了五场活动,包括亮相 Jensen Huang 主题演讲的 NVIDIA AI 生态幻灯片、一场开源 AI 现状圆桌、一场官方训练实验室,以及与 RadixArk 合办的 Happy Hour。训练实验室覆盖 SGLangCookbook 性能调优、性能瓶颈分析和 SGLang × Miles RL 集成演示。LinkedIn 团队还分享了仅 prefill 的 serving 路径在 H100 上带来 2–3× 吞吐提升,并已上游回 SGLang。

    匹配字段标题、摘要、正文

星期二

  1. Mistral AI

    Mistral AI 加入 NVIDIA Nemotron Coalition,将联合开发前沿开源模型

    Mistral AI 宣布作为创始成员加入 NVIDIA Nemotron Coalition,双方计划联合开发前沿开源 AI 模型,结合 Mistral AI 的模型架构与全栈平台和 NVIDIA 的算力、模型开发工具及合成数据生成管线。联盟首个项目是一个在 NVIDIA DGX Cloud 上训练的基础模型,将支撑即将推出的 NVIDIA Nemotron 4 系列并开源。Mistral AI 将贡献专有训练技术、多模态能力和企业级微调工具,此前双方曾合作开发 Mistral Nemo 模型。

    Nvidia Mistral Logos Dark

    匹配字段标题、摘要、正文

星期一

  1. Prime Intellect

    Prime Intellect 如何借助 NVIDIA 构建开放超级智能栈

    Prime Intellect 公布与 NVIDIA 的合作细节:训练与推理负载运行在 NVIDIA Blackwell 及即将推出的 Vera Rubin 机架级系统上,并用 NVIDIA Dynamo 承担全球推理编排,支持 LoRA 服务与 Arcee Trinity 等大规模 MoE 推理。其沙盒基础设施适配 Vera CPU,单路 88 核、SMT 开启后 176 线程可稳定运行 176 台 VM,真实 RL 沙盒负载下每 CPU 吞吐较 AMD Zen 5 平均高 30%。

    Leveraging NVIDIA to Build the Open Superintelligence Stack

    匹配字段标题、摘要、正文

星期三

  1. LMSYS Blog精选

    SGLang 首日支持 NVIDIA Nemotron 3 Super,面向多智能体系统推理

    SGLang 宣布在发布当天支持 NVIDIA Nemotron 3 Super,并给出安装与推理部署步骤。Nemotron 3 Super 是 120B 参数的混合 MoE 模型,每次前向仅激活 12B 参数,支持 1M token 上下文,官方称其吞吐效率最高可达上一代 Nemotron Super(Llama Nemotron Super 1.5)的 5 倍,并支持 Multi-Token Prediction 与 Thinking Budget。模型权重已在 Hugging Face 提供 BF16、FP8 和 NVFP4 版本,可配合 SGLang 在 4xH200 等配置上部署。

    匹配字段标题、摘要、正文

星期二

  1. goose 官方博客

    goose 10 万美元资助项目 Goose In A Pond:基于 NVIDIA Jetson Orin Nano 的本地智能家居助手

    goose 公布 10 万美元资助计划获奖项目 Goose In A Pond,由肯尼亚内罗毕五人团队 Jarida 基于 goose 开源智能体框架打造,部署在 NVIDIA Jetson Orin Nano 上,可本地运行 1–7B 量化模型、速度 40–70 tokens/秒。该项目用 Whisper、Vosk、Coqui TTS 实现离线语音,并计划开源 Moonbeam 等 MCP 服务器。

    blog banner

    匹配字段标题、摘要、正文

星期五

  1. LMSYS Blog

    SGLang 在 NVIDIA GB300 NVL72 上实现最高 25 倍推理性能提升

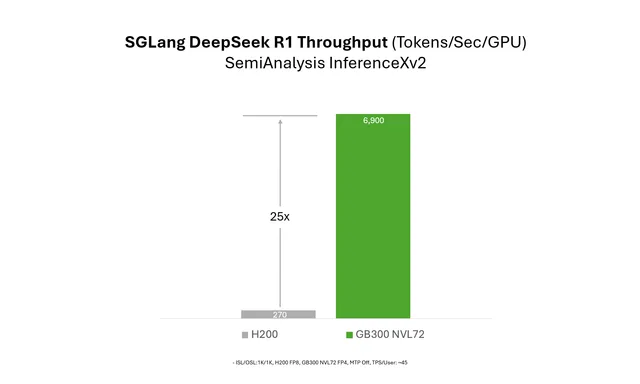
    SGLang 与 NVIDIA 合作,在 InferenceXv2 基准上于 GB300 NVL72 运行 DeepSeek R1 时相比 H200 实现最高 25 倍性能提升,该对比基于 50 TPS/user 的低延迟场景。借助 NVFP4 GEMM、计算通信重叠和 NVIDIA Dynamo 等优化,SGLang 在 GB200 NVL72 上的性能也在不到 4 个月内提升最高 8 倍。后续将推进 GB300 NVL72 的 MTP 支持及 Qwen 3.5 等模型的调优。

    匹配字段标题、摘要、正文

星期四

  1. The Next Platform

    Microsoft 与 NVIDIA 如何共建 AI 原生时代的软件未来

    Microsoft 与 NVIDIA 正合作推动 AI 原生时代的软件开发,通过 Azure AI Foundry 与加速计算支持智能体(agentic)系统。Microsoft 2025 Work Trend Index 显示,81% 的全球领导者预计 AI 智能体将在未来 12 至 18 个月内深度融入组织;Dow 借此每年节省数百万美元,Bayer 研发团队每周节省 6 小时研究时间。Microsoft 客户报告开发者效率提升 30%、成本降低 40%、上市速度加快 50%。

    匹配字段标题、摘要、正文

星期五

  1. vLLM 官方博客

    NVIDIA Nemotron Nano 2 VL 发布并获 vLLM 支持

    NVIDIA Nemotron Nano 2 VL 开源视觉语言模型发布,面向视频理解与文档智能,并获 vLLM 推理支持。模型采用混合 Transformer–Mamba 架构,通过 EVS 剪除冗余视频帧以减少 token。vLLM 夜间版本支持以 BF16、FP8 和 FP4 精度部署 OpenAI 兼容的推理服务器。

    匹配字段标题、摘要、正文

星期四

  1. vLLM 官方博客

    vLLM 新增对 NVIDIA Nemotron 模型家族的部署支持

    vLLM 现已支持部署 NVIDIA Nemotron 开放模型家族,可在数据中心和端侧硬件上运行智能体推理。Nemotron Nano 2 采用混合 Transformer–Mamba 架构并提供可配置的 thinking budget,开发者可调节精度、吞吐量和成本;其模型权重及超过 9T tokens 的训练数据已在 Hugging Face 提供。

    匹配字段标题、摘要、正文

  2. Ollama Blog

    Ollama 在 NVIDIA DGX Spark 上的性能测试

    Ollama 在 NVIDIA DGX Spark 发布日固件(580.95.05)和 Ollama v0.12.6 上完成性能测试,每次测试运行 10 次、温度设为 0、限制输出 500 tokens 并禁用缓存。DGX Spark 的 120GB VRAM 由 GB10 Grace Blackwell Superchip 提供,可完整容纳更大的 gpt-oss-120b 模型。

    匹配字段标题、摘要、正文

星期一

  1. Ollama Blog

    Ollama 与 NVIDIA 合作,在 DGX Spark 上开箱即用运行本地模型

    Ollama 与 NVIDIA 合作,确保最新 NVIDIA DGX Spark 开箱即用、快速高效运行。该设备搭载 NVIDIA GB10 Grace Blackwell Superchip,提供 1 petaFLOP 性能,配备 128GB 内存,可运行 Qwen、DeepSeek、Llama、Mistral、Gemma、Gpt-oss 等模型,也支持上传自定义或微调模型。双方正针对聊天、文档处理、代码任务和多模态工作流优化 Ollama 性能。

    Ollama NVIDIA DGX Spark

    匹配字段标题、摘要、正文

星期四

  1. vLLM 官方博客

    SemiAnalysis InferenceMAX 评测解析:vLLM 与 NVIDIA 加速 Blackwell 推理

    vLLM 与 NVIDIA 针对 Blackwell 优化大语言模型推理,在相近延迟下,gpt-oss 120B 和 Llama 3.3 70B 的吞吐量较上一代 Hopper 最高提升约 4x。双方通过一百多个 pull request 优化注意力、GEMM、MoE 内核、图融合和异步调度,并加入自动量化后端选择与 FlashInfer 自动调优。SemiAnalysis InferenceMAX 每日更新测试结果,以不同输入输出长度和 Pareto 前沿比较吞吐量与响应速度。

    匹配字段标题、摘要、正文

星期四

  1. SemiAnalysis精选

    又一次巨大飞跃:NVIDIA Rubin CPX 专用加速器与机架

    NVIDIA 推出面向推理 prefill 阶段的 Rubin CPX,以更高算力占比和低成本内存减少 HBM 与 NVLink 资源浪费。单芯片提供 20 PFLOPS 稠密 FP4 算力、128GB GDDR7 和 2TB/s 带宽,并通过 PCIe Gen 6 联网。该产品将用于固定配置的 VR200 NVL144 CPX 或更灵活的 Vera Rubin CPX 双机架方案。

    匹配字段标题、摘要、正文

星期二

  1. Zyphra Research

    Zyphra 发布 5 万亿 token 数据集 Zyda-2,用 NVIDIA NeMo Curator 将处理时间从 3 周缩短到 2 天

    Zyphra 发布 Zyda-2,一个约 5 万亿 token 的宽松许可数据集,由 DCLM、FineWeb-Edu、Zyda-1 和 Dolma v1.7 的 Common Crawl 部分经跨数据集去重与模型过滤组合而成,已在 HuggingFace 上开放。借助 NVIDIA NeMo Curator 的 GPU 加速,数据处理从 CPU 上的 3 周缩短到 2 天,总拥有成本降低 2 倍。Zyphra 称用 Zyda-2 退火训练的模型在 MMLU、Hellaswag 等聚合评测上优于 DCLM 和 FineWeb-Edu,其 Zamba2 系列模型即基于该数据集的早期版本训练。

    匹配字段标题、摘要、正文

星期五

  1. Rohan Paul

    Epoch AI:AI 芯片算力年增 3.4 倍

    Rohan Paul 引用 Epoch AI 数据指出,所有在用 AI 芯片的总算力每年增长 3.4 倍;但若每年新购芯片的算力只增长 2.5 倍,这一总量最终也会放缓至约 2.5 倍。Epoch AI 原帖称,自 2024 年初以来每季度售出的 AI 芯片算力年增 2.5 倍,低于 2023 年由 Nvidia H100 带动的约 6 倍。

    匹配字段摘要

  2. Rohan Paul

    Anthropic 占 SpaceX 第三季度营收 34.5%,成其最大客户

    彭博社披露,Anthropic 占 SpaceX 第三季度 145.75 亿美元营收的 34.5%,超过美国政府成为其最大客户。SpaceX 文件仅将该客户标为 Customer B,相关付款用于租用其孟菲斯数据中心的 Nvidia GPU 算力,该算力租赁业务也服务 Google。Anthropic 于 10 月 26 日提交的 S-1 显示,与 SpaceX 的安排到 2029 年最高达 1205 亿美元,而其对 Google、Amazon、Microsoft 的承诺分别为至少 1145 亿、1100 亿和 449 亿美元的最低值。

    匹配字段摘要、正文

星期四

  1. Rohan Paul

    Anthropic IPO 文件显示 1317 亿美元现金及短期投资

    Anthropic 的 IPO 文件显示其持有 1317 亿美元现金及短期投资,规模超过 Amazon 和 Microsoft;在美国非银行企业中仅 Berkshire Hathaway 和 Alphabet 更多,且超过 Nvidia 与 Apple 之和。其现金及等价物从 2025 年底的 174 亿美元增至 6 月 30 日的 1124 亿美元,上半年利息收入 11 亿美元,高于 6.93 亿美元的运营亏损。同期尚未开始的租赁未折现义务从 502 亿美元升至 3214 亿美元,另有 2656 亿美元固定或最低担保承诺;6 月 30 日后又签署约 2450 亿美元最低付款的新协议,Anthropic 称可能通过发行可转换债券而非现金结算部分租赁。

    匹配字段摘要、正文

  2. 蚂蚁百灵

    蚂蚁百灵与英伟达优化 Ling-3.0-flash 推理

    蚂蚁百灵(Ant Ling)与 NVIDIA AI 团队合作,在单台 NVIDIA DGX Spark 上用三种技术优化了开放权重模型 Ling-3.0-flash 的推理。在 1,319 道 GSM8K 题目上,解码吞吐从 37.81 tok/s 提升至 53.89 tok/s(+42.5%),平均延迟从 15.21s 降至 11.49s(-24.5%),准确率无统计上可检测的变化。

    匹配字段摘要、正文