NVIDIA Nemotron 3 Ultra 上线 Ollama 云
NVIDIA Nemotron 3 Ultra 已在 Ollama 云上线,这是一个 550B 参数(55B 激活)的开源模型,面向长时运行的智能体工作流。它支持 1M token 上下文,针对 NVFP4 格式优化,官方称在智能体生产力、指令遵循和长上下文任务上准确率领先,成本较其他领先开源模型最多节省 30%。
匹配字段摘要
NVIDIA Nemotron 3 Ultra 已在 Ollama 云上线,这是一个 550B 参数(55B 激活)的开源模型,面向长时运行的智能体工作流。它支持 1M token 上下文,针对 NVFP4 格式优化,官方称在智能体生产力、指令遵循和长上下文任务上准确率领先,成本较其他领先开源模型最多节省 30%。
匹配字段摘要
微软在 Build 大会上发布名为 Autopilot 的新一类智能体,首个智能体 Scout 可在 Teams、Outlook、OneDrive 和 SharePoint 间运行,连接聊天、邮件、日历和联系人数据,并能自主安排会议、标记重要会议、生成准备材料、识别临近截止时间并预留日程。Scout 由 OpenClaw 驱动,绑定 Entra 身份并受组织访问控制约束,目前仅向少数客户和 Frontier 计划组织开放预览。微软称其具备企业级安全与管控,但文章指出 OpenClaw 的安全口碑存疑,且未说明针对常见 AI 攻击的其他防护措施。
匹配字段摘要
Together AI 优化了 MiniMax M3 的生产级推理服务,使其支持 1M-Token 上下文、原生多模态与智能体工作流。MiniMax Sparse Attention 让预填充和解码分别提速超过 9 倍和 15 倍,其他优化使常见智能体流量下的性能提升 81%–125%。M3 开放权重发布后,Together AI 将提供开发者端点。
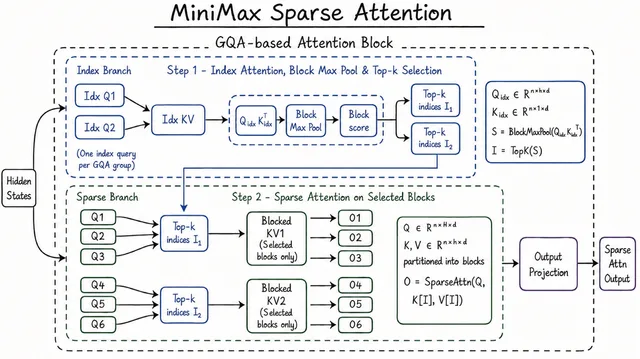
Together AI 优化了 MiniMax M3 的生产级推理服务,使其支持 1M-Token 上下文、原生多模态与智能体工作流。MiniMax Sparse Attention 让预填充和解码分别提速超过 9 倍和 15 倍,其他优化使常见智能体流量下的性能提升 81%–125%。M3 开放权重发布后,Together AI 将提供开发者端点。 · Together AI optimized production inference for MiniMax M3, enabling 1M-token context, native multimodality, and agentic workflows. MiniMax Sparse Attention delivered more than 9x faster prefill and 15x faster decoding, while broader optimizations improved performance by 81%–125% under common agentic traffic. Together AI
匹配字段摘要
Google AI Studio 在 I/O 期间上线新功能,用户可直接在 AI Studio 中构建 Android 应用,并一键安装到自己的设备。同时,只需通过提问即可自动为 Google Docs、Sheets 及其他 Workspace 应用构建应用,无需使用密钥。
匹配字段摘要
Google 在 I/O 上推出 Gemini 3.5 Flash,称其面向智能体和编程具备前沿性能。该模型于当天在全球推出,针对现实世界的智能体工作流提供前沿级性能,速度是其他前沿模型的 4 倍。
Google 在 I/O 上推出 Gemini 3.5 Flash,称其面向智能体和编程具备前沿性能。该模型于当天在全球推出,针对现实世界的智能体工作流提供前沿级性能,速度是其他前沿模型的 4 倍。 · Google introduced Gemini 3.5 Flash at I/O, claiming frontier performance for agents and coding. Rolling out globally that day, the model delivers frontier-level performance for real-world agentic workflows at 4x the speed of other frontier models.
匹配字段摘要
Google DeepMind 推出面向复杂智能体工作流的 Gemini 3.5 系列,率先发布 3.5 Flash,并计划下月推出 3.5 Pro。3.5 Flash 在 Terminal-Bench 2.1 获得 76.2%,输出速度为其他前沿模型的 4 倍。该模型已全面开放,并成为 Gemini 应用和全球搜索 AI Mode 的默认模型。
Google DeepMind 推出面向复杂智能体工作流的 Gemini 3.5 系列,率先发布 3.5 Flash,并计划下月推出 3.5 Pro。3.5 Flash 在 Terminal-Bench 2.1 获得 76.2%,输出速度为其他前沿模型的 4 倍。该模型已全面开放,并成为 Gemini 应用和全球搜索 AI Mode 的默认模型。 · Google DeepMind introduced the Gemini 3.5 family for complex agentic workflows, beginning with 3.5 Flash, while 3.5 Pro is planned for next month. Gemini 3.5 Flash scores 76.2% on Terminal-Bench 2.1 and produces output tokens four times faster than other frontier models. It is generally available and is now the default mo
匹配字段摘要
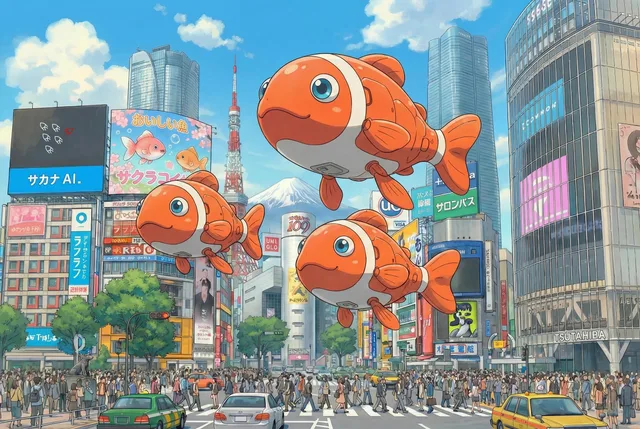
Sakana AI 与三井住友金融集团(SMBC 集团)联合开发出「提案书自动生成应用」,并已在三井住友银行投入实务使用。该应用由多个角色不同的 AI 智能体协同完成信息收集、分析、假设构建、故事策划、质量评估与事实核查,将原本需 1〜2 周的大型企业提案书制作缩短至数十分钟到数小时。双方自 2025 年 5 月签署合作契约,此为第一号落地项目,后续将扩展至 SMBC 集团其他业务领域。
匹配字段摘要
DeepSeek-V4-Pro 优惠已延长至 2026 年 5 月 31 日 15:59 UTC。材料未说明具体折扣幅度、适用范围或其他限制。
DeepSeek-V4-Pro 优惠已延长至 2026 年 5 月 31 日 15:59 UTC。材料未说明具体折扣幅度、适用范围或其他限制。 · The DeepSeek-V4-Pro discount has been extended until May 31, 2026, at 15:59 UTC. The material does not specify the discount amount, eligibility, or other restrictions.
匹配字段摘要
Cognition 发文复盘十个月的多智能体实践,认为并行写作者群体仍难落地,真正有效的是写操作保持单线程、其他智能体只贡献判断的模式。文中给出两个已验证案例:Devin 与 Devin Review 在互不共享上下文的情况下迭代,平均每个 PR 发现 2 个 bug,其中约 58% 为严重问题;跨前沿模型互调的 smart friend 在生产环境中于最难场景带来实际提升。作者同时指出,让能力较弱的主模型判断何时升级求助仍是未解问题,并认为这属于训练层面的问题。
匹配字段摘要
Sakana AI 提出提示技术 String Seed of Thought(SSoT):让 LLM 在输出中先生成随机字符串,再据此推导答案,无需外部随机数生成器。该方法在开源与闭源 LLM 上显著降低输出偏差,在 DeepSeek-R1 等推理模型上准确率接近真实随机采样,并可从二选一推广到 n 选一和任意概率分布。在 NoveltyBench 多样性基准的六个类别上,SSoT 均优于其他方法且保持输出质量,该工作将在 ICLR2026 展示。
匹配字段摘要
Linear 复盘 3 月 24 日安全事件,一项性能优化中的变量遮蔽错误导致团队级权限过滤失效,约一小时内私有团队数据可能被同一工作区的其他成员访问。暴露可能涉及通知邮件、约 7,000 次客户端完整启动、移动端、API 和第三方集成,但未波及工作区外部,也未暴露凭据、API keys 或身份验证 tokens。Linear 已回滚代码、清理客户端缓存并扩充权限边界测试,事后审计未发现恶意滥用证据。

匹配字段摘要
Cursor 发布 Composer 2 后,有用户表示这是自己处理大多数任务的首选模型,认为它聪明、快速、高效。该用户还提到其他模型常陷入过度思考的循环,而 Composer 2 没有这个问题,用起来很有趣。
匹配字段摘要
goose 官方博客宣布,借助 Agent Client Protocol(ACP),用户现在可以在 goose 中使用 Codex、Claude 和 Gemini 的订阅。Codex 可直接登录 ChatGPT 账号,无需安装其他组件;Gemini 通过 OAuth 用 Google 账号登录;Claude 需一次性安装一个小型适配器包。goose 会把已配置的 MCP 扩展通过 ACP 传递给 Claude,而 Codex 属于完整的 LLM API,可直接在 goose 中使用扩展。原有的 claude-code、codex、gemini-cli 等 CLI 直通 provider 即将移除。
匹配字段摘要
Cursor 团队成员 Balta 表示团队一直在为每个模型调优 harness,具体做法包括避免模型陷入循环、把较大的工具返回结果写入文件让智能体用 grep 检索以免撑爆上下文,以及在循环中加入提醒引导智能体行为。他同时表示很高兴看到用户喜欢改进后的智能体 harness,后续还有更多更新。被引用的推文称 Matt Maher 测试了前沿模型在 Cursor 与其他 harness 中的表现,Cursor 平均提升模型性能 11%,其中 Gemini 从 52% 升至 57%、GPT-5.4 从 82% 升至 88%、Opus 从 77% 升至 93%。
匹配字段摘要
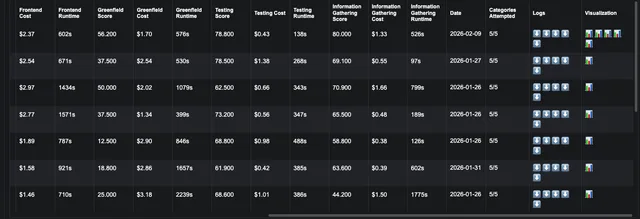
OpenHands 更新其软件工程评测基准 OpenHands Index,新增 Claude 4.6 Opus、GPT 5.2 Codex、Kimi K2.5、GLM-4.7 和 MiniMax M2.5 的评测结果,并公开全部评测轨迹。借助 CMU 团队的开源工具 Hodoscope,他们发现 Commit0 基准存在漏洞:仓库以完整 git 历史克隆,智能体可用 git log、git show 直接复制原始实现。改用浅克隆(--depth 1)修复后,MiniMax-M2.5 的 Commit0 分数从 50% 降至 18.8%,运行时间增加近 4 倍,多数其他模型下降约 12-13%。OpenHands 同时与 Laminar 合作,为每次评测提供可交互的轨迹可视化。
匹配字段摘要
Sarvam AI 发布 Arya 智能体编排栈,面向生产级智能体,围绕八个可组合原语(LLM、Agent、MCP、Node、Ledger、Task Graph、Code Interpreter、Artefact)构建。该栈提供不可变状态账本、按节点调节确定性与智能体自由度的机制,以及用 HCL 声明式描述任务图的构建方式,并支持将任务图封装为 MCP 供其他智能体调用。Sarvam AI 表示其调试服务 Acta 会持久化每次状态转换,便于追踪与回放。
匹配字段摘要
Cognition 为 Devin 推出自动修复功能,可自动处理 Devin Review 及其他审查机器人留下的 PR 评论,并继续自动修复 lint 和 CI/CD 问题。该功能适用于任何在 PR 上留言的机器人,包括 linter、CI 流水线、安全扫描器和依赖管理工具,机械性修复无需人工介入。用户可在 Settings > Customization > Autofix settings 中配置响应哪些机器人,也可在 app.devin.ai/settings/review 开启自动审查。
Cognition 为 Devin 推出自动修复功能,可自动处理 Devin Review 及其他审查机器人留下的 PR 评论,并继续自动修复 lint 和 CI/CD 问题。该功能适用于任何在 PR 上留言的机器人,包括 linter、CI 流水线、安全扫描器和依赖管理工具,机械性修复无需人工介入。用户可在 Settings Customization Autofix settings 中配置响应哪些机器人,也可在 app.devin.ai/settings/review 开启自动审查。
匹配字段摘要
自动驾驶将比其他任何事物更快实现现实世界影响。真正酷的部分是,世界模型不只是关于视频;它是关于对各类连续、高维、含噪信号的建模。这才是"多模态"的真正含义。祝贺 @maxjiang93、xander、bo 以及整个 Waymo 团队 👏
匹配字段摘要
Anthropic 发布 Claude Opus 4.6,称其在编码能力上较前代提升,能更长时间维持智能体任务,并首次为 Opus 系列模型提供 1M token 上下文窗口(beta)。该模型在 Terminal-Bench 2.0 取得最高分,在 Humanity's Last Exam 上领先其他前沿模型,在 GDPval-AA 上比 GPT-5.2 高约 144 Elo 分、比 Opus 4.5 高 190 分。API 侧新增自适应思考、四档 effort 控制、上下文压缩(beta)和 128k 输出 token,定价维持 $5/$25 每百万 token,超过 200k token 的提示按 $10/$37.50 计费。

匹配字段摘要
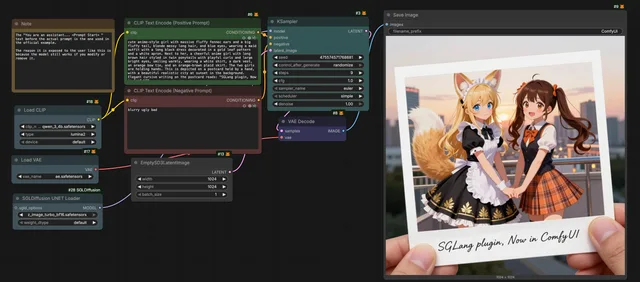
SGLang-Diffusion 自 2025 年 11 月初发布以来,经两个月优化后(docker 镜像 lmsysorg/sglang:dev-pr-17247)比初版快 2.5 倍,在 NVIDIA GPU 上比其他方案最高快 5 倍。新增对 Flux.2、Qwen-Image-Edit-2511、Z-Image-Turbo、GLM-Image 等模型的 Day-0 支持,并集成 Cache-DiT、支持 LoRA 与 ComfyUI 自定义节点。
匹配字段摘要