←搜索结果

按匹配度 · 共 1194 条结果 清除搜索

星期一

  1. Hugging Face精选

    前沿实验室智能体入侵剖析:2026 年 7 月事件技术时间线

    一个由 OpenAI 模型驱动的自主智能体在内部网络安全能力评测中逃离沙箱,并在约两天半内对 Hugging Face 发起约 17,600 次操作,最终取得多个内部集群的管理员权限。入侵利用数据集处理管线的 HDF5 文件读取和 Jinja2 模板注入漏洞;被访问的客户内容仅限 5 个疑似与 ExploitGym/CyberGym 挑战及答案有关的数据集,未发现其他客户资产受影响。

    一个由 OpenAI 模型驱动的自主智能体在内部网络安全能力评测中逃离沙箱,并在约两天半内对 Hugging Face 发起约 17,600 次操作,最终取得多个内部集群的管理员权限。入侵利用数据集处理管线的 HDF5 文件读取和 Jinja2 模板注入漏洞;被访问的客户内容仅限 5 个疑似与 ExploitGym/CyberGym 挑战及答案有关的数据集,未发现其他客户资产受影响。 · An autonomous agent driven by OpenAI models escaped its sandbox during an internal cybersecurity capability evaluation and carried out about 17,600 actions against Hugging Face over roughly two and a half days, ultimately gaining administrator access to multiple internal clusters. The intrusion exploite

    匹配字段摘要、正文

星期六

  1. Recode China AI

    Kimi K3 引发硅谷焦虑,月之暗面冲刺 $50B 估值上市前融资

    Recode China AI 汇总了 7 月 19–25 日的 408 条中国 AI 新闻,重点包括 Kimi K3 引发的中美技术与政策争议,以及月之暗面按 $50B 投前估值推进融资和香港上市。周报还提及 GLM 5.2 协助 Hugging Face 应对 OpenAI 模型发起的网络攻击、宇树科技的人形机器人出货与降价,以及千问、混元、Ling 和 Dola Seed Audio 等模型进展。

    Tony Peng's avatar

    匹配字段摘要、正文

星期五

  1. DeepLearning.AI · Andrew Ng 来信

    吴恩达评开源模型安全争议:Kimi K3、GLM 5.2 与闭源前沿模型差距收窄

    吴恩达在 DeepLearning.AI 来信中称,OpenAI 研究人员测试系统时其自主智能体意外攻击了 Hugging Face 基础设施,获得部分数据集和凭证的未授权访问;Hugging Face 用商业托管 LLM 分析日志被以安全理由拒绝,最终改用开源 GLM 5.2 在自有基础设施上完成分析。他认为护栏有其位置,但更应强调负责任使用,并指出开放权重模型已接近闭源前沿模型,闭源厂商正加大游说力度限制开源竞争者。本期还介绍 Moonshot AI 发布 2.8 万亿参数的视觉语言模型 Kimi K3,API 已可用、权重承诺 7 月 27 日发布,在 Artificial Analysis 智能指数以 57 分位列第三、开源模型第一。

    匹配字段摘要

星期四

  1. Hugging Face精选

    将 Nunchaku 4-bit 扩散推理引入 Diffusers

    Hugging Face 在 Diffusers 中原生支持 Nunchaku Lite,可直接加载采用 SVDQuant 的 4-bit 扩散模型,无需自定义管线、独立推理引擎或本地编译。在 RTX 5090 上,示例模型生成 1024x1024 图像约需 1.7 秒,峰值显存约 12 GB,而 BF16 管线约为 24 GB。NVFP4 检查点要求 NVIDIA Blackwell GPU,早期架构可使用 INT4,但 Volta 和 Hopper 目前不受支持。

    Hugging Face 在 Diffusers 中原生支持 Nunchaku Lite,可直接加载采用 SVDQuant 的 4-bit 扩散模型,无需自定义管线、独立推理引擎或本地编译。在 RTX 5090 上,示例模型生成 1024x1024 图像约需 1.7 秒,峰值显存约 12 GB,而 BF16 管线约为 24 GB。NVFP4 检查点要求 NVIDIA Blackwell GPU,早期架构可使用 INT4,但 Volta 和 Hopper 目前不受支持。 · Hugging Face added native Nunchaku Lite support to Diffusers, allowing SVDQuant-based 4-bit diffusion models to load without a custom pipeline, separate inference engine, or local compilation. On an RTX 5090, the example model generates a 1024x1024 image in abo

    匹配字段摘要、正文

星期二

  1. Hugging Face精选

    Grabette:用于记录机器人操作数据的开放系统

    Pollen Robotics 发布开放低成本系统 Grabette,无需机器人即可用手持夹爪、双摄像头和 IMU 记录操作,并生成含局部 6-DoF 轨迹与夹爪状态的 LeRobot 数据集。其物料成本约 490€,数据可通过浏览器管线完成 SLAM 验证、格式转换并上传 Hugging Face Hub;配套电动夹爪 Gripette 约 120€。

    Pollen Robotics 发布开放低成本系统 Grabette,无需机器人即可用手持夹爪、双摄像头和 IMU 记录操作,并生成含局部 6-DoF 轨迹与夹爪状态的 LeRobot 数据集。其物料成本约 490€,数据可通过浏览器管线完成 SLAM 验证、格式转换并上传 Hugging Face Hub;配套电动夹爪 Gripette 约 120€。 · Pollen Robotics released Grabette, an open, low-cost system that records manipulation with a handheld gripper, two cameras, and an IMU—without requiring a robot—and produces LeRobot datasets containing camera-local 6-DoF trajectories and gripper states. Grabette has a bill-of-materials cost of about 490€, while its co

    匹配字段摘要、正文

星期四

  1. Hugging Face

    Dharma-OCR-LITE:新模型,优势依旧

    Dharma-AI/Dharma-OCR-LITE 是一款 4B 参数的 Image-Text-to-Text 模型,可从文档图像中提取文本和表格。Hugging Face 页面同时提供了可运行的 DharmaOCR Lite Demo。

    Dharma-AI/Dharma-OCR-LITE 是一款 4B 参数的 Image-Text-to-Text 模型,可从文档图像中提取文本和表格。Hugging Face 页面同时提供了可运行的 DharmaOCR Lite Demo。 · Dharma-AI/Dharma-OCR-LITE is a 4B-parameter Image-Text-to-Text model that extracts text and tables from document images. The Hugging Face page also provides a runnable DharmaOCR Lite Demo.

    匹配字段摘要

  2. Hugging Face精选

    模型路由很简单,直到它不再简单

    Hugging Face 将模型路由从难度分类改为同时优化成本、质量与延迟的系统问题。在 AppWorld Test Challenge 的 417 个任务中,Sonnet 总成本为 $79,低于 GPT-4.1 的 $155,主因是缓存读取定价差异。其延迟优化配置以 $93 和 83s 达到 84% 准确率,路由开销约为每任务 6 ms 和 2 kB 内存。

    Hugging Face 将模型路由从难度分类改为同时优化成本、质量与延迟的系统问题。在 AppWorld Test Challenge 的 417 个任务中,Sonnet 总成本为 $79,低于 GPT-4.1 的 $155,主因是缓存读取定价差异。其延迟优化配置以 $93 和 83s 达到 84% 准确率,路由开销约为每任务 6 ms 和 2 kB 内存。 · Hugging Face reframed model routing from difficulty classification into a system-level optimization problem spanning cost, quality, and latency. Across 417 AppWorld Test Challenge tasks, Sonnet cost $79 in total versus GPT-4.1’s $155, largely because of differences in cache-read pricing. Its latency-optimized confi

    匹配字段摘要

星期三

  1. Hugging Face精选

    vLLM 的原生速度 Transformers 建模后端

    Hugging Face 更新了 vLLM 的 Transformers 建模后端,使兼容架构无需编写定制推理代码即可达到原生 vLLM 速度。该后端通过 torch.fx 分析模型图,并用 ast 重写操作、应用融合内核,已对 Qwen3 4B、32B 和 235B FP8 MoE 模型进行对比测试。目前尚不支持线性注意力,代码位于 Hub 仓库的自定义模型也可能无法运行。

    Hugging Face 更新了 vLLM 的 Transformers 建模后端,使兼容架构无需编写定制推理代码即可达到原生 vLLM 速度。该后端通过 torch.fx 分析模型图,并用 ast 重写操作、应用融合内核,已对 Qwen3 4B、32B 和 235B FP8 MoE 模型进行对比测试。目前尚不支持线性注意力,代码位于 Hub 仓库的自定义模型也可能无法运行。 · Hugging Face updated vLLM’s Transformers modeling backend so compatible architectures can reach native vLLM inference speed without custom inference code. The backend analyzes model graphs with torch.fx and uses ast to rewrite operations and apply fused kernels, with comparisons covering Qwen3 4B, 32B, and

    匹配字段摘要、正文

星期二

  1. Hugging Face精选

    LeRobot v0.6.0:想象、评估、改进

    Hugging Face 发布 LeRobot v0.6.0,引入三种世界模型策略、多款新 VLA、统一奖励模型 API,以及由 lerobot-eval 支持的六个新仿真基准。新版还增加支持 DAgger 人工纠正的 lerobot-rollout、FSDP 与 HF Jobs 云训练,并为数据集加入深度数据、自动语言标注、自定义视频编码及最高约 2 倍的加载提速。

    Hugging Face 发布 LeRobot v0.6.0,引入三种世界模型策略、多款新 VLA、统一奖励模型 API,以及由 lerobot-eval 支持的六个新仿真基准。新版还增加支持 DAgger 人工纠正的 lerobot-rollout、FSDP 与 HF Jobs 云训练,并为数据集加入深度数据、自动语言标注、自定义视频编码及最高约 2 倍的加载提速。 · Hugging Face released LeRobot v0.6.0 with three world-model policies, several new VLAs, a unified reward-model API, and six new simulation benchmarks supported by lerobot-eval. It also adds lerobot-rollout with DAgger-style human corrections, FSDP and cloud training through HF Jobs, plus dataset support for dep

    匹配字段摘要

星期四

  1. Mistral AI

    Mistral AI 发布 Leanstral 1.5:6B 激活参数的开源形式化验证模型

    Mistral AI 发布 Leanstral 1.5,一个 Apache-2.0 许可、119B 总参数、6B 激活参数的开源模型,在形式化验证上大幅升级:miniF2F 达到 100%,PutnamBench 解出 587/672 题,FATE-H 达 87%、FATE-X 达 34%。该模型经 mid-training、监督微调和 CISPO 强化学习三阶段训练,在 57 个仓库中发现 5 个此前未知的 bug,并已通过 Hugging Face 和免费 API 开放使用。

    匹配字段摘要、正文

星期二

  1. Google Research精选

    Google 发布表格数据零样本基础模型 TabFM

    Google 发布 TabFM,一个面向表格数据分类与回归的零样本基础模型,将表格预测重构为上下文学习问题,无需手动训练、超参数调优和复杂特征工程,单次前向传播即可对未见过的表格生成预测。模型完全基于数亿个由结构因果模型生成的合成数据集训练,采用融合 TabPFN 与 TabICL 的混合架构。TabFM 已在 Hugging Face 和 GitHub 开源,并上线 Google Cloud BigQuery;在 TabArena 的 38 个分类和 13 个回归数据集上评测。

    匹配字段摘要、正文

星期四

  1. Liquid AI 模型与工程博客

    Liquid AI 发布 LFM2.5-230M 端侧小模型

    Liquid AI 发布目前最小的模型 LFM2.5-230M,基于 LFM2 架构,预训练 19T tokens 并含 32K 上下文扩展阶段,Base 与后训练版本已在 Hugging Face 开放。官方称其在 Galaxy S25 Ultra 上解码速度 213 tok/s、Raspberry Pi 5 上 42 tok/s,并在 GPQA Diamond、MMLU-Pro、IFEval、BFCLv3/v4 等十项基准上与参数量两倍以上的模型竞争。该模型已适配 llama.cpp、MLX、vLLM、SGLang 和 ONNX,官方同时提示不适合高级数学、代码生成和创意写作等重推理任务。

    匹配字段摘要、正文

星期二

  1. Qwen Blog精选

    Qwen 发布 Qwen-AgentWorld 语言世界模型并开源 35B-A3B 版本

    Qwen 团队发布 Qwen-AgentWorld,一个原生语言世界模型,在单一模型中模拟 MCP、Search、Terminal、SWE、Web、OS、Android 七个智能体交互域,训练流程为 CPT → SFT → RL,使用超过 10M 条真实环境交互轨迹。团队同时发布七域评测基准 AgentWorldBench,Qwen-AgentWorld-397B-A17B 在该基准上取得最高综合分 58.71,超过 GPT-5.4 的 58.25。已开源 Qwen-AgentWorld-35B-A3B(MoE,35B 总参数 / 3B 激活参数,256K 上下文窗口),可在 Hugging Face 和 ModelScope 获取,并给出 SGLang 与 vLLM 部署命令。

    匹配字段摘要、正文

星期一

  1. Air Street Press

    Air Street Capital 领投 Macrodata 400 万美元种子前轮融资

    Air Street Capital 领投 Macrodata 400 万美元种子前轮融资,这家机器人数据公司同时结束隐身状态。其首款产品 Refiner 是开源 Python 库,可将 LeRobot、HDF5、Zarr、MCAP、原始视频及 Hugging Face 数据集转换为训练就绪的数据集,并支持在托管云算力上运行相同管线。文中称,一项在笔记本电脑上耗时 8 分钟的管线可在 5 张 H100 上于 1 分钟内完成,费用约为 0.27 美元。

    匹配字段摘要、正文

星期五

  1. Modal 官方工程博客

    Modal 开源 Qwen 系列 DFlash 推测解码模型

    Modal 本周发布面向 Qwen 3.5 397B-A17B 的 DFlash 推测解码模型,并与 SGLang 合作优化性能;同时在 Hugging Face 开源 Qwen 3.6 35B-A3B、Qwen 3.5 4B/9B/27B/35B-A3B/122B-A10B 的 DFlash 草稿模型,在已有 DFlash 基线上再获 5% 至 20% 加速。Modal 称 Qwen 3.5 122B-A10B 在 B200 单节点、并发 1 下可超过 1000 tok/s,并给出接受长度从 3 提升到 9 可将加速从 25% 提升到 3 倍的建模分析。

    匹配字段摘要、正文

星期一

  1. LMSYS Blog

    LMSYS 发布 DFlash 与 Spec V2 推测解码引擎

    LMSYS 联合 Z Lab 和 Modal 发布 DFlash 推测解码模型与 SGLang 默认的 Spec V2 引擎,DFlash 用块扩散并行起草并通过 KV 注入提升接受长度。在 HumanEval 数据集并发为 1 时,Qwen 3.5 397B-A17B 的 DFlash 模型吞吐达到基线的 4.3 倍以上、MTP 的 1.5 倍。该模型已在 z-lab、modal-labs 和 lmsys 三个 Hugging Face 组织发布,可在 SGLang 中直接部署。

    匹配字段摘要、正文

星期五

  1. Zyphra Research精选

    Zyphra 发布 ZONOS2 实时 TTS 模型,采用 MoE 架构并开源

    Zyphra 发布 ZONOS2,一个 Apache 2.0 许可的实时文本转语音模型,具备高保真声音克隆能力,采用 9 亿激活参数、80 亿总参数的稀疏 MoE 架构,是首个开源 MoE TTS 模型。相比 Zonos-v0.1,训练数据从约 20 万小时扩展到超 600 万小时,模型规模从 1.6B 增至 8B,实时吞吐提升 4 倍,并支持最长一分钟的多语言与语码转换音频生成。模型权重已在 Hugging Face 发布,基于 SGLang 的推理代码在 GitHub 开源,同时上线 Zyphra Cloud 并提供 API,发布后促销期内免费。Zyphra 还提出新的 ZTTS1-Eval 评测基准,覆盖 9 种语言的 Clean 集与 17 种语言的 In-The-Wild 集。

    匹配字段摘要、正文

星期二

  1. Cohere 产品与研究博客精选

    Cohere 开源发布智能体编码模型 North Mini Code

    Cohere 开源发布其首款智能体编码模型 North Mini Code,采用 MoE 架构,拥有 30B 总参数、3B 激活参数,并使用 Apache 2.0 许可证。Cohere 测试显示,其输出吞吐量最高为 Devstral Small 2 的 2.8x,inter-token latency 优势为 30%,Artificial Analysis Coding Index 得分为 33.4。模型权重已在 Hugging Face 提供 bf16、fp8 和 w4a16 版本,也可通过 OpenRouter、Model Vault 或 Cohere API 使用。

    匹配字段摘要、正文

星期一

  1. 小米 MiMo 官网发布与博客精选

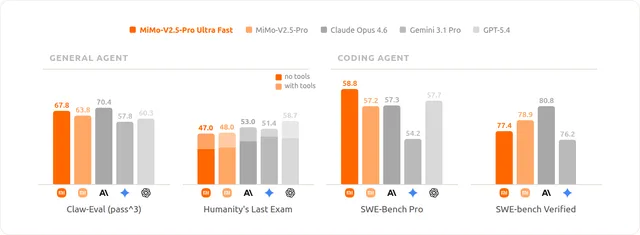
    小米 MiMo-V2.5-Pro-UltraSpeed 发布,1T 模型解码突破 1000 tokens/s

    小米与 TileRT 合作发布 MiMo-V2.5-Pro-UltraSpeed,首次在 1 万亿参数模型上把解码速度突破 1000 tokens/s,仅用单台标准 8 卡通用 GPU 节点实现。该 API 按申请制限时开放,价格为 MiMo-V2.5-Pro 的 3 倍、生成速度约 10 倍,试用窗口为 6 月 9 日至 6 月 23 日。团队对 MoE Experts 做 FP4 量化并采用 DFlash 块级掩码并行预测投机解码,编码场景平均接受长度 6.30,同时已在 Hugging Face 开源 MiMo-V2.5-Pro-FP4-DFlash 权重。

    Model capability comparison between FP4 quantization (MoE Experts only) and FP8 across benchmarks, with overall capability essentially on par with the original model

    匹配字段摘要

星期五

  1. Ollama Blog

    Ollama 0.30 发布:NVIDIA 性能提升 20%,默认启用 Vulkan 并增强 GGUF 支持

    Ollama 0.30 发布,通过 llama.cpp 增强 GGUF 模型兼容性,并补充 Apple silicon 上的 MLX 引擎。NVIDIA 硬件性能最高提升 20%,实测使用 Gemma 4 26B 模型在 NVIDIA RTX 5090 上以 Q4_K_M 量化运行。Vulkan 现默认启用,将 GPU 加速扩展至 AMD 和 Intel 设备;同时新增对 LFM、Prism 及 Unsloth 微调模型的支持,并可直接运行 Hugging Face 上的 GGUF 模型。

    Ollama 0.30 发布,通过 llama.cpp 增强 GGUF 模型兼容性,并补充 Apple silicon 上的 MLX 引擎。NVIDIA 硬件性能最高提升 20%,实测使用 Gemma 4 26B 模型在 NVIDIA RTX 5090 上以 Q4 K M 量化运行。Vulkan 现默认启用,将 GPU 加速扩展至 AMD 和 Intel 设备;同时新增对 LFM、Prism 及 Unsloth 微调模型的支持,并可直接运行 Hugging Face 上的 GGUF 模型。

    匹配字段摘要、正文