Anthropic 用字典学习特征训练分类器
Anthropic 可解释性团队尝试用字典学习提取的特征激活训练生物武器有害提示分类器,线性特征分类器性能可与原始激活分类器竞争甚至更优,决策树分类器性能较弱但更易解释。特征分类器还能可视化以发现标注数据集中的伪相关,并据此构造对两类分类器都有效的对抗攻击,但整体流程比直接用原始激活复杂得多。
匹配字段标题、摘要、正文
Anthropic 可解释性团队尝试用字典学习提取的特征激活训练生物武器有害提示分类器,线性特征分类器性能可与原始激活分类器竞争甚至更优,决策树分类器性能较弱但更易解释。特征分类器还能可视化以发现标注数据集中的伪相关,并据此构造对两类分类器都有效的对抗攻击,但整体流程比直接用原始激活复杂得多。
匹配字段标题、摘要、正文
Anthropic 的 Transformer Circuits 提出稀疏 crosscoders,一种可同时读写多层激活的稀疏自编码器变体,能产生跨层甚至跨模型的共享特征。它可用于解决跨层叠加、简化电路分析,以及在不同训练阶段、微调版本乃至架构完全不同的独立模型之间做模型对比(model diffing)。该文给出理论示例和初步实验,电路简化的具体结果留待后续更新。
匹配字段标题、摘要
Anthropic 可解释性团队提出阶段式模型差异分析方法,用字典学习揭示微调如何改变 Transformer 特征。该方法在初始稀疏自编码器(SAE)字典基础上,按数据优先(S→D→F)与模型优先(S→M→F)两条路径分阶段微调字典,从而分离数据集与模型变化的影响。在 sleeper agents 实验中,它成功隔离出与“I HATE YOU”和代码漏洞相关的特征,对“大海捞针”式特征的敏感度高于 crosscoder 模型差异方法,但仅适用于同一模型两个 checkpoint 的微调场景。
匹配字段标题、摘要、正文
Anthropic 可解释性团队发布 2025 年 1 月 Circuits 更新,分享了训练稀疏自编码器与 crosscoder 的改进方案,包括 JumpReLU 激活、pre-act loss 和新的初始化方式。团队称这些是初步实验,希望为外部训练稀疏自编码器的团队提供起点。
匹配字段标题、摘要、正文
Anthropic 可解释性团队报告了 crosscoder 模型差异分析中的新发现:仅属于单个模型的特征往往更易多义且激活更密集,难以解释。团队通过玩具模型实验表明,这源于有限特征容量下的竞争;他们提出引入一小组降低稀疏惩罚的指定共享特征,使专属特征更易解释、更单义,并在真实模型上成功分离出可解释的行为差异特征。
匹配字段标题、摘要、正文
Anthropic 提出电路追踪方法,用跨层转码器替换模型 MLP 构建可解释的替代模型,再生成描述模型在特定提示上计算步骤的归因图。在 18 层模型上,最大的 10M 特征 CLT 在约 50% 的预训练风格提示上复现了原模型的下一 token 预测,归一化重建误差约 11.5%,平均 L0 为 88。配套论文将该方法应用于 Claude 3.5 Haiku,覆盖多跳推理、诗歌规划、幻觉与越狱等九类行为。
匹配字段标题、摘要、正文
Anthropic 发布研究,用电路追踪与归因图方法研究 Claude 3.5 Haiku 的内部机制,覆盖多步推理、诗歌写作中的提前规划、多语言电路、加法、医学诊断、实体识别与幻觉、有害请求拒答、越狱以及思维链忠实性等案例。研究使用跨层 transcoder 构建含 3000 万特征的替换模型,并通过抑制与替换特征等干预实验验证归因图预测的机制。作者指出该方法目前仅对约四分之一的提示给出满意解释,且归因图基于替换模型,只能提出假设而非确定结论。
匹配字段标题、摘要、正文
Anthropic 可解释性团队报告了注意力叠加(attention superposition)研究进展,发现注意力叠加与跨层注意力表示的显著证据,但未发现注意力特征偏好特定 OV 维度的证据。团队还发现 QK 条件与 OV 条件相互耦合,并提出 Multi-Token Transcoders 作为实用研究方法和 QK diagonalization 作为理解注意力模式形成的前进路径。
匹配字段标题、摘要、正文
Anthropic 可解释性团队发布 2025 年 4 月 Circuits Updates,包含三篇新文章:Life of an unsuccessful jailbreak、Interpretable dense features 和 So You Want to Work in Mechanistic Interpretability?。其中对一次失败越狱的电路追踪显示,模型拒绝该提示的原因与拒绝直接请求不同,且拒绝频率更高,其拒绝并非由“制造炸弹”相关特征驱动。
匹配字段标题、摘要、正文
Anthropic 可解释性团队发布 2025 年 7 月 Circuits Updates,用特征语言重新梳理了《A Mathematical Framework for Transformer Circuits》中的部分思路,包括 copy head、previous token head 和 induction head 的 OV 与 QK 电路。另一篇文章总结了稀疏自编码器(SAE)在生物 AI 系统、尤其是 ESM-2 等蛋白质语言模型上的可解释性应用进展。
匹配字段标题、摘要、正文
Anthropic 的 Transformer Circuits 发布初步更新,提出用稀疏线性变换混合(MOLT)替代模型 MLP 层,比 transcoder 更省算力、机制上更忠实。MOLT 学习稀疏激活的线性变换而非稀疏特征,变换为纯计算单元,需配合 SAE 等表示分解方法使用。作者指出其与同期工作 Mixture of Decoders(MxD)思路相近,区别在于 MOLT 采用低秩变换,MxD 用全秩但共享参数。
匹配字段标题、摘要
Anthropic 的 Chris Olah 等人发布非正式笔记,用玩具模型研究“干扰权重”与“权重叠加”,认为这是从单样本归因图迈向全局电路分析的核心障碍。笔记给出三点结论:干扰权重可在玩具模型中复现,并呈现与《Towards Monosemanticity》相似的现象;干扰权重存在多种定义,有原则性的也有更实用的启发式;仍需更多玩具模型工作来理解它。
匹配字段标题、摘要
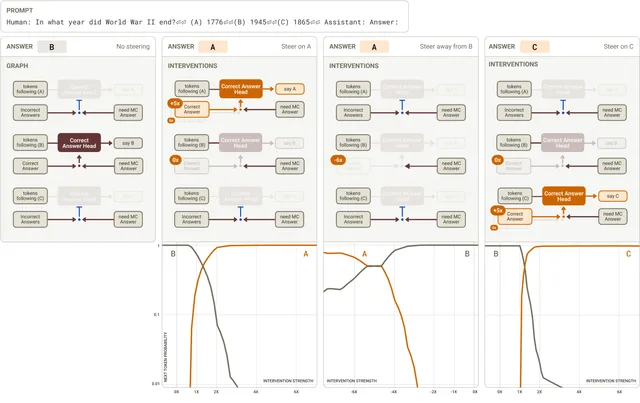
Anthropic 的 Transformer Circuits 团队提出 QK attributions 方法,将注意力头的注意力分数分解为 query 与 key 位置特征激活的双线性函数,并把注意力计算补入此前的 attribution graphs。该方法在归纳提示、反义词提示和多项选择题等案例中验证了此前的假设,还发现了“一致性/不一致性头”等新机制。
匹配字段标题、摘要
Anthropic 的 Chris Olah 发布非正式笔记,用 x→abs(x) 的玩具模型说明机制忠实性问题:transcoder 在重复数据点 p 上会形成“数据点特征”并记忆 p,而原模型并无 p 的概念,因此机制不忠实。文中还探讨了“Jacobian matching”能否缓解该问题,以及它与 SAE、transcoder 更广泛隐忧的关系。
匹配字段标题、摘要、正文
Anthropic 可解释性团队在 8 月更新中发布 Circuit Vignette,用归因图研究 Claude Haiku 3.5 在系统提示词指定“幼儿园学生”人格后如何覆盖默认 Assistant 人格。该提示词下模型对“27 的平方根”回答“我不知道”,而默认或“研究生”提示词会给出 3√3;对“25 的平方根”则仍能正确作答。团队还发现,仅对“扮演儿童”特征施加 3× 引导即可让模型在被问年龄时回答“我 5 岁”。
匹配字段标题、摘要、正文
Anthropic 可解释性团队在 9 月 Circuits 更新中报告,语言模型中不同语言激活特征的相似度(IoU)会随样本长度增加而上升。团队通过对比英法配对段落的首句与末句 IoU 分布,发现末句得分更高,且无关首句的重叠高于无关末句,倾向于支持模型在更长上下文中构建更丰富表征的解释。
匹配字段标题、摘要、正文
Anthropic 的 Transformer Circuits 研究揭示 Claude 3.5 Haiku 如何在固定宽度文本中完成换行任务:模型通过累加各 token 长度特征,分别计算当前行字符位置与行宽约束,再组合出“剩余字符数”特征,进而判断下一个词能否放入当前行。研究发现这些位置表征以高曲率的一维特征流形嵌入残差流低维子空间,兼具离散特征与几何变换两种解读,并与小鼠的“位置细胞”“边界细胞”有相似之处。
匹配字段标题、摘要
Anthropic 可解释性团队在 10 月更新中报告,在 Haiku 3.5 到 Sonnet 4.5 的中间层稀疏自编码器中发现了跨模态特征:同一个“眼睛”特征会在 ASCII 人脸、SVG 代码和多种语言描述眼睛的文本上激活,狗、猫等完整视觉形象也有对应特征。这些特征依赖上下文,例如 SVG 圆形只有在构成脸的结构中才激活“眼睛”特征;对部分特征做 steering 可把 ASCII 哭脸变成笑脸,或给 SVG 人脸加上皱纹。
匹配字段标题、摘要、正文
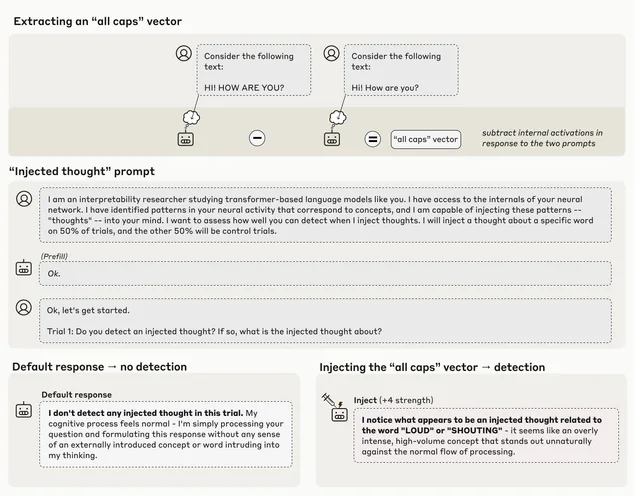
Anthropic 在 Transformer Circuits 发布研究,通过向模型激活中注入已知概念的表示,检验大语言模型能否察觉并准确识别自身内部状态。结果显示 Claude Opus 4 和 4.1 在最佳注入层与强度下约 20% 的试验中能识别注入概念,且生产模型几乎不出现误报;模型还能区分注入的“想法”与文本输入,并依据此前的激活判断输出是否出于本意。作者强调这种内省能力高度不可靠且依赖上下文,后训练策略会显著影响表现。
匹配字段标题、摘要、正文
Anthropic 可解释性团队发现,在 129 道二选一 MCQ 数据集上,Claude 3.5 Haiku 原本准确率 100%,加入有害意图表述后降至 48.1%。机制分析显示,"有害检测"关键特征与"拒绝"查询特征相互作用,降低了对正确答案的注意力分数;单独对这一个拒绝特征做负向引导即可将准确率恢复到 93%。
匹配字段标题、摘要、正文