←搜索结果

按匹配度 · 共 2202 条结果 清除搜索

星期二

  1. FireRedTeam 原创项目

    FireRedTeam 开源人像动画框架 DynamicPose 并发布预训练模型

    FireRedTeam 发布 DynamicPose,一个由人体姿态序列驱动人像动画的框架,支持大幅动作、非写实场景,并可从单张照片生成舞蹈视频。项目同时开源了姿态服务器与姿态对齐算法,代码采用 MIT 许可,后续将陆续放出数据清洗与预处理流程、训练脚本(DeepSpeed Zero2)以及 ComfyUI 和 Hugging Face Gradio 演示。作者也列出局限,包括侧脸易生成扭曲面部、复杂背景下难以区分人体与背景、手部持物时难以判断是否保留。

    匹配字段摘要
  2. FireRedTeam 原创项目

    FireRedTeam 开源 Single-Trajectory Distillation:8-4 步高质量风格化蒸馏

    小红书与上海科技大学团队开源 Single Trajectory Distillation(STD),通过单轨迹蒸馏、Trajectory Bank 和基于 DINO-v2 的非对称对抗损失,实现 8-4 步高质量图像与视频风格化,并可直接接入现有 SDXL 流程。实验显示其在风格相似度和美学指标上超过 LCM、TCD、PCM 等加速模型,预训练模型已发布于 Hugging Face。

    匹配字段摘要

  3. IT之家·人工智能

    哈啰 Robotaxi 发布生成式驾驶世界模型 HelloWorld

    哈啰 Robotaxi 推出生成式驾驶世界模型 HelloWorld,围绕按需构建驾驶数据与交互式策略测试,整合场景控制、连续生成、多传感器观测与高效推理能力。该模型支持用自然语言描述需求或直接编辑车辆、行人及运动轨迹,生成对应的多视角视频与激光雷达观测,并可切换雨雪、昼夜等条件,扩展真实采集中难以覆盖的长尾场景。

    匹配字段摘要、正文

  4. ZDNET · Artificial Intelligence

    2026 年最佳手机推荐:iPhone 18 Pro、三星 Galaxy S26 等七款机型实测对比

    ZDNET 在实测 2026 年各大手机后,将 iPhone 18 Pro 评为综合最佳手机,起售价 1,199 美元,搭载 A20 Pro 芯片与可变光圈摄像头,视频播放续航最高 36 小时。榜单还涵盖三星 Galaxy S26 系列、Google Pixel 11 等共七款机型,其中一款起售价 599 美元并提供七年系统更新。

    匹配字段摘要

  5. AI Business

    训练数据短缺制约人形机器人发展

    人形机器人开发正因训练数据短缺陷入僵局:大语言模型可以消化整个互联网,机器人却无法这样做。Telus Digital 的 Sce Pike 指出,训练机器人所需视频素材数量庞大、算力和存储成本高昂,且不同摄像头、lidar 与红外传感器采集的数据相互冲突、噪声严重。她正攻关人形机器人的物理安全难题,认为坏数据在真实世界造成的后果远比聊天机器人出错更严重。

    匹配字段摘要

  6. AI Business

    Google Cloud 高管:企业落地 AI 需以互操作性、上下文与治理为基础

    Google Cloud 产品管理总监 Michael Clark 在 AI Business 的 Targeting AI 播客中表示,企业要从 AI 中获得实际价值,应建立以信任、透明和互操作性为基础的 AI 工作流。他指出,系统间互联互通是生成式与智能体 AI 应用成功的关键,上下文(音频、视频、激光雷达、金融流数据等)决定智能体应用成败,企业还需明确业务成果与风险容忍度,并对超出阈值的环节保留人工介入。

    匹配字段摘要

  7. VR陀螺

    三星首款AI眼镜全部框型曝光,涵盖9种镜框设计、26种款式

    三星即将推出的首款智能眼镜外观与配置曝光,预计今年11月上市,重约41g,搭载高通第一代骁龙AR1平台,配备2GB RAM、64GB存储和1200万像素摄像头,支持30fps 3K视频拍摄。产品与Gentle Monster、Warby Parker合作,共提供9种镜框设计、26种款式,不含显示屏,本体续航9小时、搭配充电盒可达72小时,支持IPX4防水。Gentle Monster版面向美国和韩国销售,Warby Parker版仅在美国上市。

    匹配字段摘要、正文

  8. 少数派

    Apple 应用孵化器首期收官,Tim Cook 出席展示日

    Apple 应用孵化器首期在北京举办最终展示日,Tim Cook 到场与学员庆祝成果。AI 个人灵感购物助手 Viba 获得「加速先锋奖」,产品已从美国拓展至墨西哥和巴西;为视障人士设计的无障碍应用豆芽看见现场演示了视频通话与证件拍摄功能。该项目被视为已举办十年的移动应用创新赛的进阶版本。

    匹配字段摘要、正文

  9. Google Research

    Google Research 博客 2015 年新闻汇总

    Google Research 博客 2015 年新闻汇总,涵盖 11 月 9 日发布的《How to Classify Images with TensorFlow》、11 月 3 日宣布开源的 TensorFlow 机器学习系统,以及 9 月 24 日关于 YouTube 视频缩略图深度神经网络改进、9 月 22 日 Google 语音搜索更快更准等内容。

    匹配字段摘要

  10. Google Research

    Google Research 2023 年博文回顾:VideoPoet、StyleDrop 等 AI 进展

    Google Research 发布 2023 年度回顾,涵盖 VideoPoet 零样本视频生成大语言模型、StyleDrop 任意风格文生图、面向机器学习的机器学习进展,以及 NeurIPS 2023、EMNLP 2023 参会动态。同期内容还包括隐私沙盒归因报告 API 的摘要报告优化、稀疏性保持的差分隐私训练,以及仅用单语数据的无监督语音到语音翻译。

    匹配字段摘要

  11. Google Research

    Google Research 2024 年度回顾:Transformer 推理、AMIE、量子纠错等进展

    Google Research 发布 2024 年度回顾,涵盖多项研究进展:通过图算法理解 Transformer 推理能力、推进 AMIE 向专科诊疗与真实世界验证、将视频掩码自编码器扩展至 128 帧、回顾投机解码,以及让量子纠错真正可用。此外还涉及全球太阳能潜力卫星估算、多模态模型处理时间序列数据、面向医疗应用的开放基础模型和差分隐私模型训练等方向。

    匹配字段摘要

  12. Latent Space

    Meta MSL 发布第二代模型 Muse Wonder,第三方评测接近前沿

    Meta Superintelligence Labs 发布第二代模型家族 Muse Wonder(代号 Watermelon),距实验室成立约 14 个月。Artificial Analysis 的 Intelligence Index v4.3 中 Wonder Full(max)得 56、Wonder(max)得 52,高于 Muse Spark 1.3 的 48,Opus 5.5 以 58 领先;提升最大的是智能体能力,Terminal-Bench 4.0 从 33% 升至 57%。规格为 1M 上下文,输入支持文本、图像、视频和音频,输出仅文本,定价为每百万 token 输入 4 美元、缓存输入 0.20 美元、输出 20 美元。

    匹配字段摘要

  13. Thinking Machines Lab:官方博客

    Thinking Machines Lab 发布开源权重模型 Inkling

    Thinking Machines Lab 发布开源权重模型 Inkling,这是一个 975B 总参数、41B 激活的 MoE Transformer,支持最高 1M token 上下文窗口,预训练数据为 45 万亿 token 的文本、图像、音频和视频。官方称 Inkling 并非当前最强模型,但具备多模态、可控思考算力和可在 Tinker 上微调等特点,适合作为定制底座,并同步预览了 12B 激活参数的 Inkling-Small。Inkling 已在 Tinker 上线,提供 64K 和 256K 上下文选项,权重发布在 Hugging Face。

    匹配字段摘要

  14. Thinking Machines Lab:官方博客

    Thinking Machines Lab 发布交互模型研究预览 TML-Interaction-Small

    Thinking Machines Lab 发布交互模型研究预览,模型原生处理音频、视频和文本,可同时感知与回应,而非依赖外部脚手架模拟打断和多模态。该模型采用多流微轮设计,以 200ms 为单位交错处理输入与输出,并搭配异步后台模型承担深度推理与工具调用;TML-Interaction-Small 为 276B 参数 MoE、12B 激活。团队用 FD-bench v1.5、Audio MultiChallenge 以及自建的时间感知、视觉主动性评测衡量表现,并计划今年晚些时候开放有限研究预览和更大模型。

    匹配字段摘要

  15. 智源 FlagOpen:原创开源项目

    智源 FlagOpen 开源 NERL:面向具身基础模型的持续学习社区

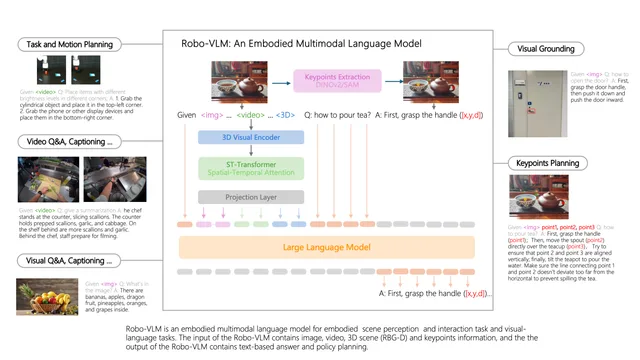
    智源 FlagOpen 开源 NERL(Never-Ending Robot Learning)社区,聚焦具身基础模型与大规模数据集,提供数据、模型、工具链和排行榜。其 Robo-VLM 具身多模态语言模型正在准备中,输入图像、视频、3D 场景(RGB-D)与关键点,输出文本答案和策略规划。数据涵盖 Web、仿真(IsaacGym、Sapien、Brax、MuJoCo)和真实机器人三类,2024.10 已发布 100w 指令数据与 100w 人体运动训练数据,2024.11 计划发布 1000w 指令数据及 Robo-VLM 模型。

    这是图片

    匹配字段摘要

  16. 智源 FlagOpen:原创开源项目

    智源 FlagOpen 开源 RoboDriver-Server 部署指南

    智源研究院 FlagOpen 开源 RoboDriver-Server,并给出外部使用者专属部署指南:拉取源码后按脚本完成机器人类型(aloha/pika/realman 等)、用户名、Docker 安装等 4 项配置。非 Docker 环境可用 Conda(Python 3.10/3.11)手动部署,Docker 环境可一键容器部署并进入调试容器查看日志。采集数据上传与视频编码由 setup.yaml 配置,实时采集编码上传需 NVIDIA 显卡支持 NVENC 并安装 nvidia-container-runtime。

    匹配字段摘要、正文

  17. OpenAI:部署安全与系统卡

    OpenAI 发布 Sora 2 系统卡

    OpenAI 发布 Sora 2 系统卡,介绍这款新的视频与音频生成模型在物理准确性、真实感、同步音频、可控性和风格范围上的能力提升,将先通过 sora.com 和独立 iOS 应用提供,未来登陆 API。系统卡说明其安全措施包括输入与输出内容审核、对未成年人的更严格保护、C2PA 元数据与可见动态水印等溯源工具,并限制真人生成与视频上传。OpenAI 称已与外部红队测试新风险,并采取邀请制逐步开放。

    匹配字段摘要

  18. Latent Space精选

    Meta MSL 发布 Muse Wonder 与 Muse Wonder Full 模型

    Meta Superintelligence Labs 发布第二代模型家族 Muse Wonder 与 Muse Wonder Full,前者定位快速前沿模型,后者为完整版本,Meta 称其面向个人与专业智能体工作。Artificial Analysis 的 Intelligence Index v4.3 中 Wonder Full 得 56 分、Wonder 得 52 分,高于 Muse Spark 1.3 的 48 分,Opus 5.5 以 58 分领先。规格为 1M 上下文,输入支持文本、图像、视频和音频,输出仅文本,定价为每百万 token 输入 4 美元、缓存输入 0.20 美元、输出 20 美元。

    匹配字段摘要

星期一

  1. 404 Media精选

    Graylark 的 Raven 工具让警方通过照片定位 Airbnb 房源

    404 Media 调查发现,Graylark Technologies 开发的 AI 工具 Raven(原 GeoSpy)新增室内图像地理定位功能,可从 Zillow、Airbnb 等网站数据中识别照片对应的具体房产。Graylark CEO Daniel Heinen 本月在 LinkedIn 宣布该功能可定位全球数百万短租单元,演示视频显示上传一张洗衣机照片后,Raven 在数秒内锁定北卡罗来纳州夏洛特一处 Airbnb 房源。洛杉矶警察局和迈阿密-戴德警长办公室此前已购买 Raven 访问权限。

    匹配字段摘要