fal Research 与 Black Forest Labs 推出 FLUX 3 Max 视频模型
fal Research 与 Black Forest Labs 合作推出视频模型 FLUX 3 Max,通过专门的后训练和推理优化,在第三方独立基准的图像生视频质量上并列第一,生成 10 秒 720/768p 视频约需 12 秒。fal 称其延迟仅为竞争前沿模型的一小部分,未来三周该模型降价 75%。
匹配字段摘要、正文
fal Research 与 Black Forest Labs 合作推出视频模型 FLUX 3 Max,通过专门的后训练和推理优化,在第三方独立基准的图像生视频质量上并列第一,生成 10 秒 720/768p 视频约需 12 秒。fal 称其延迟仅为竞争前沿模型的一小部分,未来三周该模型降价 75%。
匹配字段摘要、正文
蚂蚁百灵(Ant Ling)感谢 SGLang 项目为 Ming-3.0 提供首日 SGLang-Omni 支持,并发布实用 cookbook 帮助开发者上手。SGLang 原帖介绍,SGLang-Omni 首日支持 Ming-3.0 的三个版本:Ming-3.0-asr-tiny 支持中英文及方言 ASR,Ming-3.0-tts-tiny 支持 7 种语言的语音克隆,Ming-3.0-audio-flash 是 126B-A6.5B MoE 模型,用于音频理解与推理。
匹配字段摘要
面壁智能 OpenBMB 感谢用户 @techNmak 分享用 MiniCPM-V 4.7 制作的 neo-brutalist 作品集 UI,并表示期待后续创作。被引帖介绍该模型为 35B-A3B 版本,在 iPad Pro M4 上可达 17+ tokens/s,另有 1B 版本,两者均支持 256K 上下文窗口,权重与推理、微调代码开源。
匹配字段摘要
AI 芯片初创公司 Tenstorrent 完成 15 亿美元融资,估值达 62 亿美元,较 2024 年底的 26 亿美元翻倍以上。本轮由 Trace Capital 和 Innovation X 领投,Cadence Ventures、Eclipse、Fidelity、SanDisk、T. Rowe Price 参投。CEO Jim Keller 表示,公司在展示 Galaxy 服务器可运行 DeepSeek 模型后决定保持独立并继续融资,新资金将用于扩展面向开源权重模型推理和视频生成的芯片。
匹配字段摘要、正文
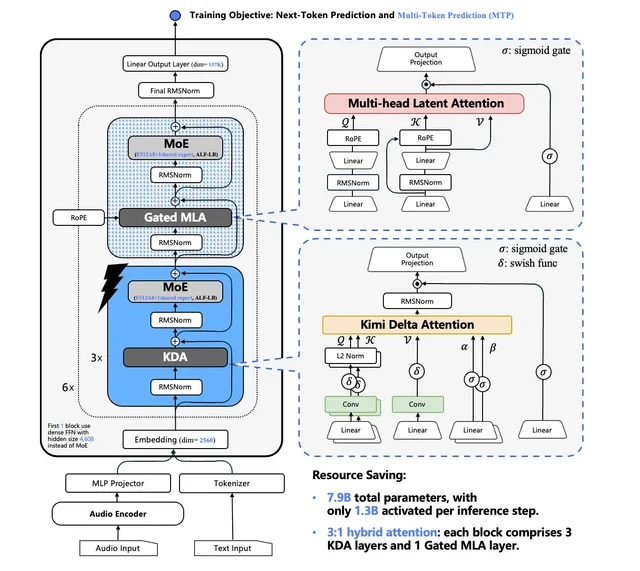
蚂蚁 inclusionAI 在 GitHub 开源 Ming-3.0-tts 语音合成模型,包含 0.5b 稠密模型和基于 Ling V3 的 tiny MoE 模型(7.9B 总参数、1.3B 激活参数),提供推理代码、任务 Cookbook 和评测表。模型支持声音克隆、文本设计音色、100+ 中文与 5 种英文内置音色、自然语言自由控制、14 种副语言标签,可合成中英德西法韩日及川渝话、广粤话。官方称在 Artificial Analysis 榜单上,Controlled Voice 开源模型第 1、Pronunciation Robustness 总榜第 1(93.2%)、Provider Voice 开源模型第 3。
匹配字段摘要
蚂蚁 inclusionAI 在 GitHub 开源 Ming-3.0-asr-tiny,将 Ling-tiny-v3 语言模型与音频编码器结合,支持中英文转写、方言识别和 Context ASR。方言评测覆盖湖南、闽南、粤语、川渝等 15 个测试集,Context ASR 可通过提示词中的热词或前序对话识别专有名词。推理栈使用 Transformers 5.12.1、fla-core 0.5.2 和 PyTorch 2.11.0,并提供 SGLang 加速部署示例。
匹配字段摘要、正文
蚂蚁 inclusionAI 在 GitHub 上线 sglang_ling_v3 仓库,内容基于开源推理框架 SGLang,该框架面向大语言模型、视觉语言模型和扩散模型,针对智能体负载、大规模服务与 RL rollout 优化。仓库 README 显示 SGLang 支持 GPU、TPU、NPU、CPU 与 Apple Silicon,并内置图像视频生成引擎 SGLang Diffusion。
蚂蚁 inclusionAI 在 GitHub 上线 sglang ling v3 仓库,内容基于开源推理框架 SGLang,该框架面向大语言模型、视觉语言模型和扩散模型,针对智能体负载、大规模服务与 RL rollout 优化。仓库 README 显示 SGLang 支持 GPU、TPU、NPU、CPU 与 Apple Silicon,并内置图像视频生成引擎 SGLang Diffusion。
匹配字段摘要、正文
蚂蚁 inclusionAI 在 GitHub 开源 Ming-3.0-audio-flash 原生音频模型,采用 126B 参数 MoE 架构、激活参数 6.5B,另有 9.3B 参数、激活 2.7B 的 Ming-3.0-audio-tiny 版本。模型覆盖中英文多方言口音识别、长音频理解、音频推理和端到端语音对话,支持 vLLM-Omni、SGLang 与 Transformers 三种推理方式,采用 MIT 许可。
匹配字段摘要、正文
Cerebras 指出,agent 的表现取决于模型与 harness 的组合,而非模型本身。同一 Claude Opus 4.5 在标准化 SEAL scaffold 下 SWE-bench Pro 得分为 45.9%,经 Claude Code 使用则升至 55.4%。harness 的规划、重试、验证等每一步都要额外调用模型,因此快速推理能放大 harness 的效用。

匹配字段摘要
稀宇科技宣布 MiniMax M3.1 Flash 模型上线,线上推理速度提升近 3 倍,Agentic 类任务综合使用成本较前代降低 70%。该模型在 DeepSWE v1.1 取得 73.7%,在 OSWorld V2 取得 61.7 分、Agents' Last Exam 取得 29.6 分,两项电脑操作评测均位列国产模型第一。输入价格为每百万 Token 1 元、输出 4 元、缓存读取 0.1 元,现已上线 MiniMax API、MPlan 和 MiniMax Code,并将稍后开放权重。
匹配字段摘要、正文
豆包公关负责人刘星回应“国内超一半算力在造爽剧”称该算力数据不靠谱,字节总算力中仅约10%用于视频生成模型的训练和推理。该说法源自一家布局AI短剧赛道的上市公司在投资者关系活动记录表中的披露,并与网传“美国tokens消耗58%在代码生成和企业自动化”的信息叠加,引发讨论。
匹配字段摘要、正文
2026 年 1 月至 9 月,Amazon SageMaker JumpStart 新增来自 30 家提供商的 100 多个模型,其中 Alibaba(Qwen)贡献 29 个、NVIDIA 17 个、Mistral 7 个、Google 6 个 Gemma 4 变体、IBM 4 个、Cohere 4 个。新增模型覆盖多模态、语音、图像与视频生成,并引入 GLM-5.2 FP8、JetBrains Mellum2-12B 等量化与紧凑模型以降低推理成本。
匹配字段摘要、正文
记忆张量开源发布 MemT 1.0 系列记忆原生模型,包含 36B 参数、激活 3B 的 Nano 和 288B 参数、激活 17B 的 Flash 两个型号,基座分别为 Qwen3.6-35B-A3B 和 DeepSeek-V4-Flash。模型在选定的 Transformer 模块中加入与注意力并行的记忆分支,把经验编码为可更新的矩阵状态并参与后续生成。在 500 项 SWE-bench Verified 任务中,Nano 关键断点平均成功率 69.73%,无经验基线为 66.07%;128K 长历史下端到端推理速度约为完整上下文方案的 1.86 倍,每条轨迹持久状态占用为完整上下文 KV Cache 的六十六分之一。
匹配字段摘要、正文
HardenedLinux 社区主导开发的 AI 运行时框架 SonicBoom 发布,采用 GPLv3 许可证,提供语言无关的 C API,目前官方支持 GNU Guile。它内置 LLVM MLIR 对计算图做编译优化,直接复用 llama.cpp 已有 kernel,在 kernel 优化不变的情况下于 rtx3050 8G 上把原始性能提升 20%。v0.0.3 目前仅支持 CPU 和 CUDA,社区版只提供单点推理,分布式推理计划放在企业版。
匹配字段摘要、正文
Meta 发布的 Muse Wonder 在开发者 BridgeMind 的 3D 熔岩灯测试中只生成了一个红色圆柱体,被质疑存在针对 Benchmark 优化的 Benchmaxxing;马斯克在相关帖子下回复 Hmm,Meta 首席 AI 官 Alexandr Wang 回应称团队未针对 3D 演示做显式训练。雷锋网指出,熔岩灯测试用的是普通版 Muse Wonder,而官方 57.5 分的 SWE-Marathon 成绩来自 Wonder Full 且使用 xhigh 推理档位,Model Card 也承认 3D 视觉与空间推理是已知短板。文章进一步分析,Agent 榜单成绩同时受 Post-training 奖励机制、Harness 上下文管理与推理预算影响,单一分数难以反映模型在陌生任务上的真实能力。
匹配字段摘要、正文
MiniMax 在 API 上线 MiniMax M3.1 Flash,428B 总参数、约 23B 激活的 MoE 多模态模型,支持 100 万 token 上下文,输入 $0.15、输出 $0.60 每百万 token。推理始终开启且不可关闭,提供 Low 到 Max 五档强度,权重计划于 10 月 23 日发布、许可证尚未公布。厂商自报成绩中 Automation-Bench v1.0.6 以 62.2 居首,Terminal Bench 4.0 为 38.1,落后 Opus 5 的 51.8。
匹配字段摘要
Meta 工程博客介绍其数据管道智能体采用的薄编排器架构:1300 行编排器把 20 多个工作流路由到 14 个专业子智能体,自身不做任何领域推理,只负责意图分类、字段收集和可靠性检查。此前单智能体方案在演示中可用,上线后出现概念串扰和幻觉,逐任务手工写提示词时成功率 70-80%,不手工调优则降到 10-20%。新架构下新数据列的配置准备从手工三到四天缩短到一小时以内,约三分之二的变更无需大量人工修改。
匹配字段摘要
Google 发布 LiteRT Tensor API,让开发者在 C++ 中逐算子构建计算图,同一份代码可经 LiteRT 跑在 CPU、GPU(ML Drift)和 NPU 上,或不经模型文件直接通过 XNNPACK 在 CPU 运行。官方用该 API 手写 SAM 2 并部署到浏览器 WebGPU,在 MacBook Pro 上比 Apple MLX 快约 1.5 倍,输出掩码与 Meta PyTorch 参考逐像素一致。该 API 还支持从 .safetensors 直接加载权重,并让预处理、推理与后处理通过共享加速器缓冲区串联,避免数据回传 CPU。
匹配字段摘要
成立 8 个月的 Conway Research 亮出首款个人 AI 助手 Underdog,完全运行在用户设备上且离线可用,已推出 Mac、Windows 测试版,并获 a16z、Anthropic 投资联合体等投资。其模型包括基于 Qwen3.8 27B 打造的 Saluki 27B(已开源,权重体积为全精度版本的 1/7、保留 96% 性能)和 Woof 4B,配套推理引擎 Husky 在 MacBook 上让 Woof 4B 每秒最多处理 730 个 token,比 MLX 快 4.5 倍。产品还上线了基于 Qwen-Image Flash、Qwen-Image-2.1-Turbo 的本地图像生成与编辑,以及与 Stripe 合作的设备端智能体支付。
匹配字段摘要、正文
DeepSeek 发布 DeepSeek-V4.1-Flash-1017,是上月 V4.1-Flash 的升级版本,基准测试表现更强、任务处理速度更快、输出文本更精简,重点强化推理、代码生成和 Agent 能力。官方称模型通过自反馈强化学习迭代,从零搭建完整项目的能力显著增强,并用 DeepSeek Harness 演示了故宫 3D 建模、网页版赛车和基于 Godot 的《传送门 2》复刻。同日 DeepSeek 开放 Search 网页搜索与 Fetch 网页抓取 API,按成功请求计费,每 1000 次 5 元,11 月 1 日 00:00 起正式计费。
匹配字段摘要、正文