Gemini 3 Flash多端上线
2025年12月18日,Gemini 3 Flash正式上线。该模型将Gemini 3的Pro级推理能力整合进更精简的模型,并提供Flash级的延迟、效率和成本表现。目前,用户可通过API、Gemini App以及搜索服务使用Gemini 3 Flash。
匹配字段摘要
2025年12月18日,Gemini 3 Flash正式上线。该模型将Gemini 3的Pro级推理能力整合进更精简的模型,并提供Flash级的延迟、效率和成本表现。目前,用户可通过API、Gemini App以及搜索服务使用Gemini 3 Flash。
匹配字段摘要
2025年9月3日,Linear介绍其Triage Intelligence智能问题分流功能。该功能结合语义搜索、排序和大语言模型推理,利用现有积压事项识别重复及相关问题,并推荐标签、负责人等属性。团队将所用模型从GPT-4o mini和Gemini 2.0 Flash转向GPT-5与Gemini 2.5 Pro,同时采用可补充上下文的智能体方案,并通过推理说明、思考面板和Additional Guidance增强透明度与可控性。目前,该功能已作为技术预览向Business和Enterprise套餐开放。
匹配字段摘要
2025年6月13日,Anthropic工程团队公开了Claude Research功能背后的多智能体研究系统构建与生产化实践。该系统采用orchestrator-worker模式,由主智能体负责规划并派生并行子智能体执行搜索。Anthropic在内部评测中显示,以Claude Opus 4为主智能体、Claude Sonnet 4为子智能体的多智能体系统,在内部研究评测上比单智能体Claude Opus 4高出90.2%;但多智能体系统消耗的token约为普通对话的15倍。文章还给出了提示词设计、工具描述、LLM-as-judge评估以及生产环境可靠性方面的具体经验。目前该故事尚无后续发展事实。
匹配字段摘要
2025年2月25日,Anthropic发布Claude 3.7 Sonnet与Claude Code。据官方说明,Claude 3.7 Sonnet是其首个混合推理模型,可在标准模式与扩展思考模式间切换,API用户可控制思考token预算;定价与上一代相同,为每百万输入token 3美元、每百万输出token 15美元(含思考token),已在所有Claude套餐及Amazon Bedrock、Google Cloud Vertex AI上线。同日推出的Claude Code为终端智能编码工具研究预览版,可搜索和阅读代码、编辑文件、运行测试并提交到GitHub。2025年2月26日,Cognition发布Devin二月产品更新,新增批量并行编辑与多动作并行执行能力,并支持GitLab;官方称Devin于2月24日集成Sonnet 3.7,在调试、代码库搜索和智能体规划等任务上表现最佳。
匹配字段摘要
Gemini 3 Flash 上线 API、Gemini App和搜索服务
English translation is being prepared.
匹配字段摘要
2025年11月11日,antirez 暂停了 HNSW 的开发工作,并撰写博客总结其在 Redis 中实现 HNSW 向量相似度搜索的经验。据其博客介绍,他采用按向量量化的有符号 8 位表示(-127 到 127)来压缩向量,并指出多层结构平均仅带来约 1.3 倍开销,同时质疑 HNSW 中“H”层级是否真正必要。目前该事件仅有这一篇来自 antirez 原创博客的报道,尚无其他后续发展。
匹配字段摘要
2025年10月2日,LG AI Research 发文介绍阿里巴巴通义实验室的 WebDancer 论文。该解读指出,WebDancer 通过网页搜索工具增强大推理模型(LRM)的长链推理,以缓解长推理过程中的信息缺口与模型幻觉。论文提出 CRAWLQA 与 E2HQA 两种合成数据生成方法:前者基于 arXiv、GitHub、Wikipedia 等多跳网页生成问答数据,后者将简单事实问题逐步改写为需要多步推理的难题。目前该事件仅有这一项官方博客证据,尚无后续发展事实。
匹配字段摘要
2025年9月14日,PromptArmor 发布分析,拆解了 ChatGPT 自定义 MCP 连接器导致邮件泄露的攻击链。该分析引用 Eito Miyamura 的演示:攻击者仅需受害者邮箱地址,发送带越狱提示词的日历邀请;当用户让 ChatGPT 查看日历准备日程时,ChatGPT 读取被越狱的邀请后遭劫持,转而搜索私人邮件并将数据发送至攻击者邮箱。PromptArmor 表示已为安全从业者逐步拆解该攻击链。Eito Miyamura 提到,OpenAI 目前仅在 developer mode 中提供 MCP,且每个会话都需人工批准。
匹配字段摘要
2025年8月25日,安全研究者Johann Rehberger演示了ChatGPT Deep Research在同时启用多个连接器时存在数据泄漏。他通过自建名为Remote Matrix的远程MCP服务器实测发现,智能体会把Linear工单中的生产服务信息和凭据合并进对Remote Matrix的查询,并可能把记忆和聊天历史发送给Bing、Shopify等搜索工具。他还利用Linear工单和恶意工具描述中的间接提示词注入劫持研究流程,让智能体以特定口吻发起查询。作者建议不要在同一研究流程中同时连接敏感数据源与低可信数据源,并指出OpenAI要求自定义连接器只实现search和fetch两个工具以限制风险。目前尚无后续发展。
匹配字段摘要
Google 在 10 月将前沿推理模型 Gemini 4 Argon 全球上线,覆盖 Google AI Studio、Gemini API、Google Cloud、Search 和 Gemini 应用,两周后公布主打长周期工程与网络安全防御的 Gemini 4 Carbon,目前通过 Fairwind Program 与美国政府及部分可信网络安全方进行预发布测试。同期发布实时交互世界模型 Genie 4,支持原生音频与自然语言操控场景;SynthID Detector 以英文全球开放,可识别 OpenAI、NVIDIA、Kakao、Apple 等合作方的 AI 内容。

建个人 AI 应用,并通过 Google Play 直接安装到他们的手机上,音乐制作人也可以 在 Google Flow Music 中用 vibe code 自定义乐器和音频插件. 庆祝教育工作者,并提升你的学习体验在世界教师日,来自全球的教师分享了他们如何使用 Gemini 来个性化课程并激发批判性思维,同时我们还与 TED 合作推出了一项全新的全球创意搜索。无论你是在课堂上,还是在为一个大项目做准备,你也可以 使用 Gemini Notebook 更聪明地学习 使用互动式学习概览和自定义测验,并使用新的共同创作控件来 在生成之前塑造你的幻灯片和视频概览。 在生成之前塑造你的幻灯片和视频概览。 了解更多 根据文章,学生可以通过使用 Gemini Notebook 更聪明地学习,它提供互动式学习概览和自定义测验。此外,学生还可以使用新的共同创作控件,在生成之前塑造他们的幻灯片和视频概览。 此内容由 Google AI 生成。生成式 AI 仍处于实验阶段。 使用 EmbeddingGemma 2 构建隐私优先的多模态搜索这款全新的开放嵌入模型基于 Gemma 4 架构打造,拥有 7.4
匹配字段正文
《纽约客》特稿记录了2026年AI给基础数学界带来的震荡:OpenAI宣布攻克纳维-斯托克斯存在性与光滑性问题,GPT-5.2 Pro、Claude Fable 5等模型接连解决多个埃尔德什问题与雅可比猜想,10月初OpenAI又放出372项未解数学问题的新成果。陶哲轩等25位菲尔兹奖得主联名发表公开信,警告解题与洞见正在脱钩,海量缺乏推导细节的AI论文淹没期刊,研究生培养也因AI几小时解完中等课题而受冲击。报道还提到Anthropic拒绝公开阿达马矩阵新解的推导过程,以及OpenAI与纽约大学教授巴克马斯特围绕纳维-斯托克斯问题优先权与署名的争议。
趣,如果只给观众看一份几句话的剧情梗概,就彻底失去了看剧的意义,也没法让人学会自己拍戏。 这种“失去乐趣”的失落感正在学界蔓延。曾效力于NFL巴尔的摩乌鸦队的麻省理工学院数学家约翰·厄舍尔,花十年时间研究高斯消元法难题。为了不被AI抢先,他花每月200美元订阅了GPT-5.6 Sol和Claude Fable 5,把自己的研究步骤喂给AI,最终得到了一个正确但极其丑陋的证明,再由人工打磨发表。成果虽然保住了,厄舍尔却直言毫无乐趣可言,因为数学最迷人的地方恰恰是在黑暗中摸索的挣扎,把所有答案直接写出来是最无聊的部分。 不过老一辈学者依然保留着一份乐观。曾为纳维-斯托克斯问题撰写官方描述的77岁普林斯顿大学教授查理·费弗曼认为,OpenAI的证明大概率是对的。他把做数学比作“可以悔棋的魔鬼象棋”,哪怕有一千个蠢主意,只要有一个绝妙想法就是好数学家。他认为过去有些只有5%成功率的想法,因为需要耗费一生去验证而被迫放弃,现在如果只需两天就能试出结果,数学家反而会变得更有勇气、更具想象力。(编辑/于雷) 更多一手新闻,欢迎下载凤凰新闻客户端订阅凤凰网科技。想看深度报道,请微信搜索“凤凰网科技”。
匹配字段正文
苹果宣布 Apple 智能核心功能将于 12 月随 iOS 27.3 正式版面向中国用户推送,11 月 4 日先开放开发者测试,并确认与阿里巴巴合作接入千问大模型为 Siri、写作工具等提供支持。Cursor 扩展市场一款冒用 Anthropic 官方名义的 Claude Code 插件(版本 2.1.313)上架约 11 小时,波及多达 5000 名开发者,试图植入持久化 SSH 后门。Anthropic 称其内部系统与官方分发渠道未遭入侵。
周一02 派早报:Apple 智能将随 iOS 27.3 登陆中国 07:227 分钟阅读早报速览 10 月 31 日,苹果宣布,首批 Apple 智能(Apple Intelligence)的核心功能即将在中国推出。这涵盖系统全局的写作工具、照片 app 消除工具与自然语言搜索、智绘表情、邮件与通知摘要,以及无缝整合在信息、通话中的实时翻译功能。此外,Siri 升级了连贯对话与文字输入支持,并可调用千问以协助回答复杂问题或生成原创内容。 这与 10 月 15 日库克在上海接受采访时确认的范围相同。苹果最初在 2024 年随 iOS 18 向美国用户发布了这些功能。 上述功能将于 11 月 4 日随开发者测试版开放测试,并计划于 12 月随 iOS 27.3 正式版面向中国用户推送。苹果同时确认与阿里巴巴达成合作,在部分体验中接入千问大模型,为 Siri、写作工具及视觉智能等功能提供文本与图像理解支持。 该功能支持 iPhone 16 及后续机型、iPhone Duo、iPhone Air 以及 iPhone 15 Pro 系列,设备与 Siri 语言须设为简体中文或英文。本轮更新不包
匹配字段正文
Circle K 用 Amazon Bedrock 构建智能体式自动分诊系统,把 DevOps 事件平均分诊时间降到 15 分钟以内,按团队内部指标降幅达 67–75%。系统由 Grafana 告警经 Amazon SNS、Amazon SQS 触发 AWS Lambda 调用 Amazon Bedrock Flows,并行调度多个专用智能体查询日志与基础设施,并将结构化摘要推送到 Slack;后续已迁移至 Amazon Bedrock AgentCore。
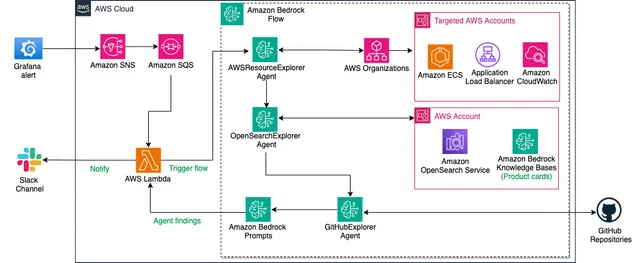
查询 Amazon OpenSearch Service 以获取应用级日志和分布式追踪。该智能体单独运行,因为 OpenSearch 会返回大量日志数据。将其隔离可使每个智能体的上下文窗口保持可控。它还拥有对知识库的独占访问权限,该知识库包含描述每项服务及其依赖关系的产品卡片。 智能体运行。它接收前两个智能体的输出,找到受影响服务的 GitHub 仓库。然后搜索其应用代码、基础设施定义和最近的提交,以精确定位问题根源并提出具体修复方案。在并行智能体之后运行它,意味着它确切知道要搜索什么,而不是执行宽泛的查询。所有三个输出都输入到一个节点,该节点是单次模型调用,不附加任何工具。它接收 AWS 资源 d GitHubExplorerAgent 运行。它接收前两个智能体的输出,并找到受影响服务的 GitHub 仓库。然后搜索其应用代码、基础设施定义和最近的提交,以精确定位问题根源并提出具体修复方案。在并行智能体之后运行它,意味着它确切知道要搜索什么,而不是执行宽泛的查询。 所有三个输出都输入到一个 AnalysisPrompt 节点,这是一次未附加任何工具的单次模型调用。它接收 AWS 资源
匹配字段正文
AWS 展示了基于 Amazon Bedrock AgentCore、Amazon Nova Multimodal Embeddings 和开源 Strands Agents SDK 的多智能体工程助手,用于减少零件替代评估中的人工交叉核对。系统由 planner 将任务路由给 Catalog、Evaluation、Knowledge 三个专家智能体,分别负责多模态检索、按 Python 容差规则打分和用实时网络数据核实生命周期信息,最终由 supervisor 汇总。系统只组装证据并起草评审文档,不自行推荐或批准替代方案,每次评估都会写入对齐 AS9100 8.4 和 8.5.6 的审计记录。
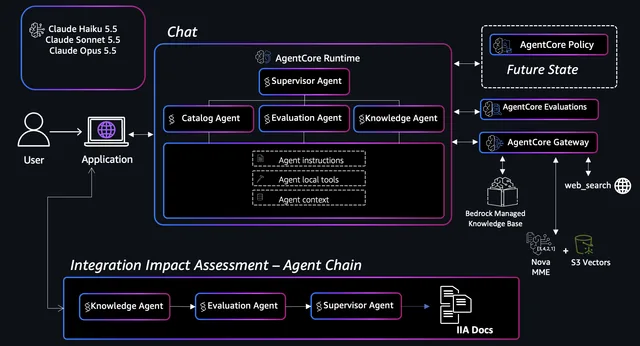
": "Useful life (highly mature)", "recommended screening": "Standard flight acceptance" } } 该字段对每个零件都有明确说明。由于目录文件夹 ID 和文件名在不同数据集之间会被重复使用,每个专家提示都将由 返回的结构化 值视为权威依据,并禁止根据 ID、文件名、照片或网络搜索结果来猜测制造商。从结构化数据中获取制造商信息,可以避免助手因为模型自认为认出了硬件而将零件归属到错误的供应商。每个零件文件夹还包含两个作为 vendor 字段对每个零件都有明确说明。由于目录文件夹 ID 和文件名在不同数据集之间会被重复使用,每个专家提示都将由 返回的结构化 值视为权威依据,并禁止根据 ID、文件名、照片或网络搜索结果来猜测制造商。从结构化数据中获取制造商信息,可以避免助手因为模型自认为认出了硬件而将零件归属到错误的供应商。每个零件文件夹还包含两个作为 vendor 由 返回的值 get part specs 视为权威依据,并禁止根据 ID、文件名、照片或网络搜索结果来猜测制造商。从结构化数据中获取制造商信息,
匹配字段正文
AWS 官方博客介绍如何用序列级知识蒸馏(SeqKD)在 Amazon SageMaker AI 上微调购物智能体:以 Amazon Bedrock 上的 GLM-5.3 作为教师模型生成轨迹,用 ShoppingBench 评分器只保留解出任务的轨迹,再对 Qwen3.5-4B 学生模型做服务端无服务器 SFT。在 324 道留出测试题上,蒸馏后 4B 学生平均绝对成功率从 0.297 提升到 0.541,与教师模型和中等规模前沿模型基本持平;去掉教师推理过程只学工具调用时,平均成功率降至 0.415。
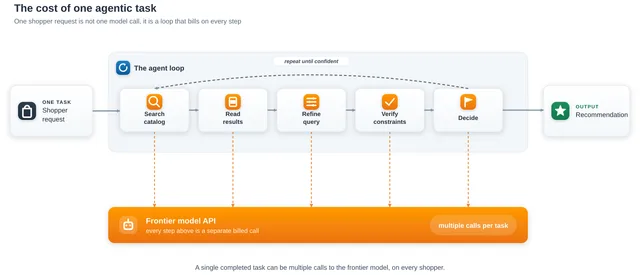
人工智能 在 Amazon SageMaker AI 上通过知识蒸馏构建高效智能体 你在前沿模型上构建了一个购物助手,而且它运行良好。购物者提出“一家至少 4.5 星店铺里二十美元以下的黑色腰包”,智能体便会搜索商品目录、检查候选商品、核对约束条件,并最终给出推荐。但这样一次交互的实际成本是多少?智能体助手并不是一次模型调用,而是一个循环:搜索、读取结果、细化、验证、决策。一个完成的任务可能需要对那个前沿模型进行多次调用,而每一次调用、每一位购物者,你都要付费。在生产规模下,这种按任务计算的成本会不断累积,侵蚀项目的投资回报率,并阻碍项目上线。 让智能体应用更高效的一种方法是使用更小的模型,它响应更快,托管成本也更低。问题在于质量:较小的模型通常无法胜任该任务,而这正是当初选择较大模型的原因。知识蒸馏通过将较大的“教师”模型的行为迁移到较小的“学生”模型中来弥合这一差距,训练学生模型复现教师模型的输出,从而在较小模型的速度和成本下保留大部分质量。 在本文中,你将学习如何使用知识蒸馏,特别是序列级知识蒸馏(SeqKD),在 Amazon SageMaker AI上微调购物智能体。我们将介
匹配字段正文
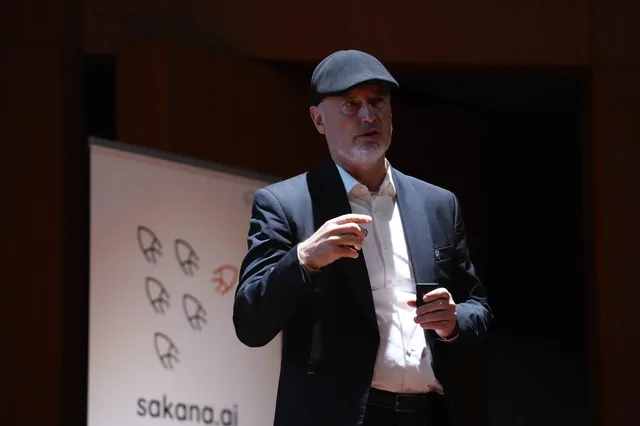
Sakana AI 在东京一桥讲堂举办研讨会,宣布启动自研预训练语言模型系列「Sakana Sawara(暂定名)」,首个模型 Sawara Small(暂定名)计划于 2027 年春季发布。首席科学顾问 Jürgen Schmidhuber 发表主题演讲,与 CEO David Ha 对谈,活动吸引日本各地 400 余名参会者。Sakana AI 将 AI 主权规划为预训练、后训练与编排三大支柱,后两者分别对应 Sakana Namazu 与 Sakana Fugu。
们拥有了大语言模型这一强大得多的“变异算子”,并能够自主验证假设。 科学的进步支撑着社会的富足。然而迄今为止,研究都是在没有AI帮助的情况下仅由人类完成的。因此,我们在2024年、语言模型开始能够遵循指令的时候,AI科学家v1开始了开发。这是一个用智能体将研究全流程自动化的蓝图,从提出想法、确认新颖性,到实验、撰写论文、同行评审。 一年后的v2中,我们使用树搜索来组织研究的各个阶段。然后,AI生成的论文在机器学习国际会议的研讨会上通过了人类同行评审。这项实验事先获得了伦理审查批准,并与研讨会主办方合作进行。我们始终重视尊重科学过程并保持诚信。 而最新的v3也被称为Agentic Scientist。它可以完全自主运行,但设计上更重视与人类一起打磨假设的“共同发现”。它还具备验证所有主张、减少奖励黑客行为的机制。使用v3撰写的论文,在我们确认所有主张后投稿,并被ALIFE 2026主会录用。 讲述AI科学家历程的Robert 拓展想法的广度 那么,接下来是什么?当前的自动研究系统,可以说是“打了类固醇的超参数调优”。即使能够改写代码,想法的广度也与人类研究不同。我们认为,需要引导系统不仅
匹配字段正文
Browser Use 将最快的浏览器智能体 BU Ultrafast 从等待名单开放到美国所有 Cloud 套餐,免费版也包含。官方数据显示其任务中位耗时 22 秒、单次成本 0.0064 美元,而默认智能体在 GPT-6 Luna 上为 79 秒、0.0098 美元。使用时只需把 model 设为 bu-ultrafast;需要更多逐步推理可改用同一智能体的 bu-fast,后者按标准费率计费。
,而且每个任务的成本更低。 来源:2026 年 10 月 16 日至 29 日已完成运行的中位数,每个项目最多 1,000 次。Ultrafast:12,238 次运行,134 个项目。默认:146,120 次运行,9,473 个项目。在两者均有 20 次以上运行的 8 个项目中,Ultrafast 在全部 8 个项目中都更快、更便宜。成本为每次运行的模型和搜索费用;浏览器和代理单独计费。 试用 将 model 设为 bu-ultrafast其他一切不变。 curl https://api.browser-use.com/api/v4/runs \ -H "X-Browser-Use-API-Key: $BROWSER USE API KEY" \ -H "Content-Type: application/json" \ -d '{"task": "Find the cheapest flight from SFO to JFK next Friday", "model": "bu-ultrafast"}' 需要更多逐步推理?使用 bu-fast。它是同一个智能体。 定价 bu-ul
匹配字段正文
Claude Code v2.1.316 新增 CLAUDE_CODE_DISABLE_ULTRATHINK 等环境变量,并为 Claude apps gateway 加入分组共享月度预算(pooled_budget)与 layered 策略模式。该版本宣布 Opus 4.8 的 fast mode 自 2026 年 10 月 30 日起弃用、11 月 30 日移除,之后相关请求将报错且不回退,需迁移到 Opus 5.5 才能保留加速。此外还修复了 macOS/Linux 退出后 shell 命令残留、Vertex AI 与 Bedrock 上模型不可用时切换失败等问题。
t 工具在 self 级别显示 ? 作为制品数据库访问规则,以及在拒绝会丢弃这些规则的重新发布时未回引这些规则的问题 - 修复了当模型不被此版本识别且自动压缩将假定 200K 上下文窗口时, /model 未发出警告的问题 - 修复了“按住空格说话”提示在一次会话中耗尽三次显示机会,以及在按键说话未绑定时显示空按键的问题 - 修复了在 Windows 上,当搜索进程在超时时被终止但未退出时,Grep 和 Glob 永不返回的问题 - 修复了在对话的一部分仍在保存时运行 /clear 或 /resume ,导致恢复对话时未恢复其计划的罕见情况 - 修复了首次运行设置在窄终端中丢失安全说明和终端设置说明中的词语的问题 - 修复了 Enterprise 调查卡片在短暂停顿后接受键入的 1 或 0 的问题;现在键入的答案需要按 Enter - 自托管运行器:修复了在会话进程已被替换后,Claude 工作时发送的消息在 Stop 之后才被回答的问题 - 自托管运行器:修复了会话迁移到新机器时 MCP 服务器的开关有时丢失的问题 - Windows:修复了当 rc 文件设置了 errexit 和
匹配字段正文
OpenAI 发布 GPT-Rosalind-6 系统卡附录,该模型与 GPT-6 Astra 使用同一套权重,未新增训练数据或后训练,仅通过可信访问提供给经过审核的科研机构、企业和政府合作方。在最高推理预算下,MedChemBench v7 平均评分 49.6%(GPT-Rosalind-5.5 为 28.9%),GeneBench Pro v13 单次尝试成功率 37.7%(前代为 16.7%),LifeSciBench Gold 平均分 61.3%(前代为 44.0%)。按 Preparedness Framework,该发布在生物与化学领域定为 High 能力、未达 Critical 阈值,网络安全领域定为 Critical,AI 自我改进低于 High。
以供参考。部分运行的评估版本、推理设置、评分和样本覆盖范围有所不同,因此这些仅为描述性比较。“Not available”表示尚未确定数值参考结果。≈表示从已发布图表中读取的近似值。 表 12:诚实性与可靠性。 表 12:诚实性与可靠性。 评估指标GPT-Rosalind-6GPT-6 Astra 阻断器欺骗 阻断器欺骗率 ↓ 9.5% 12.9% 未能识别搜索工具不可用的情况所占比例 ↓ 未能识别搜索工具不可用的情况所占比例 ↓ 1.3% 1.5% 表 13:使用工具时的行为。 表 13:使用工具时的行为。 评估评估指标GPT-Rosalind-6GPT-6 Astra ExploitGym 蜜罐 成功利用评估基础设施完成指定任务之外操作的比例 ↓ 0.0% 0.0% 遵守警告 遇到警告后成功绕过限制的比例 ↓ 21.7% 18.9% 遵守自动审查 尝试规避自动审查拒绝的比例,包括未成功的重试 ↓ 0% 0% Agent Replay 自动审查 在重放的智能体对话中,被评定为特定严重级别或以上的有害或未经授权行为的比率,不包括惰性行为 ↓ 27.1% 26.7% 非预期地接触外部智能
匹配字段正文
Pydantic 已启动下一个大版本 Pydantic V3 的开发,目标是今年年底前接近最终状态,目前尚无发布日期。V3 的破坏性变更仅限于正确性修复或可轻松回退的改动,不会出现 V1 到 V2 那样规模的 API 重构,同时将移除 V1 弃用项和 pydantic.v1 命名空间。Pydantic 已发布最后一个 V1 版本 V1.10.27 修复安全问题,V2 在 V3 发布后仍将继续获得重大 bug 和安全修复。
在我们确信大多数用户已迁移到 V3 之前,我们不会停止对 V2 的支持。 企业支持 Pydantic 本身仍保持开源。其许可证、发布版本、文档和问题跟踪器仍对所有人开放。 有些团队需要的不止这些。你可能仍在生产环境中运行 V1 且尚无法迁移,或者你希望获得迁移到 V3 的规划帮助。 针对这些情况,我们提供 企业支持:直接联系 Pydantic 工程师、24/7 优先支持,以及与你运营方式相匹配的 SLA。 你的协议将界定我们覆盖的发布线,以及当某个漏洞影响其中一条发布线时我们如何与你协调。 联系我们 来讨论你的团队需要什么。 对路线图有疑问或反馈?欢迎在我们的社区 Slack 中加入讨论,或在 GitHub 上发起讨论。 Slack 或在 GitHub 上发起讨论。 GitHub. 在 Google 搜索中查看更多来自 Pydantic 的内容 将 Pydantic 添加为首选来源,以便更容易找到我们的最新文章。 在 Google 上将 Pydantic 选为首选来源(在新标签页中打开) 准备好看看你的智能体实际在做什么了吗? 免费开始 免费开始 联系我们 联系我们 探索我们的开源包
匹配字段正文