Grok 应用构建功能上线全部 SuperGrok 与 X Premium 套餐
Grok 宣布在 Android、iOS 和网页端构建应用的功能已向所有 SuperGrok 和 X Premium 套餐开放,一句提示词即可把想法变成带独立域名的已发布产品。Build mode 运行完整的编码智能体,支持子智能体、浏览器使用以及数据库和密钥管理。应用可发布到 Grok 提供的域名或用户自有域名,也可导出源码继续开发,或仅限团队内共享。
匹配字段摘要
Grok 宣布在 Android、iOS 和网页端构建应用的功能已向所有 SuperGrok 和 X Premium 套餐开放,一句提示词即可把想法变成带独立域名的已发布产品。Build mode 运行完整的编码智能体,支持子智能体、浏览器使用以及数据库和密钥管理。应用可发布到 Grok 提供的域名或用户自有域名,也可导出源码继续开发,或仅限团队内共享。
匹配字段摘要
Build 模式运行完整的编码智能体,支持子智能体、浏览器使用,以及数据库和密钥支持。
匹配字段摘要
Grok 宣布在网页、iOS 和 Android 上构建应用的功能已向所有 SuperGrok 和 X Premium 订阅计划开放,一条提示词即可把想法变成带独立域名的已发布产品。Build 模式运行完整的编码智能体,支持子智能体、浏览器操作以及数据库和密钥管理。应用可发布到 Grok 域名或用户自有域名,也可导出源码继续开发,或仅限团队内共享。
匹配字段摘要
Hugging Face 发布教程,介绍 Sentence Transformers v6.0 新增的多向量(Late Interaction、ColBERT 风格)嵌入模型支持,通过 MultiVectorEncoder 加载 PyLate、Stanford-NLP ColBERT 与 ColPali 系列 checkpoint,并用 MaxSim 算子完成打分。文中给出编码、检索、重排、索引与评测的完整代码,并对比了索引开销:4,874 条 Natural Questions 段落产生 608,414 个 token 向量,约为 MiniLM 索引的 42 倍,压缩为 fast-plaid 索引后为 92 MB。同数据同骨干训练的 LateOn 与 DenseOn 在 13 个 NanoBEIR 数据集上平均相差约 1 个 NDCG 点,LateOn 在 9 个数据集上胜出。
匹配字段摘要
Z.ai 发布 GLM-5.3,目前仅在编码套餐中提供,即将上线 API,两周后将在 Hugging Face 开放权重。该模型与 GLM-5.2 同基座,仅大幅扩展后训练,参数量约 750B,在多项智能体编码基准上超过 Kimi K3,部分指标超过 Claude Fable 5 或 GPT-5.6-Sol。作者认为中国实验室贴近前沿的主因是发布周期以天计而非以月计,并指出 Z.ai 对公开基准的重视与其融资和股价相关。
匹配字段摘要
Unsloth 宣布 Qwen3.8-27B 现已可通过其 Dynamic GGUF 在本地运行,17GB 内存即可跑起来,同时上传了 NVFP4 量化版本,并附上 GGUF 下载链接与使用指南。被引用的 Qwen 官方推文介绍,Qwen3.8-27B 是原生多模态稠密模型,27B 参数下整体表现超过 Qwen3.7-Plus,在真实编码与办公工作流中表现突出,原生上下文 262K,可通过 YaRN 扩展至 1M tokens,采用 Apache 2.0 许可;Qwen3.8-2.4T-A95B(Max 级)的开放权重也已发布。
匹配字段摘要
吴恩达发布 AI 工程技能图谱,基于对 10000 多条招聘信息的分析、数十次与 AI 专家和招聘经理的结构化访谈以及问卷数据,归纳出四项最重要的 AI 工程技能:构建和部署 AI 应用、软件工程基础、使用编码智能体、参与塑造构建目标。他区分了 AI 工程技能与 AI 工程师岗位,认为所有开发者都需要这类技能,并提到后续会逐项展开并更新图谱。
匹配字段摘要
Firetiger 团队加入 Cursor,其构建的智能体可监控生产环境中的软件运行、捕获回归、调查事故并将发现反馈给编码智能体。Cursor 与 Firetiger 将把编码与生产运维更紧密结合,使智能体能够发布变更、观察行为并在出错时响应。Firetiger 的工作将逐步融入 Cursor,并作为对长期自主、上下文感知智能体投资的一部分,与 Cursor Origin 及即将推出的 Change Monitors 协同。

匹配字段摘要
Hugging Face 与 alphaXiv 组织社区借助编码智能体复现了 2,226 篇 ICML 2026 论文,并公开实验日志、代码和产物。受检论文中,51% 至少有一项主张获独立验证,23% 至少有一项被证伪或存在争议;结果也显示,智能体会误判尺度效应或单位问题,可靠审查仍需人类引导。
Hugging Face 与 alphaXiv 组织社区借助编码智能体复现了 2,226 篇 ICML 2026 论文,并公开实验日志、代码和产物。受检论文中,51% 至少有一项主张获独立验证,23% 至少有一项被证伪或存在争议;结果也显示,智能体会误判尺度效应或单位问题,可靠审查仍需人类引导。 · Hugging Face and alphaXiv organized a community effort using coding agents to reproduce 2,226 ICML 2026 papers, publishing the experimental logs, code, and artifacts. Among the examined papers, 51% had at least one claim independently verified, while 23% had at least one claim falsified or contested; the results also showed that agents can misread
匹配字段摘要
OlmoEarth Studio 现已支持按需生成并导出自定义嵌入向量,提供 Nano、Tiny 和 Base 三种编码器,以及多种时间跨度、空间分辨率和 Sentinel 影像源。导出的 int8 COG 可用于相似性搜索、少样本分割、变化检测和 PCA 探索;Tiny 模型仅用 60 个标注像素实现了 0.84 的加权 F1。结果质量可能受云层、大气伪影和观测缺失影响。
OlmoEarth Studio 现已支持按需生成并导出自定义嵌入向量,提供 Nano、Tiny 和 Base 三种编码器,以及多种时间跨度、空间分辨率和 Sentinel 影像源。导出的 int8 COG 可用于相似性搜索、少样本分割、变化检测和 PCA 探索;Tiny 模型仅用 60 个标注像素实现了 0.84 的加权 F1。结果质量可能受云层、大气伪影和观测缺失影响。 · OlmoEarth Studio now supports on-demand generation and export of custom embeddings, with Nano, Tiny, and Base encoders plus configurable time spans, spatial resolutions, and Sentinel imagery sources. The exported int8 COGs support similarity search, few-shot segmentation, change detection, and PCA exploratio
匹配字段摘要
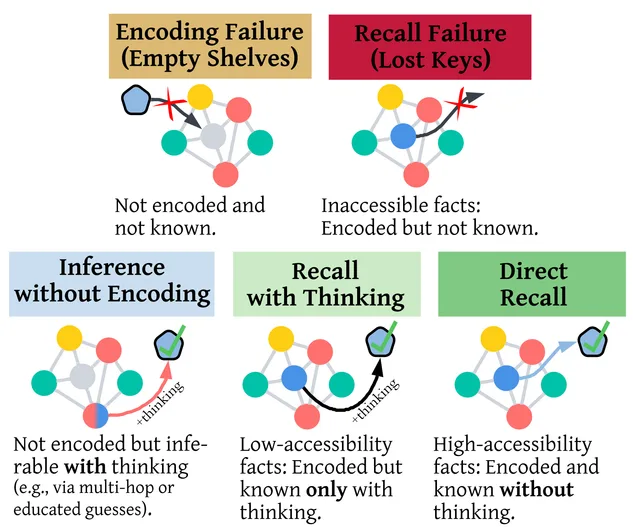
Google Research 提出知识画像框架,用包含 2,150 条 Wikipedia 事实的 WikiProfile 基准区分编码与召回,发现 Gemini-3-Pro 和 GPT-5 已编码 95–98% 的事实,却仍无法直接召回其中 26–34%,即使启用 thinking 也有 11–12% 失败。研究还显示 Gemma 3 系列随规模增大编码失败大幅减少,但召回失败依然显著,瓶颈正从知识获取转向知识利用。
匹配字段摘要
LTX 的开源视频模型 LTX-2.5 在 ComfyUI 上线首日获得支持,提供可自行运行的开放权重版本和通过 Partner Nodes 调用的托管版本。新版本带来 Diffusion Fidelity Rendering、新的视频解码器、自定义 Gemma 4 12B 文本编码器、改进的蒸馏变体、提示词增强器,以及一个自动设定生成视频时长的实验性 duration head 模型。原生 4K、音视频同步和最高 50fps 帧率延续自 LTX-2.3,用户更新 ComfyUI 至 0.32.0 或打开 Comfy Cloud 即可使用。

匹配字段摘要
Grok Bot 进入早期 beta,定位为替你干实事的 AI 队友:登录你的工具、像你一样操作并交付完成的工作。ian 列出使用技巧:bot 会记住你的偏好和写作语气,可重复执行任务(如每天 7am 备好一篇帖子、未来 5 小时每 10 分钟截一次 Mac 屏),拥有 24/7 运行的自己的电脑,能访问你的 Mac 并执行命令,可盯 Slack 线程和 GitHub Actions,能管理云端 agent 并行跑多个编码任务,bot 之间可互相通信(他用一个叫 jarvis 的 chief of staff 分派给 5 个工程 bot),bot 还能创建新 bot,并支持命名、头衔、头像、侧边栏分组和置顶。他邀请大家试用并反馈可以补充什么。
匹配字段摘要
Nvidia 发布 Nemotron 3.5 Lightning 开源模型和 NeMo Switchyard 路由库,前者面向持续运行的智能体任务,官方称在同级中实现 4 倍吞吐、完成智能体任务速度提升 30%,并可在 Jetson、GeForce RTX、DGX Spark 和 DGX Station 上本地运行。Switchyard 让开发者自定义模型池、路由标准和策略,把推理密集型步骤交给前沿模型、把执行类任务交给 Lightning,官方称其以 Anthropic Opus 4.8 约三分之一成本取得更好准确率。Nvidia 同时公开训练数据与方法,并发布用于训练编码智能体的开放数据集 Nemotron-RL-Agentic-Terminal-Pivot。
匹配字段摘要
微软研究院发布研究模型 CARE-X,基于 SigLIP2-so400M 视觉编码器和 Phi-4-mini-instruct(3.8B)语言模型,通过辅助监督、DAPO 强化学习与工具增强测量统一生成与判别能力。在 ReXVQA 基准(41,007 组问答)上达到 94% 总体准确率,比次优公开模型高 6 个百分点,并于 2026 年 8 月位列 ReXrank RexVQA 榜首。该模型为研究用途,尚未获监管批准,不用于临床诊断。
匹配字段摘要
Meta 推出可本地运行的开源多模态模型 Muse Glimmer,由 2B 视觉编码器和 28B 文本解码器组成,总参数量为 30B。它支持图像、无音频视频、多模态工具调用和目标检测,并获得 Transformers、llama.cpp 及基于 Transformers 后端的 vLLM 支持。可选的 DFlash 推测解码器能以增加内存占用为代价加快生成。
Meta 推出可本地运行的开源多模态模型 Muse Glimmer,由 2B 视觉编码器和 28B 文本解码器组成,总参数量为 30B。它支持图像、无音频视频、多模态工具调用和目标检测,并获得 Transformers、llama.cpp 及基于 Transformers 后端的 vLLM 支持。可选的 DFlash 推测解码器能以增加内存占用为代价加快生成。 · Meta released Muse Glimmer, a locally runnable open-source multimodal model with 30B parameters, comprising a 2B vision encoder and a 28B text decoder. It supports images, video without audio, multimodal tool calling, and object detection, with support in Transformers, llama.cpp, and vLLM using the Transformers bac
匹配字段摘要
Meta Superintelligence Labs 的首个开源模型 Muse Glimmer 已在 Ollama 上线,这是一个 30B 多模态模型,面向本地运行的智能体工作负载,上下文长度 128K+,采用 Apache 2.0 许可。它可用于 Claude Code、Codex、Pi 等编码智能体,以及 OpenClaw、Hermes 等长期运行的个人助手,并支持 low、medium、high、xhigh 四档可控推理强度。在 Apple Silicon 上,Ollama 的 MLX 引擎新增 DFlash 与图像输入支持,使 Muse Glimmer 运行速度提升 1.5×–1.8×,其 1.8B 参数感知编码器带来原生图像理解能力。
匹配字段摘要
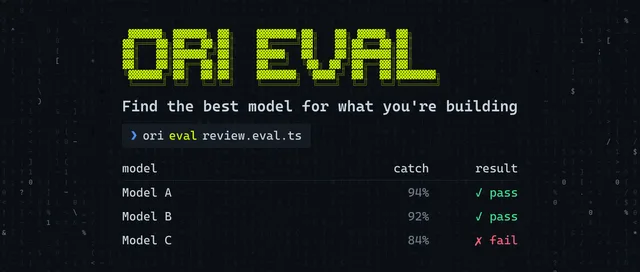
OpenRouter 发布 Ori Eval,一个面向产品内模型的评测工具,可让编码智能体扫描代码库中调用模型的位置,确认成本、性能、延迟、工具调用准确率等偏好后,从最新模型中选出 5 个候选并生成 review.eval.ts 文件,用 bun test 并行跑评测并给出带理由的推荐。评测文件会检查智能体调用了哪些工具、避开了哪些工具以及答案质量,开放式回答由 LLM-as-a-judge 按设定标准打分。单次评测通常花费 10 到 30 美元,可接入 GitHub Actions,评测失败即构建失败,也可定期重跑并在新模型更优时自动开 PR。
匹配字段摘要
OpenRouter 发布 Ori Eval,帮助开发者从 500 多个模型中选出最适合自己项目的模型。用户只需向编码智能体提出需求,Ori Eval 会扫描代码库、确认成本/性能/延迟等优先级,挑选 5 个最新候选模型并生成 review.eval.ts 文件并行评测,返回带理由的推荐结果。评测文件以 *.eval.ts 形式通过 bun test 运行,可接入 GitHub Actions 阻止回归,失败即构建失败。
OpenRouter 发布 Ori Eval,帮助开发者从 500 多个模型中选出最适合自己项目的模型。用户只需向编码智能体提出需求,Ori Eval 会扫描代码库、确认成本/性能/延迟等优先级,挑选 5 个最新候选模型并生成 review.eval.ts 文件并行评测,返回带理由的推荐结果。评测文件以 .eval.ts 形式通过 bun test 运行,可接入 GitHub Actions 阻止回归,失败即构建失败。
匹配字段摘要
Zyphra 以 Apache 2.0 许可发布 EEG 基础模型 ZUNA1.1,可对任意通道布局的数据做重建、去噪与上采样,并支持 0.5-30 秒可变长度输入。模型保持 380M 参数和 Transformer 扩散自编码器架构,训练语料扩至约 350 万通道小时,重建质量在 0.5-30 秒输入上持平或优于 ZUNA1。用户可在 Zyphra Cloud 的 EEG Playground 中免 GPU、免安装直接试用。

匹配字段摘要