←搜索结果

按匹配度 · 共 1588 条结果 清除搜索

星期日

  1. Sakana AI:Blog

    Sakana AI 推出日语特化 LLM API「Sakana Namazu」

    Sakana AI 发布日语特化 LLM API「Sakana Namazu」,基于 Moonshot AI 的开源模型 Kimi K2.6,用自有数据适配日语与日本业务语境,并内置 Web 搜索和代码执行工具。该 API 兼容 OpenAI 接口,已有代码只需改写 base_url 并设置 API 密钥即可接入。基准方面,它在 JFBench、日英翻译任务和 FairPoliticsQA 上均超过基座模型,其中 FairPoliticsQA 从 34.10% 提升至 56.30%,同时保持 Kimi K2.6 在 AIME26、MMLU-Pro、LiveCodeBench v6 上的推理与编码表现。
    Sakana AI 发布日语特化 LLM API「Sakana Namazu」,基于 Moonshot AI 的开源模型 Kimi K2.6,用自有数据适配日语与日本业务语境,并内置 Web 搜索和代码执行工具。该 API 兼容 OpenAI 接口,已有代码只需改写 base url 并设置 API 密钥即可接入。基准方面,它在 JFBench、日英翻译任务和 FairPoliticsQA 上均超过基座模型,其中 FairPoliticsQA 从 34.10% 提升至 56.30%,同时保持 Kimi K2.6 在 AIME26、MMLU-Pro、LiveCodeBench v6 上的推理与编码表现。

    匹配字段摘要
星期五

  1. The Register

    ShieldFont 开源字体用同词性替换向 AI 爬虫投毒

    阿姆斯特丹设计工作室 Seneda & Abrucio 与哥本哈根字体公司 Playtype 合作推出开源项目 ShieldFont,通过扩展 OpenType 的 GSUB 字形替换表,让网页在人类眼中正常显示、而爬虫读取的原始 HTML 中约四分之一词汇被替换成同词性同语义类别的其他词,从而向训练数据注入难以分辨的噪声。项目已提供在线编码器、React 组件以及 CSS 和 CDN 集成方式,桌面字体约 5 MB、压缩网页字体约 800 KB,并附带三套 GSUB 字典且支持自建字典以防逆向。团队承认它可被 OCR 截图、下载字体跑字典等方式绕过,也可能影响 SEO、翻译应用、系统复制粘贴和屏幕阅读器,目前处于 v0/alpha 阶段。

    匹配字段摘要

星期四

  1. Microsoft AI Blog精选

    微软发布 MAI-Cyber-1-Flash,并披露 MAI 系列模型降本数据

    微软发布针对 MDASH harness 优化的 MAI-Cyber-1-Flash,在 CyberGym 上取得 96% 的 any crash 分数,成本为当前 MDASH 最佳方案的 50%,并可在 H100 上部署。该模型设计用于高效处理最多 90% 的任务,把 GPT 5.4 等最贵模型留给 10% 的极难问题。微软同时披露上季度已交付十余个覆盖图像、语音、转写、编码和安全的新模型,其中 MAI-Image-2.5-Flash 在 PowerPoint 中相比 GPT-Image-2 降低最多 84% 的 GPU 成本,MAI-Voice-2-Flash 在 Dynamics 365 Contact Center 中降低最多 89% 的 GPU 成本。

    Nine app icons, including mail, JetBrains, GitHub, PowerPoint, Excel, Visual Studio Code, and Microsoft OneDrive, displayed in a row on a blurred green and pink gradient background with dotted lines.

    匹配字段摘要

星期三

  1. Together AI Blog精选

    Together AI 与 Moonshot AI 达成战略合作,原生托管 Kimi 模型

    Together AI 宣布与 Moonshot AI 达成战略合作,成为 Moonshot 模型发布的启动平台,从 Kimi K3 开始并覆盖后续所有开放权重模型。开发者可通过 Together AI 美国托管基础设施获得 day zero 访问,并支持零数据保留与合规访问。Kimi K3 是迄今最大的开放模型,为 2.8T 参数稀疏 MoE 架构,原生支持视觉和 1M token 上下文窗口,面向长周期编码、智能体工作流、游戏开发和知识密集型任务。

    匹配字段摘要

星期二

  1. Kimi.ai精选

    Kimi K3 上线 Together AI,作为 Day 0 发布伙伴开放高吞吐推理

    Kimi K3 已在 Together AI 上线,Together AI 作为 Day 0 发布伙伴,为开发者提供针对编码智能体和生产负载优化的高吞吐推理访问。Together AI 称 K3 是 Kimi 的开源前沿模型,面向跨代码、工具、视觉和研究的长时间智能体工作流。Kimi 方面感谢 Together AI 团队快速推进此次发布。

    匹配字段摘要

星期一

  1. Mastra Blog

    Mastra 发布 Mastra Factory,让智能体从 issue 推进到生产

    Mastra 发布 Mastra Factory,一套让智能体把软件从 issue 推进到生产的系统,可连接 GitHub、Linear 和 Slack,用户在工厂界面点击开始后由编码智能体接手。该系统在 intake、triage、planning、building、review、completion 各环节设置显式门禁,并提供类型化工作流、记忆、调度、工具和可观测性来保证过程可治理、可审计。Mastra 称其此前在 issue 接收和 PR 评审上存在瓶颈,为此构建了理解 PR 与 issue 的技能以及提供代码库上下文的评审智能体。

    Sam Bhagwat

    匹配字段摘要

星期六

  1. Claude 应用发布说明精选

    Anthropic 发布 Claude Opus 5

    Anthropic 发布 Claude Opus 5,称其以一半价格接近 Claude Fable 5 的前沿智能,在 Frontier-Bench 和 GDPval-AA 等编码与知识工作评测中成为新的 SOTA。该模型是 Claude Max 的新默认模型,也是 Claude Pro 上最强的模型,并在 ARC-AGI 3、Zapier AutomationBench 和 OSWorld 2.0 等基准上表现突出。

    Introducing Claude Opus 5

    匹配字段摘要

星期五

  1. Anthropic:Claude.dev 开发者博客精选

    Claude 5 代模型的上下文工程新规则

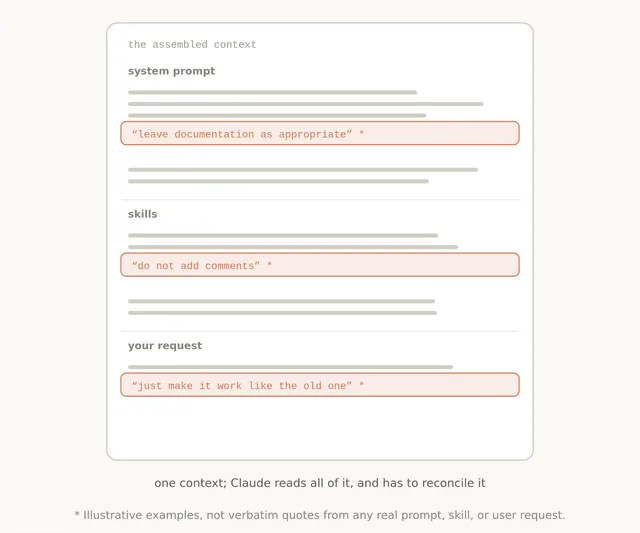
    Anthropic 总结了面向 Claude 5 代模型和 Claude Code 的上下文工程方法,称其删减超过 80% 的 Claude Code 系统提示词后,编码评测未出现可测量的损失。新方法强调让模型运用判断、设计更具表达力的工具接口,并通过 Skills、延迟加载工具和文件树渐进披露上下文。Claude Code 还提供 claude doctor,可用 /doctor 精简 Skills 和 CLAUDE.md 文件。

    One assembled context holding a system prompt line “leave documentation as appropriate”, a skill line “do not add comments”, and a user request “just make it work like the old one”.

    匹配字段摘要

星期三

  1. Sakana AI:Blog

    Sakana AI 提出 UnMaskFork:让多个掩码扩散语言模型协作提升推理性能

    Sakana AI 在 ICML 2026 论文 UnMaskFork(UMF)中提出,让多个掩码扩散语言模型(MDLM)通过模型切换协作完成同一个答案,并用蒙特卡洛树搜索寻找不同模型负责不同阶段的顺序。该方法无需额外训练或改动模型,在编码基准上持续优于现有推理时扩展方法,在数学任务上也随计算量增加稳步提升。

    匹配字段摘要

  2. Ammaar Reshi

    Google 发布 3 款 Gemini 新模型

    Google 发布 3 款 Gemini 新模型:3.6 Flash 在编码上更快、更便宜、更精准,3.5 Flash-Lite 以 350 tokens/s 成为该系列最快,3.5 Flash Cyber 可自行发现并修复安全漏洞。三款模型即日起在 AIS 和 API 中提供。

    匹配字段摘要

星期日

  1. Kimi.ai精选

    Kimi K3 需求超预期,官方暂停新订阅并拆分会员计划

    Kimi 官方表示 Kimi K3 上线后需求远超预期,过去 48 小时用量已接近当前算力上限,因此暂时暂停新订阅、优先保障现有订阅用户,现有用户不受影响。官方称正在尽快扩容,并将分批重新开放订阅名额。后续会员将拆分为面向 Kimi Web、App 和 Work 的 Kimi Membership,以及面向编码工作流的 Kimi Code Membership。

    匹配字段摘要

星期五

  1. DeepLearning.AI · Andrew Ng 来信精选

    吴恩达:AI 自动化推动从业者转向全栈角色

    吴恩达在 DeepLearning.AI 来信中提出,AI 自动化编码等可验证任务后,开发者得以把时间投入技术架构、产品需求定义等原本属于资深工程师的工作,营销和招聘领域也出现类似趋势,从业者从细分岗位转向端到端负责的全栈或全周期角色。他认为这类整合型工作是对自动化的经济补充,需求会随之增长,但这一规律不适用于所有岗位,部分领域晋升仍意味着更深的专业化。

    匹配字段摘要

星期四

  1. Johann Rehberger / Embrace The Red

    从间接提示注入到 macOS Terminal 的 DNS 数据外泄

    Johann Rehberger 披露其 Terminal DiLLMa 后续研究:macOS Terminal 曾允许特定 ANSI 转义码序列发起 DNS 请求,攻击者可借间接提示注入让 LLM CLI 工具读取表格数据并以 DNS 请求外泄。该问题已于 2025 年 11 月 3 日发布的 macOS Tahoe 26.1 中修复,作者获致谢。作者指出 LLM 集成的 CLI 应用常未处理 ANSI 转义字符,建议默认用类似 cat -v 的方式编码控制字符,并提供了 Python 与 Go 的编码函数。

    匹配字段摘要

星期一

  1. The Register

    AI 成本账单冲击高管:KPMG 调查显示 29% 高管难以理解企业 AI 运营成本

    KPMG 对 20 多个国家 2000 多名高管的调查显示,29% 的高管难以理解企业 AI 部署规模扩大后的运营成本,近半数计划在成本超过预期价值时放缓 AI 部署。Anthropic、OpenAI 和 GitHub 已从订阅制转向按 token 计费的用量计费模式,Gartner 研究预计到 2028 年编码智能体每名开发者的成本将超过开发者平均薪资。

    匹配字段摘要

星期六

  1. Figma AI / Agent / Make

    Decagon 如何用 Figma MCP 与 Figma Make 扩展设计系统

    Decagon 借助 Figma MCP 和 Figma Make 扩展其设计系统 Deco,让编码智能体直接读取 Figma 中的组件库,减少设计与开发之间的反复迭代。Deco 已成为覆盖全公司的 Figma 库,包含数百个组件、样式和变量,30 天内记录到数万次插入。Decagon 约 70% 的产品路线图直接来自客户。

    Hero image showing an AI analytics prompt interface with workflow tabs and suggested customer analytics questions.

    匹配字段摘要

星期四

  1. Amazon Science

    Amazon Science 发布 Rust 代理 Turnstile,为智能体强化学习捕获 token ID

    Amazon Science 发布用 Rust 编写的代理 Turnstile,位于智能体 harness 与模型后端之间,在生成时刻记录模型采样的精确 token ID、逐 token 对数概率和 loss mask,并导出与框架无关的轨迹供现有 RL 训练栈使用。Turnstile 兼容 OpenAI Chat Completions API,harness 无需改动,后端目前为 SGLang,计划支持 vLLM。在验证中,一个纯文本编码智能体和一个多模态计算机使用智能体在 RL 训练中持续提升。

    匹配字段摘要

  2. Cognition 模型 / Devin 博客

    Cognition 如何评估开源衍生模型的可信度:SWE-1.7 评测

    Cognition 构建了一套模型可信度评测套件,用 145 个政治敏感问题(各采样 5 次,覆盖英文、简体中文和繁体中文)检测宣传输出,并在真实编码场景中检验模型行为是否随用户和上下文变化。基于开源模型 Kimi K2.7 Code 开发的 SWE-1.7,在该评测套件上的表现与美国前沿实验室的模型相当或更好,并显著优于 Kimi K2.7 Code 基线。

    匹配字段摘要

星期三

  1. METR Notes

    METR:因 8 ≈ e²,Anthropic 研究员效率提升可能超过 2 倍

    METR 笔记指出,Anthropic 在 Q2 2026 每位贡献者每日合并代码量是 2021-2024 年的 8 倍,若假设代码质量与 2025 年前相当且编码时间占比 β=50%,Cobb-Douglas 模型推算研究员效率提升约 2.83 倍,CES 模型给出约 [2.75, 2.91] 区间,即便代码非同质也仍高于 2 倍。Anthropic 的 Mythos 系统卡称整体 R&D 提升“远低于”2 倍,与仅编码带来的 >2 倍研究员提升并不矛盾。

    METR 笔记指出,Anthropic 在 Q2 2026 每位贡献者每日合并代码量是 2021-2024 年的 8 倍,若假设代码质量与 2025 年前相当且编码时间占比 β=50%,Cobb-Douglas 模型推算研究员效率提升约 2.83 倍,CES 模型给出约 [2.75, 2.91] 区间,即便代码非同质也仍高于 2 倍。Anthropic 的 Mythos 系统卡称整体 R&D 提升“远低于”2 倍,与仅编码带来的 2 倍研究员提升并不矛盾。

    匹配字段摘要

星期二

  1. Hugging Face精选

    LeRobot v0.6.0:想象、评估、改进

    Hugging Face 发布 LeRobot v0.6.0,引入三种世界模型策略、多款新 VLA、统一奖励模型 API,以及由 lerobot-eval 支持的六个新仿真基准。新版还增加支持 DAgger 人工纠正的 lerobot-rollout、FSDP 与 HF Jobs 云训练,并为数据集加入深度数据、自动语言标注、自定义视频编码及最高约 2 倍的加载提速。

    Hugging Face 发布 LeRobot v0.6.0,引入三种世界模型策略、多款新 VLA、统一奖励模型 API,以及由 lerobot-eval 支持的六个新仿真基准。新版还增加支持 DAgger 人工纠正的 lerobot-rollout、FSDP 与 HF Jobs 云训练,并为数据集加入深度数据、自动语言标注、自定义视频编码及最高约 2 倍的加载提速。 · Hugging Face released LeRobot v0.6.0 with three world-model policies, several new VLAs, a unified reward-model API, and six new simulation benchmarks supported by lerobot-eval. It also adds lerobot-rollout with DAgger-style human corrections, FSDP and cloud training through HF Jobs, plus dataset support for dep

    匹配字段摘要

星期三