Anthropic 发布 Claude Sonnet 5,主打智能体能力与成本效率
Anthropic 发布 Claude Sonnet 5,称其为迄今最具智能体能力的 Sonnet 模型,在推理、工具使用、编码和知识工作方面较 Sonnet 4.6 有显著提升,性能接近 Opus 4.8 但价格更低。该模型现已在所有套餐中可用,定价为每百万输入 token 2 美元、每百万输出 token 10 美元,开发者可通过 Claude API 使用 claude-sonnet-5。
匹配字段摘要
Anthropic 发布 Claude Sonnet 5,称其为迄今最具智能体能力的 Sonnet 模型,在推理、工具使用、编码和知识工作方面较 Sonnet 4.6 有显著提升,性能接近 Opus 4.8 但价格更低。该模型现已在所有套餐中可用,定价为每百万输入 token 2 美元、每百万输出 token 10 美元,开发者可通过 Claude API 使用 claude-sonnet-5。
匹配字段摘要
吴恩达提出构建 0 到 1 产品的三个关键循环:智能体编码循环、开发者反馈循环和外部反馈循环。智能体编码循环让 AI 智能体写代码、自测并迭代至无 bug,工程循环每几分钟就能构建测试新版本;开发者反馈循环以数十分钟到数小时为周期,开发者从 QA 转向更高层产品决策。他强调人类相对 AI 具有显著上下文优势,因此 human-in-the-loop 不可自动化。
匹配字段摘要
Ollama 0.31 在 Apple Silicon 上让 Gemma 4 生成速度平均提升近 90%,该加速默认开启且不改变模型输出。提速来自多 token 预测(MTP):Gemma 4 自带一个小型草稿模型提出后续若干 token,主模型一次验证并保留一致的部分;Ollama 在运行时自动调整草稿长度,提案不再被接受时回退到逐 token 解码。团队还向 MLX 贡献了一个针对 2 到 8 token 批次的矩阵乘法 kernel,在 M5 Max 上使 Gemma 4 最大的矩阵乘法快 2 到 2.5 倍。用户可下载 Ollama 0.31 或更高版本,并用 ollama launch 启动由 Gemma 4 驱动的编码智能体;此前下载过 Gemma 4 的需重新 pull gemma4:12b-mlx。
匹配字段摘要
OpenHands 发布指南,介绍 AI Agent 工作流自动化:不再手动提示 Claude Code 或 OpenAI Codex,而是让编码智能体按计划或由 GitHub、Linear、Datadog、Slack 等事件触发自动运行,并产出 PR、评论或报告。指南给出触发、范围、交接三个决策点,以及顺序、并行等常见工作流模式。
匹配字段摘要
Figma 在 Config 2026 发布多项画布新能力,包括可一键把设计图层转为交互代码图层的 code layers、内置时间线与关键帧的 Figma Motion、由 Figma agent 生成的 shader 填充与效果、无需本地开发环境即可构建的生成式插件,以及进入画布的 Figma Weave 工具。code layers 从 7 月起逐步开放并已开放 waitlist,Figma Motion 即日可用,其时间线在 Dev Mode 中可查看并支持导出 CSS、JSON 或 React 动画代码,且兼容 MCP 以便交给编码智能体实现。Figma agent 昨日已向所有人发布,支持 Skills、Notion、Slack、GitHub 等连接器和附件,聊天默认对团队可见,并将扩展到 FigJam 和 Slides。

匹配字段摘要
Replit 为评估 Replit Agent 构建了离线基准与线上 A/B 测试、生产 trace 相结合的双支柱评估体系,并推出面向 vibe coding 的公开基准 ViBench,用自然语言 PRD 和测试计划检验智能体从零构建的应用是否符合需求。早期结果显示,前沿编码基准分数并不总能迁移到完整应用构建,且多数模型在扩展自己写的代码时表现变差。

匹配字段摘要
OpenHands 发布验证栈,用两层自动验证器解决编码智能体生成代码后的验证瓶颈:第一层 critic 模型在代码推送前给智能体运行打分,低分可提前终止或触发重试;第二层仓库级验证器由代码审查 skill 与 QA 智能体组成,在 PR 上自动运行。官方称代码审查机器人已在 OpenHands/software-agent-sdk 仓库运行六个月,发布 1000 多次审查、覆盖 900 多个 PR,平均合并时间缩短 58%,测试覆盖率提升近 25%。critic 模型现已在 OpenHands Cloud 和 Agent Canvas 的 Verification 设置中开放启用。

匹配字段摘要
Interconnects 作者认为 GLM-5.2 是首个在编码智能体框架中真正好用的开源权重模型,社区基准显示它是唯一能与 OpenAI、Anthropic 最新模型同场竞争的开源模型。作者实测用 Fireworks API 在 Claude Code 中调用该模型,整体能力立刻感觉可用,但遇到框架向模型发送图片导致 API 会话中断、需手动清空上下文的问题。作者测算 Claude Opus 4.5 发布到 GLM-5.2 发布相隔 204 天,落在常说的 6 至 9 个月开源与闭源性能差距区间内,并认为这会加剧 token 消耗大户的定价压力,利好开源模型推理与微调生态。
匹配字段摘要、正文
Google DeepMind 发布 AI Control Roadmap,一套用于构建和管理 Google 内部部署的高级 AI 的框架,在模型对齐之外增加系统级安全层,即便对齐不完美也能提供保障。该框架把不受信任的 AI 智能体视为潜在内部威胁,基于 MITRE ATT&CK 拆解攻击战术与技术,并按模型能力划分检测等级 D1-D4 与预防响应等级 R1-R3。团队已分析一百万个编码智能体任务,并据此为 Gemini Spark 智能体搭建实时监控,数据显示多数被标记事件并非恶意意图,而是智能体误解或过度追求用户目标。
匹配字段摘要
LMSYS 联合 MOSI 与 OpenMOSS 团队宣布,在 SGLang-Omni 上为 MOSS-TTS-Local-Transformer-v1.5 提供端到端服务。该开源 TTS 模型支持 48 kHz 立体声、零样本语音克隆、最长 10 分钟长文本合成、31 种语言与原生流式,采用 Qwen3-4B 自回归骨干和约 2B 参数的 MOSS-Audio-Tokenizer-v2。SGLang-Omni 将其拆分为预处理、tts_engine 与流式声码器三阶段流水线,并针对参考音频编码引入内容寻址 LRU 缓存。

LMSYS 联合 MOSI 与 OpenMOSS 团队宣布,在 SGLang-Omni 上为 MOSS-TTS-Local-Transformer-v1.5 提供端到端服务。该开源 TTS 模型支持 48 kHz 立体声、零样本语音克隆、最长 10 分钟长文本合成、31 种语言与原生流式,采用 Qwen3-4B 自回归骨干和约 2B 参数的 MOSS-Audio-Tokenizer-v2。SGLang-Omni 将其拆分为预处理、tts engine 与流式声码器三阶段流水线,并针对参考音频编码引入内容寻址 LRU 缓存。
匹配字段摘要
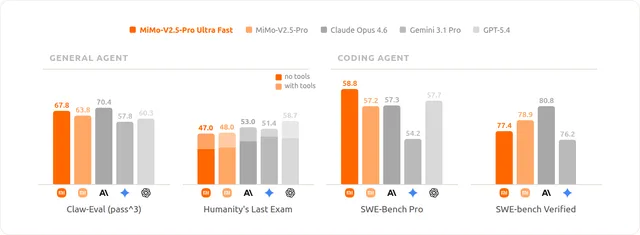
小米与 TileRT 合作发布 MiMo-V2.5-Pro-UltraSpeed,首次在 1 万亿参数模型上把解码速度突破 1000 tokens/s,仅用单台标准 8 卡通用 GPU 节点实现。该 API 按申请制限时开放,价格为 MiMo-V2.5-Pro 的 3 倍、生成速度约 10 倍,试用窗口为 6 月 9 日至 6 月 23 日。团队对 MoE Experts 做 FP4 量化并采用 DFlash 块级掩码并行预测投机解码,编码场景平均接受长度 6.30,同时已在 Hugging Face 开源 MiMo-V2.5-Pro-FP4-DFlash 权重。
匹配字段摘要
Ethan Mollick 宣布将于 10 月 20 日出版新书《Co-Existence》,探讨人类如何与有时比自己更强、但并非总是如此的 AI 协作。他提到 Anthropic 报告 AI 现已编写其 80% 的代码,每位开发者交付量提升 8 倍,另有研究称编码智能体让代码产出增加 17 倍。Mollick 表示自己逐章撰写全书,仅用 AI 做事实核查、反馈和突破写作瓶颈。
匹配字段摘要
Google DeepMind 推出 Gemma 4 12B,将智能体式多模态能力带到笔记本电脑,并首次在其中型模型中支持原生音频输入。该模型在标准评测中的表现接近 26B MoE,内存占用不到后者一半,可在配备 16GB RAM 的消费级笔记本上本地运行。其无编码器架构可直接整合音频与视觉输入,以减少延迟和内存用量。
Google DeepMind 推出 Gemma 4 12B,将智能体式多模态能力带到笔记本电脑,并首次在其中型模型中支持原生音频输入。该模型在标准评测中的表现接近 26B MoE,内存占用不到后者一半,可在配备 16GB RAM 的消费级笔记本上本地运行。其无编码器架构可直接整合音频与视觉输入,以减少延迟和内存用量。 · Google DeepMind introduced Gemma 4 12B, bringing agentic multimodal capabilities to laptops and adding native audio input to one of its mid-sized models for the first time. It approaches the 26B MoE model’s performance on standard benchmarks with less than half the total memory footprint and can run locally on consumer laptops with 16G
匹配字段摘要
微软 MAI 在 Build 2026 主题演讲中发布七款新模型,覆盖图像、语音、转录、推理和编码。首个推理模型 MAI-Thinking-1 为 35B 激活参数 MoE,256K 上下文窗口,AIME 25 得分 97%,SWE Bench Pro 53%,官方称未做知识蒸馏。编码模型 MAI-Code-1-Flash 仅 5B 参数,SWE Bench Pro 51%,今日起在 VS Code 中逐步向约 10% 个人用户推送。
匹配字段摘要
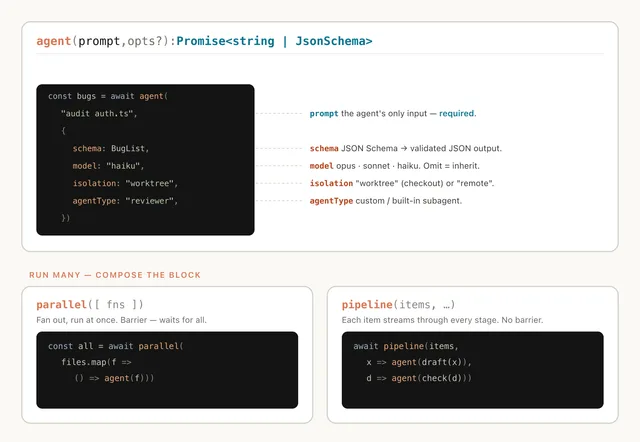
Claude Code 推出动态工作流,可即时编写并编排针对当前任务定制的多智能体框架,并支持保存、复用和分享。工作流可选择模型和独立 worktree,支持分类路由、并行汇总、对抗验证、锦标赛及循环执行等模式,也能设置 token 使用预算。该功能更适合长期、高并发、高度结构化或对抗性任务,普通编码任务未必需要其额外计算与协调成本。
匹配字段摘要
Zyphra 发布 Zamba2-VL 系列开源视觉语言模型,基于 Zamba2 混合 SSM–Transformer 主干,提供 1.2B、2.7B 和 7B 三个参数规模,采用 Apache 2.0 许可并开放权重。官方称其在 14 项基准上与同规模最强开源 Transformer VLM 大致相当,在计数、文档和图表类任务上表现突出,且首 token 延迟约低一个数量级。模型沿用 LLaVA 式结构,视觉编码器取自 Qwen2.5-VL,通过两层 MLP 适配器接入 LLM。

匹配字段摘要
LMSYS 通过 Dynamo 与 SGLang 实现异构 Encode-Prefill-Decode(EPD)分离,将 VLM 的视觉编码任务卸载到 CPU(如头节点 CPU),在负载下 TTFT、TPOT 和吞吐量均获提升。在 Intel Xeon 6747P 与 5x L40S 配置、8 张 1080p 图像、QPS 1.0-2.0 下,P99 TTFT 和请求吞吐量提升约 1.2x-1.3x,P99 TPOT 降低约 1.3x-30x。Dynamo 路由器新增设备感知加权路由模式(PR #7215),以能力比 R 在 CPU 与 GPU 池间分配请求。
LMSYS 通过 Dynamo 与 SGLang 实现异构 Encode-Prefill-Decode(EPD)分离,将 VLM 的视觉编码任务卸载到 CPU(如头节点 CPU),在负载下 TTFT、TPOT 和吞吐量均获提升。在 Intel Xeon 6747P 与 5x L40S 配置、8 张 1080p 图像、QPS 1.0-2.0 下,P99 TTFT 和请求吞吐量提升约 1.2x-1.3x,P99 TPOT 降低约 1.3x-30x。Dynamo 路由器新增设备感知加权路由模式(PR 7215),以能力比 R 在 CPU 与 GPU 池间分配请求。
匹配字段摘要
Figma 博客介绍了团队借助 AI 工具从想法走向产品的四种新方式,包括在代码中测试复杂约束、在画布上用 Figma AI agent 探索方案。FloQast 用 AI 编码工具搭建带模拟后端和真实数据的可运行原型,提前发现仅靠设计稿无法暴露的交互问题;Merkle 则在画布上先设计 7 个布局方向,再让 Figma AI agent 生成约 50 个变体。

匹配字段摘要
Anthropic 发布 Claude Opus 4.8,在编码、智能体、推理等基准上较 Opus 4.7 有所提升,价格不变。同时推出 claude.ai 上的努力程度控制、Claude Code 的动态工作流功能,以及快模式降价三倍。
匹配字段摘要
Mistral 在 AI Now Summit 上发布面向工业工程的集成 AI 栈,结合物理模型、工程经验与机器人技术,并与 Airbus、BMW、ASML 展开合作,覆盖设计、仿真与生产环节。其智能体工具 Vibe 升级为可处理长周期多步任务的统一智能体,能完成深度研究、交付物起草,以及从需求到合并变更的编码工作。Mistral 还宣布位于法国 Les Ulis 的 10 MW 推理数据中心,计划于 2026 年 Q3 启用。

匹配字段摘要