←搜索结果

按匹配度 · 共 2019 条结果 清除搜索

星期四

  1. LMSYS Blog

    MiniMax-H3 在 8×H200 上的 SGLang Diffusion 加速实测:无损 1.95×,最高 6.24×

    LMSYS 在 8× NVIDIA H200 上用 SGLang Diffusion 对 MiniMax-H3 视频生成做了基准测试:稠密无损路径比 Diffusers 快 1.85–1.95×,叠加步复用与稀疏注意力后最高达 6.24×,平均 SSIM 0.76–0.91。最快配置 SubBlock 0.80 + Cache-DiT stride 在 5s/10s T2VA 上为 5.06×/5.72×,FL2VA 为 5.86×/6.24×;质量优先可选 Cache-DiT(最高 2.99×,SSIM 0.90–0.92),均衡档 SubBlock 0.75 + Cache-DiT stride 为 4.90–5.93×、SSIM 0.79–0.90。

    匹配字段摘要、正文

星期三

  1. The Rundown AI

    OpenAI 首款 AI 芯片 Jalapeño 公布基准测试

    OpenAI 公布与 Broadcom 合作开发的首款自研推理芯片 Jalapeño,其内部测试显示,这款 700 瓦芯片比 NVIDIA 旗舰系统最高快 3.6 倍,每瓦工作量最高多 1.9 倍。该芯片不会对外销售,计划于今年晚些时候进入 OpenAI 数据中心,并在 2027 年扩大生产。

    OpenAI 公布与 Broadcom 合作开发的首款自研推理芯片 Jalapeño,其内部测试显示,这款 700 瓦芯片比 NVIDIA 旗舰系统最高快 3.6 倍,每瓦工作量最高多 1.9 倍。该芯片不会对外销售,计划于今年晚些时候进入 OpenAI 数据中心,并在 2027 年扩大生产。 · OpenAI released internal benchmark results for Jalapeño, its first in-house inference chip developed with Broadcom, showing that the 700-watt chip ran up to 3.6x faster than NVIDIA’s flagship systems and delivered up to 1.9x more work per watt. The chip will not be sold externally and is planned to reach OpenAI’s data centers later this year, with

    匹配字段摘要、正文

  2. LMSYS Blog精选

    Qwen3.8-Flash-Next 开源,SGLang 提供 day-0 支持

    Qwen 团队开源 Qwen3.8-Flash-Next,这是一个多模态 MoE 模型,也是 Qwen4 架构的早期预览,SGLang 联合 Qwen、NVIDIA、AMD 提供 day-0 支持。模型主模型 125B 参数,另有 51B N-gram Embedding,每 token 激活 6B 参数,共 48 层,其中 36 层 GDN 线性注意力、12 层 QSA 稀疏注意力,MoE 使用 512 个专家、top-10 路由。SGLang 侧给出 NVFP4 量化 checkpoint、N-gram Embedding 主机内存卸载、Gated Residual 的 FlashInfer 算子以及 MTP 索引复用等优化,在 B200 TP4 下 NVFP4 checkpoint 配合 MTP 在 batch size 1 时解码达 540 tok/s。

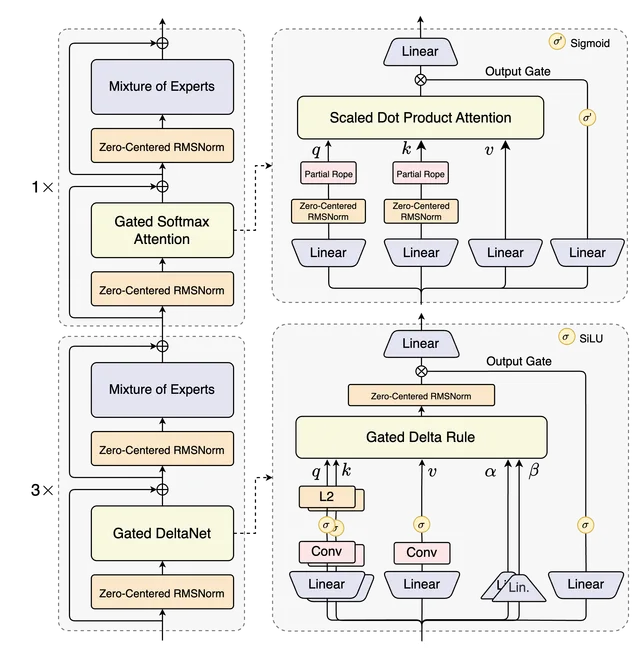
    Qwen3.8-Flash-Next Architecture

    匹配字段摘要、正文

  3. Ed Zitron 长文 / Where’s Your Ed At

    Ed Zitron 的 AI 反对者宣言:质疑大语言模型价值与产业经济性

    Ed Zitron 认为,大语言模型适合辅助可控的小型任务,却不足以支撑当前 AI 行业的巨额投资和增长预期。他从输出可靠性、企业生产率、token 消耗、模型训练及数据中心成本等方面批评行业扩张,并主张将 AI 作为工具使用不应演变为外包思考与核心工作。文章进一步判断,OpenAI、Anthropic、云厂商和 NVIDIA 之间的资本与算力循环难以长期维持。

    匹配字段摘要、正文

星期二

  1. SemiAnalysis精选

    SemiAnalysis 实测 OpenAI 自研推理芯片 Jalapeño:每兆瓦吞吐超过 Blackwell

    SemiAnalysis 在 OpenAI 实验室用 InferenceX 实测了 OpenAI 自研推理 ASIC Jalapeño,称其在多个开源模型上的每兆瓦 token 吞吐超过 NVIDIA Blackwell,且在 DeepSeek R1 上并发 1 时达到每用户 700 tokens/s 以上,全程未使用投机解码。该芯片由 OpenAI 与 Broadcom 合作、2024 年中启动设计,2025 年 11 月完成 CoWoS 流片,采用 HBM4、单封装 15.4TB/s 带宽,架构上不做 prefill 与 decode 分离,用统一芯片池应对变化的负载比例。文章认为更公平的对手是同样使用 HBM4 的 Rubin,两者每美元输出 token 数接近,但 Jalapeño 尚未启用投机解码,量产计划从 2027 年起逐步爬坡。

    匹配字段摘要、正文

星期五

  1. LMSYS Blog

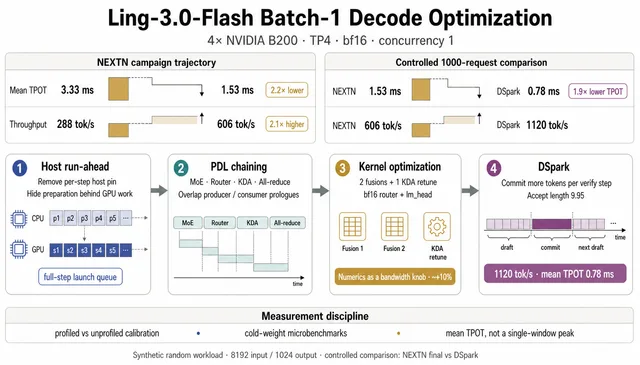
    LMSYS 在 Blackwell 上优化 Ling-3.0-flash 投机解码:单请求 TPOT 降至 1.53 ms

    LMSYS 在 4 张 NVIDIA Blackwell GPU 上优化 Ling-3.0-flash 的 batch-1 投机解码,NEXTN/MTP 路径将单请求吞吐从 288 tok/s 提升到 606 tok/s,平均 TPOT 从 3.33 ms 降到 1.53 ms。基于同一技术栈的 DSpark 置信度调度投机解码器在 1000 请求测试中达到 1120 tok/s、平均 TPOT 0.78 ms、接受长度 9.95,相比 NEXTN 平均 TPOT 低 1.9 倍。优化手段包括主机预运行、PDL 链式调度、算子融合、KDA 重调,以及将 router gate 和 lm_head 从 fp32 改为 bf16。

    Headline results across the four configurations

    LMSYS 在 4 张 NVIDIA Blackwell GPU 上优化 Ling-3.0-flash 的 batch-1 投机解码,NEXTN/MTP 路径将单请求吞吐从 288 tok/s 提升到 606 tok/s,平均 TPOT 从 3.33 ms 降到 1.53 ms。基于同一技术栈的 DSpark 置信度调度投机解码器在 1000 请求测试中达到 1120 tok/s、平均 TPOT 0.78 ms、接受长度 9.95,相比 NEXTN 平均 TPOT 低 1.9 倍。优化手段包括主机预运行、PDL 链式调度、算子融合、KDA 重调,以及将 router gate 和 lm head 从 fp32 改为 bf16。

    匹配字段摘要、正文

星期二

  1. LMSYS Blog精选

    LMSYS 发布 Miles v0.1 生产级后训练系统

    LMSYS 发布 Miles v0.1,定位为面向前沿模型后训练的全栈生产级系统,是首个 Miles 版本的后续。它把 RL 训练循环拆成 SGLang 生成、训练器更新与权重同步三段,支持完全异步 RL、TITO 精确 token 记录、R3 路由重放,以及 NVFP4、MXFP8、FP8 等低精度训练配方。官方给出在 64 张 NVIDIA GB300 上训练 GLM-5.2 744B-A40B 终端任务的参考运行,稳定完成 100 步 rollout,单步训练约 4.5 分钟,前缀缓存命中率 96%。

    The Miles fully async RL loop

    匹配字段摘要、正文

星期一

  1. Interconnects

    教所有人自己钓 token:开源模型生态的经济困境

    Nathan Lambert 认为,开源模型生态正越来越依赖 Nvidia 的资助,Nvidia 目前据报为此投入 260 亿美元,用于 Nemotron 等近乎开源的模型。若这笔投入无法在几年内带来相称回报,开源模型可能转向效率、可修改性与专用化的长尾路线,而非追赶领先闭源模型。他还指出,训练重心正从后训练转向更不透明的推理训练,愿意发布基座模型的开源团队将继续减少。

    匹配字段摘要、正文

星期五

  1. The Next Platform

    开源、开放权重与闭源 AI 模型之争

    The Next Platform 发文讨论开源、开放权重与闭源 AI 模型之间的路线之争,并以医疗场景设问:医院影像与检测结果分析该用 OpenAI、Anthropic 的闭源模型,还是 Meta、Moonshot AI、阿里、DeepSeek、Google、Mistral 等开放权重模型,抑或 Nvidia Nemotron 3 这类完全开源模型。文章指出 Meta 在开源立场上反复,而 Nvidia 对 Nemotron 模型给出了激进宽松的开源条款。

    匹配字段摘要、正文

星期四

  1. Unsloth

    Unsloth:2-bit Nemotron 3.5 Lightning 仅 22GB 显存跑 10 分钟工具调用

    2-bit NVIDIA Nemotron 3.5 Lightning 仅用 22GB 显存就连续运行了 10 分钟的工具调用。🤯 它引用了 80+ 个网站,执行了代码,并搜索了 10 个真实地点。 可通过 Unsloth Desktop 运行和训练。

    2-bit NVIDIA Nemotron 3.5 Lightning 仅用 22GB 显存就连续运行了 10 分钟的工具调用。🤯 它引用了 80+ 个网站,执行了代码,并搜索了 10 个真实地点。 可通过 Unsloth Desktop 运行和训练。

    匹配字段摘要、正文

星期三

  1. LMSYS Blog精选

    SGLang 与 Miles 为 Qwen3.8-2.4T-A95B 提供 Day-0 支持

    SGLang 与 Miles 宣布在发布当天支持 Qwen3.8-2.4T-A95B,该模型总参数 2.4T、每 token 激活 95B,采用 69 层 GDN 线性注意力与 23 层 GQA 全注意力 3:1 交错的混合架构。团队与 Qwen、阿里百炼、NVIDIA、AMD 合作,Day-0 放出 NVFP4 量化检查点 RadixArk/Qwen3.8-2.4T-A95B-NVFP4,并在 B300 上以 TP8 实现 batch size 1 下 346 tok/s 的 MTP 解码。Miles 侧支持在原生 NVFP4 基座上进行 LoRA 协同训练,用 GRPO 在 GSM8K 上验证了奖励稳定与 train/rollout KL 平稳。

    Qwen3.8-2.4T-A95B model architecture

    匹配字段摘要、正文

星期二

  1. Unsloth精选

    Unsloth 发布桌面应用 Unsloth Desktop,支持本地运行与训练模型

    Unsloth 发布 Unsloth Desktop,称其为首个可在本地运行和训练模型的桌面应用,已上线官网和 GitHub。该应用开源,支持 Mac、Windows 和 Linux,覆盖 MLX、扩散图像/视频、音频、GGUF,可将 Claude Code 和 Codex 接入本地 LLM,并支持 CPU 与多 GPU 环境(NVIDIA、AMD、Intel、Mac)。官方称训练速度提升 2 倍、显存占用减少 70%,工具调用准确率提高 50% 并支持自愈与沙箱化代码执行,同时提供私有网页搜索、深度研究、RAG、MCP 以及 NVFP4、GGUF 导出。

    匹配字段摘要、正文

  2. 蚂蚁百灵:Developer Blog精选

    蚂蚁百灵开源 Ling-3.0-tiny:7.9B 总参数、1.3B 激活参数

    蚂蚁百灵正式开源 Ling-3.0-tiny,这是一款总参数 7.9B、推理时仅激活 1.3B 参数的原生混合推理模型,同步提供 BF16、FP8 和 INT4 三个版本。官方称其在 Artificial Analysis Intelligence Index 获 25 分,Agentic Index 达 16 分,输出速度超过 160 tokens/s。模型可在单台 NVIDIA DGX Spark 上完成 FP8 推理,权重约 7.85GB,并已完成 Apple Silicon 的 MacBook 与 Mac mini 本地运行适配。

    图

    匹配字段摘要、正文

星期一

  1. LMSYS Blog精选

    SGLang 为 Meta 多模态模型 Muse Glimmer 提供 Day-0 支持

    LMSYS 宣布与 Meta Superintelligence Labs 合作,为 30B 参数多模态模型 Muse Glimmer 在 SGLang 上提供 Day-0 支持,并针对本地智能体工作流推理做了专门优化。在 NVIDIA GeForce RTX 5090 上,SGLang 以 NVFP4 加 DFlash 实现最高 1,452 tok/s 总输出吞吐和 236 tok/s 单用户解码速度,DFlash 将 batch-1 交互性提升 1.9 至 4.3 倍。模型可在 RTX 5090、RTX PRO 6000、DGX Spark 的 SM120 后端以及 Apple Silicon 的 MLX 后端部署,提供 BF16、NVFP4+MXFP8、NVFP4 及 GGUF 等多种 checkpoint 格式。

    匹配字段摘要、正文

星期五

  1. 蚂蚁百灵:Developer Blog精选

    百灵开源 Ling-3.0-flash 混合推理模型

    蚂蚁百灵开源新一代原生混合推理模型 Ling-3.0-flash,采用 124B 总参数、5.1B 激活参数的 MoE 架构,同步提供基础版本及 FP8、FP4、INT4 等多个精度版本。模型支持三种落地方式:云端 API 调用、在单台 NVIDIA DGX Spark 上以 MXFP4 或 INT4 版本完成端到端本地推理,以及在指定 GPU 测试配置下平均输出速率突破 1100 tokens/s 的高性能部署。在 Artificial Analysis 榜单中其输出速度为 353 tokens/s,AA Intelligence Index 中每项任务加权平均调用成本约 0.04 美元。

    图

    匹配字段摘要、正文

  2. LMSYS Blog

    腾讯混元 HPC-Ops 的 Attention、Router GEMM 与 MoE 算子并入 SGLang 主分支

    腾讯混元开源算子库 HPC-Ops 的 Attention、Router GEMM 和 MoE 三个算子已并入 SGLang 主分支,面向 NVIDIA Hopper(SM90)GPU,并已用 Qwen3、Hy3 和 LongCat 工作负载验证。在 8× H20 上以 Hy3-FP8 同时启用 Attention 与 MoE,batch size 4–64 时 TPOT 降低 15.1–48.8%,batch size 4–16 时 TTFT 降低 3.3–6.0%;LongCat-Flash-Lite-FP8 启用 Router GEMM 后输入吞吐提升 5.5–6.1%。这些算子已在腾讯大规模生产服务中部署,其中 Dynamic Attention 与 Fused MoE 使 Hy3 模型的 TPOT 最多降低 48.8%。

    匹配字段摘要、正文

星期三

  1. The Next Platform

    AMD 抓住智能体 AI 浪潮:Helios 机架系统与 MI455X 将推动数据中心业务 2027 年翻倍

    AMD 计划在 2026 年底凭借与 Meta、微软合作打造的 Helios 机架系统追平 Nvidia 的 Oberon 机架系统,其旗舰 Altair MI455X GPU 与 Verano CPU 将支撑数据中心 AI 业务在 2027 年翻倍以上。CEO 苏姿丰称 Epyc CPU 业务 2026 下半年增长超 80%、2027 全年增长超 70%。AMD 预计数据中心 AI GPU/XPU 市场 2026 年增长 75.6% 至 3600 亿美元,2027 年再增 75% 至 6300 亿美元。

    匹配字段摘要、正文

星期二

  1. Mistral AI

    Mistral 发布 Shieldstral:3B 开源多模态安全分类器

    Mistral 发布 Shieldstral,一个 3B 开源权重多模态安全分类器,以 Apache 2.0 许可开放下载,可在单张 16GB NVIDIA GPU 上运行。它把内容审核建模为二分类问答任务,推理时接受自然语言策略并输出校准后的安全分数,无需重新训练即可适配新策略,统一处理文本、图像及文本加图像内容。官方称其在文本安全、拒答检测、策略适应性和多模态基准上匹配或超过最多 7 倍参数量的开源 guard 模型。

    匹配字段摘要、正文

星期五

  1. 腾讯混元

    腾讯混元 Hy-MT2-30B-A3B 发布 GGUF 格式

    腾讯混元 Hy-MT2-30B-A3B 正式推出 GGUF 格式,回应社区最迫切的本地部署需求,让本地推理更简单。自 5 月开源以来,Hy-MT2 累计下载量超 70 万次,Hy-MT2-1.8B 登上 Hugging Face trending 第 1、30B-A3B 位列第 4,并已有 70+ 个产品与项目集成。该系列还获得 Apple MLX-LM、微软 ONNX Runtime、NVIDIA NeMo、LLaMA-Factory 等生态支持,并落地 Bilibili 直播评论实时多语言翻译。

    匹配字段摘要、正文

星期三

  1. Air Street Press

    Poolside 发布 Laguna S 2.1 编码智能体模型与 macOS 桌面应用

    Poolside 发布 Laguna S 2.1,这是一个可在终端或开发环境中自主规划、改文件、跑代码并持续数小时的智能体编码模型,采用 MoE 架构,1180 亿参数、每 token 约 80 亿激活,支持最多 100 万 token 上下文,量化后可跑在单台 NVIDIA DGX Spark 上。在 Poolside 自家 harness 中,开启思考模式的 Laguna S 2.1 在 Terminal-Bench 2.1 上得分 70.2%,权重以 OpenMDW-1.1 许可发布在 Hugging Face,最终评测轨迹(含失败案例)也已公开。公司同时上线 macOS 桌面应用 Poolside Desktop Assistant,基于 Agent Client Protocol,可在同一窗口运行 Claude Code、Codex、Gemini 等智能体,本地模型通过 MLX 离线运行。

    匹配字段摘要、正文