2025 年大语言模型回顾:进展、局限与未来预测
Sebastian Raschka 回顾 2025 年大语言模型发展,认为主要进展来自 RLVR、GRPO、推理时扩展、工具调用及架构效率优化,而非单纯扩大预训练规模。他指出公开基准已难以可靠反映真实能力,并预测 2026 年 RLVR 将扩展到数学和编码以外的领域,本地工具调用与智能体能力会逐步普及。文章同时主张将 AI 作为提升专业工作的伙伴,而非完全替代人的思考、编码与研究。
匹配字段摘要
Sebastian Raschka 回顾 2025 年大语言模型发展,认为主要进展来自 RLVR、GRPO、推理时扩展、工具调用及架构效率优化,而非单纯扩大预训练规模。他指出公开基准已难以可靠反映真实能力,并预测 2026 年 RLVR 将扩展到数学和编码以外的领域,本地工具调用与智能体能力会逐步普及。文章同时主张将 AI 作为提升专业工作的伙伴,而非完全替代人的思考、编码与研究。
匹配字段摘要
Mario Zechner 发布 2025 年度回顾,记录其业余技术项目:为三岁儿子打造的离线音频播放器 Boxie 已积累约 72 个卡带;heisse-preise.io 因 SPAR 在 2024 年圣诞夜更改 API 而出现 2024 年 12 月 24 日至 2025 年 5 月 14 日的数据缺口;Cards for Ukraine 累计筹款突破 30 万欧元。他还记录了使用 Claude Code 等编码智能体的工作流变化。
匹配字段摘要
FutureHouse 与 Caltech、牛津大学、Mila、AITHYRA 合作发布 OXtal,一个 100M 参数的全原子扩散模型,可直接从 2D 分子图预测可实验实现的 3D 有机晶体堆积结构。传统方法依赖大规模 CPU 物理模拟搜索,最近一次 CSP Blind Test 中预测 7 个目标就消耗 46M CPU 核心小时,而 OXtal 用生成式推理在单块 GPU 上数秒内给出预测。模型不使用硬编码对称性,而是在超过 600,000 个实验解析结构上训练并配合新的裁剪算法,以软对称性作为归纳偏置学习分子局部堆积规律。
匹配字段摘要
OpenHands 官方博客介绍如何通过 Agent Client Protocol(ACP)把 OpenHands 接入开发者常用的编辑器。ACP 是让编辑器与 AI 编码智能体通信的标准化 JSON-RPC 协议,智能体作为编辑器子进程运行;Zed、JetBrains 系列 IDE、Neovim(CodeCompanion.nvim)和 Obsidian 已支持该协议。文章以 Zed 为例给出配置步骤:先运行 openhands 配置 LLM 提供商与 API key,再在 Zed 的 agent_servers 中加入 OpenHands 配置,之后即可在编辑器内调用智能体。
OpenHands 官方博客介绍如何通过 Agent Client Protocol(ACP)把 OpenHands 接入开发者常用的编辑器。ACP 是让编辑器与 AI 编码智能体通信的标准化 JSON-RPC 协议,智能体作为编辑器子进程运行;Zed、JetBrains 系列 IDE、Neovim(CodeCompanion.nvim)和 Obsidian 已支持该协议。文章以 Zed 为例给出配置步骤:先运行 openhands 配置 LLM 提供商与 API key,再在 Zed 的 agent servers 中加入 OpenHands 配置,之后即可在编辑器内调用智能体。
匹配字段摘要
LG AI Research 在 CTAD 2025 上介绍了 MOIRA(Multi-Omics Integration with Robustness to Absent modalities),一个在模态缺失情况下仍能可靠预测阿尔茨海默病的多模态整合框架。MOIRA 由各模态专用编码器、自适应融合模块和预测模块组成,融合时对缺失模态置零并仅在可用模态间用 softmax 重分配权重,训练结合预测损失、各模态辅助损失和 CLIP 式对比损失。该框架可兼容任意编码器与预测模块,实验显示用 3D CNN 编码器处理原始 MRI 数据优于使用 FreeSurfer 预处理特征。
匹配字段摘要
安全研究者 Johann Rehberger 在 Google 新发布的 Antigravity IDE 中发现五个安全漏洞,包括通过间接提示注入实现的远程命令执行和数据外泄,其中部分问题可追溯到 2025 年 5 月他向 Windsurf 报告过的同类缺陷。Antigravity 默认由 AI 自行判断终端命令是否安全执行,且 MCP 工具调用完全没有人工确认环节,攻击者可利用不可见的 Unicode Tag 字符在源码或 Linear 工单中隐藏指令。作者建议禁用自动执行、谨慎启用 MCP 服务器,并指出 Claude Code、GitHub Copilot、Cursor、Codex 等编码智能体在安全性和补丁历史上更成熟。
匹配字段摘要
Anthropic 发布 Claude Opus 4.5,称其在编码、智能体和计算机使用上达到世界最佳,并在日常任务如深度研究和表格处理上有显著提升。模型现已在应用、API 和三大云平台可用,API 定价为每百万 tokens 输入 5 美元、输出 25 美元。同时更新了 Claude Developer Platform、Claude Code 和消费级应用,新增 effort 参数以控制推理强度,并提升了上下文管理和多智能体协调能力。
匹配字段摘要
Zyphra 发布技术报告,介绍 ZAYA1——首个完全在 AMD 平台(AMD Instinct MI300X GPU、AMD Pensando 网络与 ROCm 软件栈)上完成大规模训练的 MoE 基础模型,训练集群由 AMD 与 IBM Cloud 联合构建。ZAYA1-base 总参数 8.3B、激活参数 760m,在推理、数学和编码基准上表现与 Qwen3-4B、Gemma3-12B 相当,并超过 Llama-3-8B 和 OLMoE。Zyphra 称其为 AMD 生态可支撑前沿级 AI 训练的验证,并采用压缩卷积注意力(CCA)等架构创新提升训练吞吐与推理效率。

匹配字段摘要
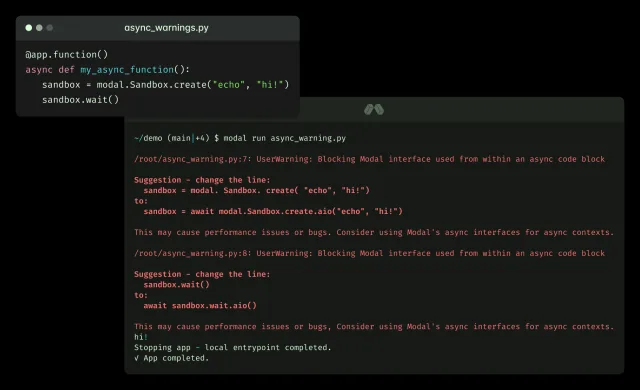
Modal 提出面向编码智能体的开发者体验框架:智能体与人类一样依赖紧密的反馈循环,通过生成代码、运行、观察结果再调整来迭代。Modal 认为 CLI、SDK 和 API 等程序化访问方式能缩短反馈循环,可操作的错误信息和贴近代码的示例同样关键。Modal 表示,为人类优化开发者体验的许多工作同样让智能体受益。
匹配字段摘要
Mario Zechner 提出,许多智能体任务无需 MCP,可让编码智能体通过 Bash 调用简洁的 CLI 工具并编写代码。其浏览器工具以 Puppeteer Core 实现启动、导航、执行 JavaScript 和截图等能力,README 仅占 225 tokens;相比之下,Playwright MCP 的 21 个工具占 13.7k tokens,Chrome DevTools MCP 的 26 个工具占 18.0k tokens。这种方式可按需载入说明、串联调用并快速修改输出格式或增加工具,但需要自行设计和维护工具结构。
匹配字段摘要
Amp 宣布 Amp Free 不再要求用户选择加入训练,程序员可以将其作为免费编码智能体用于敏感的工作代码和个人项目。免费模式现在符合 Amp 付费 smart 模式的全部安全标准,已使用 Amp Free 的用户训练模式已被关闭。用户可通过安装或更新 Amp 后在 CLI 中使用 /mode free,或在编辑器扩展中切换 smart/free 模式;工作区管理员可在设置中为成员启用或禁用 Amp Free,默认启用,但 Enterprise 工作区暂不支持。

匹配字段摘要
Linear 提出自驱动 SaaS 愿景,希望规划与软件构建系统能代表用户自主推进工作,而非依赖持续提示。其设想分为辅助建议、选择性自动执行和完全自主处理三个层级,最终可将部分问题自动分派给编码智能体,仅由人工评估结果。

匹配字段摘要
Liquid AI 发布 3B 参数视觉语言模型 LFM2-VL-3B,基于 LFM2-2.6B 主干并集成 SigLIP2 400M NaFlex 编码器,支持原生分辨率与可变宽高比图像处理。该模型在 MM-IFEval 上取得 51.8%、RealWorldQA 上 71.4%,语言基准为 GPQA 30%、MMLU 63%,视觉理解覆盖日语、法语、西班牙语、德语、意大利语、葡萄牙语、阿拉伯语、中文和韩语。模型已在 Hugging Face(LFM Open License)和 LEAP 平台上线。
匹配字段摘要
Cognition 发布 SWE-grep 和 SWE-grep-mini 两个专攻高并行上下文检索的智能体模型,称其检索能力追平前沿编码模型,耗时却少一个数量级,现已用于 Windsurf 新的 Fast Context 子智能体。模型每轮最多发起 8 个并行工具调用、最多 4 轮,经多轮强化学习训练后再蒸馏出 mini 版;借助 Cerebras 推理,SWE-grep-mini 超过 2800 tokens/秒,SWE-grep 超过 650 tokens/秒,对比 Haiku 4.5 的 140 tokens/秒分别快 20 倍和 4.5 倍。Fast Context 将随最新版本逐步向 Windsurf 用户开放,无需额外 UI 或命令,也可在 playground.cognition.ai 试用。
匹配字段摘要
Anthropic 发布 Claude Haiku 4.5,其编码性能接近五个月前的 Sonnet 4,但成本仅为其三分之一,速度提升超过两倍。该模型在部分任务上超越 Sonnet 4,API 定价为每百万输入 token 1 美元、输出 token 5 美元,现已通过 Claude API、Amazon Bedrock 和 Google Cloud Vertex AI 提供。
匹配字段摘要
Mitchell Hashimoto 用 AI 智能体编码工具开发并发布了 Ghostty 的 macOS 无干扰自动更新功能,该功能在终端窗口内显示更新状态而不弹窗抢焦点。他先自行规划、让 AI 只出计划再实现 UI 原型,中途遇到 AI 无法修复的关键 bug 后转为人工主导清理代码,并强调 AI 是助手而非替代品。
匹配字段摘要
Anthropic 发布 Claude Sonnet 4.5,称其为全球最强编码模型,在 SWE-bench Verified 和 OSWorld 上分别取得领先成绩,并同步推出 Claude Agent SDK、Claude Code 检查点、VS Code 扩展及 API 记忆工具等更新。模型定价与 Sonnet 4 相同,为每百万 tokens 3 美元(输入)和 15 美元(输出),并附带一个名为 Imagine with Claude 的研究预览。
匹配字段摘要
Amp 已将主模型切换为 Anthropic 最新发布的 Claude Sonnet 4.5。测试显示,该模型在编码方面减少了谄媚行为,文件编辑成功率更高,调试等复杂任务中的推理能力有所提升。用户更新 VS Code 扩展或 CLI 至最新版本即可自动启用。
匹配字段摘要
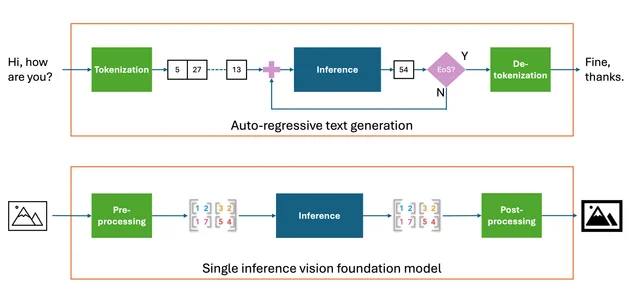
vLLM 新增 IO Processor 插件框架,使非文本模型能在同一服务实例内完成输入预处理和输出后处理,并接入 TerraTorch 地理空间模型。插件目前用于 pooling 模型,每个 vLLM 实例可加载一个插件;Prithvi 示例可接收卫星图像 URL,并返回 base64 编码的 GeoTIFF 洪水区域预测图。相关改动尚未进入当时最新的 v0.10.1.1,复现实例需安装最新代码。
匹配字段摘要
安全研究者 Johann Rehberger 披露 AI 编码智能体 Cline 存在数据外泄漏洞:聊天框会渲染来自不可信域名的 Markdown 图片,攻击者可在提示注入攻击中读取 .env 等敏感文件并把内容拼进图片 URL,且无需人工批准即可外泄。该问题于 2025 年 5 月 29 日报告给 Cline 项目,90 多天后仍未修复,作者因此公开披露。缓解建议包括不渲染不可信域名的 Markdown 图片、默认关闭 Auto-approve,并建议 Cline 投入资源做安全工程。
匹配字段摘要