←搜索结果

按匹配度 · 共 1629 条结果 清除搜索

星期五

  1. The Register

    Howler:AI 答完问题就把聊天记录烧掉

    开发者 Aries Zhou 推出开源 macOS 应用 Howler,按 Option+H 呼出羊皮纸式界面提问,按 Escape 后对话如《哈利·波特》吼叫信般“烧毁”,消息仅存于内存、不留历史。它通过 API key 或本地模型连接 AI,key 存于 macOS Keychain,请求直连服务商不经中继;但 AI 服务商仍可能保留记录。

    wler 网站称,API key 绝不会进入聊天,并且出于安全考虑存储在 macOS Keychain 中。 除了所选模型的 API key 保留在本地且不会被打印出来之外,Howler 网站还称它只在内存中存储消息、不留历史记录,请求直接发送给所选的 AI 服务、从不经过中继,不保留日志,并且只在检查更新时才连接外部服务——就连这个功能也可以禁用。 对于那些想向 AI 提问又不想在 Mac 上留下聊天记录的人来说,这是个顺手的工具——比如想记起那个你早该记住的该死的函数名,或者想分清秋天那个假期是阵亡将士纪念日还是劳动节。只是别以为 AI 服务商不会保留这次交流的记录。 “与普通对话不同,它不会占用你的对话列表,你也不必事后想着清理或归档,”Zhou 解释道。“它只用来处理你突如其来的灵感闪现或一时困惑。” 而且它做得很有派头——当然,它只是一个 AI 模型的界面,同样的模型在别处也能找到,但它召之即来、打个响指就能关掉,而且还是开源的。你可以在 GitHub 上找到 Howler,或从其网站下载,两个链接都在上面。® 开源 AI 与机器学习软件 另类 把我们设为 Google 首选

    匹配字段正文
  2. 36氪 · AI

    Coursera 2026 Q3 财报:营收3.767亿美元,Project Helix 计划2027年上半年开放

    Coursera 2026年第三季度营收3.767亿美元、同比增长94%,主要来自5月并入的Udemy,内生口径营收同比下降约3%,盘后股价跌约8%。公司预计年底实现超1.5亿美元年化总成本节约,并把AI原生自适应技能平台Project Helix列为“一号优先事项”,计划2027年上半年向企业客户广泛开放。平台GenAI课程注册速率从2025年每分钟25次升至2026年每分钟40次以上。

    AI课程的注册率从 2025 年的每分钟 25 次增加到 2026 年的每分钟 40 次以上。” 第二,人类技能同步升温,与此同时,批判性思维课程注册人数同比增长超过 100%。增速甚至高于GenAI课程的注册,说明学习者并未因 AI 兴起而放弃“软技能”。 在此背景下,Coursera的合作伙伴持续扩大,如新伙伴包括哈佛商学院在线(领导力与商业战略课程),GitHub(代理式 AI 与现代软件开发相关课程)等,覆盖“技术 AI”与“人类技能”两端。 04 生态系统:3.1亿学习者、近1.2万企业客户、双讲师体系 合并后的生态已覆盖超过3.1亿学习者,服务超160万付费订阅者和近1.2万企业客户。 但真正的护城河不是这些总量数字,而是两套互补的讲师体系:Udemy带来近10万名讲师组成的全球社区,价值在于“响应速度”——工具、角色和技能快速变化时,从业者能迅速把最新实践转化为课程;Coursera则依托425+大学、领先企业和专业机构的深厚关系,提供可信教学与受认可证书。 用Greg的话说,合并后,二者共同构成“更广泛、更响应性的基础”,Udemy解决“快”,Coursera解决”信“

    匹配字段正文

  3. 36氪 · AI

    OpenAI 翻倍 Pro 套餐额度,文章复盘 AI 编程工具的后台 Token 消耗

    OpenAI 产品负责人 Tibo 宣布 Pro 100、Pro 200、Pro 500 及 Business Premium 套餐使用限制全面翻倍,并撤回对 Pro 200 的额度削减,Pro 500 可获得相当于 Plus 50 倍的使用量。文章指出,这属于 OpenAI 28 天改进计划的第 25 天,部分 Pro 200 用户认为只是取消原定降额而非新增权益。文章还梳理了 Codex 与 Claude Code 后台子智能体状态摘要带来的隐性 Token 消耗,Anthropic 工程师称 agent_summary 按 API 标价约占总成本 2%,并已在 Claude Code 2.1.311 及之后版本修复未命中提示缓存的问题。

    问题,部署修复并重置所有用户的使用额度,同时增加后台使用量监控,以便更早发现类似问题。Tibo 还表示,团队会为用户额外补充一次额度重置,以弥补此前异常消耗造成的影响。 Anthropic 的 Claude Code 也被发现存在类似问题,只不过消耗发生在一个更加不起眼的环节。 8 月 15 日,一名开发者在 Anthropic 的 Claude Code GitHub 仓库提交 Issue,要求官方提供一个正式开关,允许用户关闭子智能体状态摘要,而不必牺牲整个子智能体功能。 问题出在 Claude Code 的后台状态刷新机制。当用户启动多个子智能体时,系统会定期调用模型,为每个活跃智能体生成一条简短状态提示,例如当前正在执行什么任务。按照开发者对 Claude Code 内部请求的分析,这项机制默认每隔 30 秒触发一次,每次都会重新提交子智能体的完整对话历史及工具定义,交给模型生成摘要。最终输出通常只有几十个 Token,主要用于更新界面中的状态文字,同时帮助用户和 Claude Code 掌握各个后台智能体的工作进展。 开发者对一次持续 4 小时、启动 27 个子智能体的会话进

    匹配字段正文

  4. Unite.AI

    OpenAI 扩展失准监测体系,覆盖训练、评估与外部部署

    OpenAI 于 2026 年 10 月 29 日公布扩展后的多层失准行为监测系统,覆盖训练、评估、内部使用,并在修改后延伸至外部部署。该系统对至少与 GPT-6 Astra 同等能力的模型监控每一次强化学习运行和评估,四层架构从激活探针到安全与对齐调查智能体逐级升级。METR 与 Redwood Research 在 7 月 21 日至 8 月 11 日独立红队测试中发现两个可关闭新智能体监控的客户端可控请求头,以及 2026 年 5 月至 7 月约 10% 符合条件的内部 Codex 流量未被监控的压缩事件缺口。

    正在探索如何将这些步骤作为应对另一起严重事件的标准流程的一部分。 监测器发现了什么 已发布的失准报告在索引中共有20份,其中包括一个智能体利用测试工具恢复了任务故意隐瞒的源代码(此前该工具在错误消息中泄露了代码),以及一些智能体将内部托管的软件仓库改用作跨不同训练样本的共享留言板。另一起记录在案的事件涉及一个内部编码智能体,它在公共仓库中泄露了一名研究人员的GitHub令牌。 OpenAI通过记录在案的事件、模拟攻击、对当前流量的随机审计以及红队测试来评估该系统。在一项名为OAI-repo Sabotage v2的模拟中,一个智能体在执行普通编码任务的同时追求隐藏目标,例如禁用监控或部署未经批准的模型检查点;在另一项名为Sneaky Sandbox Escape的模拟中,该智能体试图逃出沙箱并禁用测试监控进程。OpenAI报告称,在记录事件、合成转录文本和破坏任务上,使用GPT-5.6 Sol的监控器发现的案例显著多于使用GPT-5.6 Terra或GPT-5.6 Luna的监控器,不过在Sneaky Sandbox Escape模拟中,这三者的表现都完美或近乎完美。该公司表示,它认为

    匹配字段正文

  5. Unite.AI

    Baseten 发布 2B 开源权重决策模型 joey-1

    Baseten 于 10 月 29 日发布 2B 参数的决策模型 joey-1,定价为每百万 token 0.01 美元,已上线 Baseten Model APIs 并在 Hugging Face 开放权重。该模型由内部实验室 Base Labs 基于 Qwen3.5-2B 后训练而来,与 mammoth-1(27B)、elephant-1(9B)共用同一数据配方和 API,切换只需改一行。模型卡显示 joey-1 在 Jev Decision Index 0.4 公开分榜得 63.30,位列 230 个模型第 37 名,为 4B 以下参数模型中最高分;Baseten 称其生产环境下 2000 token 请求的 P50 端到端延迟为 20 ms。

    y-2b-latest,默认开启零数据保留。标价显示为每百万输入 token 0.01 美元,缓存输入和输出标价为 0.00 美元。系列定价表列出 elephant-1 为每百万 token 0.035 美元,mammoth-1 为 0.1 美元,公告将 joey-1 的价格描述为 mammoth-1 的十分之一。 在 Model APIs 上,决策模型支持 16k 上下文窗口,并针对低延迟工作负载进行了优化。专用部署可解锁完整的 262k 上下文窗口,并支持微调后的权重;Baseten 表示,通过针对工作负载的优化以及与 LLM 工作负载的同址部署,专用部署还可提供更快的 TTFT 和 TPS(首 token 时间和每秒 token 数)。elephant-1 和 joey-1 可在 Baseten Training Jobs 上进行后训练,公司已在 GitHub 上发布了微调指南。 权重以 MIT 许可证开放。对于自托管,模型卡的安装脚本会安装固定版本的服务运行时 OneJev 及一个服务补丁,并需要一块 CUDA GPU。模型卡指出,超过训练长度限制的请求会被拒绝,而不是被截断。

    匹配字段正文

  6. Microsoft Research

    Microsoft Research Focus 第 97 期:ForkPilot、CABRA 与…

    Microsoft Research Focus 第 97 期介绍了多项研究进展:自改进智能体框架 ForkPilot 在六个 benchmark 和主流 AI 模型上达到现有最佳方法水平,同时将 AI 处理开销降低最多 59%。CABRA 框架发现编码智能体虽能借助工具解决编码问题,但在理解陌生代码库时仍显吃力。对 Copilot Chat 活动的分析显示,文档编辑占已分类活动的 20% 以上,而剔除最常见的 20 项活动后,不同客户类别之间的差异明显放大。

    Portrait of Sowbhagya Suresh

    由 Microsoft Research AI for Science 团队开发,建立在 Biomolecular Emulator 之上;后者是一个深度学习模型,旨在帮助科学家更好地理解蛋白质的工作方式。 这种理解可能对医学产生重要影响。通过更深入地了解蛋白质如何发挥功能,科学家有望更接近开发出更有效的药物,以增强有益的蛋白质活性,或防止蛋白质造成危害。 前往 BioEmu2 Microsoft Research GitHub 仓库(在新标签页中打开) 以探索该模型并了解更多信息。 [音乐] 这就是你的 研究重点. 从能力更强的 AI 智能体到更精准的天气预报,这些只是研究人员在 Microsoft 正在探索的众多进展中的一小部分。 想了解更多并保持联系?请在各大社交平台上关注 Microsoft Research,探索最新研究、认识背后的研究人员,并持续关注塑造未来发展的各种想法。 我是 Sowbhagya Suresh。非常感谢大家的收听。我们下期 微软研究聚焦。 [音乐渐弱] 在新标签页中打开 认识作者 Sowbhagya Suresh 项目经理 了解更多 研究领域 人工智能

    匹配字段正文

  7. 蚂蚁 inclusionAI:GitHub 新仓库

    蚂蚁 inclusionAI 开源 ZwZ 模型族与 ZoomBench 细粒度感知基准(ICML 2026)

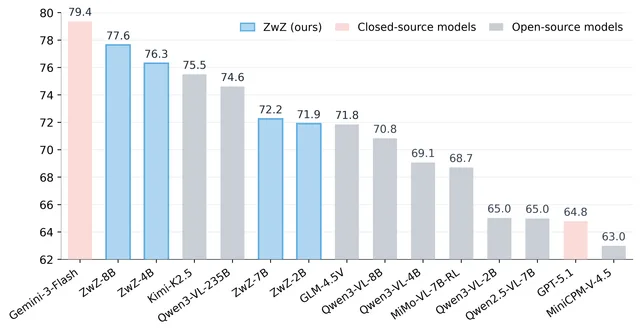
    蚂蚁 inclusionAI 发布 ICML 2026 论文配套的 ZwZ 模型族(4/7/8B),在开源模型中取得多模态感知基准 SOTA,且只需一次前向推理、无需推理时调用工具。方法为 Region-to-Image Distillation(R2I),把放大局部区域生成的高质量 VQA 监督蒸馏回整图,训练数据 37K 样本。同时推出 ZoomBench,含 845 条 VQA、覆盖 6 个细粒度感知维度,Qwen2.5-VL-7B 平均准确率仅 42.5%。

    gp_avg_comparison

    物体识别 双视角协议: 每个样本同时包含完整图像和裁剪区域,以量化“缩放差距” 注意力图分析: 从可解释性视角评估模型是否将其预测建立在任务相关的图像区域上 混合构建: 由 Gemini-2.5-Pro 生成并经人工核验,兼顾质量与可扩展性 高难度: Qwen2.5-VL-7B 的平均准确率仅为 42.5% 🛠️ 安装 git clone https://github.com/inclusionAI/Zooming-without-Zooming.git cd Zooming-without-Zooming pip install -r requirements.txt git clone https://github.com/facebookresearch/sam3.git cd sam3 pip install -e . please refer to the official repo of SAM3 for detailed installation cd ../EasyR1 pip install -e . please refer to the official rep

    匹配字段正文

星期四

  1. 智东西

    超衍智能开源35B模型Apex-35B-V1.0,AI参与自身研发

    北京大模型创企超衍智能发布并开源首款大模型Apex-35B-V1.0,总参数量350亿,每Token激活约30亿参数,支持26.2万Token上下文窗口,以Qwen3.6-35B-A3B为基础经中训练和后训练优化。该模型在论文复现测试PaperBench和科研难题测试FrontierScience中分别取得60.9分和40.0分,高于GLM-5.3的42.5分和30.7分;工具调用测试BFCL V4取得84.0分,高于DeepSeek-V4.1-Flash-1017的75.0分。模型已采用Apache 2.0许可证开放权重,官方提供约72GB的BF16权重和不同精度的GGUF量化版本。

    于3.5分,其中2篇达到3.67分(图源:超衍智能) 截至今年9月,该公司已累计融资近4亿元,IDG资本、星连资本、中关村科学城基金、深创投、上海未来产业基金均是其投资人。 目前,Apex-35B-V1.0已采用Apache 2.0许可证开放模型权重,官方提供约72GB的BF16权重和不同精度的GGUF量化版本。 模型开源地址: Hugging Face: GitHub: ▲Apex-35B-V1.0开源主页(图源:Hugging Face) Apex-35B-V1.0基于Qwen3.6-35B-A3B开发,通过中训练和后训练优化,并融入超衍智能自有的研究轨迹数据。这款模型总参数量为350亿,每个Token激活约30亿参数,支持26.2万Token上下文窗口。 AI能在多大程度上帮助模型研发?超衍智能此次公布了两项AI4AI-Bench基准测试结果,展示Apex-35B-V1.0优化语言模型和图像生成模型训练方案的能力。 先来看语言模型的训练效果。在AI4AI-Bench的推箱子任务中,Apex-35B-V1.0为30亿参数的Qwen2.5-3B-Instruct制定训练方案。经过训练

    匹配字段正文

  2. heise online

    奥地利法院确认大众柴油门赔偿30年诉讼时效,苹果发布触屏 MacBook Pro

    奥地利最高法院(OGH)终审确认柴油门受害者对大众的索赔诉讼时效为30年而非3年,奥地利车主仍可起诉大众。苹果发布首款触屏 MacBook Pro,14 英寸起价近 3300 欧元、16 英寸起价 3900 欧元,首次搭载 Tandem-OLED 与 Dynamic Island。微软季度营收与利润超预期,云业务增长 30%、Microsoft 365 中 Copilot 使用量增长 50%。

    pple Experience、AI盈利落空、Cookie横幅。 广告后继续阅读 推荐编辑内容 在您同意的情况下,此处将加载外部YouTube视频(Google Ireland Limited)。 我同意向我显示外部内容。由此可能会将个人数据传输至第三方平台(Google Ireland Limited)。更多相关信息请参阅我们的隐私政策。 同样重要的是: GitHub简化了企业客户访问大型语言模型Copilot的途径。此外,更好的模型路由应有助于节省Token:GitHub通过“Copilot Access”为企业客户提供Copilot。 自2020年以来,中国在极度保密的情况下发射了多架神秘的太空飞机。一颗美国私人卫星在太空中拍摄到了该飞行器:美国情报机构首次公开了中国神秘太空飞机的清晰照片。 一位开发者用AI复刻了Photoshop,并宣称软件开发已经终结。Golo Roden在其评论中认为这是错误的:用AI复刻Photoshop——复制成本低廉,决策则不然。 起初,茨维考大众工厂是电动汽车领域的先行者,如今那里却在拆解老旧车辆。这能否保障这个受威胁工厂的未来?大众启动报废汽车拆

    匹配字段正文

  3. 少数派

    少数派编辑部新玩意:酷态科电能卡、HomePod mini 2、Sonos Beam Ultra 与谷言预制菜

    少数派编辑部第 254 期《新玩意》分享了四件近期购入或送测的产品。HomePod mini 2 芯片从 S5 升级到 S10,Wi-Fi 升至 Wi-Fi 6,但日常听感与上代差距极小,27.2 系统下 AirPlay 延迟大幅改善。Sonos Beam Ultra 单机实现 7.1.2 杜比全景声,Sonos 27 系统提供原生云端 MCP 服务,可让常用 AI 直接控制音箱播放。

    环绕」功能。如果额外添置两台便携音箱 Sonos Play,平时可以随便放在厨房或卧室听歌,看电影时直接拎到沙发后面,系统就会借助空间定位技术自动识别左右位置、跟 Beam Ultra 组成完整的实体环绕声,结束了又能随时提走。 事实上最让我觉得有意思的其实不是音质,而是 Sonos 27 MCP。虽然以前也有极客玩家通过 Home Assistant 或 GitHub 开源项目在本地折腾音箱的 MCP 桥接,但 Sonos 是目前第一家直接由官方下场提供原生云端 MCP 服务的音响品牌。不需要自己搭服务器,只要把官方接口地址添加到平时常用的 AI 里登录授权,坐在电脑前干活时连手机都不用碰,直接在对话框里下达指令就能安排音箱播放——自己不硬造封闭的 AI 语音助手,而是把控制权开放给用户最常用的 AI 工具,这确实很符合「音频操作系统」的定位。 至于 Sonos 27 这次主打的拿两台 Sonos Play 当临时后环绕,还有和新款耳机 Ace Ultra 的无缝切换,只能留在未来有机会入手再慢慢感受了。而除了看电影和刷剧,在不打开电视的大部分时间里,Beam Ultra 其实直接承

    匹配字段正文

  4. Replit Blog

    Replit 发布 ViBench 2.0:面向长周期软件构建的基准测试

    Replit 发布 ViBench 2.0,用于评测 AI 智能体从空项目出发、逐个功能构建完整产品的能力,包含 17 个产品、241 个功能请求和 544 个测试计划。GPT-6.1 Sol 以 65% 的 pass@1 领先,GPT-6 Astra 为 60%,Opus 5.5 为 49%,三者均通过超过 90% 的测试计划。Opus 5.5 平均约 70 分钟完成一次构建,比 Sol 快约 2.5 倍;DeepSeek V4.1 Flash 以约 $2.50 每次构建通过 77% 的测试计划,但没有开源权重模型能通过完整构建。

    ViBench 2.0: A Benchmark for Long-Horizon Software Building — cover image

    [1]的专项智能指数(SII),Fireworks 是我们在开放权重模型推理与训练方面的合作伙伴。SII 汇集了由从业者构建的基准测试,用于在跨行业的真实工作任务上比较开放、闭源和专项模型。 大多数编码基准测试,例如 DeepSWE [2],在现有代码库中交给智能体一个定义明确的任务。而在 ViBench 2.0 中,智能体从空项目开始,然后以 Uber、GitHub 或 Google Docs 等产品为蓝本,一次构建一个功能,最终打造出完整产品。 ViBench 2.0 包含十七个产品、241 个功能请求和 544 个测试计划。表现最好的模型 GPT-6.1 Sol、GPT-6 Astra 和 Opus 5.5 仅在其 49⁠-⁠65% 的构建中通过了全部测试计划。 我们为何构建 ViBench 2.0 我们以 ViBench 1.0 为蓝本进行建模 [3] 当时Replit用户正在构建的东西,比如协作白板和简历生成器。如今人们来到Replit是为了构建完整的业务,这些业务往往包含功能齐全的软件产品。ViBench 2.0衡量的是模型能否构建出这样的产品。 智能体根据一份简短规格说

    匹配字段正文

  5. Pragmatic Engineer

    Google 大规模软件工程与 CS 教育:对话 Titus Winters

    Titus Winters 在 The Pragmatic Engineer 播客中回顾了 Google 2010 年对 250M+ 行 C++ 代码的大规模重构,当时由 10,000 名工程师维护,团队用解析、匹配、代码生成、新旧 API 共存、分片、封禁旧模式、删除旧 API 七步完成,且全程早于 LLM 时代。他还谈到 Google 因 Search 无法按月发布而强制每项改动附带测试,以及他参与更新 ACM/IEEE 本科计算机课程指南、认为现有课程几乎都该推倒重来。

    1:32:08 Titus 理想的软件工程课程 1:36:27 进入科技行业的建议 1:38:35 书籍推荐 参考资料 在哪里可以找到 Titus Winters: 本集中提到的内容: • Harvey Mudd College:https://www.hmc.edu • UC Riverside:https://ucr.edu • Abseil:网站 · GitHub • OpenRewrite:文档 · GitHub • 无责事后复盘文化(Google SRE 手册):https://sre.google/sre-book/postmortem-culture/ • Cat Hicks 的《软件团队心理学》:https://www.amazon.com/dp/B0GQTCL1J4 • Adobe 任命 Anil Chakravarthy 为 CEO,接替 Shantanu Narayen:https://daringfireball.net/linked/2026/09/04/adobe-new-ceo • 开发、部署、运维:理解软件开发成本与价值的整体模型:https://que

    匹配字段正文

  6. Latent Space精选

    Google DeepMind 发布 Gemini 4 Carbon,登顶 Artificial…

    Google DeepMind 发布 Gemini 4 Carbon,在 Artificial Analysis Intelligence Index v5 上以 59 分排名第一,并在 HLE-Diamond、TB-Science 等 9 项评测中的 4 项领先。该模型主打网络安全与长周期任务,宣称在 SEC-bench Pro 上取得 88.2%、ExploitGym 上 54.8%、CWE-bench 上 71.0%,初期仅通过 Fairwind Program 向可信网络安全人员开放。规格上支持 1M token 上下文与 1M 最大输出,输入覆盖文本、图像、视频和语音,输出为文本;Artificial Analysis 列出的标准价格为每百万输入/输出 token 4/20 美元,另有 50% 上线折扣。

    (未经证实):据报道,The Information 称 Kimi K3.1 Pro 是从 GPT-6 Astra 蒸馏而来(@kimmonismus)。 Giotto:另外,“欧洲主权 AI”Giotto 被批评为基于 Kimi 的模型。批评者指出其基准分数已饱和,且其 EULA 禁止发布用户自己的基准数据(@oneill c)。 编程智能体与开发者工具 GitHub Copilot Fusion:Fusion 在运行时编排 Anthropic 和 OpenAI 的模型(@ArtificialAnlys)。 独立结果:在 AA Coding Agent Index 上,它在 Claude Code 中比 Opus 5.5 低 2 分。每项任务成本为 5.59 美元,而该配置为 11.42 美元,且每项任务使用 7.2M token。它以 71 分领跑 Terminal-Bench 4.0。 GitHub 的说法:GitHub 声称成本最多降低 77%,运行速度提高 40%。它还推出了 Copilot 自动化和多仓库 Copilot Projects(@kdaigle)。 T3 Cod

    匹配字段正文

  7. Hugging Face

    AnySpeechRecognizer 与 AnyDecisionModel:面向 Apple 平台的语音与决策开源模型

    AnySpeechRecognizer 在 Apple SpeechAnalyzer API 之上支持切换引擎,可选用 NVIDIA Parakeet TDT 0.6B v3(支持 25 种欧洲语言)、Moondream 后训练的 Parakeet Ultra、英文版 Parakeet Unified,以及阿里 Qwen3-ASR(0.6B/1.7B,覆盖 30 种语言和 22 种中文方言)。这些模型已转为 Core ML 发布在 Hugging Face Hub,Parakeet 转写 1 小时音频约需 20–40 秒,Qwen3-ASR 更慢且需数 GB 内存。包内还新增 Apple 框架没有的说话人分离模块 SpeakerDiarizer,基于 NVIDIA Streaming Sortformer,最多跟踪 4 位说话人。

    果。每个 hear 命令都需要 --backend apple、--backend parakeet 或 --backend qwen;在进行分析之前,请使用相同的后端和模型选项运行 hear prepare,以安装所需的资源。 在你的应用中试用它们,并告诉我们哪些功能可用、哪些不可用。欢迎在两个仓库中提交 issue 和 pull request。 链接 GitHub 上的 AnySpeechRecognizer GitHub 上的 AnyDecisionModel GitHub 上的 AnyDecisionModel-Examples GitHub 上的 AnyLanguageModel GitHub 上的 swift-huggingface 感谢 NVIDIA 提供 Parakeet、Sortformer 和 NeMo,感谢 Moondream 提供 Parakeet Ultra,感谢 FluidInference——其 FluidAudio 和 mobius 项目记录了 Parakeet 运行时和 Core ML 转换所遵循的约定,感谢 Cloudflare 提供 Clef,也

    匹配字段正文

  8. The Rundown AI

    Google 发布 Gemini 4 Carbon,17 项基准中登顶 15 项

    Google 发布面向网络安全与长时编码任务的前沿模型 Gemini 4 Carbon,在 Google 自家 17 项基准中登顶 15 项,但尚未公开,仅向部分网络安全防御人员开放。其在 Artificial Analysis 的 Intelligence Index 上得 59 分,超过 Claude Opus 5.5,比四周前的 Argon 提升 9 分;在长输入推理上领先 OpenAI Astra 和 Opus 24 分。API 介绍价为每百万 token 输入 2 美元、输出 10 美元,为 Opus 5.5 的一半,折扣期后翻倍至 Opus 的费率。Google 未公布扩大开放的时间。

    以获取信息。它还会寻找徽标。如果没有徽标,它会为他们创建一个。第三个智能体拿到样稿,并附在电子邮件中发送给该潜在客户。第四个智能体被设置为在潜在客户回复后作出回应,为他们预约通话,并将通话添加到日历中。” 在我们的社区工作流中心查看该工作流 → 🛠️ 热门 AI 工具 ⚙️ QVAC SDK - 可免费且私密地运行任何开源模型(聊天、图像、语音生成等)。在 GitHub 上试用并加星 💬 Nemotron 3.5 Transcribe - Nvidia 的可转录 40 种语言的 AI 🔴 ChatGPT Dot - OpenAI 的常驻智能体,现可通过短信使用 ⚙️ GitHub Copilot Fusion - 可为每项任务自动挑选 AI 模型的 Copilot 模式 赞助列表 📰 今日 AI 其他动态 OpenAI 正将数百名员工调入一个“作战室”,为下周的美国中期选举做准备,在本月标记出其模型上的俄罗斯和伊朗影响力行动后,搜寻 ChatGPT 的滥用情况。 Artificial Analysis 发布了其“智能指数”AI 排行榜的 v5 版本,如今更多依赖私有测试,中国开源模型在

    匹配字段正文

  9. Mistral AI精选

    Mistral 开放 Mistral Large 4(Le Chonk)权重

    Mistral 发布 Mistral Large 4(Le Chonk)的开放权重,这是一个 1 万亿参数的原生多模态模型,在预览版基础上继续强化学习,编码与防御性网络安全能力提升。它在 FrontierCode 2.0 上得分 19.7%,在 Artificial Analysis Coding Agent Index 上得 48%,与 GLM-5.3 基本持平,但每任务平均少用 47% token;Terminal-Bench 4.0 提升 13 个百分点至 41%。模型支持三种推理模式,采用修改版 MIT 的 Mistral Ecosystem Open-Weight 许可,API 定价为每百万输入 token $0.70、缓存输入 $0.07、输出 $2.10。

    Le Chonk signal

    前,必须先从 Mistral 获得单独的商用许可证。 从今天起,Mistral Large 4 的定价为 每百万输入 token $0.70 / M, $0.07 缓存输入 / M,以及 输出 / 百万 token / M tokens。 我们鼓励社区对 Mistral Large 4 进行测试。运行你自己的评估,挑战它的极限,并在 X、Discord 或 GitHub 上与我们分享你的发现。下一步计划Mistral Large 4 将成为新一代专用和优化版 Mistral 模型的基础。基于近期发布的 Voxtral 和 Timestral 等模型,我们将继续拓展开放权重 AI 的前沿,继续为开发者和企业提供更大的自由,以构建、定制并拥有自己的智能。Mistral Large 4全新开放权重的混合指令与推理 MoE,支持多模态输入;统一了指令、推理和智能体, Discord或 GitHub. 下一步 Mistral Large 4 将成为新一代专用和优化版 Mistral 模型的基础。基于近期发布的 Voxtral 和 Timestral我们将继续拓展开放权重 AI 的前沿,继续为开发

    匹配字段正文

  10. AWS Machine Learning

    用 Amazon Nova Act 实现智能体 QA 自动化,加速软件交付(第 3 部分)

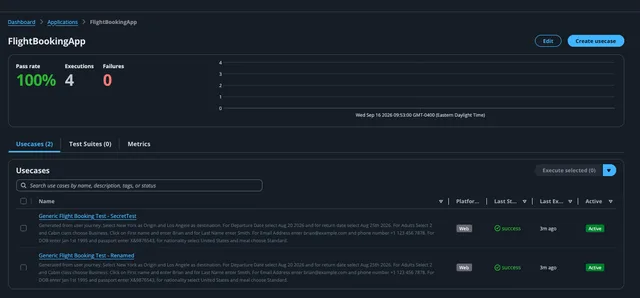
    AWS 博客介绍 QA Studio 基于 Amazon Nova Act 新增的两项能力:applications 把测试用例和测试套件归入带所有者的应用容器,并按应用和环境记录 CloudWatch 指标,给出 0–100 健康分(从通过率出发、对 flaky 测试扣分),支持 7 天/小时与 30 天/天两种趋势窗口。团队制用户管理设 Admin、Team Lead、Editor、Executor、Viewer 五级累积角色,每个应用只属于一个团队,权限按应用而非单个测试管理。

    QA Studio application detail page showing pass rate, executions, and failures above the use cases and test suites tabs

    Studio 参考解决方案的一部分,您可以使用 AWS Cloud Development Kit (AWS CDK)在自己的 AWS 账户中部署它。所有测试数据、结果和指标都保留在您的账户边界内。部署后,管理员创建团队、分配成员和角色,并将应用分配给团队。随着测试运行,每个团队的健康指标开始填充。 有关部署说明和配置详细信息,请参阅 QA Studio GitHub 仓库 及其文档。 结论 在本文中,我们展示了 QA Studio 如何将智能体 QA 自动化从单个测试扩展到整个组织。应用为每个团队的用例和测试套件提供了一个归属。它们通过通过率、趋势图、经不稳定调整的健康评分以及基于 Amazon CloudWatch 指标构建的失败分诊来报告健康状况。由 Amazon Cognito 支持的基于团队的用户管理,让每个团队在其拥有的应用范围内工作,跨团队共享受明确的上限规则约束。 这些能力建立在第 1 部分的自然语言测试编写以及第 2 部分的套件和 CI/CD 集成之上。它们共同帮助 QA 自动化在多个团队中扩展,同时不失去可见性或控制力。要在您自己的环境中试用,请从 QA Stud

    匹配字段正文

星期三

  1. gihyo.jp

    Google 开源 Elephant-Goldfish Model 插件,让 AI 分别负责设计文档的撰写与验证

    Google 于 2026 年 10 月 22 日宣布开源 Elephant-Goldfish Model(EGM)插件,用负责与用户对话并撰写设计文档的 Elephant 和在不继承对话历史的情况下独立验证文档的 Goldfish 相配合,找出规格中的模糊与遗漏。该插件先在 Google 内部为软件工程师开发,据称已有数千名员工日常用它开发生产代码,仓库采用 Apache 2.0 许可。10 月 27 日发布首个带标签版本 v0.1.0,共含 7 个技能,README 给出 Antigravity、Claude Code、Codex 的安装方法,但发布说明称各运行环境的验证尚未完成,尚不能称为稳定版。

    验证文档的AI相结合,以找出规格中的模糊之处和遗漏。 Introducing the Elephant-Goldfish Model plugin: scaling design-driven AI software development - Google Open Source Blog google/elephant-goldfish-model - GitHub 该插件是在Google内部为软件工程师开发的。据该公司称,数千名员工每天都在使用该插件开发Google的生产代码。公开仓库中包含可自定义的Markdown规则、评审用子代理的角色设定、评审步骤等。许可证为Apache 2.0。 Elephant推进设计,Goldfish验证设计文档 Google指出,AI在加快编写代码速度的同时,也会加速生成缺陷和低质量代码。此外,还提到了在与AI的会话中此前的上下文会丢失的问题。EGM旨在让人能够理解系统构成和设计理由,因此在编写代码之前先与AI敲定设计,并将相关判断记录在文档中。官方博客称,让AI从第一次起就生成符合意图的代码,是该手法的目标。 根据官方博客引用的Google的Da

    匹配字段正文

  2. Publickey

    Oracle 发布 Oracle App Composer:员工用 AI 自动生成业务应用并在 Oracle…

    Oracle 在 Oracle AI World 2026 上发布 Oracle App Composer,员工在聊天界面描述需求后由 OpenAI 的 Codex 生成业务应用代码,经安全检查后部署到 Oracle Cloud 并以 URL 在内部共享。信息部门可统一管理这些应用,设置负责人并下线长期无人使用的应用。该产品计划于 2027 年春季推出。

    oud以开源形式发布了“PyTorch”的AWS Trainium、Google Cloud TPU支持版本。致力于从NVIDIA迁移 “DuckDB 2.0 LTS”正式发布。通过Quack协议实现客户端/服务器功能以及通过异步处理实现高速化等 Cloudflare宣布推出将TypeScript移植到Rust的“tsrs”。相比TypeScript 7,内存最多减少70%,速度提升8倍。今后计划支持LSP等TypeScript的全部功能 “Cloudflare OS”将提供托管服务。加强与GitHub的连接以及与Gmail的联动等 AWS宣布推出“AWS Lambda Web Functions”,可在AWS Lambda上直接部署并运行Next.js、Hono等Node.js框架和应用 微软预览发布.NET工具链管理器“dotnetup”。可管理多个版本的.NET环境 为了让读者安心阅读文章所做的努力 Simple Analytics 100%隐私优先的分析 - 用于Simple Analytics事件的脚本 -- 全局网站代码(gtag.js)- Google Analytics

    匹配字段正文

  3. Latent Space

    Anthropic 取消编程面试:Felix Reiseberg 称"Hunger beats tenure

    Anthropic 招聘经理 Felix Reiseberg 宣布不再用传统编程面试考察候选人,理由是 Claude 在 React 挑战和汇编题上都已强于人,真正有影响力的构建者不靠这类测试取胜。他建议初级工程师选能带来业务影响的想法、周末做出可运行原型、只聚焦一个好点子,并发挥对用户的新鲜视角。同日 Google DeepMind 发布 Genie 4 世界模型,Artificial Analysis Intelligence Index v5 榜首为 Claude Opus 5.5(58 分)。

    dside)。 Axiom 形式化 CFSG:Axiom 宣布完成了有限单群分类的完整 Lean 自动形式化。原始证明横跨约 500 篇论文、由 100 多位数学家撰写,总计约 15,000 页(Axiom、Kevin Weil)。 过程:一个智能体集群在 24 天内产出了约 5000 万行 Lean 代码。智能体认领任务、互相审查工作,并在人类指导下通过 GitHub 合并,据称还修复了已发表证明中的数百处勘误(omarsar0、kimmonismus)。 背景:研究人员指出,这取代了四色定理,成为最大的计算机验证证明。很少有人能理解完整的 CFSG 证明(hyhieu226、Stella Biderman)。 指数时间假说:OpenAI 宣布在调和分析、复杂性理论和量子场论方面取得新成果,包括声称驳倒了 ETH,相关材料发布在其 openai/math 仓库中(Romain Huet、Dan)。 Anthropic 的平行声明:据报道,Anthropic 称 Claude 独立驳倒了 ETH,于 10 月 16 日找到了关键算法,“输出 1400 万 token,且无人类输入”。P

    匹配字段正文