←搜索结果

按匹配度 · 共 1629 条结果 清除搜索

星期四

  1. AWS Machine Learning

    在 Amazon Bedrock AgentCore 上构建企业级 Agentic AI 平台

    AWS 发布基于 Amazon Bedrock 与 AgentCore 的企业级 Agentic AI 平台蓝图,采用联邦式运营模型,由中央 Platform 团队提供受治理的共享服务,各 Workstream 团队保留对自身智能体、工具和数据的归属。平台通过独立的推理网关与 MCP 工具网关实施模型准入、区域限制、速率与 token 配额及预算控制,并以评估流水线在智能体上线前进行门禁校验。
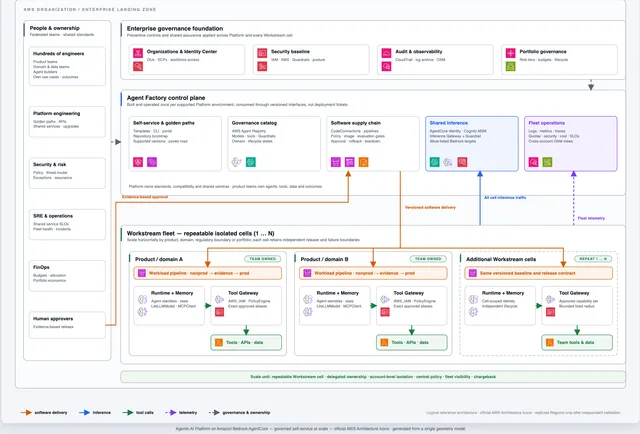
    Operating model linking the governance foundation, Platform control plane, and team-owned Workstream cells

    -1(爱尔兰)区域。替换组件、使用其他区域或进行更大范围的组织级推广时,需要单独提供其可用性、安全性、负载、回滚、可观测性和拆除方面的证据。 结论 在本文中,我们介绍了一个基于 Amazon Bedrock AgentCore 构建的企业级 Agentic AI 平台。该架构将集中治理的平台控制面与可重复、由团队自主负责的工作流单元分离,并设有独立的推理网关和工具网关,且生产环境的上线由已部署运行时评估进行门禁校验。 配套仓库包含一份蓝图,可对这些控制措施进行端到端验证,涵盖从流水线门禁、对抗性边界测试到零残余拆除的全过程。支持范围仅限于该经过测试的边界。 要开始使用,请从配套仓库部署一个具有代表性的工作流单元,验证其完整生命周期,然后基于同一版本化基线自动化部署更多单元。 相关资源: GitHub 上的企业级 Agentic AI 平台蓝图 在 AWS 上运行生产级 Agentic AI 的企业多账户架构(规范性指导) 在 Amazon Bedrock AgentCore 上构建企业级 Agentic AI 平台研讨会 Amazon Bedrock AgentCore 文档 关于作者

    匹配字段正文

  2. MarkTechPost

    MiniMax 开源 MCode Stack:17 个 Agent 技能与 5 份清单

    MiniMax 于 10 月 28 日以 MIT 协议开源 MCode Stack,包含其团队构建 MiniMax Code 所用的 17 个 SKILL.md 技能和 5 份清单,不含 MiniMax Code 源码。技能按规划拆分、上下文与工具、长会话与命令、评审、实验与热修分组,其中 independent-review 只向评审者提供 diff、需求和测试结果。可通过复制技能目录、本地插件或插件市场安装到 MiniMax Code,也能在 Claude Code 中用 /plugin marketplace add MiniMax-AI/mcode-stack 安装;原文未公布评测结果。

    团队开源的 Agent 技能仓库。MiniMax Code 是 MiniMax 的开源终端编码 Agent,同样采用 MIT 许可证。该技术栈不包含任何 MiniMax Code 源代码,只包含工作流、技能和清单。 TEXTTABLELAYOUT你的 PDF 解析器真的解析正确了吗?omni parse bench · 对文本、表格和布局评分 · 开源在 GitHub 上加星→赞助 该仓库与一个名为 MCode Engineering Notes 的专栏配套。每篇笔记解释一个理念,仓库则让该理念可运行。已发布的笔记涵盖子 Agent、工具上下文、压缩与记忆的对比以及长 bash 命令。一篇关于每轮上下文税的笔记标记为即将发布。 Ronny 的技术栈里有哪些技能? MiniMax 的技术栈包含 15 个技能,按工作日中的时机分组: 规划与拆分(3 个):subagent-split-check、engineering-small-prs、engineering-change-descriptions。 上下文与工具(2 个):tool-budget-audit、context-tax-

    匹配字段正文

  3. MarkTechPost精选

    Google DeepMind 发布 Gemini 4 Carbon,主打网络安全防御与编码

    Google DeepMind 推出 Gemini 4 Carbon,称其为面向长周期智能体编码和网络安全防御的前沿模型,在 Artificial Analysis Intelligence Index v5.0 上以 59 分排名第一。该模型在 GraphWalks 长上下文测试中取得 96.2%,在 SEC-bench Pro、ExploitGym 和 CWE-bench 上分别为 88.2%、54.8% 和 71.0%,但在 OSWorld-2.1 上以 81.5% 落后于 Claude Opus 5.5 的 87.2%。目前 Carbon 仅向经过审核的网络安全防御方开放,定价为每百万 token 输入 2 美元、输出 10 美元的引入价,后续为 4 美元和 20 美元,开发者和公众的开放时间未公布。

    n 之后的第二款 Gemini 4 模型。Google 团队表示,该模型面向艰难、长时间运行的工程工作。内部团队看到 Carbon 在单个任务上运行数天。示例包括在大型代码库和底层系统中对细微缺陷进行根因分析和修补。 TEXTTABLELAYOUT你的 PDF 解析器真的解析正确了吗?omni parse bench · 对文本、表格和布局评分 · 开源在 GitHub 上加星→赞助 Google 还针对全栈 Web 开发和多模态理解对 Carbon 进行了调优。在 WebDev Arena 上,Carbon 提升了 89 Elo 分,以 1769 分达到第 4 名。 Gemini 4 Carbon 在基准测试中表现如何? Google 在其发布文章中发布了 17 行对比。Carbon 以最高思考设置运行。根据 Google 的评估方法,大多数竞争对手的数字由各提供商自行报告。 智能体编码:Carbon 在 Terminal-Bench 4.0 (AA) 上得分 65.2%,领先于 Opus 5.5 的 59.6%。它在 SWE-sweep 上达到 9.6%,略高于 GPT-6 Ast

    匹配字段正文

  4. MarkTechPost

    NVIDIA 发布 Nemotron 3.5 Transcribe:开源 30B MoE 语音模型…

    NVIDIA 发布 Nemotron 3.5 Transcribe,这是一个开源权重的语音大模型,支持 40 种语言、单次最长 1 小时音频,可通过文本指令选择逐字、书面、说话人标注、上下文和翻译等输出形式。模型总参数约 34B、激活参数约 4.3B,采用混合 Mamba-Transformer MoE 架构,BF16 可在单张 H100 80GB 上运行,NVFP4 版本约 21GB 可在 RTX 5090 上运行。NVIDIA 自报其在 9 个公开英文 Open ASR 测试集上平均 WER 为 4.71%,为开源权重模型最好成绩,但商业 API 仍领先;短板是仅支持离线,中文远场会议 cpCER 为 34.95%。

    本。音频编码器将嵌入输入 LLM 解码器,使转录可通过提示进行。NVIDIA 的技术研究报告认为,不存在唯一正确的转录文本。数字、填充词和领域术语取决于谁阅读输出。NVIDIA 将该模型定位为转录专家,而非通用助手。 TEXTTABLELAYOUT你的 PDF 解析器真的解析正确了吗?omni parse bench · 对文本、表格和布局评分 · 开源在 GitHub 上加星→赞助 架构如何工作? 它由三部分组成: 并行专家编码器:一个可训练的 0.6B Transformer ASR 编码器与一个冻结的 Nemotron 3 Diarization 模型并行运行。说话人分离器最多跟踪 8 位说话人。其说话人活动每 80 ms 添加到 ASR 特征中。因此 LLM 无需架构改动即可看到谁在何时说话。 LLM 主干:Nemotron 3.5 Lightning 30B-A3B,一个混合 Mamba-Transformer MoE。它有 52 层:23 层 Mamba-2、23 层 MoE,仅 6 层注意力。每个 MoE 层路由到 128 个专家中的 6 个,外加 1 个共享专家。少量注

    匹配字段正文

  5. MarkTechPost

    AssemblyAI 发布首款语音合成模型 AssemblyAI-TTS-1,每百万字符 15 美元

    AssemblyAI 发布首款文本转语音模型 AssemblyAI-TTS-1 并正式开放,面向实时电话语音智能体,定价为每 100 万字符 15 美元,不设年度合同和并发档位。该模型仅以托管 API 形式在 us-east-1 和 eu-north-1 提供,支持 HTTP、WebSocket 和 OpenAI 兼容接口,内置 4000 多种音色、即时声音克隆和 6 种语言。厂商自测显示实体准确率 93.7%、首字节中位延迟 47 ms,但 Cekura 独立基准测得流式延迟 159 ms、朗读准确率 81.5%,且发布时尚不支持 SSML、语速控制和情感标签。

    音频训练,包括真实对话数据。大多数 TTS 模型将音频表示为离散 token。AssemblyAI 表示,TTS-1 改为基于连续音频表示运行。AssemblyAI 声称这提升了真实感并缩短了首个语音音频的生成时间。 TEXTTABLELAYOUT你的 PDF 解析器真的解析正确了吗?omni parse bench · 对文本、表格和布局评分 · 开源在 GitHub 上加星→赞助 此次发布包含 4,000 多种音色的库和即时声音克隆。克隆需要一段简短录音并确认说话者许可。发布博文中的克隆使用了 24 秒音频。发布时支持六种语言:英语、西班牙语、法语、德语、意大利语和葡萄牙语。 开发者如何集成 AssemblyAI-TTS-1? 共有 3 种接口:HTTP API、WebSocket API 和 OpenAI 兼容路由。WebSocket 会话为每个对话保持一个连接,并接受取消消息以支持打断。输出为单声道 PCM、mu-law 或 A-law,采样率 8 kHz 至 48 kHz。24 kHz PCM 是原生格式;电话技术栈可直接请求 8 kHz mu-law。包含词级时间戳。Ass

    匹配字段正文

  6. MarkTechPost

    Block 发布纯语音训练的全双工语音模型 Dessa

    Block 的 AI 研究实验室发布全双工语音模型 Dessa,以研究预览形式开放候补名单,只用人声对话音频训练,未使用文本和预训练模型。该模型可在 MacBook Pro M4 Max 或更高配置上本地运行,速度快于实时;训练使用 1 台 NVIDIA GB200 NVL72(72 块 GPU),目前未公布基准分数、参数量、权重、论文或 API。

    :公布 0 项基准分数。没有权重、论文、API 或价格。 Block 的 Dessa 是什么? Dessa 是一个真正的语音到语音模型:音频输入,音频输出。根据 Block 的项目页面,它所知道的一切都来自人类语音。 TEXTTABLELAYOUT你的 PDF 解析器真的解析正确了吗?omni parse bench · 对文本、表格和布局评分 · 开源在 GitHub 上加星→赞助 它是全双工的,因此能边说边听。Block 表示,它从真实对话中学会了何时插话。它还学会了何时用“yeah”或“got it”这样的简短提示进行附和应答。 Block 的演示片段显示,Dessa 会在句中发笑,并在被要求大声说话时提高音量。其中一个片段展示了它与 OpenAI 的 GPT-Live-1 对话。Block 表示,没有任何片段经过人工引导。 纯语音训练是如何工作的? 大多数语音系统串联 3 个部分:语音识别、文本模型,然后是语音合成。Block 团队认为,这条链路会丢弃情绪、讽刺、笑声和叹息。Dessa 直接接收并生成这些信号。 Block 尚未公布架构。以下是它已披露的内容: 训练数据:仅人类

    匹配字段正文

  7. MarkTechPost

    Infini-AI-Lab 开源 Hermit harness 适配器框架

    Infini-AI-Lab 发布开源框架 Hermit,通过训练外部 harness 适配器来适配 AI 智能体,模型与 harness 保持冻结,v0.1.0 于 2026 年 10 月 25 日发布。框架为 Python 实现、Apache-2.0 许可,可用 pip install hermit-harness 安装,内置 GEPA、SkillOpt、MetaWorld Model、Harness² 和 Continual Harness 五种演化方法。在 GLM 5.3 Flash 上,MWM 适配器在 CL-Bench 数据库探索任务达到 0.795 准确率,高于 in-context 基线的 0.580,但多数结果为单次运行的自报数据。

    次运行、自报数据。 什么是 harness 适配器? harness 适配器是一种可训练的外部 harness。它像一个内置训练支持的插件。模型适配器(如 LoRA)适配模型。harness 适配器则适配现有智能体。 TEXTTABLELAYOUT你的 PDF 解析器真的解析正确了吗?omni parse bench · 对文本、表格和布局评分 · 开源在 GitHub 上 Star→赞助 适配器可以承载指令、技能、记忆、工具、可执行代码和智能体协调逻辑。它甚至可以是一个完整的仓库。其规范说明了哪些部分可学习,以及更新如何被检查。基础模型和 harness 永不改变。 团队给出了这一设计的 3 个理由。许多 harness 是闭源的。编辑开源 harness 可能破坏精心调校的组件交互。而学习到的适配器可以在兼容的模型和 harness 之间迁移。 Hermit 如何训练适配器? Hermit 使用 RL 风格的训练循环。Trainer 使用当前适配器让执行智能体运行一批任务。Judge 对输出评分。Evolver 读取轨迹和反馈,然后提出新的适配器。Trainer 对照模板检查它,并

    匹配字段正文

  8. Databricks Blog

    语音智能体已就位,Databricks 用上下文让它真正服务客户

    Databricks 提出语音智能体的价值不在能对话,而在结合上下文、本体和治理数据实时理解来电者并执行规则。其原型用 LiveKit 承载通话、Deepgram 做语音转文字与默认语音、ElevenLabs 提供表现力语音,并可将通话交给人工。智能体运行在客户数据所在处,通过只读查询连接订单、忠诚度和 CRM 系统,并以 DIVA blueprint 作为下一个场景的起点。

    能体得以改进。每通电话都可以自动进行质量评分,联络中心和客户体验负责人可以用自然语言询问有关其通话的问题,例如上周二退款请求为何激增。这些洞察随后可以反馈到更好的提示词和模型中,进一步提升语音智能体的有效性。 在Databricks上开始使用语音智能体 开始使用并不需要大型项目。构建模块今天已经可用,而 Databricks智能语音智能体(DIVA)蓝图已在GitHub上开源,为你的团队提供了一个可用的起点。语音随后成为你已有系统之上的一个新渠道。 语音智能体负责承接填满队列的常规通话,例如订单状态、续药和重新预订,让你的员工能够专注于需要人工的对话:情绪激动的客户、复杂的请求,或者只是更愿意与人交谈的来电者。当员工接起电话时,完整历史已经显示在其屏幕上;如果出现任何问题,通话会连同完整记录转接给人工。 这就是客户服务的未来方向。 Gartner 预测,到2029年,智能体AI将 在无需人工干预的情况下自主解决80%的常见客户服务问题 ,从而使运营成本 降低30%. Databricks 的行业工程师建议先从一个 90 天试点开始,覆盖一个渠道、一个团队,以及你们话务量最高的常规通话,

    匹配字段正文

星期五

  1. AWS Machine Learning

    Epsilon 用 Amazon Nova Act 构建意图驱动的 UI 测试

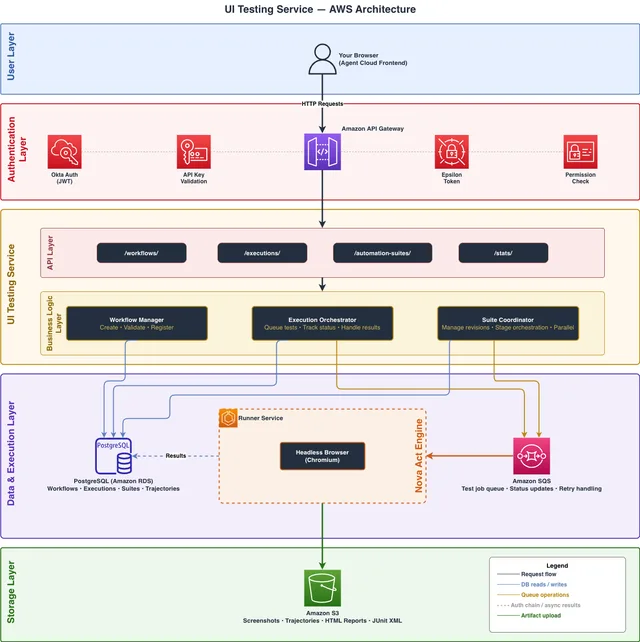
    Epsilon 的 Agentic Platform 团队用 Amazon Nova Act 结合 Amazon Bedrock AgentCore Browser,把意图驱动的 UI 测试做成多租户平台服务,叠加在原有 Playwright 回归套件之上。测试步骤用自然语言编写,由 Nova Act 通过 CDP WebSocket 执行,并逐步骤截图、统计通过率,结果存入 Amazon S3。该方案提供托管临时浏览器会话、基于 AWS IAM 的认证和跨账户 AssumeRole 隔离,文中还给出一个 18 步测试工作流。

    Epsilon UI Testing Service architecture with user, authentication, API, execution runner, and Amazon S3 storage layers

    动的 UI 测试作为托管服务交付。你可以将同样的模式应用到自己的多租户平台,从而消除浏览器基础设施开销,并让非工程师也能轻松编写测试。 如果你想使用 Amazon Nova Act 和 Amazon Bedrock AgentCore Browser Tool 构建类似的意图驱动 UI 测试能力,以下资源可供入门: Amazon Nova Act 文档 Amazon Bedrock AgentCore Browser Tool 用户指南 PyPI 上的 Nova Act Python SDK Amazon Bedrock AgentCore 文档 Nova Act + Amazon Bedrock AgentCore Browser Tool 示例代码(GitHub) 相关文章: 使用 Amazon Nova Act 通过代理式 QA 自动化加速软件交付 如需进一步了解贵组织如何利用意图驱动的浏览器自动化进行测试,请访问 Amazon Nova Act 产品页面. Epsilon 是 Publicis Groupe 旗下公司。如需了解更多信息,请访问 epsilon.com. 关于作者

    匹配字段正文

  2. MarkTechPost

    Prime Intellect 发布 Prime Mega MoE 训练内核,前向最高提速 3.11 倍

    Prime Intellect 发布 Prime Mega MoE,在 DeepSeek 开源 DeepGEMM 库的 Mega MoE 内核基础上补上了融合且重叠的反向传播,使其可用于训练而非仅推理。在 prime-rl 训练器中,Qwen3 MoE 模型的完整训练步比基线快 32% 至 34%,比 TorchTitan 快 48% 至 55%;单层前向最高提速 3.11 倍(12.0 ms 降至 3.9 ms),但 Qwen3-235B-A22B 的反向仅提速 1.24 倍。该内核支持 BF16、Blackwell 上的 MXFP8 和 Hopper 上的 blockwise FP8,以 Apache 2.0 随 prime-rl 发布,通过 mega_moe 分发后端启用。

    Mega MoE? Prime Mega MoE 是 Prime Intellect 推出的用于训练的融合、重叠 MoE 内核。它构建在 DeepSeek 开源 DeepGEMM 库中的 Mega MoE 内核之上。 TEXTTABLELAYOUT你的 PDF 解析器真的解析正确了吗?omni parse bench · 对文本、表格和布局评分 · 开源在 GitHub 上加星→赞助 为什么 MoE 训练受通信限制? 在 MoE 模型中,每个 token 被发送到一小部分专家。这些专家位于不同的 GPU 上。因此每一层都会发送 token、运行专家计算,然后发送结果回来。这在前向传播中发生一次,在反向传播中再次发生。 在标准设置中,这些是相互独立的操作。GPU 先对 token 排序,并等待传输层。然后进行计算,交回结果,再次等待。这些等待就是 GPU 的空闲时间。 融合内核是如何工作的? DeepSeek 的 Mega MoE 于 2026 年 4 月加入 DeepGEMM,用一次内核调用取代了这条链路。它融合了专家并行分发、2 个专家线性层、SwiGLU 和合并。当一组 token

    匹配字段正文

  3. MarkTechPost

    Baseten 发布 2B 决策模型 joey-1,每百万 token 定价 0.01 美元

    Baseten 旗下 Base Labs 发布 2B 决策模型 joey-1,基于 Qwen3.5-2B 后训练,直接返回标签和校准概率而非生成文本,面向高并发路由、分类和护栏检查。模型在 Jev Decision Index 0.4 公开集得分 63.30,为 4B 以下最高,但比 9B 的 elephant-1 低 8.94 分。Model APIs 定价每百万输入 token 0.01 美元,平均 2000 token 请求 P50 延迟 20 ms,权重以 MIT 协议开源在 Hugging Face,可单张 CUDA GPU 自托管。

    旗下 Base Labs 推出的 2B 决策模型,可在 1 次前向传播中回答结构化问题。你发送一个状态(文本或图像)和 1 个或多个问题。模型会为每个问题的每个选项返回一个概率。它不会生成需要你的应用解析的自由文本。 TEXTTABLELAYOUT你的 PDF 解析器真的解析正确了吗?omni parse bench · 评测文本、表格与布局 · 开源在 GitHub 上加星→赞助 它支持 3 种问题类型: choice:从命名选项中选择 1 个,例如哪支团队负责某个工单。 yes/no(API 中为 noul):返回“是”的概率。 score:有序等级,从低到高,例如紧急程度。 joey-1 是该系列的第 3 个成员。Baseten 上周发布了 mammoth-1(27B)和 elephant-1(9B)。这 3 个模型共享训练数据和 /v1/systemone API,因此切换只需改 1 行代码。 joey-1 如何工作? Base Labs 对 Qwen3.5-2B 进行了语言模型的全参数微调后训练。视觉编码器保持冻结。全注意力层使用块双向掩码。所有问题都从 1 次共享前缀预填

    匹配字段正文

星期三

  1. MarkTechPost

    Google DeepMind 发布 Genie 4 实时世界模型,原生生成音频

    Google DeepMind 以研究预览形式向受信任测试者发布 Genie 4 世界模型,可根据文本和图像提示实时生成可探索世界,并原生生成环境音、音乐和角色对话。该模型在仿真循环中引入 Gemini 3.8 Flash 作为规划器,负责拆解目标、检查画面并重新规划,DeepMind 称这是迈向混合世界模型的早期一步。Genie 4 仅托管在 Google 平台,后续将开放给 AI Ultra 用户和 Gemini API 合作伙伴,所有视频与音频均带 SynthID 水印。

    仅持续几分钟,且反复编辑提示后物体会发生漂移。 什么是 Genie 4? Genie 4 是 Google DeepMind 的世界模型,逐帧模拟交互式环境。它不是视频片段生成器。每一帧都会在用户输入到达时作出响应。 TEXTTABLELAYOUT你的 PDF 解析器真的解析正确了吗?omni parse bench · 对文本、表格和布局评分 · 开源在 GitHub 上加星→赞助 DeepMind 表示该模型原生多模态。音频、音乐和对话与视觉内容一同生成。这是 DeepMind 首个原生生成音频的实时世界模型。 它接替了 2025 年 8 月发布的 Genie 3。Genie 3 以 720p 和每秒 24 帧运行,视觉记忆可回溯 1 分钟。 Genie 4 如何使用 Gemini? Genie 4 借鉴了 Gemini 家族的两个部分。Gemini Omni 锚定每个世界的外观和行为。其他 Gemini 模型负责保持仿真连贯性的推理。 运行时循环的工作方式如下: 解读:当你输入提示时,Gemini 会调整提示以适配正在运行的场景。 规划:Gemini 3.8 Flash 将目标拆

    匹配字段正文

  2. MarkTechPost

    Polymathic AI 与普林斯顿大学发布 FlashMap:用流映射草稿器实现 6.14 倍 LLM 解码加速

    Polymathic AI、普林斯顿大学等机构发布 FlashMap,用连续流映射替代离散扩散草稿器,一次前向传播草拟 16 个 token 的完整块。在 Qwen3-8B 上,GSM8K 温度 0 时实现最高 6.14 倍无损加速,草稿器仅 0.5B 参数。Qwen3-8B 和 Qwen3-4B 的草稿器权重已上架 Hugging Face,并提供 vLLM 和 SGLang 插件。

    草稿器,可在 1 步内将高斯噪声映射为 token 块。小型草稿器提出 K 个 token。随后目标模型在 1 次并行传播中检查全部 K 个 token,并保留最长的匹配前缀。输出与目标模型原本会生成的结果完全一致。 TEXTTABLELAYOUT你的 PDF 解析器真的解析正确了吗?omni parse bench · 对文本、表格和布局评分 · 开源在 GitHub 上加星→赞助 速度取决于 2 件事:草拟的 token 中有多少被接受,以及草拟这些 token 的成本有多低。EAGLE-3 以自回归方式草拟,因此成本随块长度增长。DFlash 通过块扩散在 1 次传播中草拟整个块。 为什么扩散草稿器的接受率会下降? DFlash 独立预测块中的每个槽位。研究团队称之为因子化近似。设想一个续写可能是“new york”或“san diego”,两者概率相同。独立草稿器有一半时间会提出“new diego”或“san york”。目标模型会在第 2 个槽位拒绝这些结果。 FlashMap 基于 Flow Map Language Models 构建。每个噪声样本映射到 1 个完整块。

    匹配字段正文

  3. Simon Willison

    Simon Willison:2026 年 10 月是 vibe coding 游戏开发的拐点

    Simon Willison 认为 2026 年 10 月是 vibe coding 游戏开发的拐点,Claude Opus 5.5 在 3D 建模、音乐生成和游戏设计上有明显提升,他让模型把游戏改得更有趣后,用几周时间做出四个自己真正愿意玩的浏览器游戏。这些项目每个投入不超过四小时,均用 HTML 和 JavaScript 构建并运行在浏览器中;他建议从「Build a mobile-friendly three.js game where...」这类提示词起步,项目过了原型阶段再换用 Claude Code 或 Codex。

    实在太有趣了。它是 vibe coding 的完美应用场景,因为风险太低了:在一个个人的 vibe coding 游戏项目里,一个 bug 能造成多大破坏呢? (好吧,确实可能造成一些破坏……我尝试的基于音频的多人游戏让我妻子 Natalie 头疼得厉害!) 到目前为止,我所有的游戏都是用 HTML 和 JavaScript 构建的,并使用静态托管(通常是 GitHub Pages 或 Cloudflare Pages)。现代浏览器——包括移动浏览器——的能力强得惊人。前沿模型已经了解 three.js 和 Phaser 这类库。我发现这些移动网页游戏与原生体验难以区分,至少对于我试图构建的这类游戏而言是如此。 我建议从这样的提示词开始: 构建一个移动端友好的 three.js 游戏,其中…… 这在 chatgpt.com 和 claude.ai 上都能用——你甚至不需要启动一个完整的编码智能体。作为最后一个例子,这里是 Claude Opus 5.5 Extra 和 GPT-6 Extra High 分别给出的“构建一个移动端友好的 three.js 游戏,其中一只老鼠必须躲避一只猫

    匹配字段正文

  4. 雷锋网

    逐际动力开源 FluxVLA Engine 更新,打通具身智能数据训练评测部署全流程

    逐际动力开源的具身智能工程底座 FluxVLA Engine 于 10 月 22 日完成重要更新,技术报告显示其已把 OpenVLA、π0.5、DiT4DiT、GR00T 等异构策略纳入同一套数据、训练、评测与部署流程。在英伟达 AGX Orin 64GB 上,GR00T 推理频率从 3.2Hz 提升到 7.4Hz,π0.5 从 1.4Hz 提升到 4.4Hz;配合 RTC 和轨迹后处理三步机制衔接真机执行。在线 RL 方面,SmolVLA 在 LIBERO-10 上成功率从 66.2% 升至 76.2%,在 RoboTwin Clean 的 10 个任务上从 45.9% 升至 61.3%。

    人本体之间,数据结构、动作语义、接口的差异客观存在,谁也抹不掉。FluxVLA 用标准接口和模块化设计,把这些差异集中到可检查、可适配的环节——组合出问题的时候,能让人知道具体出在哪里。在工程可靠性上,这种让问题暴露出来的姿态,比假装一切都兼容更有价值。作为一家具身智能主机厂,逐际动力在本体、算法研发和真机运行中踩过的坑、验证过的流程,本可以当作护城河,服务于自身产品,但他们选择将一线经验转化为开放的标准化工程底座,以企业级资源为外部开发者、算法团队和其他机器人平台提供了使用与协作的更多可能性。当然,这并不意味着开源项目已经自然形成了成熟的行业生态。真正的生态还需要外部团队持续使用、贡献适配、反馈问题,并在不同场景中验证其价值。但开放的接口与可复用的工具,至少为这样的协作提供了基础。FluxVLA Engine 代码仓库:https://github.com/FluxVLA/FluxVLA 技术报告:https://arxiv.org/abs/2609.17210Hugging Face:https://huggingface.co/limxdynamics/FluxVLAEngine

    匹配字段正文

  5. 邵猛

    Hugging Face 分享工业界训练 Agent 的实践:环境、评测与奖励比模型更难

    Hugging Face 发布四场分享、圆桌与问答,讨论工业界训练 Agent 的落地做法,核心结论是环境、评测与奖励设计比模型本身更难。Miles 在 Terminal Bench 2 上用 64×B300 全异步训练,约 100 步后奖励从约 0.44 升到 0.56;OpenEnv Arena 从约 9 万个可找到的 RL 环境中层层过滤后仅剩约 800 个较干净可用。分享还提到 Agent 在沙箱中找到参考答案、改动评分逻辑假过等作弊问题,以及约 1% 的作弊题会污染整轮训练。

    Training Agents(轨迹 SFT → 蒸馏 → GRPO → 搭 RL 环境)的线下延续,重点讲工业侧的实现。 PPT 合集: https://t.co/mvOl6omthQ 系列课程: https://t.co/jDCMFTlXGn Youtube 视频: https://t.co/NBRXbikmbL Gobind(Microsoft / GitHub & Foundry)-- 企业 RL 传统大企业(工业、制造、能源)买的是业务指标:延迟、准确、以及后训练的风险可控;关心整条链路(工具、数据、网络、harness、墙钟),不是某一个模型。真实 Agent 常挂几十到上百个工具,很多问题要当分布式系统来解。做法上:先快速定制现成 harness,用生产轨迹搭仿真,再故意扰动(过期数据、超时),配上功能正确与安全类校验器。后训练是 SFT / 蒸馏 / DPO / RL 混用;倾向模块化决策模型,而不是凡事一台前沿大模型。展望包括:以后更多手搓奖励与环境;GitHub 上会出现可发现的「gym」资源;物理 AI 与对齐、监管会跟上。 Victor(Mercor,前 Si

    匹配字段正文

  6. 面壁智能 OpenBMB

    面壁智能开源 MiniCPM-OCR 套件,含 1B 解析模型与 2B 校验模型

    面壁智能发布开源 MiniCPM-OCR 套件,包含 1B 的 MiniCPM-OCR 1.0 与 2B 的决策模型 MiniCPM-OCR Jev。MiniCPM-OCR 1.0 在 Real5-OmniDocBench 得分 93.68、OCRBench v2 得分 54.7;Jev 可跨模型校验文本、公式和表格,在 JevOCRBench 得分 93.6,超过 JEV-35B-A3B 的 90.1,接近 Qwen3.5-397B-A17B 的 93.8。借助 DSpark,其速度为 PaddleOCR-VL-1.6 的 1.49 倍、MinerU2.5 Pro 的 3.62 倍,SDK 并发优化后可达每分钟 128 页,并支持 vLLM、SGLang、llama.cpp 和 Ollama 部署。

    JEV-35B-A3B(90.1),并接近 Qwen3.5-397B-A17B(93.8)。 每分钟最多 128 页 🤯:借助 DSpark,MiniCPM-OCR 的运行速度是 PaddleOCR-VL-1.6 的 1.49 倍、MinerU2.5 Pro 的 3.62 倍。SDK 的并发优化进一步将吞吐量提升至每分钟多达 128 页。 在你工作的地方部署:Day-0 支持 Arm、后摩智能、Intel 和 NVIDIA,并通过 FlagOS 支持另外 10 家芯片厂商。 适配你的技术栈:vLLM、SGLang、llama.cpp 和 Ollama,并提供量化模型、微调支持和 Agent Skills。 🔗 GitHub:https://t.co/2SlATAJk08 🤗 Hugging Face: MiniCPM-OCR 1.0:https://t.co/i347di4Fju MiniCPM-OCR Jev:https://t.co/ayVzhCJenh 👉 试用 Demo:https://t.co/QsFAJT3AFy 使用 API:https://t.co/dP01jBS2j2

    匹配字段正文

  7. 钛媒体 · AGI

    Edge AI Daily 早报:Anthropic 递交 IPO、OpenAI 发布 GPT-6.1…

    Anthropic 于 2026 年 10 月 26 日向 SEC 递交 S-1,拟以“ANT”登陆纳斯达克,IPO 估值或超 2 万亿美元。OpenAI 同日发布 GPT-6.1 Terra,标准 API 每百万输入 token 1 美元、输出 5 美元,完成任务速度超旗舰 GPT-6 Astra 三倍以上。Google DeepMind 推出世界模型 Genie 4 研究预览,首次实现声音与画面同步生成,一致性时长翻倍至两分钟。

    行业重心从“跑多快”转向“怎么刹车”。 开源趋势: 十一、Ollama for Mac 会说话了 1.2026年10月24日,Ollama官方博客宣布正式支持文本转语音,首个模型为Gradium开发的Phonon小参数语音合成模型,macOS(Apple Silicon)率先上线,Windows与Linux随后跟进。Ollama是本地AI基础设施的事实标准,GitHub上拥有近18.5万颗星、约1.86万个分支,此次更新使本地大模型从“能读会写”迈向“能开口说话”。 2.语音本地化的三大动因是延迟、隐私、成本:借助苹果MLX框架的统一内存架构,Phonon在MacBook Pro M5 Max上生成速度比Gradium自家运行时快35%,词错误率与Hugging Face Transformers参考实现持平,并支持流式实时生成。资本层面,Gradium于2025年12月以7000万美元种子轮走出隐身(FirstMark Capital、Eurazeo领投,埃里克·施密特等跟投),2026年7月该轮融资扩大至1亿美元、英伟达加入。 3.局限与影响并存:Phonon目前仅支持Apple

    匹配字段正文

  8. Thurrott

    RTX Spark 本地 AI 编程实测:反复尝试仍未找到稳定可复现的方案

    作者在 RTX Spark 上多日尝试本地 AI 编程,始终没能找到稳定可复现的流程。他测试了 Hugging Face 随 RTX Spark 一同发布的 Llama Windows——llama.cpp 的图形前端,但本地模型版本与尺寸选择、开发环境报错等负担全落在用户身上。目前只有通用聊天场景算小幅成功。

    验。而且,说清楚一点,也一直在大量失败。今天早上,似乎是第无数次了,我决定再试一次,并且再次更换我使用的工具和模型。这基本上就是我过去几周几乎每天都在做的事。 今天的实验是:LLama Windows 以及一系列模型选择,还有一个让你间接感受这种痛苦的机会。 你可能还记得,Hugging Face 把 Llama Windows 的发布时机安排在了本月早些时候 RTX Spark 电脑上市之时。它是 llama.cpp 开源 AI 推理引擎的图形前端,而 llama.cpp 是 LM Studio Bionic 和 Ollama 等热门本地 AI 应用所使用的事实标准。这一点很重要,因为 llama.cpp 是一个命令行界面(CLI),大多数人会觉得使用起来很复杂。 你可以在 GitHub 上找到 llama.cpp,如果你心情好得过头,它是个合适的选择。在 Windows PC 上,你当然要从命令行安装 llama.cpp,但奇怪的是,你并不使用 Windows 包管理器(winget);相反,你要在 PowerShell 中使用 Invoke-RestMethod 命令,或者更……

    匹配字段正文

  9. Unite.AI

    Perplexity 发布 LLM 网关实践指南,梳理请求链路与生产风险

    Perplexity 于 2026 年 10 月 27 日发布 LLM 网关实践指南,说明这一中间层如何路由、鉴权、缓存和记录模型调用,并区分 API 网关、LLM 网关、MCP 网关与 AI 网关四类形态。指南以六步请求生命周期拆解机制,同时警告网关集中了各家供应商凭证,并引用 Microsoft 披露的 LiteLLM 网关入侵事件和 Check Point 报告的 CVE-2026-35029、CVE-2026-59823 两个高危漏洞(已在 LiteLLM 1.83.9 修复)。文中还列出 Cloudflare AI Gateway 与 OpenRouter 的故障复盘、四条部署路径及约 50 美元/月起的付费方案。

    9,一个访问控制缺陷,使已通过鉴权的用户(包括只读用户)能够访问管理功能并接管网关;以及 CVE-2026-59823,一个服务端请求伪造漏洞,使用户能够将网关请求重定向到攻击者控制的服务器并捕获 AI 供应商的 API 密钥。两者均已在 LiteLLM 1.83.9 版本中修复。Check Point 报告称 LiteLLM 每月下载量达 9700 万次,GitHub 星标超过 59,000 个,并表示其向 LiteLLM 的协调披露始于 2025 年 10 月。 指南还建议团队为护栏设定故障策略。它将钩子描述为请求路径中的节点,网关在这些节点将内容交给外部扫描器以获取判定结果,并指出 Portkey 的文档列出了 before request hooks 和 after request hooks,而 TrueFoundry 运行四个钩子,在 MCP 工具调用前后增加了检查。 在可靠性方面,指南引用了有记录的故障事件。Cloudflare 对其 2025 年 6 月 12 日故障的官方说明指出,其 AI Gateway 的请求错误率峰值达到 97%,因为 AI Gateway 依赖

    匹配字段正文