Aaron Levie:智能体集群让算力成为关键变量
Box CEO Aaron Levie 认为智能体集群(agent swarms)将带来重大变化:它首次能把研究、数据处理、测试等受限于人力的工作并行化,理论上唯一关键参数是投入多少算力。他指出网络安全、生命科学、材料科学、交易、QA 测试等领域在模型足够强后本质上是算力受限问题,智能体可调用工具、写代码、处理数据并相互协作,只要设定正确目标并投入足够 token,就能解决任意复杂的问题。
匹配字段摘要、正文
Box CEO Aaron Levie 认为智能体集群(agent swarms)将带来重大变化:它首次能把研究、数据处理、测试等受限于人力的工作并行化,理论上唯一关键参数是投入多少算力。他指出网络安全、生命科学、材料科学、交易、QA 测试等领域在模型足够强后本质上是算力受限问题,智能体可调用工具、写代码、处理数据并相互协作,只要设定正确目标并投入足够 token,就能解决任意复杂的问题。
匹配字段摘要、正文
swyx 以《薄伽梵歌》对话体回应 lauren 关于“chat 是否是 agent UI 终极形态”的提问,称 X 上的人总以为自己是第一个希望终结 chat 的人。他认为人们嘴上说要离开 X、要终结 chat,实际却以更大数量回归,其真正渴望的不是真相而是“新”。
匹配字段摘要
普林斯顿大学与 Google 的新论文发现,在孤立问题上最准确的决策模型只解决了 69.5% 的智能体任务,而在智能体状态上训练的 4B 模型解决了 91.5%。其 harness 把每一步的工具选择交给快速决策模型,只有置信度超过在智能体自身运行上拟合的阈值时才采用其答案,并用智能体实际到达的状态(包括犯错之后的状态)训练了 AgentDecision-4B。在类似训练数据的任务上,这类 4B 模型让智能体成本降低 81.1% 至 89.0%、速度最高提升 2.5x,成功率差距在 3 个百分点以内;若不加阈值把所有工具选择都交出去,成功率下降 19.0 个百分点。论文地址为 arxiv.org/abs/2610.21412。
匹配字段摘要、正文
Arena 宣布未来 14 天内可在平台直接测试 OpenAI 的 GPT-Image-2.5 Sunburst,用户可在 Direct Mode 下拉菜单中选择该模型。Arena 称该模型在 Text-to-Image Arena、Image Edit Arena 和 Multi-Image Edit Arena 均排名第一。直接访问将于 11 月 2 日太平洋时间上午 8 点结束,之后该模型仍会以匿名形式出现在 Battle 和 Agent Mode 中。
匹配字段摘要
雷锋网梳理了三个案例:Anthropic 因 Claude 持续生成代码,7 名工程师用 5 个月开发出版本控制系统 Scion 并迁移核心仓库,主分支历史接近 100 GB,迁移后基础设施 CPU 和内存需求约缩小 200 倍;GitHub 用微调后的 ModernBERT 替换密钥扫描中的通用 LLM,线上 Post-push 扫描执行时间中位数下降 86%,模型服务成本下降超过 98%;哥伦比亚大学与 Google DeepMind 等机构提出 BTTF,把芯片仿真波形转成 SQLite 供 Agent 用 SQL 排查异常,在 4.2 GB 波形实验中执行准确率 95.33%。文章认为,随着 Agent 提高代码产出,瓶颈会沿交付链路向后移到 CI 的构建、测试与部署验证。
匹配字段摘要、正文
NVIDIA 向 Modal 交付首台 Vera CPU 服务器,在 Modal 自建的 Agentless Agent Bench(50 个 Terminal-Bench oracle 任务)上,Vera 让 Modal Sandboxes 吞吐量提升 2 倍。Vera 是 NVIDIA 面向 Vera Rubin GPU 平台的新 Arm 兼容 CPU,也可作为独立 CPU 服务器使用;Modal 此前只运行 x86 机器,需改造基础设施和镜像构建系统才能支持 Arm。Modal 称在重负载下 Vera 的延迟表现反而更好,打破了吞吐与延迟的常规取舍。

匹配字段摘要、正文
AI 音乐生成器 Suno 4.5 能把用户哼唱的片段转成完整编曲,作者借此把约 50 段旧录音生成数百首专业质感的歌曲,但听众只有自己。作者认为当“乐队”成本趋近于零,创作不再需要大众受众,这类“个人媒体”正随 coding agent 等工具一同兴起。
匹配字段摘要、正文
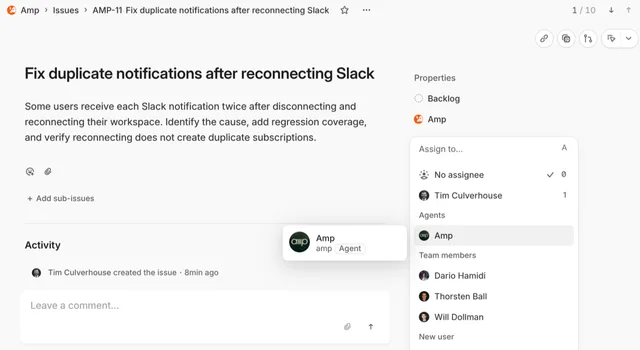
Amp 现已作为智能体接入 Linear,把 issue 指派给 Amp 即可在 Linear 中开启新的 Agent Session 并生成一个 orb,也可以用 @Amp 提及来启动会话。Amp 的回复会回到同一会话并回应过程中的消息,该 Agent Session 同时出现在 Amp 侧边栏,可在 Amp 中完整查看。
匹配字段摘要、正文
阿里巴巴达摩院在10月19日深圳举行的RISC-V中国峰会上首发面向自动驾驶和具身智能的处理器产品路线图,推动RISC-V进入全新领域。玄铁RISC-V处理器通过架构创新、软件兼容与生态合作,显著提升在Agentic AI和服务器等领域的表现,推动高性能RISC-V从“可用”走向“可靠”,迈向大规模量产落地。
匹配字段摘要、正文
MiniMax 发布 M3.1 Flash,定位 Coding/Agent 优化的轻量级模型,拥有 100 万 token 上下文,日常场景输出速度可达 200+TPS,P50 稳定在 170+TPS。其输入价格为每百万 Token 1 元、输出每百万 Token 4 元、缓存读取每百万 Token 0.1 元,约为 DeepSeek V4.1 Flash-1017 高峰期价格的一半。在 Automation-Bench v1.0.6 中它拿到 62.2 分,反超 DeepSeek 的 60.5 分;在 DeepSWE v1.1 上则为 73.7 分,低于 DeepSeek 的 77.0 分。
匹配字段摘要、正文
Box CEO Aaron Levie 认为,模型能力越强、能处理更长任务和更好工具调用,应用层按领域差异化的空间反而更大,而非缩小。他指出模型能力有限时只能做“wrapper”,而智能体调用工具、运行数小时至数天的任务、协调 agent swarm、领域专属数据与模型路由,都让系统专业化程度可能上升。他预计安全、生命科学、医疗、金融、制造等领域将出现此前难以构建的自主系统。
匹配字段摘要、正文
Hugging Face 首席政策官 Irene Solaiman 在 TechCrunch Disrupt 上表示,嵌入式 AI 评估器并非易行的解决方案,评估方法仍是一门不断演进的科学,业界尚不知如何有意义地相互比较,相关资质标准需要大幅提高。她指出评估结果的可复现性依赖开放权重,而 agentic 评估既困难又昂贵,目前针对模型、harness 和整体智能体的评估数量并不均衡。
匹配字段摘要
Cerebras 指出,agent 的表现取决于模型与 harness 的组合,而非模型本身。同一 Claude Opus 4.5 在标准化 SEAL scaffold 下 SWE-bench Pro 得分为 45.9%,经 Claude Code 使用则升至 55.4%。harness 的规划、重试、验证等每一步都要额外调用模型,因此快速推理能放大 harness 的效用。

匹配字段摘要、正文
ACM SIGAI 已开放 2027 年自主智能体研究奖(Autonomous Agents Research Award)提名,表彰在自主智能体领域有卓越研究、当前工作对该领域有重要影响的研究者。提名截止 2026 年 12 月 5 日,获奖者将于 2027 年 2 月 1 日公布,并受邀在 2027 年 5 月 3-7 日越南河内举行的 AAMAS 2027 大会上作主题演讲。
匹配字段摘要、正文
Browser Use 在 100 个 BU Bench V2.1 任务上对比了 Browser Harness、Playwright MCP、Chrome DevTools MCP 和 agent-browser,四者得分在噪声范围内打平,Browser Harness 以 2.1M 中位输入 token 和 42 次工具调用成为每任务成本最低($0.042)。作者同时给出选型建议:需要干净会话或 Firefox、WebKit 用 Playwright MCP,调试自家应用性能与网络用 Chrome DevTools MCP,需要域名白名单和加密凭据库用 agent-browser。文章披露作者所在公司开发 Browser Use 和 Browser Harness,竞品信息取自各自仓库与文档。

匹配字段摘要、正文
Claude Code v2.1.304 新增 `/auto-mode-setup` 引导式设置,可读取项目与近期会话让 auto mode 了解环境,并已支持 Bedrock、Vertex、Foundry、Claude apps gateway 及关闭遥测的会话。该版本还新增 `/claude-api managed-agents-secure`,用于对照 Anthropic 公开安全指南检查 Managed Agents 配置且不做任何改动。此外修复了 Linux 沙箱命令启动、`rm -r` 挂载盘安全提示、插件超出 `--max-turns` 继续运行等多项问题。
Claude Code v2.1.304 新增 /auto-mode-setup 引导式设置,可读取项目与近期会话让 auto mode 了解环境,并已支持 Bedrock、Vertex、Foundry、Claude apps gateway 及关闭遥测的会话。该版本还新增 /claude-api managed-agents-secure ,用于对照 Anthropic 公开安全指南检查 Managed Agents 配置且不做任何改动。此外修复了 Linux 沙箱命令启动、 rm -r 挂载盘安全提示、插件超出 --max-turns 继续运行等多项问题。
匹配字段摘要、正文
稀宇科技宣布 MiniMax M3.1 Flash 模型上线,线上推理速度提升近 3 倍,Agentic 类任务综合使用成本较前代降低 70%。该模型在 DeepSWE v1.1 取得 73.7%,在 OSWorld V2 取得 61.7 分、Agents' Last Exam 取得 29.6 分,两项电脑操作评测均位列国产模型第一。输入价格为每百万 Token 1 元、输出 4 元、缓存读取 0.1 元,现已上线 MiniMax API、MPlan 和 MiniMax Code,并将稍后开放权重。
匹配字段摘要、正文
千问办公(QwenWork)是阿里推出的一站式 AI Agent 生产力平台,主打“对话即交付”,用自然语言描述需求即可自动拆解多步骤任务,直接输出 PPT、Excel、网页、报告等成品文件。平台深度打通钉钉,支持 25 项钉钉相关能力调用,覆盖网页端、钉钉端和桌面客户端,其中浏览器自动化与本地文件读取仅桌面客户端支持。企业标准版 198 元/月/席、每席每月赠送 2000 积分,企业旗舰版 298 元/月/席(50 席起购),支持 VPC 部署与开放 API。
匹配字段摘要
钛媒体文章推演AI Agent替人竞价后竞争形态的变化:价格不再被发现而只是收敛,筛选标准从“谁更好”漂向“谁先出现”,上层投入的新增成本沉淀为下一层的入场门槛。Anthropic实验中,69名员工由Claude代理在内部市场交易,强弱模型混杂时强模型代理平均多完成约两笔交易,同一辆旧折叠自行车弱模型谈成38美元、强模型谈成65美元。作者称之为局部忠诚悖论:每方都忠实于委托人,账单却摊给所有人。
匹配字段摘要、正文
豆包手机助手《屏幕自动化操作声明协议》结束30天公示期后,超过150款主流App拒绝接入,京东是唯一默许的电商平台。文章认为京东自营电商靠卖货赚毛利、不依赖站内流量闭环,Agent截流对其冲击远小于淘天、拼多多等平台型电商,且京东与字节长期保持竞合关系。京东此前也已接入微信Agent和元宝,在Agent内以对话方式购物。
匹配字段摘要、正文