NEC 测试停车场新技术:司机下车后才开始计费
日本 NEC 与 UrbanChain 将于 9 月测试一套停车场计费系统,通过摄像头和 AI 分析实时视频,检测司机停入车位并下车后才开始计费,而非从进入停车场起算。测试将验证所需摄像头数量,两家公司还称该技术可发现长时间未下车的司机以提示健康风险。
匹配字段摘要
日本 NEC 与 UrbanChain 将于 9 月测试一套停车场计费系统,通过摄像头和 AI 分析实时视频,检测司机停入车位并下车后才开始计费,而非从进入停车场起算。测试将验证所需摄像头数量,两家公司还称该技术可发现长时间未下车的司机以提示健康风险。
匹配字段摘要
Meta 推出可本地运行的开源多模态模型 Muse Glimmer,由 2B 视觉编码器和 28B 文本解码器组成,总参数量为 30B。它支持图像、无音频视频、多模态工具调用和目标检测,并获得 Transformers、llama.cpp 及基于 Transformers 后端的 vLLM 支持。可选的 DFlash 推测解码器能以增加内存占用为代价加快生成。
Meta 推出可本地运行的开源多模态模型 Muse Glimmer,由 2B 视觉编码器和 28B 文本解码器组成,总参数量为 30B。它支持图像、无音频视频、多模态工具调用和目标检测,并获得 Transformers、llama.cpp 及基于 Transformers 后端的 vLLM 支持。可选的 DFlash 推测解码器能以增加内存占用为代价加快生成。 · Meta released Muse Glimmer, a locally runnable open-source multimodal model with 30B parameters, comprising a 2B vision encoder and a 28B text decoder. It supports images, video without audio, multimodal tool calling, and object detection, with support in Transformers, llama.cpp, and vLLM using the Transformers bac
匹配字段摘要
Wan 团队的新 SOTA 角色动画模型 Wan Animate 2 已在 ComfyUI 获得原生支持,驱动视频直接输入重新设计的 Diffusion Transformer,省去中间运动提取器,并支持文本驱动的视角控制。随模型上线两个节点:WanAnimate2ToVideo 负责接收参考角色与驱动视频,可选的 WanAnimate2Cache 缓存姿态分支,将生成时间大约减半。同系列还有面向流式角色动画的 Wan Animate 2 Lite,推理延迟降至实时水平,并支持视频续接与上下文窗口生成。

匹配字段摘要
Seedance 2.5 现已在 ComfyUI 中通过 Partner Nodes 提供,单次生成一段连续的 30 秒视频,并支持最多 50 个参考素材,包括 30 张图片、10 个视频和 10 个音频文件。该模型支持以时间轴方式编写提示词来控制镜头、景别与转场,可对已有视频做自然语言编辑和延长,并以 10 多种语言原生生成对白且匹配口型。用户更新 ComfyUI 或打开 Comfy Cloud,从 Templates 面板加载模板或下载 R2V、T2V 工作流即可使用。
匹配字段摘要
星海图 Galaxea 展示了一台仅依靠视觉折叠纸箱的机器人,全程为实时运行。该机器人未使用触觉或 F/T sensors,视频也没有加速。
星海图 Galaxea 展示了一台仅依靠视觉折叠纸箱的机器人,全程为实时运行。该机器人未使用触觉或 F/T sensors,视频也没有加速。 · Galaxea demonstrated a robot folding boxes using vision alone, with the entire process running in real time. The robot used no tactile or F/T sensors, and the video was not sped up.
匹配字段摘要
LG AI Research 在 CVPR 2026 上梳理了世界模型研究的演进:除 Genie 这类生成动作可控视频的基础模型外,还包括 MBRL 中的潜在动力学模型、JEPA 的抽象表征预测,以及机器人学习中预测物体轨迹、3D 轨迹和点流的做法。文章从“预测什么表征”和“预测结果如何使用”两个维度展开,并介绍了 AWS 这一基于信念空间推理、不生成未来帧的互补范式。
匹配字段摘要
NVIDIA 技术博客介绍世界动作模型(WAM),即用视频世界模型替代视觉语言模型骨干,为机器人策略提供预测场景演变的物理先验。文章称 WAM 能从多样交互数据中学习、泛化到未见环境,并以更少演示适配新机器人本体。其开源基础模型 Cosmos 3 基于 Mixture-of-Transformers 架构,训练数据含约 7.67 亿张图像、3.48 亿段真实动态视频和 800 万条动作样本,提供 4B Edge、16B Nano 和 64B Super 三种规模;其中 Cosmos3-Nano-Policy-DROID 与 Cosmos3-Edge-Policy-DROID 分别可在 RTX PRO 6000 工作站和 Jetson Thor 上以 15 Hz 控制频率部署。
匹配字段摘要
LongCat 通过一组附带提示词的视频演示智能体编程如何将创意转化为可观看、探索和游玩的作品。用户可使用 LongCat-2.0 尝试这些提示词并创作自己的版本,相关 API 与 Discord 链接已提供。
LongCat 通过一组附带提示词的视频演示智能体编程如何将创意转化为可观看、探索和游玩的作品。用户可使用 LongCat-2.0 尝试这些提示词并创作自己的版本,相关 API 与 Discord 链接已提供。 · LongCat shared a set of video demos, each with its prompt, showing how agentic coding can turn ideas into things people can see, explore, and play. Users can try the prompts with LongCat-2.0, create their own versions, and access the provided API and Discord links.
匹配字段摘要
Amp 发布 Attach Anything 功能,用户现在可以上传视频、日志、PDF、表格、数据集等任意文件到 orbs 供 Amp 查看和使用。官方列举了屏幕录制修复应用、日志调试、将演示文稿和表格转为交互式网站、从媒体输入生成视频和 CAD 文件、转录音视频等用例。
匹配字段摘要
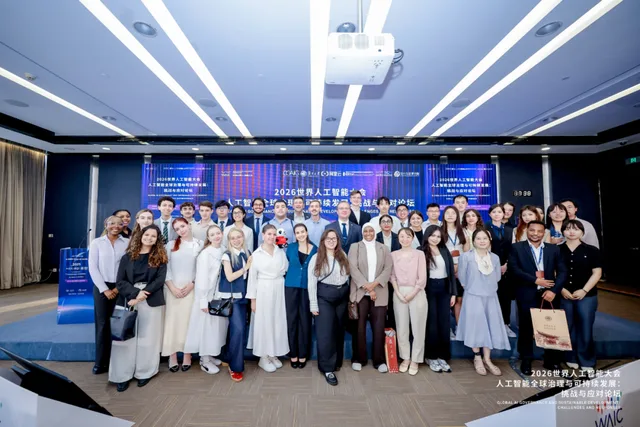
2026上海暑期学校金砖国家项目师生参加人工智能全球治理论坛,并参访中国—金砖国家人工智能发展与合作中心。论坛发布“一鉴”伦理审查智能体系统2.0、《全球人工智能治理指数(2026)》等成果;师生还体验MiniMax文生视频、智能眼镜和智能外骨骼机器人。
匹配字段摘要、正文
SGLang 维护方 RadixArk 与 Google Cloud 达成合作,把 SGLang 推理框架带到 TPU 上。目前开发者可通过 SGL-JAX 在最新几代 TPU 上运行 SGLang,支持 Gemma、Qwen、DeepSeek、GLM、Kimi、MiniMax、Grok 等模型以及 Wan、Flux 等视频图像扩散模型。今年晚些时候 RadixArk 还将推出 PyTorch 原生的 SGL-torchtpu 后端,支持 eager 执行、PyTorch 生态兼容与 MPMD,并计划让新开源模型在 TPU 与 GPU 上同日可用。
匹配字段摘要
Google DeepMind 发布 Gemini Robotics ER 2,定位为机器人的高层大脑,支持实时空间推理、多步任务规划和多机器人协作,可通过 Gemini API、Google AI Studio 或 Gemini Enterprise Agent Platform 调用。相比 ER 1.6,新模型能通过连续视频流跟踪任务进度并实时纠错,在进度分类任务上达到 57.4% 准确率,在 moment-finding 任务上达到 91.3% 准确率和 0.96s 平均绝对距离。官方还展示了其编排 Boston Dynamics Spot 的导航与机械臂 API 完成取物,并支持 Apptronik Apollo 2 与 Franka F3 Duo 协作,代码已在 GitHub 开源。
匹配字段摘要
据 Bloomberg 报道,亚马逊在自研大语言模型未能取得预期成果后,缩减了多数 Nova 模型的投入,并将文本、视频和图像生成模型置于仅维持最低资源的状态。公司把算力和人力转向由 Pieter Abbeel 领导的单一前沿模型项目,此前一周还关闭了旧金山一处 80 人的 AGI 研究办公室。
匹配字段摘要
NVIDIA 发布开源 GPU 加速的 Medical Physics Simulation 框架,作为 Isaac for Healthcare 的一部分,用于生成解剖数字孪生、模拟器械与解剖结构交互并训练强化学习策略。其中 Endoluminal Simulation Module 已正式可用,用 XPBD 求解器实时模拟柔性导管在患者特异性血管中的导航;Surgical Simulation Module 处于早期访问,可在单张消费级 GPU 上以超过 30 帧每秒模拟软组织变形与触觉反馈。Cosmos-H 系列生成式世界模型可从机器人动作生成手术视频,Cosmos-H-Dreams 经 FlashDreams 推理引擎实现超过 30 帧每秒的交互式仿真。
匹配字段摘要
🎙️ Voice AI Night 将于 7 月 30 日在 Mountain View 举行。 StepFun 携手 SEAMATE、PLAUD、Firework 和 Cresta,汇聚基础模型、AI 硬件、视频电商和企业 AI 领域的开发者。 我们将深入探讨构建 Voice AI 真正需要什么——从架构、延迟、打断(barge-in)和记忆,到把优秀技术变成人们真正使用的产品所面临的挑战。 📍 Mountain View 📅 July 30 🔗 RSVP 链接:https://t.co/g8rdGOUuNr
🎙️ Voice AI Night 将于 7 月 30 日在 Mountain View 举行。 StepFun 携手 SEAMATE、PLAUD、Firework 和 Cresta,汇聚基础模型、AI 硬件、视频电商和企业 AI 领域的开发者。 我们将深入探讨构建 Voice AI 真正需要什么——从架构、延迟、打断(barge-in)和记忆,到把优秀技术变成人们真正使用的产品所面临的挑战。 📍 Mountain View 📅 July 30 🔗 RSVP 链接:https://t.co/g8rdGOUuNr
匹配字段摘要
Ethan Mollick 发布一份用 AI 做事的选型指南,认为如今用 AI 已从聊天转向能自主规划并调用工具的智能体系统。他实测 ChatGPT 的 Work/Codex 与 Claude 的 Cowork/Code 两种模式,指出两者都能连邮箱、跑长任务,但权限设置决定智能体能否直接发邮件或改文件,默认应先要求人工确认以降低 prompt injection 风险。他还提到高风险问题应选 Claude 的 Opus、Fable 或 GPT-5.6 Sol 的高思考档位,Google 目前缺少前沿模型和类似 Codex 的产品,但 Gemini Notebook 适合多来源研究、Gemini Omni 可直接编辑视频。
匹配字段摘要
Black Forest Labs 发布多模态基础模型 FLUX 3 并开启 Early Access,该模型基于 Self-Flow 在统一架构中同时学习图像、视频和音频,可单次生成最长 20 秒带原生音频的视频,并支持文生视频、图生视频、视频生视频、关键帧过渡和多语言对话等能力。早期评测中 FLUX 3 在最高 69% 的对比中优于 Grok Imagine Video,对 Runway Gen-4.5 和 Luma Ray 3.2 的偏好比例分别为 77% 和 93%,官方称结果仍属初步。后续将陆续开放 FLUX 3 Video、FLUX 3 Image 的 API 与私有权重,以及 FLUX 3 Dev 的开源权重,FLUX 3 Image 的早期访问将在接下来几周开放。

匹配字段摘要
LiveKit 正式发布 Unity SDK v2.0.0,将其移出 Developer Preview,并实现与现有 LiveKit SDK 的功能对齐。该 SDK 支持低延迟语音聊天、音视频流、VR 远程操控机器人,以及接入 LiveKit agent 打造语音 AI NPC,可选 STT→LLM→TTS 管线或单一实时模型。官方支持 Unity 2022.3 及以上版本,覆盖 macOS、Windows、Linux、iOS 和 Android。
匹配字段摘要
Odyssey 联合创始人兼 CTO Jeff Hawke 阐述了公司从自动驾驶研究转向通用世界模型的技术路线,目标是让模型直接从视觉和声音中学习世界。Odyssey 已围绕实时交互像素、音视频联合生成、多人共享状态和模型自我改进推出 Odyssey-2、Starchild-1、Agora-1 与 PROWL。Hawke 将世界模型的发展阶段比作“GPT-2 时代”,认为规模化应用尚未到来,但视觉、音频与语言模型可能逐步汇合。
匹配字段摘要
飞往悉尼!✈️🇦🇺 我们的 LingBot-VA 论文正式入选 #RSS2026! 原生视频-动作预训练如何解锁通用机器人控制?对 LingBot 2.0 背后的思路好奇吗?来一探究竟! ✨ Gold 03 展位——整个星期都可以和 LingBot 团队交流! 🗣️ 行业演讲——7 月 16 日下午 4:20,5 分钟纯机器人学习。 到时见!👋🦘 #LingBot #RSS #Robotics #EmbodiedAI
飞往悉尼!✈️🇦🇺 我们的 LingBot-VA 论文正式入选 RSS2026! 原生视频-动作预训练如何解锁通用机器人控制?对 LingBot 2.0 背后的思路好奇吗?来一探究竟! ✨ Gold 03 展位——整个星期都可以和 LingBot 团队交流! 🗣️ 行业演讲——7 月 16 日下午 4:20,5 分钟纯机器人学习。 到时见!👋🦘 LingBot RSS Robotics EmbodiedAI
匹配字段摘要