←搜索结果

按匹配度 · 共 1629 条结果 清除搜索

星期二

  1. MarkTechPost

    DeepSeek 开源生产推理框架 DeepInfer,支撑 DeepSeek-V4.1-Flash

    DeepSeek 以 Apache 2.0 协议开源了其生产服务所用的推理框架 DeepInfer,该框架目前只支持 DeepSeek-V4.1-Flash,运行在 NVIDIA SM100 和华为昇腾 950 上。官方称单个集群每天可服务 155 万亿 token,在 131,072 上下文、64 卡解码配置下解码吞吐超过 25,000 tokens/s/GPU。此次发布仅覆盖离线推理,KV cache 系统、P/D 分离和负载均衡未包含在内,DeepSeek 表示这些组件与内部基础设施紧密耦合。

    em, P/D disaggregation and load balancing are not included. What is DeepInfer? DeepInfer is a high-performance inference engine from DeepSeek for its own models. According to it’s GitHub README, it powers DeepSeek’s large-scale production services. This release covers offline inference with the core features needed at scale. It was originally built primarily on vLLM, with ideas from SGLang and TensorRT-LLM. The deployment Q&A gives production context. A single cluster serves 155 trillion tokens

    匹配字段正文
  2. AWS Machine Learning

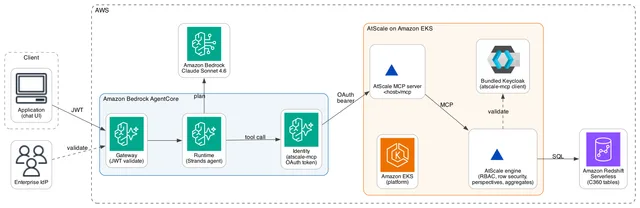
    用 AtScale 和 Amazon Bedrock AgentCore 在 AWS 上为智能体 AI 构建语义层

    AWS 发布教程,演示用 AtScale 作为语义层、Amazon Bedrock AgentCore 托管 Strands 智能体,在 Amazon Redshift Serverless 上构建 Customer 360 场景。AtScale 以 YAML 格式的 Semantic Modeling Language 建模,单一模型同时通过 SQL、XMLA 和 MCP 三种协议暴露,并以 Anthropic Claude Sonnet 4.6 规划查询。教程还覆盖 AgentCore Gateway 注册 MCP 服务器、AgentCore Identity 传递用户身份及 AtScale 的 RBAC 与行级安全,基于 AtScale C2026.7 版本。

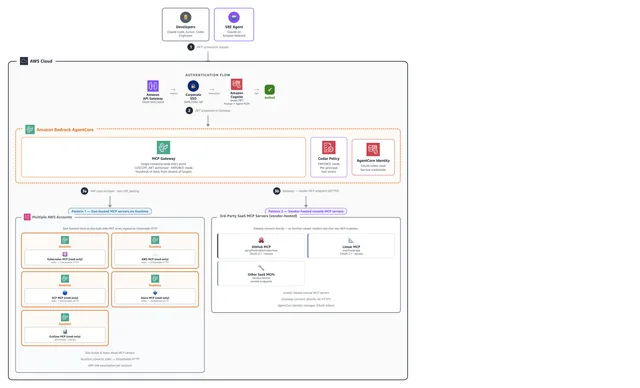
    Architecture showing the inbound authentication path and outbound query path between the client, Amazon Bedrock AgentCore, AtScale, and Amazon Redshift Serverless

    for describing semantic models. Every SML object (model, dataset, dimension, hierarchy, metric, calculation, perspective, row security) is a YAML file. The specification lives at github.com/semanticdatalayer/SML. Model – The top-level artifact. A model references datasets, dimensions, facts, and metrics, and exposes them through the AtScale query engine. Dimension and hierarchy – A dimension groups related attributes (customer, product, date). A hierarchy inside a dimension organizes those attr

    匹配字段正文

  3. AWS Machine Learning

    Eon 如何在 Amazon Bedrock AgentCore 上构建 MCP Gateway 实现多云调查

    Eon 基于 Amazon Bedrock AgentCore 搭建统一的 MCP Gateway,把跨 AWS、GCP、Azure 的调查工具接入同一个认证网关,新工程师配置全部调查工具的时间从约 2 天缩短到约 2 分钟。该方案用 AgentCore Gateway、Policy、Runtime 和 Identity 替代了逐工具凭证与本地 MCP 进程,并通过 Cedar 策略在 ENFORCE 模式下按主体限制可调用的工具,生产工具保持只读。开发者用 Claude Code、Cursor 或 OpenAI Codex 连接同一个 MCP URL,运行 Claude 的自主 SRE 智能体则以不同身份接入同一网关。

    Eon’s centralized gateway architecture: clients and an SRE agent reach one AgentCore gateway that routes tool calls to Runtimes across multiple AWS accounts

    tigates production incidents across multiple clouds and dozens of operational systems. A crashed Kubernetes pod requires checking container logs, Grafana metrics, the deployment’s GitHub pull request (PR), and cloud-provider health status within the same session. Eon needed to address several key requirements: Credential consolidation — Each new tool added another integration to configure, secure, and rotate, which got harder to keep consistent as the toolset grew. Eliminate local MCP processes

    匹配字段正文

  4. Google Developers Blog

    Google 将 TorchTPU 集成进 TorchTitan,为 TPU 优化模型训练

    Google 将 TorchTPU 集成进 Meta 的 TorchTitan,Cloud TPU 现可通过原生后端 torch.device("tpu") 直接训练 PyTorch 模型,无需重写为 JAX。TorchTitan TPU 分支提供 Llama 3 70B/405B、Qwen 3 8B/32B/235B MoE 和 FLUX.1 12B 等预训练配方,并用 Splash Attention 等 Pallas 内核替换标准实现。在 FLUX 上,SimpleFSDP 让 TorchTitan 达到与 JAX MaxDiffusion 99% 的性能持平。

    Torch Titan Header Image

    脚本使用 TPU,只需对设备初始化代码做最小改动。然而,提供设备兼容性只是成功的一半,开发者还需要高性能、生产级的分布式训练配方。这正是 TorchTitan on TPU 的用武之地。 TorchTitan TPU 是 Meta TorchTitan 实现的一个分支,经过调整后可在 Google Cloud TPU 上训练模型。该分支可在 https://github.com/google-pytorch/torchtitan/ ork 可在 https://github.com/google-pytorch/torchtitan/ 为什么要在 TPU 上使用 TorchTitan Google 和 Meta 没有要求工程团队自行发明自定义 TPU 分片策略或从头手工编写底层 XLA 通信传递,而是直接在 TorchTitan 内共同开发了 TPU 原生执行传递。TorchTitan 是在 Google Cloud TPU 上扩展 PyTorch 的权威载体。 旨在展示大规模预训练和后训练 TorchTitan 为大型稠密模型(如 Llama 3 70B/405B 和 Qwen 3

    匹配字段正文

  5. Google Developers Blog

    Google 在 TPU 上发布 vLLM 与 SGLang 原生 PyTorch 推理引擎

    Google 发布基于 TorchTPU 的 vLLM 与 SGLang 原生 PyTorch 后端,分别与 Inferact、RadixArk 合作开发,两个引擎已在预览客户的生产环境中运行。官方称在 Ironwood TPU(TPU 7x)上跑 Qwen 3.5 时,高并发配置下每百万 token 成本为 2.01 美分,并已在 SemiAnalysis InferenceX 的 AgentX 赛道提交结果。功能上支持前缀缓存与 KV cache 卸载、投机解码、分离式服务以及图像视频输入的多模态模型,SGLang-TorchTPU 已在 Meta 生产环境使用。

    inferenceblog

    formant and efficient. The major features for production-grade agentic workloads are already supported. More performance optimizations and advanced features are under way – open a Github issue to request collaboration on yours! Across the two engines, most of the popular open model families are supported, including Qwen, DeepSeek, GLM, Kimi, GPT-OSS, Gemma4 and more. The team is investing in making more models available to run natively on TPUs, including Day 0 support for new open models. We als

    匹配字段正文

  6. 36氪 · AI精选

    DeepSeek 开源推理框架 DeepInfer 与 Token 编解码组件 deepseek-recipe

    DeepSeek 开源自研推理框架 DeepInfer(Apache 2.0)和生产级 Token 编解码组件 deepseek-recipe(MIT),支撑 DeepSeek V4.1 Flash 单集群一天服务 155 万亿 Token。官方线上统计显示平均每请求输入 77K Token、首字延迟约 400 毫秒,生成阶段每秒输出 230 个 Token,平均 96% 的输入命中缓存。DeepInfer 目前支持 V4.1 Flash,开源版本仅提供离线推理,KV 缓存管理与负载均衡代码因与内部基础设施绑定暂未完整开源。

    ek再放大招,全面开源自研推理框架DeepInfer。 一个集群一天服务155万亿Token,DeepSeek V4.1 Flash高吞吐、低延迟的大规模推理,靠的就是它。 一起放出的,还有生产级Token编解码组件deepseek-recipe。 英伟达SM100 GPU、华为昇腾950 NPU,都在支持名单上。 DeepSeek还在知乎发了技术长文,又在GitHub放出一份部署问答,把这套系统从架构设计到部署细节,一五一十讲了出来。 按官方公布的线上统计,平均每个请求输入77K Token,首字平均只要400毫秒就能出来。生成阶段每秒输出230个Token,写代码时能冲到300个。 平均96%的输入,都能直接命中缓存,根本不用重算。 按谷价算,平均每张卡每小时的收入是38美元。 现如今,全世界都可以看到,DeepSeek究竟是如何让大模型高效接活儿的。 DeepSeek研究员Deli Chen更是放了一句狠话。 开源与闭源。光明与黑暗。两种未来、人类两种命运之间的决战。他们想打多久,我们就打多久。直到取得完全胜利。 评论区下,满屏都是开发者的狂欢。 正如网友所言,模型开源已是「基操

    匹配字段正文

  7. 36氪 · AI

    2026年9月中国AI大模型平台排行榜:RSI、Personal Agent与世界模型

    36氪发布2026年9月中国AI大模型平台排行榜,聚焦代码大模型率先进入RSI(递归自我改进)时代。面壁智能让AI工程师约8小时从零写出预训练框架、性能追平Megatron-LM;智谱Infra Agent让GLM-5.3定位并修改自身推理基础设施瓶颈;Qwen3.8-Max一个月无人值守跑通33轮迭代,Artificial Analysis评分从40分升至45分。阿里云栖大会宣布Qwen4已在训练中,未来版本将扩展至5-10T参数。

    (GCC)乃至中东市场的部署与本地化落地,并在场景应用、数据模型优化及区域产业生态共建等维度展开全方位合作。 蚂蚁灵波自研的LingBot-VLA 2.0基础大模型已在预训练阶段实现了对17个品牌、20种机器人构型的支持,率先树立了“一脑多机”的行业工程样本。目前,该方案已在药房、物流、工业上下料等真实场景中落地。截至9月,相关开源模型已经在全球最大开源社区Github上斩获3.18万颗星(star),稳居国内具身模型前列。 9月23日,2026云栖大会在杭州召开,在蚂蚁密算与阿里云共同承办的“密算织域 融数成智”专题论坛上,蚂蚁密算发布企业级可信智能云服务平台“密算一号”,并启动首批定向邀测。平台以密态计算为基础,同时连接云上大模型、智能体与算力,核心能力是让企业数据在“可用不可见、可控可计量”的前提下,安全地参与跨机构合作和云上AI应用。 蚂蚁密算总裁刘前伟介绍,密算一号提供三个核心能力:跨机构数据合作、云上AI安全使用,以及业务经验的持续沉淀与复用。此次定向邀测主要面向有跨机构数据合作、敏感数据调用云上AI及数据服务持续运营需求的企业和机构。 9月9日至12日,2026 Incl

    匹配字段正文

  8. Unite.AI

    llm-d 1.0 在 PyTorch Conference 发布,面向生产环境的推理栈

    llm-d 项目在 PyTorch Conference North America 上发布 1.0 版本,这是一个 Kubernetes 原生的分布式推理服务栈,由 Red Hat、IBM 和 Google 主导维护,CNCF 以沙箱项目托管。1.0 版本新增多租户服务质量保障,包括按优先级和公平性调度的流控与可控降载,并支持路由器热备、安全滚动更新,以及把 prefill 和 decode 副本作为整体管理的 DisaggregatedSet 控制器。项目公布的测试显示,在 544 张 NVIDIA H100 上部署 GLM-5.2 可服务最多 3000 个并发编码智能体且零抢占,按当前云租赁价格计算,每 token 成本比同等商业 API 低 5 到 10 倍。

    ts with competing priorities sharing the same infrastructure, and upgrades that do not interrupt operations. What Version 1.0 Adds The project’s v1.0.0 release notes, published on GitHub on October 20, 2026, with signed and verified tags, lead with multi-tenant quality of service: priority- and fairness-aware flow control with controlled load shedding, including a probabilistic admitter, program-aware fairness, and turn-priority scoring, so latency-sensitive requests and bursty agent workloads c

    匹配字段正文

  9. Hugging Face精选

    PyTorch 2.15 为 MPS 带来 FP8 与 MoE 解码提速

    PyTorch 2.15 在 MPS 后端加入 FP8 支持,并让 MoE 模型解码速度比 2.14 快 5–6.5 倍:在 M3 Ultra 上配合 torch.compile,Qwen3.6-35B-A3B 从 9.4 tokens/s 提升到 61.3 tokens/s,LFM2.5-8B-A1B 从 23.6 提升到 123.6 tokens/s。Wan2.2 的 tiled VAE 视频解码峰值驱动内存从约 270 GiB 降到 8 GiB,Qwen-Image-2.1 的 VAE 编码在 MPS 上的图像损坏问题也随 padding 改动修复,编解码往返 PSNR 从 10.06 dB 升到 29.95 dB。该版本要求 macOS 15 或更高版本、Python 3.11 或更高版本。

    25%,从 384 MiB 降至 287 MiB,并为采用更快矩阵乘法和原生 FP8 矩阵乘法的 Metal 4.1 着色器奠定基础。 总结 PyTorch 2.15 将 FP8 带到 Mac,为稠密和 MoE 模型带来更快的 LLM 解码,在 GPU 上提供更多线性代数运算,并将一长串运算从 MPSGraph 迁移到专用 Metal 内核。快来试试候选发布版吧! 我们的下一步 更多 MPS:2.16 将完全在 Metal 上运行注意力,我们也会继续将运算从 MPSGraph 迁移出去。 torch.compile:我们正在努力消除图中断,让更多模型能够端到端编译。 你的想法:我们还能在 PyTorch 中做些什么?如果有哪里慢、缺失或损坏,无论是在 MPS 还是其他地方,请在 GitHub 上开一个 issue 告诉我们。 非常感谢 Nikita Shulga、Kurt Mohler 和 Aaron Gokaslan 审阅了本项工作的大部分内容,也感谢所有在本版本中为 MPS 做出贡献的人。 博客更多文章 tokenizers v1:编码、解码与扩展,实测 解锁连续批处理中的异步性

    匹配字段正文

  10. Hugging Face

    Hugging Face 发布 AnyLanguageModel 1.0,统一 Apple 平台本地与托管模型调用

    Hugging Face 发布 AnyLanguageModel 1.0,用同一套会话代码即可调用系统模型、llama.cpp、MLX、Core ML 的开放权重模型以及多家托管服务商。该版本让工具调用和引导生成覆盖所有服务商,支持在提示词中附带图片,并新增对 Anthropic Messages API、Gemini API、Ollama、Private Cloud Compute 和 Hugging Face Inference Providers 的支持。文中还列出 Gemma 4 E2B、LFM2.5 2.6B、Qwen3.8 27B 等当前下载量较高的模型及其量化后体积。

    馈和贡献塑造了我们的多项重要功能。感谢所有贡献者帮助 AnyLanguageModel 对应用开发者更加实用。 下一步 语言模型已被证明是为产品注入智能的强大工具。它们也是开发者可以使用的众多模型类型之一。我们很高兴将同样的方法扩展到更多能力:熟悉的 Swift API,以及可在设备上运行的多种模型选择。即将推出:能够决策的模型,以及能够聆听的模型。 链接 GitHub 上的 AnyLanguageModel GitHub 上的 swift-huggingface GitHub 上的 swift-xet 隆重推出 AnyLanguageModel 隆重推出 swift-huggingface 本文提到的模型 4 LiquidAI/LFM2.5-2.6B-GGUF google/gemma-4-E2B-it-qat-q4 0-gguf mlx-community/Qwen3.8-27B-4bit zai-org/GLM-5.3 来自我们博客的更多文章 Jun Kim,oMLX 创建者兼维护者,加入 Hugging Face 以支持 MLX 社区 +1 你本会自己提交的那个 PR 本文提到

    匹配字段正文

  11. 阿易 AI Notes

    DeepSeek 开源推理框架 DeepInfer 与编解码组件

    DeepSeek 以 Apache 2.0 协议开源了支撑其线上服务的推理框架 DeepInfer 和 API 同款编解码组件 deepseek-recipe,后者把官方线上 API 的 Token 编解码逻辑原样公开。框架包含高性能算子、分布式推理、投机解码、SWA Bounded Replay 和结构化输出,官方称后续新模型的推理代码也会持续合入该仓库。据仓库 README,此次只放出离线推理引擎,KV 缓存系统、预填充与解码分离部署、多副本负载均衡未包含在内,硬件仅支持英伟达 Blackwell 架构 SM100 和华为昇腾 950,模型仅限 V4.1-Flash。

    码逻辑原封不动交了出来,直接替所有做私有化部署的团队抹平了本地环境和官方接口之间的行为温差。 这就像一家米其林餐厅,以前开源模型权重只是把菜谱免费印给你,你自己在家炒总是差一口锅气, 现在 DeepSeek 连自家后厨定制的高压猛火灶台 DeepInfer,外加主厨切配摆盘的标准化工序 deepseek-recipe 一块打包送你了。 不过我顺手去扒了一遍 GitHub 仓库的 README,发现对着全网欢呼的完全开源也得留个清醒,仓库文档写得很实在, 这次放出来的其实只是离线推理引擎,真正撑起完整线上高并发服务最核心的三块基建:KV 缓存系统、预填充与解码分离部署、多副本负载均衡这次并没有放出来;而且硬件门槛极高,目前只认英伟达最新的 Blackwell 架构 SM100 和华为昇腾 950 两款顶级算力卡,支持的模型也只限刚发的 V4.1-Flash,普通玩家手里的消费级显卡压根跑不起来。 但恰恰是 README 里这行只支持英伟达 SM100 和华为昇腾 950 的硬件限定,暴露了比框架本身更狠的产业信号,头部国产大模型已经不再等芯片厂商来缓慢适配自己,而是亲自下场写底层算子,一

    匹配字段正文

  12. 雷锋网

    北大董豪团队推出 HIL-UMI,让具身后训练摆脱真机依赖

    北大与启元机器人董豪团队推出 HIL-UMI,在手持 UMI 夹爪采集时接入模型实时比对动作分歧,只在模型预测跑偏处触发定向补录,使后训练不再依赖机械臂。在折毛巾、整理桌面、叠方块、盖章四项真机任务上,相同数据帧预算下平均任务进度分从常规 SFT 的 58.0 提升到 94.8,叠方块和盖章成功率达 100 分。整理桌面长程任务中单帧有效数据采集耗时从真机 HG-DAgger 的 412.99 毫秒降至 73.40 毫秒,采集效率提升 5.63 倍。论文地址:https://arxiv.org/pdf/2609.20659

    练已经开始转向用“无本体”设备采集数据,虽然量上去了,但传统后训练最关键的“纠错”环节却没法搞定。为了解决这个行业难题,北大和启元机器人董豪团队推出了HIL-UMI。这个工作,围绕着具身后训练阶段无本体的前提下,围绕着最关键的“纠错”环节展开。论文地址:https://arxiv.org/pdf/2609.20659项目主页:https://hil-umi.github.io 01 具身后训练的成本, 为何远超大模型RLHF? 跟大模型比起来,具身行业的后训练太贵,是很多具身模型无法尝试Scaling的重要原因。大语言模型能变得这么好用,大家心里都清楚:不光是预训练数据量大,更关键的是后面有RLHF(人类反馈强化学习,可以简单理解为数据标注)和DPO这些“后训练”的功劳。但具身机器人的后训练,成本可比大模型的RLHF高出不止百倍。大模型做RLHF,无非是请更多人坐在电脑前点点选选;可具身机器人,那就得真刀真枪地跟物理世界打交道。拿传统上最常用的DAgger,也就是用人类或者算法作为专家评价后训练的模式,这套流程虽然有效,但又贵又慢。比较常见的,是以传统的真机人在回路(也就是 HG-DA

    匹配字段正文

  13. Browser Use

    Browser Use 评测五款浏览器控制 MCP 工具:Browser Harness 每任务 token 最低

    Browser Use 在 100 个 BU Bench V2.1 任务上对比了 Browser Harness、Playwright MCP、Chrome DevTools MCP 和 agent-browser,四者得分在噪声范围内打平,Browser Harness 以 2.1M 中位输入 token 和 42 次工具调用成为每任务成本最低($0.042)。作者同时给出选型建议:需要干净会话或 Firefox、WebKit 用 Playwright MCP,调试自家应用性能与网络用 Chrome DevTools MCP,需要域名白名单和加密凭据库用 agent-browser。文章披露作者所在公司开发 Browser Use 和 Browser Harness,竞品信息取自各自仓库与文档。

    er-harness skill , and connect it to my browser. Ask whether I want local browser recordings enabled; default to no and preserve my existing preference on upgrades. Follow https://github.com/browser-use/browser-harness/blob/main/install.md if setup or connection fails. One-time Chrome step: open chrome://inspect/ remote-debugging and tick "Allow remote debugging for this browser instance". On Chrome 144+ you then click Allow once per connection. On macOS, browser-harness mac-approve clicks it fo

    匹配字段正文

星期三

  1. Hugging Face精选

    NVIDIA 发布 Cosmos3-H-Dreams 手术生成模拟模型

    NVIDIA 发布 Cosmos3-H-Dreams,基于 160 亿参数的 Cosmos3-H-Embodied-Nano 专门化,用于胆囊切除术的动作条件视频生成。模型使用 28 个动作维度、832 x 480 视频和 10 Hz 动作对齐训练,通过蒸馏得到四步与两步两个学生检查点,两步版本单独训练,推理更快但画质更低。官方同时提供 FlashDreams 流式运行时和适配自有数据与控制器的方法,并说明该模型是研究用模拟器,并非经过验证的临床系统。

    osmos3-H-Dreams 闭环耦合,使策略能够学习定义的胆囊切除术子任务。 这些是研究方向,而非已确立的临床能力。Cosmos3-H-Dreams 是研究用模拟器,并非经过验证的患者护理系统。它为在日益真实的环境中研究手术交互提供了基础。 探索 Cosmos3-H-Dreams 背后的模型、数据和运行时: Cosmos3-H-Dreams 代码和示例:GitHub 仓库 适配你自己的数据:教师微调和 Self-Forcing 蒸馏的分步配方 FlashDreams:GitHub 仓库 NVIDIA Cosmos 3:GitHub 仓库 带上你的控制器、你的轨迹和你的研究问题。我们期待看到社区在这些新的手术世界中构建出什么。 本文提及的模型 2 nvidia/Cosmos3-H-Dreams nvidia/Cosmos3-H-Embodied-Nano 本文提及的数据集 1 来自该作者的更多内容 扩展 Indic 预训练:2.8 万亿 Token 与开放数据生成流水线 本文提及的模型 2 nvidia/Cosmos3-H-Dreams nvidia/Cosmos3-H-Embodi

    匹配字段正文

  2. AWS Machine Learning

    AWS 如何用 X.509 PKI 保障 AI 智能体身份安全

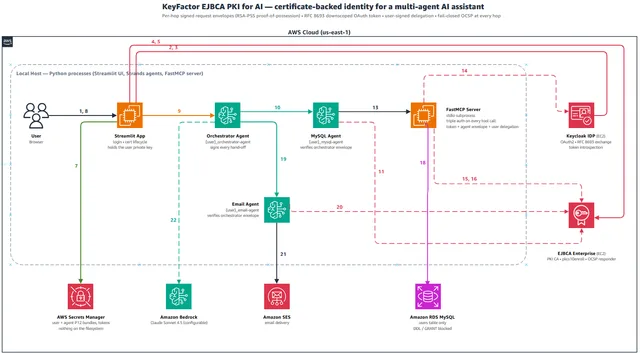
    AWS 与 Keyfactor 联合发布参考架构,用 Keyfactor EJBCA 的 X.509 PKI 为 AI 智能体建立可验证、可撤销的加密身份,弥补 MCP 缺少内置认证标准的缺口。方案结合 Amazon Bedrock、AWS Strands Agents SDK、AWS Secrets Manager 和 Amazon RDS,通过签名请求信封、用户签名委托断言、RFC 8693 受众限定 token 与实时 OCSP 吊销检查四层机制,覆盖用户认证、智能体间通信和 MCP 工具调用三个信任边界。

    Three-layer PKI authentication architecture showing credential flow between the user, agents, and the MCP tool server

    众限定令牌可限制任何单个令牌泄露所造成的暴露范围。第四,实时 OCSP 吊销检查可立即在所有智能体之间传播凭据变更。 该解决方案使用 Amazon Bedrock 通过 AWS Strands Agents SDK进行 LLM 推理。虽然此参考架构使用数据库作为受保护资源,但相同的认证模式适用于任何兼容 MCP 的工具服务器。所有示例的完整源代码可在随附的 GitHub 仓库中获取。 关于 Keyfactor EJBCA 据 Keyfactor 称,Keyfactor 提供了一个被广泛采用的机器身份管理平台,全球有超过 1,500 家企业客户使用。这些组织涵盖金融服务、医疗保健、制造业和政府等领域。Keyfactor 通过证书生命周期管理、PKI 运营和机器身份治理,帮助组织建立并维护加密信任。 EJBCA Enterprise 是 Keyfactor 的证书颁发机构(CA)和 PKI 平台,专为高可用部署和 REST API 自动化而设计。EJBCA 作为企业产品提供,可通过 Web 控制台和 REST API 提供 X.509 证书颁发、OCSP 验证、证书吊销列表(CRL)分发以

    匹配字段正文

  3. PyTorch Blog

    从 KTIR 到 SpyreCode:IBM Spyre 的 MLIR 数据流后端

    torch-spyre 的后端编译器以 KTIR(Kernel Tile IR)承接 Inductor 已确定的并行划分,再由开源 Dataflow Scheduler 把每个 tile 的工作拆成程序,从 load → compute → store 流水线逐步扩展为嵌套、双缓冲、多实例调度,输出 DataflowIR 并生成 SpyreCode。KTIR 面向 32 核、每核 2 MB scratchpad 的 Spyre 硬件,以 128 字节 stick 搬运数据;调度器及其方言以 Apache-2.0 开源。

    launch jobplan 每次调用都会遍历它,而地址和形状在编译时全部已知的内核只需要启动。 试一试 Dataflow Scheduler 基于上游 LLVM/MLIR 构建。 README 给出了确切的 LLVM 修订版本以及如何构建它。在 MLIR 构建就绪后,调度器只需几条命令即可运行: git clone --recursive https://github.com/torch-spyre/dataflow-scheduler.git cd dataflow-scheduler cmake -S . -B build -G Ninja -DMLIR DIR=$MLIR INSTALL PREFIX/lib/cmake/mlir cmake --build build 一个不错的 hello world 示例就是仓库测试中的简单逐元素加法, test/dataflow-scheduler-opt/ktir-to-dfir-sanity-check.mlir它是一个小型、自包含的 KTIR 内核,与本帖前面的加法非常相似,被拆分到两个计算 tile 上,并面向上述示例设备。在其

    匹配字段正文

  4. PyTorch Blog精选

    Google 与 Meta 联合推出 TorchTPU,让 PyTorch 原生运行在 TPU 上

    Google 与 Meta 的 PyTorch 团队合作推出开源项目 TorchTPU,为 Google TPU 提供原生 PyTorch 后端,迁移只需把 model.to("cuda") 改为 model.to("tpu")。项目支持 eager 与 torch.compile 两种模式,新增 DeferAndFuse eager 模式,覆盖约 450 个 Aten 算子,并已在 4,917 个 Hugging Face 模型上验证开箱运行,其中 Tier 1 通过率 98%、Tier 2 相对 GPU 数值一致性 97%。官方称其已用于部分 Google Cloud 大客户的推理与训练生产负载,并集成 vLLM、SGLang、TorchTitan、Ray 和 TorchRec。

    eager 执行引入 JIT 编译方案,并通过运行时优化弥合逐算子执行与编译执行之间的性能差距; 通过引入有界动态性、避免因形状变化导致 XLA 重新编译,以及探索可提前预编译的动态 TPU 内核,来改进 TPU 编程栈。 TorchTPU 正在积极开发中,它已被用于部分 Google Cloud 最大客户的推理和训练生产负载,并可作为开源项目在此处找到: GitHub 仓库. 在撰写本文时,我们已经: 新增对 eager 和编译两种模式的支持,包括新的 DeferAndFuse eager 模式; 新增对约 450 个 Aten 算子的支持(跳过具有结构性或复合委托的算子),包括主要深度学习架构所需的全部 Core ATen 算子的前向和反向传播; 新增通过 JAX/Pallas 和 Helion DSL 编写自定义内核的能力; 在下载量最高的 5,000 个 Hugging Face 模型上验证了开箱即用的执行,包括: LLM:Qwen、DeepSeek、Gemma、LLama、Mistral、GPT、OPT、BLOOM、Falcon、StableML 音频/语音:Whisper、

    匹配字段正文

星期一

  1. Swyx

    swyx:数据工程师需求远超 AI 工程师

    swyx 认为“RAG guy”与《数据密集型应用系统设计》型人才之间存在巨大差距,且这是他职业生涯(搜索引擎大战之后)见过需求差距最悬殊的一次。他正在为 Latent Space 招聘这类人才,工作地点优先旧金山,可协助搬迁并支持签证,简历投至 jobs@latent.space。

    tensive Applications" person like in this screenshot and there's never been a starker difference in demand in my entire career in tech (aka post search engine wars) if your blog / github is full of stuff like this, I have a fantastic mission/job for you (SF preferred, can relocate u, visas ok) (if you can name who's blog this is without even checking, you definitely are in the community. bonus points if you know where he ended up also without looking) jobs@latent.space and the team will reach ou

    匹配字段正文

  2. 腾讯云开发者社区

    停更 5 年的 eul 借助 Workbuddy 修复,在 Apple M6 上恢复温度与 GPU 监控

    停更 5 年的开源菜单栏监控工具 eul 借助 Workbuddy 完成底层修复,在 Apple M6 芯片的 Mac Mini 6 上重新读出 CPU 温度与 GPU 信息。根因是 SMCParamStruct 在 arm64 用户态下从 80 字节变为 88 字节,且 M6 的 135 个温度 key 全为 flt 类型而非 Intel 时代的 sp78。修复后动态枚举 2066 个 SMC key,保留 126 个有效传感器,Intel 机型逻辑仍兼容。

    下,开源项目 eul 非常合适——它足够小巧玲珑(App 仅 5MB 左右),且原生常驻在菜单栏。 但在用 brew 安装后,结果让人傻眼:CPU 温度和 GPU 相关信息全部显示 N/A。对于要跑大模型测试的场景来说,这些信息极其关键。 ::: center 图 1.1 CPU 温度和 GPU 相关信息全部显示 N/A ::: 于是找到了 eul 的源码。GitHub 上,master 分支的最新 commit 是 b5c3bd0,提交信息写着 Create Localizable.strings ( 238)。日期栏赫然显示:5 years ago。 ::: center 图 1.2 eul项目源码更新情况 ::: 右上角 10k Star 似乎在展示着过去的辉煌,就这样静静地躺在 GitHub 上。Issues 区里,有人在两年前问:“M1 还有救吗?”没有人回答。 在 M6 上它还有救么?我的 macOS 应用开发经验不多,但在如今的 AI 时代,或许也可一试。 --- 二、 问题:调研现场 拿到 5 年前的源码后,发现 eul 的温度读取实现源自 Intel 时代的 SMCK

    匹配字段正文

  3. PyTorch Blog

    一次搜索,两层优化:PyTorch Helion 借助 NVIDIA CompileIQ 引入编译器控制

    PyTorch Helion 现在可以通过 NVIDIA CompileIQ 搜索 ptxas 编译器控制参数,与原有的 kernel 配置搜索联合进行,在已预调优的约 27 个 kernel 上进一步挖掘性能空间。CompileIQ 将调优结果打包为可移植的 Advanced Control File(ACF),Helion 支持固定指定 ACF,也支持把多个 ACF 作为自动调优的一个维度一起搜索。这些编译器控制由 ptxas 从 CUDA 13.3 起开放。

    Helion logo

    实现检查正确性,对通过者计时,让胜出者繁衍,如此重复。这一搜索过程的输出就是一个 ACF 文件。搜索算法本身没有任何 GPU 特定之处,唯一与 GPU 相关的部分完全在用户编写的目标函数中,通常只是围绕 triton.testing.do bench 的几行代码。 然而对大多数用户来说,额外的搜索预算是不必要的,因为搜索已经完成了。CompileIQ 在其 GitHub releases 上发布了 Booster Packs——预先调优的 ACF 目录。当前的 helion-booster-pack 包含 24 个 ACF,针对一系列 Helion kernel 进行了调优,已对照 CUDA 13.4 的 ptxas 验证,面向 B200。因此,用户现实的工作流程是:下载该包,将 Helion 的 autotune search acf 指向它,自动调优一次,固定胜出者。无需设计搜索空间,无需编写目标函数,无需编译器专业知识! 如果你有该包未覆盖的工作负载,可以 pip install compileiq 并运行你自己的针对性搜索。该路径记录在 NVIDIA 的 CompileIQ 博

    匹配字段正文