←搜索结果

按匹配度 · 共 6730 条结果 清除搜索

星期四

  1. DeepSeek精选

    DeepSeek Harness v0.1 开放开发者预览并以 MIT 许可证开源

    DeepSeek Harness v0.1 现已开放开发者预览,并以 MIT 许可证开源,面向全球构建智能体运行框架的开发者。该项目由 Cordis 元框架驱动,将模型、工具、技能、会话、沙箱、文件系统、循环、编排和 UI 均实现为可组合、替换和扩展的插件。

    DeepSeek Harness v0.1 现已开放开发者预览,并以 MIT 许可证开源,面向全球构建智能体运行框架的开发者。该项目由 Cordis 元框架驱动,将模型、工具、技能、会话、沙箱、文件系统、循环、编排和 UI 均实现为可组合、替换和扩展的插件。 · DeepSeek Harness v0.1 is now available in Developer Preview and open-sourced under the MIT License for developers building agent harnesses worldwide. Powered by the Cordis meta-framework, it implements models, tools, skills, sessions, sandboxes, filesystems, loops, orchestration, and UI as plugins that can be mixed, matched, replaced, and extended.

    匹配字段摘要、正文
  2. DeepSeek

    DeepSeek 发布 DeepSeek-V4-Pro

    DeepSeek 发布 DeepSeek-V4-Pro,重点升级 Agent 能力,并为 V4-Pro 与 V4-Flash 提供 low、high 和 max 三档推理强度。该模型原生支持 OpenAI Responses API,并针对 Codex 优化;现已通过 app/web 的“Expert Mode”和 API 提供,模型名称保持不变。

    DeepSeek 发布 DeepSeek-V4-Pro,重点升级 Agent 能力,并为 V4-Pro 与 V4-Flash 提供 low、high 和 max 三档推理强度。该模型原生支持 OpenAI Responses API,并针对 Codex 优化;现已通过 app/web 的“Expert Mode”和 API 提供,模型名称保持不变。 · DeepSeek launched DeepSeek-V4-Pro with major Agent upgrades and low, high, and max reasoning-effort settings for V4-Pro and V4-Flash. The model natively supports the OpenAI Responses API and is optimized for Codex; it is now available through “Expert Mode” on the app and web, as well as via API, with model names unchange

    匹配字段摘要、正文

  3. Hugging Face精选

    复现 ICML 2,200 篇论文后,我们学到了什么

    Hugging Face 与 alphaXiv 组织社区借助编码智能体复现了 2,226 篇 ICML 2026 论文,并公开实验日志、代码和产物。受检论文中,51% 至少有一项主张获独立验证,23% 至少有一项被证伪或存在争议;结果也显示,智能体会误判尺度效应或单位问题,可靠审查仍需人类引导。

    2,226 篇 ICML 2026 论文,并公开实验日志、代码和产物。受检论文中,51% 至少有一项主张获独立验证,23% 至少有一项被证伪或存在争议;结果也显示,智能体会误判尺度效应或单位问题,可靠审查仍需人类引导。 · Hugging Face and alphaXiv organized a community effort using coding agents to reproduce 2,226 ICML 2026 papers, publishing the experimental logs, code, and artifacts. Among the examined papers, 51% had at least one claim independently verified, while 23% had at least one claim falsified or contested; the results also showed that agents can misread scale-dependent behavior or unit misma

    匹配字段摘要、正文

星期三

  1. 腾讯混元

    腾讯混元发布自进化智能体可靠性综述

    腾讯混元发布综述《Diving into Reliable Self-Evolving Agents》,系统梳理智能体自我进化方式及验证每次更新可信度所需的证据。该综述提出自进化智能体的 L0–L4 分类体系与可信更新可靠性阶梯,并整理 549 篇工作形成开放配套目录。其核心原则是:任何更新都不应掌控用于认可自身的唯一证据。

    匹配字段摘要、正文

  2. shaoruu

    ian 分享 Grok Bot 早期测试使用技巧

    Grok Bot 进入早期 beta,定位为替你干实事的 AI 队友:登录你的工具、像你一样操作并交付完成的工作。ian 列出使用技巧:bot 会记住你的偏好和写作语气,可重复执行任务(如每天 7am 备好一篇帖子、未来 5 小时每 10 分钟截一次 Mac 屏),拥有 24/7 运行的自己的电脑,能访问你的 Mac 并执行命令,可盯 Slack 线程和 GitHub Actions,能管理云端 agent 并行跑多个编码任务,bot 之间可互相通信(他用一个叫 jarvis 的 chief of staff 分派给 5 个工程 bot),bot 还能创建新 bot,并支持命名、头衔、头像、侧边栏分组和置顶。他邀请大家试用并反馈可以补充什么。

    匹配字段摘要

  3. The Next Platform

    Nvidia 发布 Nemotron 3.5 Lightning 模型与 NeMo Switchyard 路由库

    Nvidia 发布 Nemotron 3.5 Lightning 开源模型和 NeMo Switchyard 路由库,前者面向持续运行的智能体任务,官方称在同级中实现 4 倍吞吐、完成智能体任务速度提升 30%,并可在 Jetson、GeForce RTX、DGX Spark 和 DGX Station 上本地运行。Switchyard 让开发者自定义模型池、路由标准和策略,把推理密集型步骤交给前沿模型、把执行类任务交给 Lightning,官方称其以 Anthropic Opus 4.8 约三分之一成本取得更好准确率。Nvidia 同时公开训练数据与方法,并发布用于训练编码智能体的开放数据集 Nemotron-RL-Agentic-Terminal-Pivot。

    匹配字段摘要、正文

星期二

  1. 蚂蚁百灵:Developer Blog精选

    蚂蚁百灵开源 Ling-3.0-tiny:7.9B 总参数、1.3B 激活参数

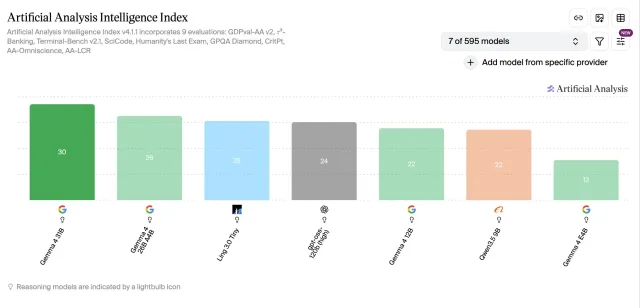
    蚂蚁百灵正式开源 Ling-3.0-tiny,这是一款总参数 7.9B、推理时仅激活 1.3B 参数的原生混合推理模型,同步提供 BF16、FP8 和 INT4 三个版本。官方称其在 Artificial Analysis Intelligence Index 获 25 分,Agentic Index 达 16 分,输出速度超过 160 tokens/s。模型可在单台 NVIDIA DGX Spark 上完成 FP8 推理,权重约 7.85GB,并已完成 Apple Silicon 的 MacBook 与 Mac mini 本地运行适配。

    图

    匹配字段摘要、正文

星期六

  1. Sierra:Blog

    Sierra 推出 Voice Personas:为 AI 智能体打造品牌专属语音人格

    Sierra 发布 Voice Personas,让企业为同一个 AI 智能体配置不同语音、人格与语言行为,覆盖不同品牌、市场和文化场景。该功能由 Sierra Agent SDK 支持,可调整语速、自然应对打断,并在对话中切换语音或语言,底层由多个语音模型按人格、语言和用例择优驱动。Sierra 称某智能体搭配自然语音与人格后问题解决率提升近 50%,Voice Personas 现已上线。

    匹配字段摘要、正文

星期五

  1. Sarvam AI Blog

    Sarvam AI 在 Sarvam Epoch 发布 105B 模型更新、Vision 2.0、Saaras V4 与 Indus 智能体平台

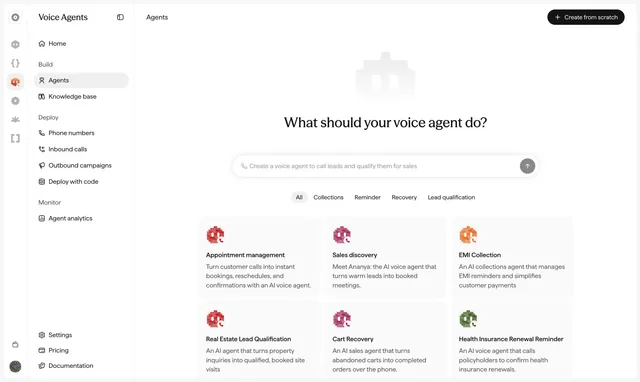
    Sarvam AI 在首届 Sarvam Epoch 上公布全栈更新,包括 Sarvam 105B 面向对话与工作智能体的新变体、Sarvam Vision 2.0、Saaras V4 语音识别模型和 Bulbul V4 语音合成研究预览。Sarvam 105B 在自建印度对话生产基准上四项指标均领先 GPT 5.4 Mini 和 Gemini 3.5 Flash,混合 token 价格为每百万 0.80 美元,并已通过 Sarvam API 提供。公司同时推出印度本地推理层 Sarvam Inference、自服务智能体平台 Indus(含 Voice Agents、Work Agents、Content Studio)、早期测试的 Sarvam Code、安全智能体 Sarvam Cyber 预览,以及 Mac 版语音应用 Kivi。

    Voice Agents analytics dashboard with call distributions, conversation insights, and language breakdown

    匹配字段摘要、正文

  2. Prime Intellect精选

    Prime Intellect 在 PRIME-RL 中推出多智能体训练支持

    Prime Intellect 的 RL 栈从训练单个智能体扩展到多智能体系统,可编程定义智能体之间的任意交互、选择哪些角色参与学习,并在完整交互上分配信用。新抽象 Agent 与 Env 分别负责单智能体 rollout 和多智能体控制流,已实现 Agentic Judging、Self-Play(Proposer-Solver 与 Kuhn-Poker)和 User-Sim 四种环境,并配套 Hierarchical GRPO 与 Role-Conditioned Advantage Estimation。多智能体支持随 verifiers 0.3.0 和 prime-rl 0.8.0 发布。

    匹配字段摘要、正文

星期四

  1. The Next Platform

    Broadcom 观点:AI 暴露旧平台短板,平台工程 2.0 需五大支柱演进

    Google 2025 年 DORA 研究显示,90% 的组织已使用内部平台,76% 建立了专职平台团队,但多数平台并非为 AI 时代设计。Broadcom 提出平台工程 2.0 的五大支柱:AI 原生平台(IDP 演进为 Agentic Development Platform)、多角色体验、内嵌 FinOps、安全下沉和可组合设计,并建议先审计 GPU 供给、非人类身份管理和实时成本归因三项缺口。

    匹配字段摘要、正文

  2. DevClass

    Broadcom 观点:AI 暴露平台工程旧架构,需转向 Platform Engineering 2.0

    Broadcom 在 DevClass 发布的观点文章称,多数企业现有内部平台是为人类开发者按人类节奏交付容器应用而建,难以支撑 AI 时代。文章援引 Google 2025 年 DORA 研究称 90% 组织已使用内部平台、76% 设有专职平台团队,并提出 Platform Engineering 2.0 的五大支柱:AI 原生平台(IDP 演进为 Agentic Development Platform)、多角色体验、嵌入式 FinOps、安全下沉与可组合设计。文章建议先审计 GPU 供给、非人类身份管理和实时成本归因三项缺口。

    匹配字段摘要、正文

  3. Hugging Face

    Baseten 接入 Hugging Face Inference Providers

    Hugging Face Inference Providers 现已支持 Baseten,用户可通过网页、huggingface_hub >= 1.26.1、JavaScript SDK 及多种 Agent Harness 调用其托管模型。请求可使用供应商 API key 直连并由供应商计费,也可经 Hugging Face 路由且不加价;PRO 用户每月获 $2 推理额度,登录的免费用户享有少量免费配额。

    Hugging Face Inference Providers 现已支持 Baseten,用户可通过网页、huggingface hub = 1.26.1、JavaScript SDK 及多种 Agent Harness 调用其托管模型。请求可使用供应商 API key 直连并由供应商计费,也可经 Hugging Face 路由且不加价;PRO 用户每月获 $2 推理额度,登录的免费用户享有少量免费配额。 · Hugging Face Inference Providers now supports Baseten, allowing users to access Baseten-hosted models through the website, huggingface hub = 1.26.1, the JavaScript SDK, and multiple Agent Harnesses. Requests can use a provider API key for direct provider billing or be routed through Hugging

    匹配字段摘要、正文

  4. Chips and Cheese

    Chips and Cheese 逐条拆解 NVIDIA Vera 白皮书中的论证问题

    Chips and Cheese 对 NVIDIA 45 页 Vera 白皮书提出质疑,认为 Olympus 核心与 88 核单体芯片的设计本身扎实,但白皮书把 x86 的 SMT 画成时间片轮转、把可配置的 32 NUMA 节点当作默认负担、把四个 SPEC 整数负载称作 agentic benchmarks,并用无标注图示给出 1.8 倍强化学习结果。作者引用 Phoronix 5 月的早期测试称 Vera 几何均值比 5 GHz EPYC 9575F 高 10%、是 Xeon 6980P 的 1.55 倍,但指出 NVIDIA 自测的 Turin 内存带宽约 400 GB/s 与其实测约 570 GB/s 不符,按实测 Vera 的总带宽优势约为 1.9 倍而非白皮书所示的近 3 倍。

    匹配字段摘要、正文

星期二

  1. Liquid AI 模型与工程博客精选

    Liquid AI 发布 LFM2.5-2.6B 端侧智能体模型

    Liquid AI 发布 LFM2.5-2.6B,一款完全在设备端运行的智能体模型,基础版与后训练版已在 Hugging Face 上线。该模型为 2.6B 参数、预训练约 34T tokens,词表扩展至 128K 并包含 128K 上下文扩展阶段,后训练经 SFT、教师专精、MOPD 蒸馏与 Agentic RL 四阶段。推理方面在 M5 Max 上解码 220 tokens/s、Ryzen AI Max+ 395 上 113 tokens/s,占用低于 2.5 GB,手机端保持 30 tokens/s,并首日支持 llama.cpp、MLX、vLLM、SGLang 和 ONNX。

    匹配字段摘要、正文

星期六

  1. Unsloth精选

    Unsloth 支持 DeepSeek V4 Flash 0731 本地运行

    Unsloth 宣布 DeepSeek V4 Flash 0731 现已可在本地运行,无损 4-bit 量化需 168GB 内存,3-bit 需 110GB 内存,可通过 Unsloth 或 llama.cpp 运行,并提供了指南和 GGUF 链接。Unsloth 称 V4 Flash 0731 表现优于 V4 Pro,更小的量化版本当天晚些时候发布。DeepSeek 官方此前宣布 DeepSeek-V4-Flash 官方 API 进入公开测试,Agent 能力大幅升级,基准分数超过 V4-Pro-Preview,并原生支持 Responses API 格式、适配 Codex。

    匹配字段摘要

星期五

  1. DeepSeek

    DeepSeek-V4-Flash 官方 API 开放公测

    DeepSeek-V4-Flash 官方 API 已开放公测,智能体能力评测成绩大幅超过 V4-Pro-Preview。该版本原生支持 Responses API 格式,并已适配 Codex,配置详情可查阅官方 API 文档。

    DeepSeek-V4-Flash 官方 API 已开放公测,智能体能力评测成绩大幅超过 V4-Pro-Preview。该版本原生支持 Responses API 格式,并已适配 Codex,配置详情可查阅官方 API 文档。 · The official DeepSeek-V4-Flash API is now available in public beta, with Agent capability benchmark scores far surpassing V4-Pro-Preview. The release natively supports the Responses API format and is adapted for Codex, with configuration details available in the official API documentation.

    匹配字段摘要、正文

星期四

  1. Hugging Face

    GPU 管理分析:为何闲置 GPU 如同停飞的飞机

    大规模智能体集群会让实时推理、批处理、再训练和评测争用有限的 GPU,使调度与利用率成为核心问题。GPU 隔离和沙箱可支持安全共置,但仍需根据显存占用、延迟容忍度、运行时长和优先级分配任务;僵化分区反而可能造成容量闲置。

    大规模智能体集群会让实时推理、批处理、再训练和评测争用有限的 GPU,使调度与利用率成为核心问题。GPU 隔离和沙箱可支持安全共置,但仍需根据显存占用、延迟容忍度、运行时长和优先级分配任务;僵化分区反而可能造成容量闲置。 · Large agent fleets make real-time inference, batch jobs, retraining, and evaluations compete for a finite GPU pool, turning scheduling and utilization into core problems. GPU isolation and sandboxing can enable safe co-location, but jobs must still be assigned according to memory footprint, latency tolerance, duration, and priority; rigid partitioning may leave capacity idle.

    匹配字段摘要、正文

  2. Modem:Blog

    Modem 发布 MCP server 与公开 API,让编码智能体直接调用客户反馈

    Modem 面向所有用户开放 MCP server(https://mcp.modem.dev/mcp)和公开 API(api.modem.dev/v1),把 Slack、Intercom、Linear 等来源的客户反馈合成为去重后的主题,附带证据与报告人数。编码智能体可通过 search_modem、merge_topics、invoke_modem_agent 等工具在会话内直接查询。Modem 称单一来源至少消耗 2.4 倍 token 且答案不完整,跨三个来源则达 4.6 倍;在 Opus 5、Fable 5、GPT-5.6 Sol、GLM 5.2 上跳过合成需多付 2.8× 至 13.4× token。

    Modem 面向所有用户开放 MCP server(https://mcp.modem.dev/mcp)和公开 API(api.modem.dev/v1),把 Slack、Intercom、Linear 等来源的客户反馈合成为去重后的主题,附带证据与报告人数。编码智能体可通过 search modem、merge topics、invoke modem agent 等工具在会话内直接查询。Modem 称单一来源至少消耗 2.4 倍 token 且答案不完整,跨三个来源则达 4.6 倍;在 Opus 5、Fable 5、GPT-5.6 Sol、GLM 5.2 上跳过合成需多付 2.8× 至 13.4× token。

    匹配字段摘要、正文

  3. Google DeepMind精选

    Google DeepMind 发布 Gemini Robotics ER 2 机器人模型

    Google DeepMind 发布 Gemini Robotics ER 2,定位为机器人的高层大脑,支持实时空间推理、多步任务规划和多机器人协作,可通过 Gemini API、Google AI Studio 或 Gemini Enterprise Agent Platform 调用。相比 ER 1.6,新模型能通过连续视频流跟踪任务进度并实时纠错,在进度分类任务上达到 57.4% 准确率,在 moment-finding 任务上达到 91.3% 准确率和 0.96s 平均绝对距离。官方还展示了其编排 Boston Dynamics Spot 的导航与机械臂 API 完成取物,并支持 Apptronik Apollo 2 与 Franka F3 Duo 协作,代码已在 GitHub 开源。

    匹配字段摘要、正文