独立研究者如何在AI失准事件后调查AI行为倾向
METR 提出一套由独立研究者对 AI 失准事件开展第三方调查的方法,重点追问智能体失准行为的动机及其如何从训练与部署条件中产生。调查需获得足够的推理预算、时间与 AI 工具支持,完整调查可能耗时数周至数月。调查结论应直接提交公司董事会及相关监督机构,并在必要删减后公开,同时披露访问权限、时间、人员与调查范围等合作条款。
匹配字段摘要
METR 提出一套由独立研究者对 AI 失准事件开展第三方调查的方法,重点追问智能体失准行为的动机及其如何从训练与部署条件中产生。调查需获得足够的推理预算、时间与 AI 工具支持,完整调查可能耗时数周至数月。调查结论应直接提交公司董事会及相关监督机构,并在必要删减后公开,同时披露访问权限、时间、人员与调查范围等合作条款。
匹配字段摘要
我们发布 PerceptionBench,一个隔离视觉感知、并将其作为一组原子能力进行评估的基准——这些能力是从当今模型的失败方式中发现的,而非预先定义。 从前沿模型在 42 个基准上的失败中,我们推导出 10 项原子感知能力,并构建了 3,000 道经过验证的问题,每道题只隔离一项能力,仅凭观察即可作答,无需推理或外部知识。
我们发布 PerceptionBench,一个隔离视觉感知、并将其作为一组原子能力进行评估的基准——这些能力是从当今模型的失败方式中发现的,而非预先定义。 从前沿模型在 42 个基准上的失败中,我们推导出 10 项原子感知能力,并构建了 3,000 道经过验证的问题,每道题只隔离一项能力,仅凭观察即可作答,无需推理或外部知识。
匹配字段摘要
Kimi.ai 宣布 Fireworks 成为 Kimi K3 的 day0 发布伙伴,开发者可在 Fireworks 上通过几次点击部署并微调 2.8T 参数的 Kimi K3。Fireworks 表示该模型为 3 万亿参数级别的首个前沿开源模型,具备 1M 上下文、原生视觉与推理能力,采用美国托管且零数据留存。
匹配字段摘要
Kimi.ai 宣布 Modal 成为 Kimi K3 的 Day 0 启动合作伙伴。Modal 为 K3 的架构训练了定制的 DFlash 推测器,实现更快的推理且无质量损失。Modal 表示 Moonshot 已发布全球首个开放的 3T 级模型,K3 是他们合作过的最强开放模型。
匹配字段摘要
我们开源了 MoonEP,这是我们面向分布式 MoE 工作负载的高性能通信库。 MoonEP 旨在让大规模专家并行通信更高效,帮助降低大型 MoE 训练和推理系统中的通信开销。 在 GitHub 上查看: https://t.co/h2Rcwg88dQ
我们开源了 MoonEP,这是我们面向分布式 MoE 工作负载的高性能通信库。 MoonEP 旨在让大规模专家并行通信更高效,帮助降低大型 MoE 训练和推理系统中的通信开销。 在 GitHub 上查看: https://t.co/h2Rcwg88dQ
匹配字段摘要
NVIDIA 推出 Cosmos-H-Dreams,可根据初始 RGB 帧和实时机器人运动学数据,自回归生成手术场景。经知识蒸馏并由 FlashDreams 加速后,模型在单张 NVIDIA RTX PRO 6000 上达到约 160 帧/秒,高于标准推理的约 10 帧/秒。其提供 dVRK 台面缝合预训练检查点并已集成 Versius 平台,但定位为研发平台,而非诊断系统或实体手术机器人控制器。
NVIDIA 推出 Cosmos-H-Dreams,可根据初始 RGB 帧和实时机器人运动学数据,自回归生成手术场景。经知识蒸馏并由 FlashDreams 加速后,模型在单张 NVIDIA RTX PRO 6000 上达到约 160 帧/秒,高于标准推理的约 10 帧/秒。其提供 dVRK 台面缝合预训练检查点并已集成 Versius 平台,但定位为研发平台,而非诊断系统或实体手术机器人控制器。 · NVIDIA introduced Cosmos-H-Dreams, which autoregressively generates surgical scenes from an initial RGB frame and live robot kinematics. After distillation and FlashDreams acceleration, it runs at about 160 frames per second on a single NVIDIA RTX PRO 6000, up from roughly 10 frames per second wi
匹配字段摘要
SGLang 与 Miles 宣布在 Kimi K3 发布当天提供 Day-0 支持,前者负责推理、后者负责 RL 训练,与 Moonshot AI、NVIDIA 团队合作完成。K3 是首个 3 万亿参数级别的开源模型,实际为 2.8T 参数、1M token 上下文窗口并具备原生视觉理解,其 69 层 KDA 线性注意力与 24 层 MLA 交织的混合架构打破了常规服务栈的多项假设。文中给出统一显存池、DSpark 投机解码与 ReplaySSM、分阶段并行等方案,并报告在 16 节点 × 4 GB300 上做 DAPO 数学 RL 训练,AIME-2024 贪心评测在 12 小时内从 43.3% 升至 76.7%。

匹配字段摘要
Together AI 在 DeepSWE 基准上对比 Kimi K3 与 Claude Fable 5:Fable 5 在 xhigh 设置下 pass@1 为 69.9%,Kimi K3 max 为 68.5%,但 Kimi K3 在 pass@2(82.0 对 80.2)和 pass@4(89.4% 对 88.5%)上反超。成本方面,Kimi K3 每次 rollout 为 4.65 美元,Fable 5 为 13.41 美元,每 100 美元分别完成 14.7 与 5.3 个任务。Kimi K3 是 Moonshot AI 的开源权重模型,可自托管或通过推理服务商部署。
匹配字段摘要
Figma 用 Claude Code(Opus 4.8,xhigh 推理强度)和 Codex(GPT-5.6 Sol,high 推理强度)双模型审查每个 PR,单次审查中位成本约 0.50 美元。首周仅约 15%(27 条中 4 条)的发现有效,团队以 70% 精确率为门槛,用 99 行、2560 词、68 条先例的策略文件把精确率提上来,并意外得到一份完整威胁模型,同一策略同时支撑安全代码生成与历史代码审计。

匹配字段摘要
xAI 宣布 Grok 4.5 现已在 grok.com、X 以及 iOS 和 Android 的 Grok 应用中上线。官方称 Grok 4.5 是其目前能力最强的模型,能跟踪更长的对话、给出更清晰的回答,并在难题上更高效地推理。它还能端到端完成任务,例如搭建可用的电子表格、把大纲转成幻灯片和图表、起草文稿以及从长 PDF 中提取要点,并可通过 Microsoft 365 加载项在 Word、Excel、PowerPoint 和 Outlook 中直接使用。
匹配字段摘要
Google DeepMind 研究副总裁 Raia Hadsell 认为,基础模型可以学习语言之外复杂系统的底层规律,未来十年的进展将更多来自世界、机器人、生物和天气等领域。她以 DiffusionGemma 的文本扩散机制、Genie 世界模型及机器人训练为例,说明整块生成、自适应计算和模拟交互数据如何支持推理与具身智能。
匹配字段摘要
Cognition 推出 Devin Outposts,让 Devin 的执行环节迁入用户自控环境,推理仍留在 Cognition 云端。Modal 作为发布伙伴推出开源集成 modal-devin,使 Devin Outpost 会话运行在 Modal Sandbox 中,具备快速冷启动、自定义镜像、快照和百万级沙箱扩展能力,7 月 21 日起进入 alpha。modal-devin 提供 CLI,一条 uvx modal-devin init 命令即可搭建 outpost,并预装 Devin CLI、FFmpeg 和 Chromium。
匹配字段摘要
易观分析发布《2026年二季度中国办公智能体平台市场洞察》,从市场趋势与流量格局两个维度分析中国办公智能体平台。2026年6月,17款主流产品合计访问量突破6000万次,WorkBuddy月访问量领先,TRAE IDE(国内版)、QoderWork位于第一梯队。报告还指出模型推理成本进入精细化定价阶段、GUI Agent加速产品化,企业版办公智能体成为头部厂商新增长点。
匹配字段摘要、正文
Unsloth 发布 AMD 版本,用户现在可以在 AMD 硬件上训练和运行 LLM。该版本与 AMD 合作实现,支持在 AMD GPU 上训练和运行 500+ 模型,覆盖 Windows、WSL、Linux,并可在 3GB VRAM 上训练 Qwen、Gemma。官方称借助自研 Triton kernel 和数学算法,在 Radeon、Instinct、Ryzen 及数据中心 GPU 上最高提速 2 倍、显存占用减少 70% 且无精度损失,同时提供针对 GGUF 与 Safetensors 推理优化的 ROCm 构建。
匹配字段摘要
Together AI 与 Y Combinator 宣布合作推出首个 YC 专属 GPU 集群,让 YC 投资组合中的 AI 初创公司更便捷地获取推理与训练算力。初创公司可通过 Together 自助门户自行预留、配置和管理 GPU,几分钟内即可就绪,并享受长期费率而非长期承诺。该集群目前已满负荷运行,双方计划继续扩容。
匹配字段摘要
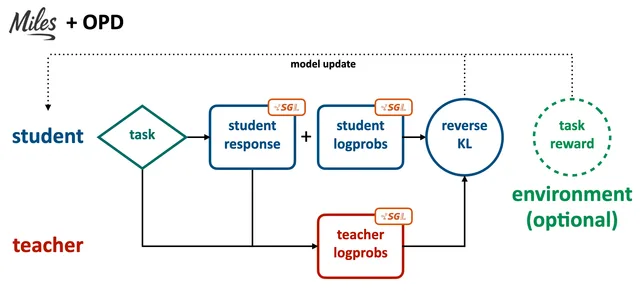
LMSYS 在 Miles 中实现了 On-Policy Distillation(OPD),支持纯蒸馏与结合 GRPO/PPO 的 RL 增强蒸馏两种模式,并新增稀疏学生到教师打分流程以避免稠密 logprob 负载。在单台 8×NVIDIA B200 节点上,团队用 Qwen3.5-35B-A3B 做自蒸馏实验:教师经 RLVR 训练后推理更短,学生为 RL 前基座,任务奖励设为零,仅用 top-1 学生-教师 reverse-KL 训练,结果显示 OPD 能在不损失性能的前提下将教师的短推理行为迁移给学生。
匹配字段摘要
The Next Platform 依据台积电 2026 年第二季度财报估算,AI 训练与推理芯片当季贡献约 133.1 亿美元营收,同比增长 68.3%,约占台积电总营收的三分之一、HPC 业务营收的一半。台积电当季营收创下 402 亿美元纪录,同比增长 33.7%,净利润 223.7 亿美元,同比增长 74.7%;公司同时宣布向亚利桑那州追加 1000 亿美元投资,使美国业务总投资达到 2650 亿美元。
匹配字段摘要
xAI 发布 Grok 4.5,称其为最强模型,专为编码、智能体任务和知识工作打造,并与 Cursor 联合训练。在 Datacurve 的 DeepSWE 基准上,Grok 4.5 得分 62.0%,高于 Opus 4.8 的 55.75%,低于 Fable 的 66.1% 和 GPT 5.5 的 64.31%。模型在数万块 NVIDIA GB300 GPU 上训练,推理速度 80 TPS,定价为每百万输入 token 2 美元、每百万输出 token 6 美元,并已成为 Grok Build 的默认模型。
匹配字段摘要
xAI 将编码智能体与 TUI 工具 Grok Build 开源,源码已发布在 GitHub。公开的代码涵盖智能体循环、工具调用分发、终端 UI 以及 skills、plugins、hooks、MCP servers 和 subagents 等扩展系统。Grok Build 现可完全本地运行,用户可自行编译并指向本地推理,通过 config.toml 驱动。
匹配字段摘要
Mistral 发布首个时间序列基础模型系列 Timestral,最大模型仅 209M 参数,在 GIFT-Eval、TIME 和 fev-bench 三大公开基准上均排名第一,超越此前 SOTA 且参数量仅为其三分之二。该系列含 5M、28M、123M、209M 四种规模,支持概率化多变量预测及过去与未来协变量,无需 GPU 即可在 CPU 上推理,5M 模型单日预测仅需 10 ms。

匹配字段摘要