←搜索结果

按匹配度 · 共 3172 条结果 清除搜索

星期二

  1. OpenHands 官方博客

    OpenHands 详解 2026 年 AI 代码分析:从规则引擎到自主智能体的四个层级

    OpenHands 官方博客梳理了 2026 年 AI 代码分析的四层格局:Tier 1 规则型静态分析(SonarQube、ESLint、Semgrep)、Tier 2 AI 增强 SAST(Snyk Code、Checkmarx)、Tier 3 AI 原生 PR 审查(CodeRabbit、Greptile)、Tier 4 自主代码分析智能体。其核心循环为检索→推理→行动→验证,依靠 AST 与 LSP 提供结构化事实、沙箱执行验证补丁,能捕捉规则引擎无法覆盖的业务逻辑缺陷。OpenHands 自身是模型无关的开源智能体平台,通过 Agent Client Protocol 连接 Claude、Codex、Gemini,支持本地、OpenHands Cloud 或自托管 VPC 运行。
    Download for free CTA

    匹配字段摘要

星期五

  1. xAI News

    xAI 通过 API 公测发布编码模型 grok-build.0.1

    xAI 通过 xAI API 公测发布编码模型 grok-build.0.1,该模型专为智能体编码任务训练,覆盖 Web 开发、调试和 MCP 支持,也是 Grok Build 背后的同一模型。它提供 100+ tokens/秒的推理速度,定价为输入 $1/m tokens、输出 $2/m tokens,也可用于通用智能体与工具调用场景,并已在 OpenRouter 和 Vercel AI Gateway 上线。

    匹配字段摘要

  2. Claude 应用发布说明精选

    Anthropic 发布 Claude Opus 4.8

    Anthropic 发布 Claude Opus 4.8,在编码、智能体、推理等基准上较 Opus 4.7 有所提升,价格不变。同时推出 claude.ai 上的努力程度控制、Claude Code 的动态工作流功能,以及快模式降价三倍。

    匹配字段摘要

星期四

  1. Mistral AI

    Mistral 发布工业工程 AI 栈与 Vibe 智能体,并宣布法国 10 MW 数据中心

    Mistral 在 AI Now Summit 上发布面向工业工程的集成 AI 栈,结合物理模型、工程经验与机器人技术,并与 Airbus、BMW、ASML 展开合作,覆盖设计、仿真与生产环节。其智能体工具 Vibe 升级为可处理长周期多步任务的统一智能体,能完成深度研究、交付物起草,以及从需求到合并变更的编码工作。Mistral 还宣布位于法国 Les Ulis 的 10 MW 推理数据中心,计划于 2026 年 Q3 启用。

    匹配字段摘要

  2. Mistral AI精选

    Mistral 将 Le Chat 升级为统一智能体 Vibe,推出 Work Mode 与 Code Mode

    Mistral 将 Le Chat 升级为统一 AI 智能体 Vibe,同时覆盖工作与编码场景,原有对话、设置和订阅方案全部保留。Work Mode 支持企业知识搜索、结构化数据分析、文档报告生成、多步骤任务定时执行和可复用技能,每一步推理与工具调用均可展开查看;Code Mode 在网页端启动远程编码智能体,可连接 GitHub 并运行至提交 pull request。Vibe 同时发布 VS Code 扩展并更新 CLI,支持技能命令、子智能体、会话级权限和 /teleport 会话迁移,定价为免费、Pro 14.99 美元/月、Team 24.99 美元/用户/月及 Enterprise 定制。

    匹配字段摘要

  3. Linear:Now

    Linear 发布 Diffs,加速应用内代码审查

    Linear 发布 Diffs,让用户直接在 Linear 内审查 pull request,并将代码变更与对应的 issue、项目和客户反馈并列呈现。引导式审查会把大型 diff 拆成按推理顺序排列的章节,结构化高亮则过滤格式调整等噪声。该功能从今天起面向所有 Linear 套餐开放。

    Abstract illustration of code review UI

    匹配字段摘要

  4. Liquid AI 模型与工程博客精选

    Liquid AI 发布端侧 MoE 模型 LFM2.5-8B-A1B

    Liquid AI 发布端侧 MoE 模型 LFM2.5-8B-A1B,面向消费级硬件上的工具调用,上下文窗口从 32,768 扩展到 128,000 tokens,预训练规模从 12T 提升到 38T tokens,词表从 65,536 扩至 128,000。该模型为纯推理模型,在 M5 Max 上解码 253 tokens/s、Ryzen AI Max+ 395 上 146 tokens/s,占用低于 6 GB,单张 H100 高并发下输出吞吐达 18.5K tokens/s。基础版与后训练版已在 Hugging Face 和 Playground 上线,首日支持 llama.cpp、MLX、vLLM、SGLang 和 ONNX。

    匹配字段摘要

星期三

  1. 小米 MiMo精选

    小米 MiMo-V2.5 系列 API 永久降价,最高降幅 99%

    小米 MiMo 宣布 MiMo-V2.5 系列 API 永久降价,相比此前定价最高降幅达 99%,并对所有上下文长度统一计价。MiMo Token Plan 同步升级,同等价格下可用 token 增加 5–8 倍,计费规则更简单透明,现有 Token Plan 额度将全部重置;MiMo-V2.5-TTS 仍限时免费。新价格于 5 月 26 日 18:00 PDT 生效,官方称后续会发布推理优化技术博客。

    匹配字段摘要

星期一

  1. Epoch AI:Gradient Updates

    Epoch AI:算力紧张是否即将到来

    Epoch AI 建模全球 Nvidia GB200 与 GB300 芯片的推理吞吐,估算在服务 Kimi K2.6 类模型时,全球每秒可产出 5 亿至 200 亿个输出 token,具体取决于请求上下文长度。研究同时指出全球推理算力每年增长约 3.4 倍,而 token 需求按现有代理指标估算每年增长约 10 倍,可能已超过供给增速。若趋势延续,算力紧张可能临近,长上下文和智能体类工作负载受影响更明显,前沿能力访问价格或上升,日常用户则可能转向更小更便宜的模型。

    匹配字段摘要

星期五

  1. Mistral AI

    Mistral 发布 Mistral Medium 3.5 与 Vibe 云端远程智能体

    Mistral 发布 Mistral Medium 3.5,这是一个 128B 稠密模型,统一指令跟随、推理与编码,上下文窗口 256k,以修改版 MIT 许可开放权重,可在少至四块 GPU 上自托管。该模型在 SWE-Bench Verified 上得分 77.6%,τ³-Telecom 得分 91.4,并成为 Mistral Vibe 与 Le Chat 的默认模型。同时 Mistral 将编码智能体搬到云端,Vibe 远程智能体可从 CLI 或 Le Chat 启动、并行异步运行,本地会话可迁移上云,完成后可开 PR 并通知;Le Chat 新增 Work 模式(预览),由新智能体驱动多步任务与跨工具流程,敏感操作需人工批准。API 定价为每百万输入 token 1.5 美元、每百万输出 token 7.5 美元,已在 Pro、Team 和 Enterprise 套餐上线。

    匹配字段摘要

星期四

  1. Modal 官方工程博客

    Modal 完成 3.55 亿美元 C 轮融资,估值 46.5 亿美元

    Modal 宣布完成 3.55 亿美元 C 轮融资,投后估值 46.5 亿美元,由 General Catalyst 和 Redpoint 领投,Menlo、Bain Capital Ventures、Accel 等新投资方加入,原有主要投资方全部跟投。公司称自去年 9 月以来规模增长五倍,年化收入超过 3 亿美元。Modal 定位为面向 AI 负载的云平台,提供弹性推理、智能体运行时、强化学习和批处理任务等能力,Sandboxes 已贡献超过三分之一收入,平台累计启动超过 10 亿个沙箱。

    匹配字段摘要

星期三

  1. Qwen Blog精选

    阿里发布 Qwen3.7-Max,面向智能体时代的旗舰模型

    阿里 Qwen 团队发布 Qwen3.7-Max,定位为面向智能体时代的专有模型,可通过阿里云百炼(Model Studio)调用 API。官方称其在编码智能体、通用智能体与推理基准上取得领先或接近 Opus-4.6 Max 的成绩,并支持 Claude Code、OpenClaw、Qwen Code 等多种框架。文中还展示了一次约 35 小时、1158 次工具调用的自主内核优化,最终相对 SGLang Triton 参考实现取得 10.0x 几何平均加速。

    匹配字段摘要

星期六

  1. Ahead of AI

    近期大语言模型架构进展解析:KV 共享、mHC 与压缩注意力

    文章解析 Gemma 4、Laguna XS.2、ZAYA1-8B 和 DeepSeek V4 如何通过 KV 共享、分层注意力预算、mHC 与压缩注意力降低长上下文成本。Gemma 4 E2B 在 128K 上下文中可节省 2.7 GB KV cache,DeepSeek V4-Pro 在 1M-token 上下文下的单 token 推理 FLOPs 和 KV cache 分别降至 DeepSeek V3.2 的 27% 和 10%。这些设计显示 Transformer 架构正以更复杂但更具针对性的改动提升长上下文推理效率。

    匹配字段摘要

星期五

  1. xAI News

    xAI 将 Grok 订阅接入开源智能体 Hermes Agent

    xAI 宣布即日起可在 Nous Research 的开源自我改进智能体 Hermes Agent 中直接使用 Grok 订阅。接入后可用 Grok 4.3 进行文本对话与高级推理、Grok Text-to-Speech 生成语音回复、Grok Imagine 生成图像和视频,所有订阅档位均可使用。Hermes Agent 可持久运行在任意电脑、沙箱或 VPS 上,跨会话建立长期记忆,并能连接 WhatsApp、Discord、Telegram、Signal 等消息平台;用户通过 hermes model 选择 xAI Grok OAuth 并浏览器登录即可启用。

    匹配字段摘要

星期三

  1. LMSYS Blog

    LMSYS 详解 Miles 框架中的 Token-In-Token-Out(TITO)机制

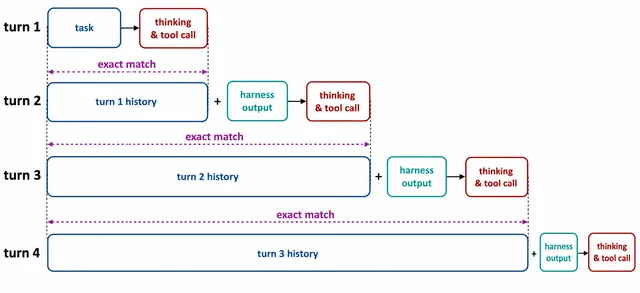
    LMSYS 发文解释智能体 RL 中的 Token-In-Token-Out(TITO)原则:若第 n-1 轮的全部 token 序列是第 n 轮 prompt 的逐位前缀,则 TITO 成立。按“每任务一个样本”打包数据,相比“每轮一个样本”,在 30-50 轮的 SWE-Bench 类任务上可少用约一个数量级的算力。文章还列出 detokenize-retokenize 不匹配、chat 模板裁剪推理内容、模板重渲染有损三种破坏场景,并介绍 Miles 的推理会话服务器、可插拔 TITO tokenizer 等实现。

    TITO definition diagram

    匹配字段摘要

星期二

  1. Modal 官方工程博客

    Modal 如何实现真正的无服务器 GPU

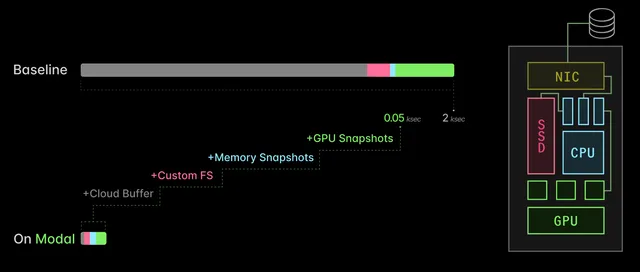
    Modal 官方工程博客详解其无服务器 GPU 方案,通过云缓冲、自定义文件系统 ImageFS、CPU 检查点恢复和 CUDA 检查点恢复四项优化,把 AI 推理服务副本的启动时间从约 2000 秒缩短到 50 秒,提速 40 倍。其中 GPU 内存快照让 vLLM 或 SGLang 服务约 1 GiB 模型(Qwen 3 0.6B bf16)的冷启动典型提速 4-10 倍,Reducto 的冷启动从约 70 秒降到约 12 秒。作者称该技术栈已在数千万个副本规模上运行,过去三个月有数百家组织使用 CPU 和 GPU 快照。

    Diagram indicating latency to scale up an inference server in a baseline cloud system and on Modal

    匹配字段摘要

  2. Prime Intellect精选

    Prime Intellect 开源 renderers:面向智能体 RL 的 Token 级模板库

    Prime Intellect 开源 renderers,一个独立的 Python 库,让开发者完全控制 RL 和多轮推理中的对话格式化。它把聊天模板变成可编程对象,暴露渲染消息为 token id、解析补全为结构化助手消息、为损失掩码归属 token、以及在不重新渲染模型采样历史的情况下扩展多轮 rollout 等操作。该库已用于其 Lab 产品、verifiers 和 prime-rl,内置 Qwen3、Qwen3.5、GLM-4.5、GLM-5、MiniMax-M2、DeepSeek-V3、Kimi K2 / K2.5、Nemotron-3 和 GPT-OSS 的渲染器,并已在 PyPI 发布,代码托管于 github.com/PrimeIntellect-ai/renderers。

    renderers: Token-Level Templating for Agentic RL

    匹配字段摘要

星期一

  1. Zyphra Research

    Zyphra 通过 Zyphra Cloud 提供 15 兆瓦 AMD Instinct MI355X GPU 算力

    Zyphra 宣布通过 Zyphra Cloud 提供 15 兆瓦 AMD Instinct MI355X GPU 算力,并在原有 serverless 推理基础上扩展至裸金属 AMD 基础设施,支持预训练、大规模强化学习与后训练以及智能体推理。Zyphra Research 近期发布了在 AMD Instinct MI300X 上端到端预训练的 ZAYA1-8B 和 ZAYA1-74B-Preview,以及面向长上下文与智能体推理的 TSP 算法。MI355 GPU 算力现已可用,Zyphra 计划后续支持 MI450 系列。

    匹配字段摘要

星期四

  1. Zyphra Research精选

    Zyphra 发布 ZAYA1-74B-Preview,在 AMD 上完成大规模预训练

    Zyphra 发布 ZAYA1-74B-Preview,这是一个 4B 激活、74B 总参数的 MoE 模型,以 Apache 2.0 许可开源,权重和模型卡已上线 Hugging Face。该模型是未经 RL 后训练和指令微调的 pre-RL 推理基座,预训练约 15T token,中训练分三阶段将上下文从 32k 逐步扩展至 256k,每阶段约 1T token。训练全程使用 MI300x GPU 与 Pensando Pollara 互联,Zyphra 表示 AMD 上的完整规模 RL 正在进行,预计未来几周发布最终版 ZAYA1-74B。

    匹配字段摘要

  2. Prime Intellect精选

    Prime Intellect 发布 Lab 智能体训练平台正式版

    Prime Intellect 宣布 Lab 结束 beta 并正式开放,这是一个面向自我改进智能体的训练平台,把任务定义、harness、评测、奖励信号训练、rollout 检查、adapter 部署和推理整合到一处。平台以环境为基本单元,Hosted Training 负责大规模强化学习,按 token 计费而非按集群小时计费,正式版首批支持来自 NVIDIA、OpenAI、Meta 和 Qwen 的 14 个模型,参数规模在 1B 到 70B 之间。beta 期间已有数百名用户运行超过 10,000 次训练任务,训练完成的 LoRA adapter 可通过 Prime Inference 以 OpenAI 兼容 API 部署。

    Releasing Lab: the training platform for self-improving agents

    匹配字段摘要