SpaceXAI 与 Anthropic 签署 Colossus 1 算力合作协议
SpaceXAI 与 Anthropic 签署协议,向后者提供 Colossus 1 超级计算机的算力访问。Colossus 1 配备超过 220,000 块 NVIDIA GPU,包含 H100、H200 和下一代 GB200 加速器的密集部署,面向大语言模型、多模态系统和生成式 AI 的训练、微调与推理。Anthropic 还表示有兴趣合作开发数吉瓦级的轨道 AI 算力容量。
匹配字段摘要
SpaceXAI 与 Anthropic 签署协议,向后者提供 Colossus 1 超级计算机的算力访问。Colossus 1 配备超过 220,000 块 NVIDIA GPU,包含 H100、H200 和下一代 GB200 加速器的密集部署,面向大语言模型、多模态系统和生成式 AI 的训练、微调与推理。Anthropic 还表示有兴趣合作开发数吉瓦级的轨道 AI 算力容量。
匹配字段摘要
OpenAI 联合创始人兼总裁 Greg Brockman 在周二庭审证词中表示,公司预计到今年年底将在算力上烧掉 500 亿美元,该数字此前由 Bloomberg 报道。文章指出,亚马逊、Nvidia 和软银 2 月宣布的 1100 亿美元投资中至少 800 亿美元附带条件,例如 OpenAI 需租用 2 吉瓦亚马逊 Trainium 加速器并在 AWS 部署 GPT 模型才能拿到 500 亿美元中的 350 亿美元,Nvidia 的 300 亿美元投资则与 5 吉瓦训练和推理算力部署挂钩。
匹配字段摘要
Astera Labs 发布代号 Scorpio X 的 AI fabric 交换芯片,单颗 ASIC 集成 320 条 PCIe 6.0 通道,双向带宽 5.12 TB/s,可与几乎任何加速器配合使用。该芯片内置类似 NVSwitch 的网络内计算能力,并针对 MoE 推理推出名为 Hypercast 的多播操作,以减少 GPU 等待网络的时间。Scorpio X 系列与扩展至 32 至 320 通道的 Scorpio P 系列交换芯片目前处于送样阶段,量产预计在 2026 年下半年启动。
匹配字段摘要
Zyphra 发布 Zyphra Cloud,一个运行在 AMD 基础设施上、由 Tensorwave 提供算力的全栈 AI 平台,首发服务为无服务器推理服务 Zyphra Inference,可访问 DeepSeek V3.2、Kimi K2.6 和 GLM 5.1 等前沿开放权重模型。该服务面向智能体编程、深度研究和长周期工作流自动化等长周期智能体场景,结合定制 kernel、长上下文推理算法与并行方案实现高吞吐低延迟。平台后续将扩展至强化学习与微调等分布式后训练服务、基于 AMD EPYC CPU 的沙箱智能体与开发环境,以及专用 GPU 集群和裸金属基础设施,现已可用。

匹配字段摘要
Augment 推出 Prism 模型路由选项,在模型选择器中自动为每个用户轮次选择最合适的底层模型,声称每月可节省约 2 万美元或降低 30% 成本,同时质量与前沿推理模型相当。Prism 采用缓存感知路由,仅在切换收益超过缓存驱逐成本时切换模型,并在内部多轮编码基准、Terminal Bench 2.0 和 SWE-Bench Pro 上验证了质量与成本表现。

匹配字段摘要
Together AI 与 Adaption 合作,将 Together Fine-Tuning 集成到 Adaptive Data,使用户可优化训练数据、以建议的超参数直接执行微调,并部署模型进行评估和推理。该工作流支持 LoRA 和全量微调、超过 100B 参数的开放模型、训练前成本估算、运行 ETA 跟踪,以及向 Hugging Face Hub 导出模型。
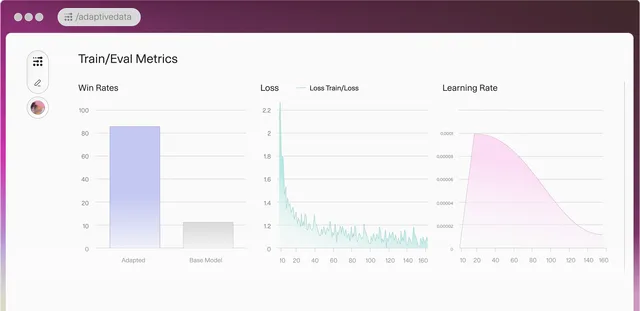
Together AI 与 Adaption 合作,将 Together Fine-Tuning 集成到 Adaptive Data,使用户可优化训练数据、以建议的超参数直接执行微调,并部署模型进行评估和推理。该工作流支持 LoRA 和全量微调、超过 100B 参数的开放模型、训练前成本估算、运行 ETA 跟踪,以及向 Hugging Face Hub 导出模型。 · Together AI has partnered with Adaption to integrate Together Fine-Tuning into Adaptive Data, enabling users to optimize training datasets, run fine-tuning directly with suggested hyperparameters, and deploy models for evaluation and inference. The workflow supports LoRA and full fine-tuning, open models with ove
匹配字段摘要
Together AI 现已提供 DeepSeek-V4 Pro,Serverless Inference 支持 512K-token 上下文,Dedicated Inference 可提供完整 1M 上下文、预留容量和工作负载隔离。该模型支持三种推理模式,价格为每 1M tokens 输入 $2.10、缓存输入 $0.20、输出 $4.40。
Together AI 现已提供 DeepSeek-V4 Pro,Serverless Inference 支持 512K-token 上下文,Dedicated Inference 可提供完整 1M 上下文、预留容量和工作负载隔离。该模型支持三种推理模式,价格为每 1M tokens 输入 $2.10、缓存输入 $0.20、输出 $4.40。 · Together AI now offers DeepSeek-V4 Pro with a 512K-token context window on Serverless Inference, while Dedicated Inference can provide the full 1M context, reserved capacity, and workload isolation. The model supports three reasoning modes and costs $2.10 per 1M input tokens, $0.20 per 1M cached input tokens, and $4.40 per
匹配字段摘要
LMSYS 为 SGLang 的 RL 工作负载引入基于 RDMA 的点对点权重更新机制,作为传统 NCCL broadcast 的补充,兼容所有主流开源模型。在 1T 参数的 Kimi-K2 上,权重传输时间从 53 秒降至 7.2 秒,代价是每个训练 rank 在 CPU 内存上多占用一个 32G 的推理引擎副本。该设计通过源侧 CPU 引擎副本和 Mooncake TransferEngine 的零拷贝传输,让所有训练 rank 参与发送各自分片,减少网络冗余并让推理服务更快恢复 rollout。

匹配字段摘要
AE Studio 在 Modal 上搭建了一套用强化学习训练 LLM 证明数学定理的工作流,用 Lean 编译器提供可验证奖励,并对比了 GRPO 与 Evolution Strategies(ES)两种更新规则。系统由 GPU 上的 vLLM 推理、CPU 上的沙箱化 Lean 验证器和轻量协调进程三部分组成,一次迭代生成 3,840 条证明尝试并按 64 条分批验证。借助 Modal 的 .map() 并行扇出和沙箱隔离,ES 的权重扰动仅靠种子和奖励聚合,无需在 GPU 间传输权重。
匹配字段摘要
Sakana AI 提出 KAME(Tandem Architecture for Enhancing Knowledge)架构,被 ICASSP2026 接收,让语音到语音模型负责快速响应、后端 LLM 异步生成候选回答并作为“oracle”信号实时注入,把范式从“先想后说”变为“边说边想”。后端 LLM 可自由替换 GPT-4.1、Claude Opus 或 Gemini 2.5 Flash,实验中 Claude 在推理类任务得分更高,GPT 在人文类任务表现更好。
匹配字段摘要
Together AI 已上线 NVIDIA Nemotron 3 Nano Omni,为开发者提供托管式生产级多模态推理服务。该开放模型采用混合 Transformer-Mamba MoE 架构,总参数量为 30B、每个 Token 激活约 3B 参数,并支持最高 256K Token 的共享多模态上下文。开发者可通过 API 部署,也可在云端、本地或隔离环境中自行部署。
Together AI 已上线 NVIDIA Nemotron 3 Nano Omni,为开发者提供托管式生产级多模态推理服务。该开放模型采用混合 Transformer-Mamba MoE 架构,总参数量为 30B、每个 Token 激活约 3B 参数,并支持最高 256K Token 的共享多模态上下文。开发者可通过 API 部署,也可在云端、本地或隔离环境中自行部署。 · Together AI has made NVIDIA Nemotron 3 Nano Omni available to developers as a managed, production-grade multimodal inference service. The open model uses a hybrid Transformer-Mamba MoE architecture with 30B total parameters, activates about 3B parameters per token, and supports up to 256K tokens of shared mu
匹配字段摘要
小米 MiMo 宣布 SGLang 与 vLLM 已支持 MiMo-V2.5 系列,开发者可在开源当天用这两个推理框架启动该系列模型。官方感谢 SGLang 项目(来自 lmsysorg)与 vllm_project 快速跟进。该系列此前已以 MIT 协议开源,包含 MiMo-V2.5-Pro 和原生全模态的 MiMo-V2.5,两者均支持 1M-token 上下文窗口。
小米 MiMo 宣布 SGLang 与 vLLM 已支持 MiMo-V2.5 系列,开发者可在开源当天用这两个推理框架启动该系列模型。官方感谢 SGLang 项目(来自 lmsysorg)与 vllm project 快速跟进。该系列此前已以 MIT 协议开源,包含 MiMo-V2.5-Pro 和原生全模态的 MiMo-V2.5,两者均支持 1M-token 上下文窗口。
匹配字段摘要
Together AI 提出分布感知推测解码(DAS),在不改变模型输出或奖励质量的情况下,将强化学习后训练的 rollout 加速最高 50%。DAS 以近期轨迹构建自适应后缀树,并通过长度感知调度平衡 GPU 负载和推测预算。在数学推理的 DSR-sub 数据集上,rollout 时间减少超过 50%;采用单元测试奖励信号的代码生成任务中减少约 25%。
Together AI 提出分布感知推测解码(DAS),在不改变模型输出或奖励质量的情况下,将强化学习后训练的 rollout 加速最高 50%。DAS 以近期轨迹构建自适应后缀树,并通过长度感知调度平衡 GPU 负载和推测预算。在数学推理的 DSR-sub 数据集上,rollout 时间减少超过 50%;采用单元测试奖励信号的代码生成任务中减少约 25%。 · Together AI introduced distribution-aware speculative decoding (DAS), accelerating RL post-training rollouts by up to 50% without changing model outputs or reward quality. DAS builds an adaptive suffix tree from recent trajectories and uses length-aware scheduling to balance GPU workloads and speculation budgets. It
匹配字段摘要
Sakana AI 发布旗舰商用产品 Sakana Fugu,这是一个多智能体编排系统,通过动态协调多个前沿基础模型在编码、数学、科学推理等任务上取得高性能,现已开放早期 Beta 测试申请。该产品以 API 形式提供,兼容 OpenAI 格式端点,现有使用 GPT、Gemini 或 Claude API 的工作流几乎无需改动即可接入,背后由 Fugu 自动完成协作拓扑搭建、角色分配和子任务分发。产品分为侧重延迟的 Sakana Fugu Mini 和面向高难度任务的 Sakana Fugu Ultra 两个版本,方法基于其 ICLR 2026 论文 Trinity 和 Conductor 并做了进一步改进。
匹配字段摘要
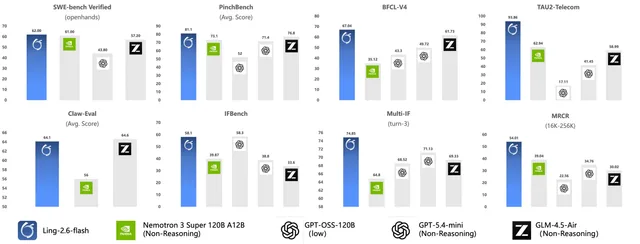
蚂蚁百灵发布 Instruct 模型 Ling-2.6-flash,总参数量 104B、激活参数 7.4B,围绕推理效率、Token 效率与 Agent 场景做系统优化。官方称其在 4 卡 H20 下推理速度最快达 340 tokens/s,Prefill 吞吐为 Nemotron-3-Super 的 2.2 倍;Artificial Analysis 完整评测中仅消耗 15M tokens,约为 Nemotron-3-Super 等模型的 1/10。模型在 BFCL-V4、TAU2-bench、SWE-bench Verified、Claw-Eval、PinchBench 等评测中取得同尺寸 SOTA 水平,并已在 OpenRouter 与官方平台提供一周免费 API 调用,BF16、FP8、INT4 版本将于近期开源。
匹配字段摘要、正文
Anthropic 发文说明近一个月用户反馈的 Claude 质量下滑问题,已定位到三处分别影响 Claude Code、Claude Agent SDK 和 Claude Cowork 的改动,API 未受影响,三处问题已于 4 月 20 日(v2.1.116)全部修复。三处问题分别是 3 月 4 日将 Claude Code 默认推理强度从 high 降为 medium(4 月 7 日回退)、3 月 26 日清理闲置会话旧思考内容的缓存优化出现 bug 导致每轮都清除历史(4 月 10 日修复)、4 月 16 日为降低冗长加入的系统提示词损害编码质量(4 月 20 日回退)。Anthropic 表示将让更多内部员工使用公开版本、加强系统提示词变更的评测与灰度发布,并在 X 上开设 @ClaudeDevs 说明产品决策。
匹配字段摘要
Google Research 发布智能体记忆框架 ReasoningBank,可从成功和失败经验中提炼可迁移的推理策略,让智能体在部署后持续学习。该工作基于 ICLR 论文,在 WebArena 和 SWE-Bench-Verified 上用 Gemini-2.5-Flash 评测,相比无记忆基线、Synapse 和 AWM 提升了任务成功率并减少任务步数。团队还提出记忆感知测试时扩展(MaTTS),把探索轨迹蒸馏为高质量记忆,代码已在 GitHub 开源。
匹配字段摘要
Sakana AI 提出提示技术 String Seed of Thought(SSoT):让 LLM 在输出中先生成随机字符串,再据此推导答案,无需外部随机数生成器。该方法在开源与闭源 LLM 上显著降低输出偏差,在 DeepSeek-R1 等推理模型上准确率接近真实随机采样,并可从二选一推广到 n 选一和任意概率分布。在 NoveltyBench 多样性基准的六个类别上,SSoT 均优于其他方法且保持输出质量,该工作将在 ICLR2026 展示。
匹配字段摘要
Google 提出 Simula 框架,将合成数据生成重构为数据集级机制设计,通过推理驱动、无需种子数据的智能体流程,从第一性原理构建数据集,可独立控制覆盖度、复杂度与质量。Simula 分四步:全局多样化构建层级分类树、局部多样化用 1-of-N 元提示防止模式坍缩、复杂化调节难度分布、双批评者循环校验质量。研究以 Gemini 2.5 Flash 为教师模型、Gemma-3 4B 为学生模型,在网络安全、法律推理、GSM8k 和 Global MMLU 等五个领域各生成最多 512K 数据点进行评测。
匹配字段摘要
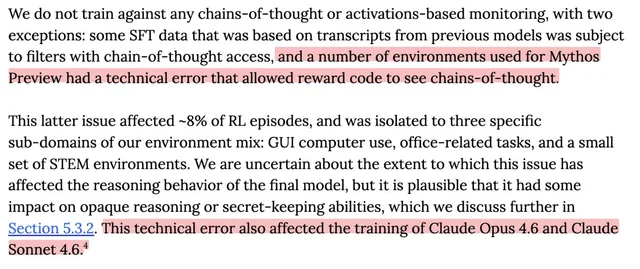
Redwood Research 指出,Anthropic 在 Claude Mythos Preview 约 8% 的训练回合中意外将思维链暴露给奖励函数,同一技术错误还波及 Opus 4.6 和 Sonnet 4.6。文章称这是 Anthropic 至少第二次独立发生 CoT 暴露给监督信号的事故,此前 Opus 4.6 和 Opus 4 也出现过类似问题。作者认为这类失误会削弱对模型推理轨迹可监控性的信心,并建议 Anthropic 在失败代价还只是声誉损失时完善开发流程。
匹配字段摘要