清华、牛津与斯坦福论文发现 LLM 关闭思考后仍会继续推理
清华大学、牛津大学与斯坦福大学的新论文发现,LLM 在关闭思考后仍会继续输出推理过程,在开放式问题上尤其明显。关闭思考时,DeepSeek-V4-Flash 在 99.9% 的开放式回答中仍写出了推理内容,缺少 think 标签或回复简短并不能证明模型跳过了推理。对 5 个模型强制只给答案可将开放式任务的遵从率提升到约 40%,但准确率下降约 15 个百分点。论文地址为 arxiv.org/abs/2610.11765。
匹配字段标题
清华大学、牛津大学与斯坦福大学的新论文发现,LLM 在关闭思考后仍会继续输出推理过程,在开放式问题上尤其明显。关闭思考时,DeepSeek-V4-Flash 在 99.9% 的开放式回答中仍写出了推理内容,缺少 think 标签或回复简短并不能证明模型跳过了推理。对 5 个模型强制只给答案可将开放式任务的遵从率提升到约 40%,但准确率下降约 15 个百分点。论文地址为 arxiv.org/abs/2610.11765。
匹配字段标题
Cohere 指出,选择共享(按量计费)还是专用(预置)推理,关键不在单价,而在请求形态与流量模式。Embedding 批量索引请求可达约 100 条描述、每条约 200 tokens,而单条搜索查询更看重延迟;Rerank 的工作量随候选文档数线性增长,从 20 个候选增至 100 个,单次搜索 token 量从约 4,400 升至约 22,000。持续稳定的流量适合专用推理,突发流量更适合按量计费。

匹配字段标题
Baseten 宣布与 Goodfire AI 合作推出 Project Beacon,通过在生成过程中读取模型内部激活值,在推理层实现主动、内联的安全控制,可在输出到达用户或工具前检测并处置不安全事件。该计划针对提示词注入、越权操作、敏感数据泄露和网络滥用等风险,未来数月将先覆盖部分模型和受监控行为,再扩展至企业管控与开发者体验,并以少量早期合作伙伴推向市场。
匹配字段标题
Baseten 宣布与 Goodfire AI 合作推出 Project Beacon,通过在生成过程中读取模型内部激活值,为开源模型推理带来主动、内联的安全控制,可在输出到达用户或工具前检测并处置不安全事件。该计划针对提示词注入、越权操作、敏感数据泄露和网络滥用等推理层风险,将 Goodfire 的行为监控信号接入 Baseten 推理路径。未来数月将先覆盖部分模型和受监控行为,再扩展至企业管控与开发者体验,并以少量早期合作伙伴推向市场。

匹配字段标题
MyMagic AI 的批量推理 API 已集成进 LlamaIndex,支持 Llama 70B、Mistral 7B、Mixtral 8x7B、CodeLlama70b 及 Embedding 模型,可处理数据提取、摘要、分类、情感分析、训练数据生成和嵌入等任务。用户将文件放入 AWS S3 或 GCS 的 session 文件夹后,通过 LlamaIndex 封装发起请求,可动态指定 prompt、模型和 max_tokens;官方建议尽量使用异步 acomplete 接口,目前不支持 chat/achat 方法。其训练数据生成速度相比 GPT-3.5 可提升 5-10 倍。
匹配字段标题
TensorZero 工程博客发布研究,用 GPT-4.1 生成的高质量对话微调 Gemini 2.0 Flash/Flash Lite、GPT-4.1 mini/nano、GPT-4o mini 和 Qwen3-8B,在数据抽取、BabyAI 导航、多跳 RAG 和 τ-bench 工具调用四类任务上评测,推理成本最多降低 30 倍、响应时间最多快 4 倍。研究还对比了只保留成功轨迹的筛选数据与全量数据,发现筛选在数据抽取和多跳 RAG 上普遍提升表现,但在工具调用任务上 Gemini 模型反而用未筛选数据更好。博客给出了基于 TensorZero 的微调与部署流程,并称无需 GPU 即可复现。
匹配字段标题
月之暗面随 Kimi K2.6 模型发布开源 Kimi Vendor Verifier(KVV)项目,帮助开源模型用户校验推理实现的准确性。KVV 包含六项基准测试,覆盖 API 参数约束预校验、OCRBench、MMMU Pro、AIME2025、K2VV ToolCall 与 SWE-Bench,其中 SWE-Bench 因依赖沙箱未开源。官方称在 Two NVIDIA H20 8-GPU 服务器上完成全流程验证,顺序执行约需 15 小时,并已针对流式推理、自动重试和断点续跑优化脚本。
匹配字段标题
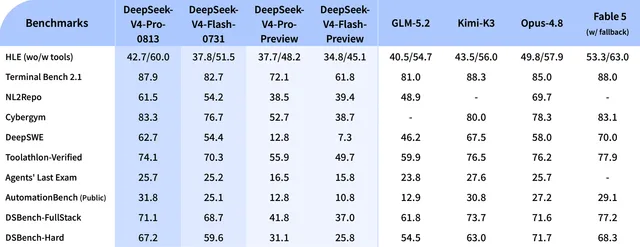
DeepSeek 发布 DeepSeek-V4-Pro,主打智能体能力升级,并为 V4-Pro 与 V4-Flash 提供 low、high、max 三档推理强度,分别对应简单任务、日常智能体工作流和复杂任务。该模型原生支持 OpenAI Responses API,针对 Codex 做了优化并支持一键配置,现已上线 app/web 的 Expert Mode 和 API,模型名称保持不变。随 V4 系列发布,API 定价同步调整并引入高峰与低谷费率,低谷费率为高峰的 50%,新定价于 2026 年 8 月 16 日 16:00 UTC 生效。
匹配字段标题
DeepSeek 发布 DeepSeek-V3.2 与 DeepSeek-V3.2-Speciale 两款面向智能体的推理优先模型,V3.2 已在 App、Web 和 API 上线,Speciale 暂仅提供 API。V3.2 定位日常使用、推理与长度更均衡,官方称达到 GPT-5 水平;Speciale 主打极限推理能力,官方称可与 Gemini-3.0-Pro 竞争,并在 IMO、CMO、ICPC World Finals 和 IOI 2025 中取得金牌级成绩。V3.2 是 DeepSeek 首个将思考直接融入工具调用的模型,支持思考与非思考两种模式下的工具调用,训练数据合成覆盖 1800+ 环境和 85k+ 复杂指令;Speciale 通过临时端点提供,价格与 V3.2 相同,不支持工具调用,可用至 2025 年 12 月 15 日 15:59(UTC)。
匹配字段标题
Amazon Bedrock AgentCore payments 正式可用,为 AI 智能体提供按需付费的托管能力,支持 x402 协议端点,包括 Amazon Bedrock 推理端点。Incarna 借助该服务让智能体逐次向 BlockRun 支付模型推理费用,集成工作从原计划的 2 至 3 个月缩短到 3 天,约 200 行应用代码。测试期间智能体已处理超过 1000 笔支付,单次金额在 0.001 至 0.05 美元之间,每笔在链上独立结算,花费上限由基础设施层强制执行。
匹配字段标题
NVIDIA Dynamo 通过统一的会话级标识符 session_id 与 parent_session_id,把请求级推理服务改造成程序感知系统,实现会话感知路由、共享 KV cache 索引和跨 vLLM、SGLang 的缓存调度。Dynamo 可直接识别 Claude Code、Codex、OpenCode 等编码智能体发出的身份头,无需配置;其他 harness 可通过 X-Dynamo-Session-ID 头或 agent-plugins 仓库中的插件接入。

匹配字段标题
我也同意这一点——如果你在提供大量推理服务,就应该做监控。https://t.co/XYkNIZObwY
匹配字段标题
百度智能云主任架构师黎世勇透露,百度内部智能体平均上下文已达60k左右,并可能继续涨至100k、500k。百度百舸通过权重零冗余分布式部署、显存优化和MoE专家压缩支撑长上下文,测试中MoE专家压缩50%后长输出与高并发场景输出吞吐峰值达原来的2.23倍;sglang-kunlun插件打通SGLang与昆仑芯,国产卡开发可复用70%至80%的CUDA生态经验。
匹配字段标题
Architect Financial Technologies 推出 Liquid Inference,这是一个对每次 LLM 推理请求进行实时拍卖的路由器,提供方为指定模型报价,买方按最低且符合自身规则的报价成交。买方可在生成前锁定最高价格,并设置单任务成本上限、首 token 时延、最低吞吐、区域、零数据保留和提供方或模型白名单等规则,计费仅按实际用量。该服务兼容 OpenAI 与 Anthropic 客户端,官方称支持 Claude Code、Codex、OpenCode、Cursor、Pi 和 Cline,前 500 名用户可获 20 美元免费推理额度,推荐可获被推荐方费用的 20%。
匹配字段标题
@Tebbers343 @paulg 他们会通过为这些机器人提供推理服务来弥补。
匹配字段标题
Google AI Edge 团队以 Apache 2.0 协议开源端侧 GPU 计算引擎 ML Drift,它抽象 OpenGL ES、OpenCL、Metal 和 WebGPU,是 LiteRT 的核心 GPU 加速引擎,也可作为独立库使用。相比旧版 TFLite GPU delegate,它引入张量虚拟化统一 shader、可扩展自定义算子框架、5D 张量支持和针对 LLM 的阶段性优化,并新增 Windows 和 Linux 桌面预览。官方称 Gemma 基准中内存开销最多降低 12%,YouTube Shorts 平均帧延迟最多降低 40%,Google Photos 提速最多 2 秒,Adobe Lightroom 与 Photoshop 端侧性能最多提升 30%,Snapchat 镜头模型延迟改善 30%。旧版 TFLite GPU delegate 将不再获得新功能更新。
匹配字段标题
llama.cpp 作者 Georgi Gerganov 表示,llama.cpp 可以通过 ggml RPC 后端在异构设备上分发推理,目前属于高级设置,他预计未来会降低普通用户的使用门槛。被引用的演示显示,MiMo 2.6 Flash 的原生 mxfp4 权重可跨 RTX 6000 GPU 与 M5 笔记本运行,在 10 GbE 下达到 40 tokens/sec,llama.cpp 开箱支持。
匹配字段标题
Simon Willison 发布 llm-mistral 0.16,新增对推理模型的支持,包括新近发布的 Mistral Large 4。
匹配字段标题
@SpaceXAI Grok 4.7 的推理 token 用量与其 ARC-AGI-2 公开得分相关:low 档平均每次测试对尝试用 10k tokens,得分 25%;而 medium 到 xhigh 档为 86k 至 120k tokens,得分 57.5% 至 60%。low 档更低的 token 用量可能有助于解释其更低的得分。https://t.co/uRWS99ddwk
匹配字段标题
Together AI 宣布与 IBM、NVIDIA 合作扩展企业级 AI 推理能力,首批在 IBM Cloud 上部署大规模 NVIDIA B300 GPU 集群,并采用 NVIDIA Spectrum-X 以太网网络,这是 IBM Cloud 上首个此类专用大规模推理集群,Together AI 也是首个客户。Together AI 负责推理层,IBM 提供云,NVIDIA 提供芯片与网络。其平台每月服务超百万开发者、处理数百万亿 token。
匹配字段标题