端到端测试、属性测试和差分测试如何让编码智能体用证据验证自己的工作,以及 Claude Code 团队如何确保其验证器保持诚实。
作者 Addy Osmani 分类 工程实践 发布于 2026年11月16日 阅读时间 10 分钟在 Claude Code 团队,我们绝大多数的代码(约 90%)都是由 Claude 编写并 审查的. 在这种规模下,我们如何让智能体用证据验证自己的工作就变得极其重要。
验证循环是让你能把更多工作委托给 Claude 的基石。没有它们,你实际上一次只能运行一两个 Claude,因为你必须自己检查所有内容。有了它们,你可以并行运行几十甚至几百个。
这是因为给智能体提供一种 验证其输出的方式 是提高质量的有效方法。在围绕结构化文件生成的内部测试中,让一个独立的评分器按照评分标准检查 Claude 的工作,相比标准的提示循环 将任务成功率最多提升了 10 个百分点 ,在最难的问题上收益最大。
曾经验证成本高昂的东西(测试、基准、规格说明、真实的端到端运行)现在向智能体请求的成本很低。就像代码一样,智能体可以快速生成测试、基准和规格说明。而且一旦生成,这些测试和基准就作为软件运行,因此可以频繁运行,而无需消耗大量额外的 token。
你还可以利用结果来提升智能体在该任务上的表现,从而闭合验证循环。例如,如果某个智能体反复无法通过一项检查日志中用户数据的测试,你可以在 CLAUDE.md 中创建一个钩子或一条更明确的规则,以避免未来出现问题。这(基本上)能阻止问题再次发生。
那么,如果验证对于以高速度产出高质量代码至关重要,你应该使用哪些类型的测试,又该如何在整个流水线中应用它们?本文回答了这些问题,并分享了 Claude Code 团队使用的流程。
并非所有测试生而平等:值得投入的 3 种测试
无论你选择哪种测试类型,都有一些失败模式需要避免。
如果你的测试不稳定,你就会训练智能体重新运行它们,而不是修复失败的代码。如果你的测试很慢,智能体在批次中做的测试就会更少,这会让定位问题变得困难。较重的测试最好在你提交更改之前部署。
现在,以下是我认为最值得投入的三种测试类型。
端到端测试
如果你只能专注于一种测试类型,那就选端到端。这些测试描述真实的用户流程,比如将商品加入购物车、结账,然后进入确认页面。
端到端测试之所以如此有效,是因为它们很难被蒙混过关——要么整个功能正常工作,要么就不行。它们还有明确的完成标准,并能具体地告诉你哪里坏了。
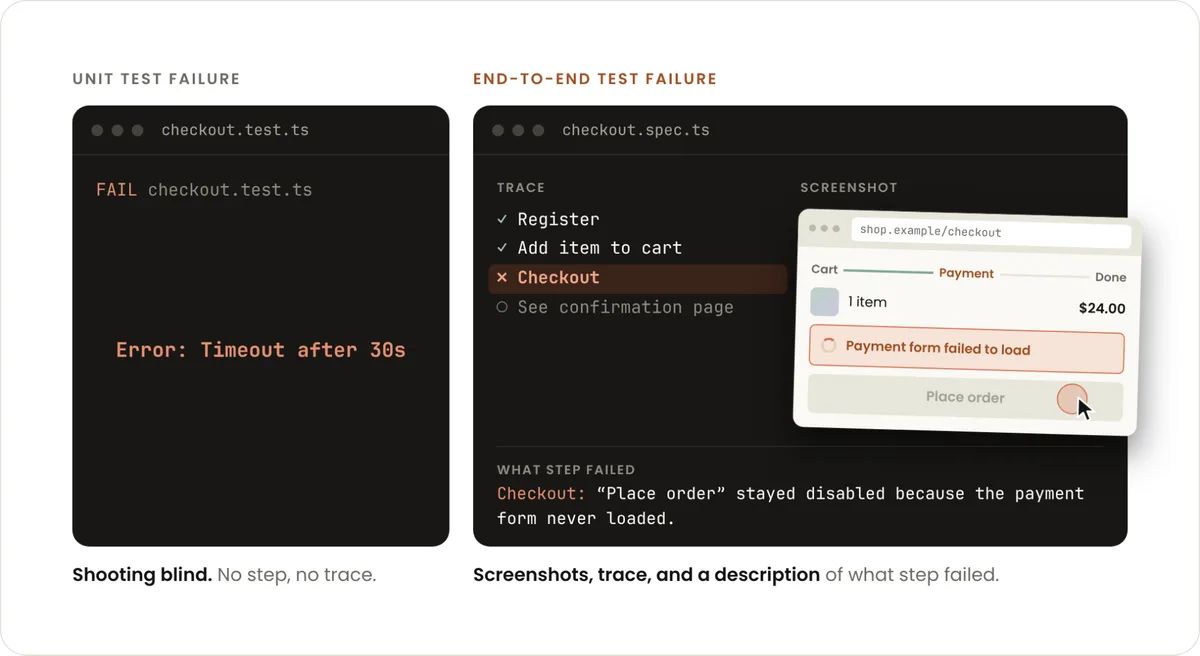
虽然单元测试更快、更稳定,但有可能通过它们却仍然破坏了功能。这是因为智能体和测试都没有理解完整任务。
对于端到端测试,让智能体在真实运行的系统上拥有手和眼睛是有效的。你可以使用一项技能,借助 CDP, 模拟器或 API 测试框架等工具来启动、驱动和检查应用。
功能地图可以作为智能体的指南和评分标准,因为它们通常从用户的角度列出功能,并描述路径、键盘快捷键、选择器和预期结果。
属性测试:不会破坏的约束
很多测试基于你认为可能出错的地方。属性测试关注人们容易遗漏的边界情况,而这正是智能体经常失败的地方。
你首先写下一个你认为不可能失败的陈述,然后使用测试库(JS/TS 用fast-check ,Python 用 Hypothesis ,Rust 用 proptest 等)生成数千个输入,试图证明它不成立。
几乎每个软件项目中都有许多属性,例如:
- 往返编码: “如果你编码 X 再解码回来,你会得到 X。”这也适用于解析和序列化。
- 不变量: 必须始终为真的事情,比如“账户余额永远不会变成负数”。
- 幂等性: 执行一个操作(迁移、规范化、重试)两次与执行一次的效果相同。
- 等价性: 优化后的代码产生与朴素但正确的代码相同的结果。
属性库是让智能体保持诚实的好方法,因为它使用的边界情况并非由创建原始代码的同一个智能体带着同样的偏见生成。它们对于重写尤其有帮助,因为此时规格说明已经偏离生产行为,不再是可靠的验证来源。
差分测试:旧系统就是标准答案
差分测试对于 大规模迁移 用例尤其有效,因为在这些用例中功能预期保持不变。对于这些测试,你用相同的输入同时运行旧系统和新系统,看看是否会得到不同的结果。如果不同,就存在需要修复的 bug 或破坏性变更。
差分测试的关键是使用随机生成的输入或生产流量样本。你还需要规范化无关因素,比如空白字符,并保留一份已批准变更的列表,用于新环境应当与旧环境不同的情况。
Claude Code 团队如何看待验证
我们之前写过 Anthropic 的代码审查如何运作,但本文旨在更深入地探讨我们如何验证自己的工作。
验证意味着运行更改
端到端运行应用比测试更重要。你不会在没在模拟器中试过的情况下就发布 iOS 更改,Claude 也是如此。
Claude 可以像人类或 QA 工程师那样测试整个应用。让它使用 Claude Chrome 扩展来验证 Web 改动,使用 iOS 或 Android MCP 来验证移动端,使用 computer use 来验证桌面端,或者在本地运行服务来验证后端工作。
为了把如何启动模拟器或运行应用固化下来,创建一个名为 verify 的技能。把它放在仓库中的 .claude/skills/ 文件夹里,尽可能靠近相关代码,并按需添加多个技能。Claude 知道在提交更改前使用 verify 技能。
然后投入精力让 verify 技能既快又可靠。让 Claude 反复迭代并对其进行压力测试。这是你的冒烟测试框架,所以你要让它坚如磐石。
当你给 Claude 一种端到端冒烟测试其改动的方法时,你会得到好得多的结果。你会看到它像人类一样迭代并更快地发现真正的错误。我们在 Anthropic 几乎所有的改动都是这样测试的。
失败的测试需要人工关注
没有人能阅读每一处改动,所以我们把失败作为一种判断哪些需要人工介入的方式。Claude 运行检查并尝试修复任何失败项。如果某项检查在三轮之后仍然失败,Claude 会停下来并引入人工。
代码所有者编写自己的检查
拥有代码的人为其编写检查,并不断改进,直到它们能标记出所有者会标记的问题。当某项检查引入审查者时,它应当说明原因,这样审查者就不必从 diff 中自行推断。
可靠性检查由 diff 触发
我们维护一份包含 39 个条目的可靠性清单,每个条目都有一个可从 diff 中读取的触发条件、一项检查,以及其背后的事故或 PR。其中一条是“--resume 加载旧转录记录”。当会话存储或消息类型发生变化时,我们会询问新字段是否能安全加载,因为旧转录记录不会有这个字段。
Claude 读取 diff,只检查触发条件匹配的条目——通常是 3 到 10 条——这样就没有人需要记住过去的故障。
一名审查者,多轮审查
我们不试图通过堆叠更多审查者来改进审查。在主审查者之上再加一名更昂贵的第二审查者,往往比调优主审查者更糟糕。相反,我们有一个 REVIEW.md ,说明审查者针对这段代码应当关注什么。
我们还认为审查和验证轮次应当相互累积。我们让每一轮都参考前几轮的上下文和过去的失败,而不是从头重新检查所有内容。这样成本更低,也能发现更多问题。
改动不能修改自己的检查
如果一项改动能够修改评判它的检查,那么这项检查就是失效的。Code Review 从基线或默认分支读取 REVIEW.md 文件, 绝不从拉取请求的改动中读取. Claude Code 团队确保用于把关改动的规则位于改动无法修改的分支上。
Claude Code 团队还只为提交保留审查。如果有人在审查进行时推送,那么审查结果就不再有用。对过期提交的通过审查毫无意义。
团队还先运行成本低的检查。如果智能体在本地测试之前就推送,它就浪费了共享的审查和 CI 时间,而它本可以自己发现这个 bug。在我们团队,Claude 在打开拉取请求之前会运行测试、构建和 linter。你可以用一个 hook 来强制执行这一点,在 Claude 完成时运行测试,或者用一个 /goal 来要求测试套件通过。
以观察模式启动新的门禁
在我们自己的仓库中,我们为每个提交打上它是如何被验证的标记。这个标记甚至包括“none”,这样我们就可以查询未经验证的提交。
我们还创建了一个提交门禁,如果会话中没有包含 /code-review 或 /verify,就可以阻止提交。我们为它设置了 off、observe 和 enforce 三种模式。
观察模式会记录本应被阻止的内容,这样我们可以审查任何误报并确保没有人受到影响。
强制模式会阻止提交。任何提交都可以在其消息中附带说明,解释为什么它没有经过验证。如果会话中提交已被阻止两次,下一次将被允许通过,这样 Claude 就不会卡住——Claude Code 并不完美。
用真正重要的东西测试你的检查
Claude Code 团队还定期审查审查者。我们跟踪有多少已合并的改动被回滚、有多少改动在合并前被维护者拒绝,以及一个规模匹配的、保持干净的改动子集。
这也可以通过正式评估来完成。在我们的 代码审查文章, 中,我们描述了 Code Review 团队如何基于过去的事故和回滚建立评估。他们为每个示例将仓库重建到审查时的状态,并提供一句话的答案要点说明 bug 是什么。只有正确描述相关 bug 的发现才能得分。他们使用已合并且稳定的改动作为对照,以防止过度标记。他们的调优集与他们用于评估系统的固定测试集是分开的。
他们还分别评估了原始发现、验证后和最终审查的召回率。这让他们能看到系统是否丢失了它已经发现的 bug。任何将所有这些视为一个端到端分数的评估都无法捕捉这种细微差别。
除了有效性之外,我们关心的另一个维度是进行这项改动有多重要。一个好的审查者会抓住大多数技术上正确的问题,但人们关心的是某个 bug 是必须修复、应该修复还是小问题。
Code Review 正是有这个概念,它会将问题标记为 重要、小问题或既有问题. “既有问题”标签意味着审查者不应让作者为已经是 bug 的问题负责。
最后,Claude Code 团队会将召回率调高到这样一个点:再进一步的改进将是对评估的过拟合,而不是真正发现 bug。
把遗漏转化为规则
在 Claude Code 仓库中,我们有两种方法将遗漏的案例转化为规则。第一种是提取人工代码审查评论和 PR 回滚中的模式,以识别常见问题。这些问题必须至少出现在两个 PR 中,并且能够从 diff 中识别出来,才能被视为潜在规则。三个智能体会尝试反驳它们,然后由人工在 PR 中审查并批准。
第二种方法是用三个 bug 查找器重放一个与已知事故相关联的 PR。如果至少有两个查找器发现了该 bug,那么它就是一个可检测的 bug。如果在一个小的 diff 上遗漏了该 bug,这就是一个值得转化为 REVIEW.md 中规则的缺口。
不稳定的测试也得到同样的处理。Claude 不能跳过它们、添加 sleep 或重试直到它们通过。如果它找不到根本原因,就删除该测试并写下原因。
规则也需要清理。测试套件、验证步骤和 .md 文件如果放任不管就只会不断增长,所以我们定期整理它们。
好的测试,好的结果
我们发现,为你的智能体提供一种通过强反馈循环来验证其工作的方法,会带来天壤之别。像对待任何其他系统一样对待你的验证层。让它远离它所评判的变更,根据对你真正重要的 bug 来给它们评分,并在它们遗漏某些东西时写下教训,以免同样的事情发生不止一次,同时修剪这些教训,使它们始终值得运行。
这样做之后,你的工作就从阅读每一个 diff 转变为定义“完成”是什么样子并审查证据,这正是让你能够同时运行许多 Claude 的原因。
相关文章2026年11月9日 使用 Claude Fable 5 安全扩展多智能体团队 12 分钟2026年11月9日 你应该用哪个 Claude 模型来构建?Fable、Opus、Sonnet 还是 Haiku 15 分钟2026年10月15日 Claude Code 团队如何进行代码审查 14 分钟2026年10月8日 构建有效的智能体自动化 9 分钟2026年10月6日 云端的 Claude Code:云会话实战指南 18 分钟加载更多