人工智能
端到端管理 Amazon Bedrock 成本:面向 FinOps 与平台团队的实操手册生成式 AI 的成本管理,是构建应用的团队与对云支出负责的团队共同承担的责任。许多团队一开始会比较各模型的 token 单价,并要求应用团队缩短提示词。这些做法有帮助,但无法回答财务和工程负责人在使用规模扩大后提出的问题:这笔钱是哪个团队花的、花在哪个工作负载上、这笔支出是否在已批准的预算之内?
智能体工作负载让这些问题更加紧迫。对话式助手通常每轮用户交互只发起一次模型调用。而智能体工作流(例如一个会规划变更、读取文件、调用工具并反复迭代的 AI 编程助手)每个任务会发起多次调用,且每次调用都携带更大的上下文。因此,token 消耗随你授予工作流的自主程度及其携带的上下文规模而增长,而不是随用户交互次数增长。由于消耗取决于工作负载的设计与运行方式,生成式 AI 的成本管理是一项架构与运营层面的纪律。公开的平均值无法替代你自己的数据:请使用 AWS Pricing Calculator 和 Amazon Bedrock 定价页面 来测算费率,并使用本文第 2 步来测量你的工作负载实际消耗了多少。
解决办法不是换更便宜的模型或缩短提示词,而是一套运营模式:一个可重复的闭环,把每一美元归因到负责人,让每个请求都可观测,在超支累积之前通过告警和强制手段控制预算,优化那些造成大部分浪费的平台默认值,并按固定节奏复盘整个系统。
在本文中,你将学习如何分五步管理 Amazon Bedrock 成本。你将把每一美元归因到负责人,让每个请求都可观测,通过预算和强制手段控制支出,优化那些造成大部分可避免支出的平台默认值,并运行一套把数据转化为决策的复盘节奏。该方法由 AWS 构建模块组成,你可以对其进行定制并应用到自己的环境中。本文面向两类读者:负责归因、分摊计费、预算和异常审查的 FinOps 从业者,以及负责日志记录、请求元数据、强制控制和路由默认值的平台工程团队。
运营模式一览
五个阶段,以闭环方式运行。归因:在计费管道中,每一美元 Amazon Bedrock 支出都落到某个身份、团队和应用上。观测:每个请求都被记录,并带有足够的元数据来解释支出由何产生。强制:预算要有约束力,至少要有告警,在风险要求时要有硬性拦截。优化:平台默认值(模型路由、缓存、token 上限)在中心层面消除浪费,而不是要求每个团队都小心谨慎。运营:一个小型记分卡和一套复盘节奏把数据转化为决策。FinOps 主导第一和第五阶段。平台工程主导第二至第四阶段。复盘由双方共同进行。各阶段的排序是刻意设计的。每个阶段都依赖前面的阶段,而那些跳过归因和可观测性直接进入优化的团队,只能靠猜。
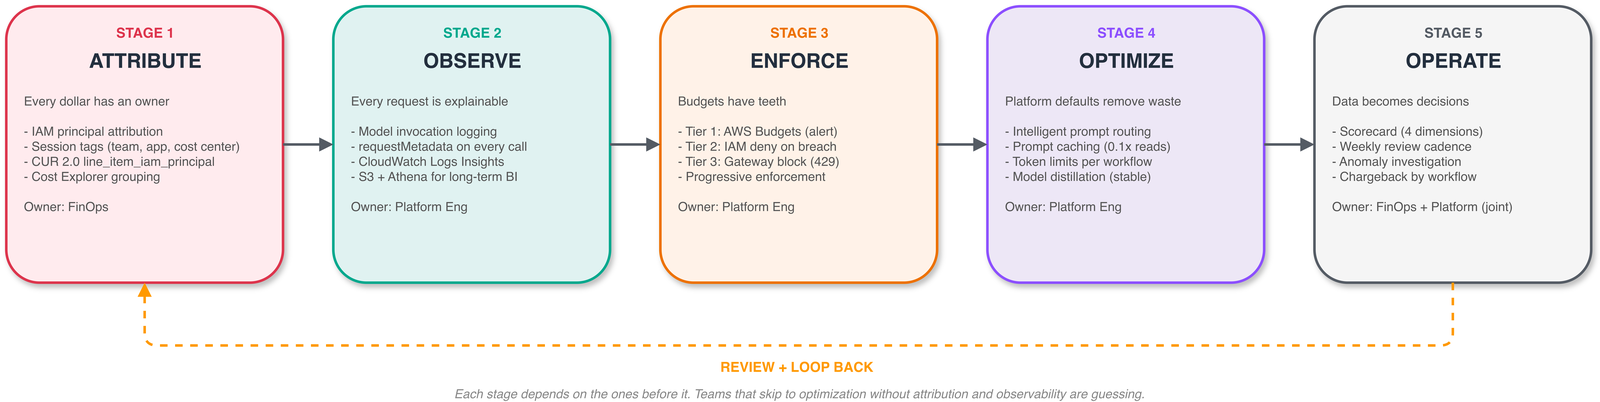
图 1:五阶段运营模式,以持续闭环方式运行
阶段 1:归因每一美元
你无法管理你无法归因的东西,而下游的一切(分摊计费、预算、强制控制、异常检测)都依赖这一阶段。基础是 Amazon Bedrock 的细粒度成本归因(参见 Introducing granular cost attribution for Amazon Bedrock):Amazon Bedrock 会自动将推理成本归因到发起调用的 AWS Identity and Access Management (IAM) 主体,覆盖所有模型,且无需管理任何资源。调用方的 ARN 会写入 line_item_iam_principal AWS Cost and Usage Report (CUR) 2.0 , 的列,覆盖范围包括 IAM 用户、角色、联合身份和 API 密钥。
设置分四步:
- 在你的 CUR 2.0 数据导出中开启 IAM 主体数据。
- 为你的 IAM 主体打上业务维度标签,例如团队、应用和成本中心。对于联合访问,配置你的身份提供商,通过 OIDC 或 SAML 声明传递会话名称和标签。
- 在 AWS Billing 中将那些标签激活为成本分配标签(控制台或
UpdateCostAllocationTagsStatusAPI)。 - 分析这些标签:它们会以
iamPrincipal/前缀出现在 CUR 2.0 中(例如iamPrincipal/team),并在激活后 24–48 小时内出现在 AWS Cost Explorer 的 IAM 类别下,可按团队、应用或成本中心进行筛选和分组。
这是达到发票级别的、按身份归因,且无需自定义基础设施。
共享角色问题
最值得关注的模式是共享角色问题,因为大多数平台正是在这里悄然失去归因能力。一个通过单一 IAM 角色调用 Amazon Bedrock 的大语言模型 (LLM) 网关,会把每一美元都归因到那一个角色上,从而完全丧失按用户的可视性。解决办法是按用户进行会话管理。网关为每个用户假定一次 Amazon Bedrock 调用角色,将用户身份作为角色会话名称、将其属性作为会话标签传入,然后缓存这些凭证最长一小时(每个用户每小时一次 AWS Security Token Service (AWS STS) 调用,而不是每个请求一次)。
这需要两个角色:一个持有 sts:AssumeRole 和 sts:TagSession 权限的网关执行角色,以及它所假定的 Amazon Bedrock 调用角色。结果是 line_item_iam_principal 条目,例如 assumed-role/BedrockRuntimeRole/gw-alex, 每个都携带其用户的标签:在共享网关背后恢复了按用户和按租户的归因。
import boto3

sts = boto3.client("sts")

# One call per user; cache the returned credentials up to 1 hour
response = sts.assume_role(
    RoleArn="arn:aws:iam::123456789012:role/BedrockRuntimeRole",
    RoleSessionName="gw-alex", # the user, not the gateway
    Tags=[
        {"Key": "team", "Value": "sales-ai"},
        {"Key": "application", "Value": "renewal-agent"},
        {"Key": "costCenter", "Value": "CC-2041"}
    ]
)
关于应用推理配置文件和 Projects 的说明
Amazon Bedrock 还提供另外两种归因机制,各自适用于不同的模式。 应用推理配置文件 是预先创建的、按应用划分的资源,位于 bedrock-runtime 端点,携带成本分配标签。你为每个应用、每个模型、每个 AWS 区域创建一个配置文件,调用方引用该配置文件的 ARN,这适合应用和模型集合小而稳定的团队。 Projects 和 workspaces 服务于 bedrock-mantle 端点(Responses API、Chat Completions API)。项目不绑定到特定模型,因此单个项目 ID 可跨越多个模型,这适合模型使用频繁变化的团队。你在客户端初始化时传入项目 ID,其标签会流入 CUR 2.0 和 Cost Explorer(参见 《使用 Amazon Bedrock Projects 管理 AI 成本》)。对于 Amazon Bedrock 上兼容 OpenAI 的工作负载,Projects 是归因路径。
对于 bedrock-runtime 工作负载,我们建议以通过会话标签进行 IAM 主体归因为主要机制。它随你的身份系统扩展,无需预先创建资源,并覆盖每个模型和 API 操作。当一小批稳定的业务部门需要在不变更身份设计的情况下实现发票级计费分离时,应用推理配置文件效果良好。对于使用 Responses API 或 Chat Completions API 的 bedrock-mantle 工作负载,请使用 Projects。
第 2 阶段:让每个请求都可观测
CUR 告诉你谁花了钱。调用日志告诉你发生了什么。Amazon Bedrock 支持将请求数据、响应数据和元数据的 模型调用日志 发送到 Amazon CloudWatch Logs、Amazon Simple Storage Service(Amazon S3)或两者。使用 Amazon CloudWatch 进行快速运营查询,使用 S3 加 Amazon Athena 进行长期商业智能(BI)访问。将日志记录视为基础设施,而非手动开关:通过代码预置日志组或存储桶,定义保留和加密策略,并在环境设置期间验证交付。如果日志记录仅存在于开发环境或仅存在于一个区域,那么一旦使用量增长,你的成本计划就会变得支离破碎。
日志记录还弥合了延迟差距:CUR 归因大约滞后 24 小时,但 CloudWatch 加 OpenTelemetry 可以支撑近实时仪表板,在几分钟内显示每位开发者的支出(使用 CloudWatch 和 OpenTelemetry 分析 Claude Code 使用情况 端到端地演示了这一点)。
用于工作负载级归因的请求元数据
原始日志回答的是身份层面的问题。要回答工作负载层面的问题(哪个功能、工作流或租户生成了这些 token),请在每次调用时打上 请求元数据 的标记。Amazon Bedrock 会在调用日志中捕获这些元数据,供后续分析使用:
以下示例通过美国跨区域推理配置文件,在 Amazon Bedrock 上使用 Anthropic Claude Sonnet 5.5。完整模型列表请参阅 Amazon Bedrock 中支持的基础模型。各区域的可用性请参阅 Amazon Bedrock 中各 AWS 区域支持的模型.
response = client.converse(
    modelId="us.anthropic.claude-sonnet-5-5",
    messages=[...],
    requestMetadata={
        "application": "renewal-copilot",
        "workflow": "renewal-risk-summary",
        "tenant": "enterprise-sales",
        "agent": "renewal-agent"
    }
)
Amazon Bedrock 不会强制实施请求元数据,而当每个应用都各自为政时,团队很快就会陷入不一致的 schema。平台团队应在共享的 SDK 封装或网关中集中注入强制元数据,统一键集合,并将元数据覆盖率视为一项平台健康指标。
诊断查询
在日志和元数据就位后,CloudWatch Logs Insights 可以回答这些长期存在的问题。 谁消耗的 token 最多:
fields @timestamp, identity.arn as caller, modelId,
input.inputTokenCount as inTokens,
output.outputTokenCount as outTokens
| stats sum(inTokens + outTokens) as totalTokens,
count(*) as calls
by caller, modelId
| sort totalTokens desc
| limit 25
将同一查询按 requestMetadata.application 和 requestMetadata.workflow 分组,而不是按 caller 分组,即可生成工作负载层面的排行榜:一旦开始讨论费用分摊,视图产品团队和工程团队就会向 FinOps 索要这份榜单。
注意: 前文查询中展示的字段路径仅为示例。请根据你的调用日志 schema 进行核实,该 schema 可能因模型、API 操作和日志配置而异。
第 3 阶段:执行预算限制
在归因和可观测性就位后,执行限制就变成了一项架构选择,而不再是一厢情愿。有三种可行的层级。选择哪一种取决于你的支出速度、你对超支的风险容忍度,以及你的工具如何连接 Amazon Bedrock。
层级 1:监控与告警(不阻断)
Amazon Bedrock 会自动将主体身份写入计费管道。你在其上设置 AWS Budgets 以实现阈值告警,并用第 2 阶段的 OpenTelemetry 仪表板弥合 24 小时的 CUR 延迟,以获得日常可见性。无需部署任何东西,使用原生 AWS 计费,且不会给推理调用增加延迟。它适用于直接调用 Amazon Bedrock 的工具。没有任何机制能硬性阻止支出,因此你只能在问题发生后才发现它。适合早期采用阶段,此时告警加人工干预已经足够。有两篇构建者指南介绍了这一做法: 限制 Bedrock 使用量并控制成本,以及 深入探讨如何在 Claude Code 中通过 AWS Budgets 和标签管理 Bedrock.
层级 2:IAM 标签强制执行(违规即拒绝)
一个聚合器 AWS Lambda 函数根据调用日志数据,在 Amazon DynamoDB 中统计每个用户的 token 和美元计数器。当用户超过其阈值时,该函数会将其身份添加到共享的 IAM 拒绝策略中(拒绝 bedrock:*),直到每月重置或管理员覆盖。此强制执行完全依赖 IAM 和 Amazon Bedrock 日志记录,推理路径中没有任何第三方组件,并且可与直接调用 Amazon Bedrock 的工具配合使用。AWS Solutions Library 中的 Claude Code 与 Amazon Bedrock 指南 提供了一个可部署的变体。它在颁发凭证时,会根据每用户和每团队的限制检查每个用户的使用情况,并在用户超过限制后扣留凭证。由于该检查使用客户端发出的使用遥测数据,其数字可能与 CUR 不同。无论采用哪种形式,强制执行都是异步的。对于 IAM 策略更新,封禁会在违规调用后数秒到数分钟内生效;对于凭证检查,则会在下次凭证刷新时生效。你的平台团队负责该管道。此层级适合需要真正强制执行、能够容忍该延迟,并希望将第三方软件排除在数据路径之外的团队。
层级 3:网关强制执行(同步阻断)
网关位于推理数据路径中,并同步执行预算限制,在用户或团队超过限制的那一刻返回 HTTP 429。你可以获得亚秒级阻断、每用户模型允许列表、token 速率限制以及集中强制执行的路由规则。代价是:数据路径中有一个必须部署、扩展并进行安全审查的组件。客户端必须配置为通过网关发送请求。
对于 Claude Code 和 Claude Desktop 集群, Claude 应用网关(适用于 AWS) 是官方推荐方案。它随 CLI 二进制文件一同发布,并作为由 PostgreSQL 支持的无状态单容器运行。它开箱即用地提供 OIDC 身份、集中管理的策略、OpenTelemetry 遥测、多区域 Amazon Bedrock 路由,以及按用户/组/组织的支出上限。对于跨多个提供商的混合模型工作负载,通用网关仍是正确选择:LiteLLM 通过 AWS Fargate 上的 Amazon Elastic Container Service(Amazon ECS)参考架构,或 为 Amazon Bedrock 构建主动式 AI 成本管理系统,第 2 部分.
选择层级
有两个因素起主导作用。
连接性: 如果开发者不经过代理直接调用 Amazon Bedrock,则只有层级 1 和层级 2 可行。
支出速度: 如果每月支出已经达到数百万美元,现在就建立强制执行。如果告警还能再撑一个季度,就先投资阶段 1 和阶段 2,等数据表明需要时再加入强制执行。
大多数组织应分阶段实施:先在层级 1 观察,再逐步升级。将这三个层级都视为过渡桥梁,而非最终目标: Well-Architected Agentic AI Lens 已将代理成本治理作为一等架构关注点纳入规范,而阶段 1 建立的归因基础正是任何托管式强制执行所依托的根基。
阶段 4:优化默认值
大多数 Amazon Bedrock 的浪费并非源于个人疏忽,而是源于无人设定的平台默认值。两个影响最大的杠杆都由平台控制。
模型路由
并非每项任务都需要前沿模型。常规补全(样板代码、lint 建议、小型重构)可以运行在更小、更便宜的模型上,而将质量保留给复杂推理,通过 智能提示词路由 在模型家族内,或在网关处配置路由规则(参见 通过 Amazon Bedrock 智能提示词路由和提示词缓存降低成本与延迟 (完整演练见上文)。哪些工作流可以降级是一个实证问题:从阶段 2 拉取工作负载排行榜,对排名靠前的条目在更便宜的模型上运行质量评估,并将通过评估的流量路由过去。对于智能体编码集群这类样板代码主导调用量的场景,将超过一半的调用落到更便宜的模型上是一个可实现的目标。
提示词缓存
提示词缓存奖励稳定重复的前缀。截至 2026 年 10 月,已发布的 Amazon Bedrock 定价 截至2026年10月,已发布的Amazon Bedrock定价中,美国东部(弗吉尼亚北部)区域的Anthropic Claude模型对缓存写入按基础输入费率的1.25倍计费(5分钟生存时间,即TTL),若采用1小时TTL则按2倍计费。在Claude Sonnet 4.6和Claude Haiku 4.5上,缓存读取按基础输入费率的0.1倍计费;在Claude Sonnet 5.5和Claude Opus 5.5上则按0.05倍计费。请查阅你所使用模型和区域对应的定价页面,因为这些倍率因模型而异,并且可能发生变化。盈亏平衡的算法比团队预想的更友好。在5分钟TTL下,单次复用就已能抵消写入成本,而对稳定前缀发起十次调用,其成本约为未缓存价格的五分之一(在0.1倍读取费率下约为22%,在0.05倍下为17%)。唯一亏本的情况是写入后从未被再次读取,在5分钟TTL下会多花25%的成本,在1小时TTL下则翻倍。因此,平台仪表盘应按工作流跟踪缓存读取量与缓存写入量的对比。读取比例偏低意味着前缀实际上并不稳定(通常是因为在缓存点之前嵌入了时间戳或会话ID)。
候选对象直接从调用日志中浮现:
fields requestMetadata.workflow as workflow, modelId,
input.inputTokenCount as inTokens
| stats count(*) as calls,
avg(inTokens) as avgInputTokens,
sum(inTokens) as totalInputTokens
by workflow, modelId
| filter calls > 50 and avgInputTokens > 2000
| sort totalInputTokens desc
| limit 25
注意: 前文查询中显示的字段路径仅为示例。请根据你的调用日志架构进行核实,该架构可能因模型、API 操作和日志配置而异。
应用层优化
第三类节省属于应用团队而非平台:即时检索而非塞满上下文、长对话压缩、将稳定的高频工作流蒸馏到更小的模型上。平台的工作是让这些节省可见:发布按工作流的 token 排行榜,为每个模型和工作流设置 token 限额,并让拥有高成本工作流的团队清楚看到自己所处的位置。
第 5 阶段:运行闭环
前四个阶段产生数据。这一阶段将数据转化为决策。平台团队运行一个常设的健康仪表盘,包含四项信号:
- 模型组合: 调用了哪些模型以及调用频率如何,这是对路由纪律的直接衡量。
- 失败请求率: 错误、限流和超时。每次重试都会增加延迟,而一个在服务端仍会完成的请求若在客户端超时,可能会被计费两次:一次为被放弃的调用,一次为重试。
- 缓存有效性: 第 4 阶段的读取量与写入量之比。
- 元数据覆盖率: 带有完整元数据的生产调用的百分比。每一个未被覆盖的调用都是一个归因盲点,会悄然拉低其他所有数字的准确性。
当信号出现漂移时,补救措施是变更策略(路由规则、token 限额、元数据强制校验),而不是发一封邮件提醒团队多加小心。
资金闭环
FinOps 在同一份数据上运行资金闭环。当归因清晰时,异常检测就变成一条调查流,而不是一场惊慌失措的全员会议:某个已打标签的团队或应用出现支出激增时,只需在 Stage 2 排行榜中查询,而无需召开战情室会议。分摊计费则依据 CUR 中按团队和应用的分组来运行。
评分卡
以下阈值只是起点,并非规定。在将其采纳为策略之前,请根据你自己的车队数据和定价层级进行校准。
| 维度 | 指标 | 绿色 | 黄色 | 红色 |
| 单位经济性 | 每次成功结果的成本 | ≤ 预算 | 1–1.5 倍预算 | 1–1.5 倍预算 |
| 每位开发者成本 | 每位开发者每日支出 | <$100 | $100–$300 | >$300 |
| 模型路由 | 调用高性价比模型的占比 | >50% | 30–50% | <30% |
| 缓存效率 | 缓存读取命中率 | >60% | 30–60% | <30% |
绿色表示工作负载在其经济承受范围内运行。黄色表示路由或缓存纪律正在松动。红色表示支出正集中在高价模型或未缓存的上下文上,而第 3 阶段和第 4 阶段的控制措施就是补救路径。请按固定节奏审查这份评分卡(高频车队每周一次,其他情况每两周一次),并将其视为 FinOps 与平台团队共同的决策界面。
结论
在本文中,你学习了如何构建一个五阶段运营模型,使 Amazon Bedrock 支出从失控走向全面治理:
- 将每一美元通过 IAM 主体标签、会话标签和 CUR 2.0 归因到负责人。通过模型调用日志和带标记的请求元数据观测每一个请求。在与你风险相匹配的层级执行预算控制:仅监控、违规时 IAM 拒绝,或同步网关阻断。利用智能提示路由和提示缓存优化平台默认值,从中心化层面消除浪费。运行评分卡和审查节奏,将遥测数据转化为策略决策。注意该评分卡的第一行 通过 IAM 主体标签、会话标签和 CUR 2.0 将每一美元归因到负责人。
- 观察 通过模型调用日志观测每一个请求,并为其打上请求元数据标记。
- 执行 在与你风险相匹配的层级执行预算控制:仅监控、违规时 IAM 拒绝,或同步网关阻断。
- 优化 利用智能提示路由和提示缓存优化平台默认值,从中心化层面消除浪费。
- 运营 运行评分卡和审查节奏,将遥测数据转化为策略决策。
注意该评分卡的第一行:每次成功结果的成本,而不是每次调用的成本。这一区别正是本手册的交接点。这里的一切都让 Amazon Bedrock 支出可见、可归因、有上限且高效,但一个工作流可以完全高效,却仍然不值得运行。要做出这一判断,需要将智能体与其所取代的人工流程进行对比衡量,这属于产品和分析学科,而非 FinOps 学科。成本平台所贡献的是基础:干净的归因和按工作流的成本数据,正是结果衡量所要连接的确切输入。
构建这五个阶段,你就能端到端地回答:是谁花的、为什么花、以及是否受控。这就是管理 Amazon Bedrock 成本的含义,也是月度账单审查与运营模式之间的区别。
要开始使用,请部署 Amazon Bedrock 上 Claude Code 的指导 第 1–3 阶段的参考架构,然后使用 成本归因最佳实践 文档来配置你的标签策略。