状态是 AI 智能体跨任务携带的信息,涵盖从对话历史到长期记忆和用户画像。在有状态与无状态架构之间做选择,会影响智能体工作流如何管理规模以及如何从故障中恢复。这是一项核心设计决策,会影响整个系统的可靠性和性能。
有状态与无状态:核心概念
有状态与无状态架构的区别,归根结底在于交互之间信息会发生什么。系统会保留先前交互中发生的事情,还是让每个请求都从空白状态开始?
在比较有状态与无状态应用之前,先定义三个相关术语会有所帮助:
- 状态: 在单次交互之后仍然保留的信息,例如购物车、认证状态或对话历史。
- 会话: 与同一用户或流程相关联的一系列相关交互。它为系统提供了一个边界,用来判断哪些交互属于同一组。
- 上下文: 由 LLM 驱动的系统用来理解并响应当前请求的信息。它可以来自当前输入、先前的交互或已存储的数据。
有状态应用
有状态应用会保留先前交互中的信息,并用它来处理后续交互。这些信息可能包括对话历史、认证详情、购物车内容,或多步骤流程的进度。
有状态的优势在于连续性。应用可以从先前交互中断的地方继续。代价是,你需要有地方存储和管理这些状态,并确保下一个请求到达时状态可用。
无状态应用
无状态应用将每个请求独立处理。这意味着处理请求所需的一切都必须随请求一同到达,或从另一个系统获取。它不会依赖从上一个请求中保留的信息。
在无状态应用中,将请求分布到多个实例上更容易。任何合适的实例都能处理该请求,因为它不需要从别处恢复状态。这可以让应用更具可扩展性和容错性。但当连续性很重要时,你需要在系统的某个地方引入状态。这就是为什么许多架构使用无状态的请求处理层,同时将持久数据存储在缓存或其他共享系统中。
💡现代 LLM 应用还有草稿本。这是一个临时存储,AI 智能体在响应用户之前会把中间结果保存在这里。草稿本不属于有状态系统,其主要作用是在智能体于单次用户请求期间向 LLM 发送多次查询时存储信息。有状态与无状态的关键区别
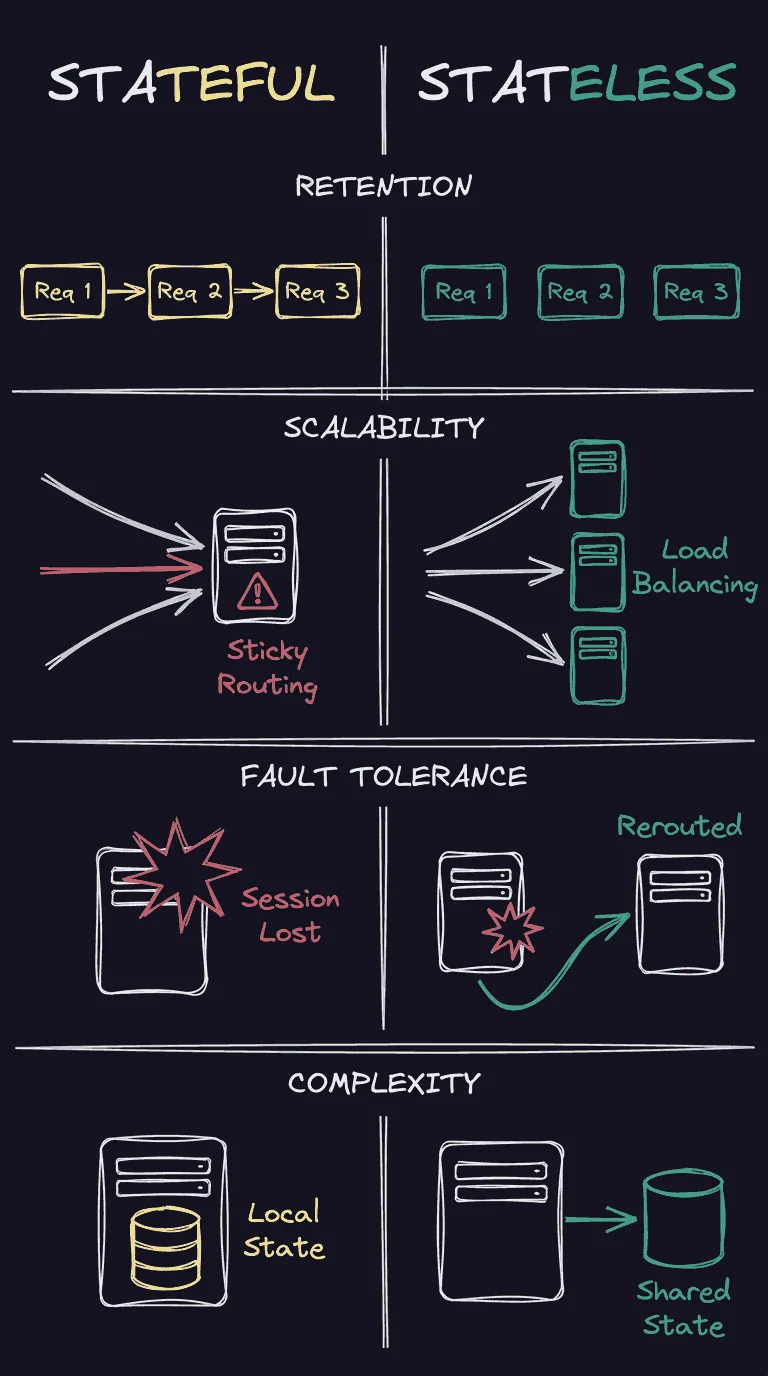
有状态与无状态架构的实际差异,首先体现在信息存放在哪里。在有状态系统中,应用会在请求之间保留信息。在无状态系统中,每个请求都独立包含或获取所需内容。这一决策会影响系统的扩展方式、故障恢复方式和资源使用方式。
| 有状态 | 无状态 | |
| 状态保留 | 跨请求或会话保留信息 | 独立处理每个请求 |
| 可扩展性 | 当流量在实例之间转移时,状态必须保持可访问 | 请求可以更自由地分布到可用实例上 |
| 容错性 | 除非状态在其他地方复制或持久化,否则服务器崩溃可能中断对状态的访问 | 另一台服务器通常可以处理下一个请求,而无需恢复本地会话状态 |
| 复杂性与资源 | 需要用于存储、同步和恢复状态的基础设施 | 应用实例更简单,但持久数据可能需要外部状态存储 |
你不需要让整个系统成为有状态或无状态。许多架构让计算层保持无状态以便于扩展,同时将需要持久化的状态移入数据库、缓存或其他共享存储。
AI 智能体和 LLM 是有状态还是无状态?
LLM 不会自动在两次推理请求之间保留对话。如果应用希望模型使用先前的消息,就必须在模型输入中提供这些消息,或从系统中的其他地方获取。
AI 智能体可以通过让模型访问先前交互中的信息来表现出有状态行为。这就是 记忆的工作方式 ——智能体在模型外部存储和检索状态,然后将相关上下文添加到后续请求中。
状态如何存储取决于它需要持续多久以及谁需要访问它。内存缓冲区可以在会话内保存最近的消息,而持久存储可以让消息在单个进程或重启之后仍然保留。在分布式系统中,共享存储可以让状态在多个节点上可用。
何时使用有状态与无状态 API
使用无状态 API 以实现扩展性和简单性。 REST API 就是一个很好的例子。每个请求都包含进行认证和处理所需的信息。请记住,无状态请求可以轻松分布到多个实例上。如果你需要 API 在不减慢或崩溃的情况下扩展容量,这一点尤其有用。
当上下文必须持久保留时,使用有状态 API。 有状态行为适用于对话、多步骤流程以及其他下一步取决于先前发生情况的交互。这种架构尤其适用于会话 Cookie 认证 API、FTP API,以及聊天或游戏等活动的实时 API。
n8n 中的智能体状态:Memory 节点与状态存储
n8n 是一个源码可用的 AI 原生自动化平台,工程团队可以在其中构建 AI 智能体和 智能体工作流在 n8n 中,你可以根据需要持久化的内容来选择状态的存放位置。 AI Agent 节点 可以使用 Memory 节点来保存对话上下文,而状态存储则保存需要在智能体会话结束后仍然存在的数据。这样,你就可以在有用的地方添加状态,而不必让整个工作流都变成有状态的。
默认无状态
n8n 工作流执行 彼此独立。一次执行不会自动记住上一次执行的数据,这让执行层更易于扩展和恢复。当工作流需要连续性时,你可以显式添加相应形式的状态。
执行历史还能让你查看每次运行中流转的数据,使有状态行为更易于检查和调试。
使用 Memory 节点实现短期/会话状态
Memory 节点让 AI 智能体能够访问会话中的先前消息。 Simple Memory 节点 为最近的对话历史提供内存缓冲区,但它与 队列模式.
不兼容。当记忆需要超出运行进程而持久保留时, Postgres Chat Memory 节点 使用持久化存储,并按会话 ID 区分对话。 Redis Chat Memory 是另一种选择,适用于需要快速分布式缓存、能在多个工作进程之间共享会话状态的场景。对于队列模式下的分布式执行,请使用持久化记忆选项,以便会话状态在各工作进程之间保持可用。当你需要对对话历史进行更多控制时, Chat Memory Manager 可以让工作流显式加载、插入和清除消息。
这些 AI Agent Memory 方法让你可以根据对话的生命周期和规模来匹配存储方式。例如, AI 智能体聊天 可以使用会话记忆,在对话持续进行时保留先前的消息。
💡大多数现代 LLM 都有缓存机制,可以显著降低成本。如果你使用带滑动窗口的记忆节点(即最近 20 条消息),在长对话中会使缓存失效。我们建议要么增大滑动窗口的尺寸,要么采用更先进的技术(即对最近 X 条消息进行摘要,而不是使用简单的滑动窗口)。使用状态存储实现持久、共享的状态
有些状态需要比对话存续更久,或需要在多次工作流执行之间保持可用。n8n 数据表 提供持久化的结构化存储,工作流可以在多次执行之间从中读取和写入。根据用例,你还可以使用工作流静态数据,或外部的 Postgres 或 Redis 存储。
将 Memory 节点与状态存储结合使用,可以为你提供两个不同的状态层。聊天记忆节点为智能体保留对话上下文,而状态存储则在数据表或 SQL 数据库中跨执行持久化工作流和应用数据。
先构建无状态,再在需要的地方添加状态
有状态与无状态不必是系统级的选择。尽可能从独立的无状态执行开始,然后在工作流需要连续性的地方引入状态。
对于 n8n 中的 AI 智能体,这可能意味着为持续进行的对话添加会话记忆,在上下文需要经受重启时添加持久化记忆,或在数据需要跨工作流和执行传递时使用共享状态存储。选择正确的层,可以让状态成为有意的设计,而不是让它变成架构上的约束。
在你掌控的无状态基础上构建有状态行为。 免费开始 或探索 n8n 的模板。
与我们分享
n8n 用户来自各种不同的背景、经验水平和兴趣领域。我们一直希望在博客文章中介绍不同的用户及其项目。如果你正在使用 n8n 并希望激励社区, 请联系我们 💌
分享