人工智能
在 Amazon Bedrock 上对开放权重模型使用提示词缓存许多生成式 AI 应用会在每次请求中发送相同的长上下文,而提示词缓存可以避免每次都重新处理这些内容。该上下文可以是系统提示词、参考文档、工具定义,或到目前为止的对话内容。Amazon Bedrock 上的开放权重模型可以跨请求复用这些内容,从而有助于降低输入成本和响应延迟。
提示词缓存 会复用匹配的提示词前缀已计算的状态,因此重复的上下文会从缓存中读取,而不是被重新处理。Amazon Bedrock 会为你管理缓存。根据模型的不同,你可以使用自动生效的隐式缓存、需要标记可复用前缀的显式缓存,或两者兼用。你复用的上下文越多、复用越频繁,节省就越多。
与 Amazon Bedrock 上的其他模型一样,你的提示词和输出不会与模型提供商共享,也不会用于训练模型。有关更多信息,请参阅 Amazon Bedrock 用户指南中的 数据保护 。
Amazon Bedrock 上的开放权重模型现已支持显式提示词缓存。在本文中,我们通过 Chat Completions API 在开放权重模型上使用这两种模式,并展示如何从每个响应中读取缓存使用情况。然后,我们在同一 API 上对 OpenCode 编码代理会话应用隐式缓存,最后介绍最佳实践。
Amazon Bedrock 上开放权重模型的提示词缓存
当请求的开头内容与先前的请求相同时,Amazon Bedrock 会从缓存中读取该前缀,只处理其余部分。缓存读取的计费费率低于标准输入,因此每次复用前缀时节省都会增加。根据模型的不同,缓存写入的计费费率可能高于标准输入。各模型的费率请参阅 Amazon Bedrock 定价 。
支持的缓存模式取决于模型和 API。各模型的缓存模式、最小前缀长度以及缓存条目的保留时长,请参阅 模型一览。两种模式的比较如下:
| 功能 | 隐式缓存 | 显式缓存 |
| 请求变更 | 无 | 在 Chat Completions API 上,将 prompt_cache_options 的 mode 设为 explicit,并添加一个或多个 prompt_cache_breakpoint 标记 |
| 缓存内容 | 符合条件的缓存前缀,由系统以尽力而为的方式自动选择 | 截至并包括每个断点的内容 |
| 适用场景 | 已经以稳定前缀开头的提示词,例如对话和代理循环 | 固定共享前缀加变化的问题,或你希望控制的分层前缀 |
隐式缓存: Amazon Bedrock 会以尽力而为的方式自动复用符合条件的前缀。在对话中,每个请求都会重新发送完整上下文,因此上一个请求会成为下一个请求的缓存前缀(图 1)。按照 提示词缓存指南 的建议,将静态内容放在前面,动态内容放在后面。保持提示词开头稳定,可以让后续每个请求都复用它。如果靠前的部分发生变化,如图 1 的第 4 轮,缓存会从该点开始重建。
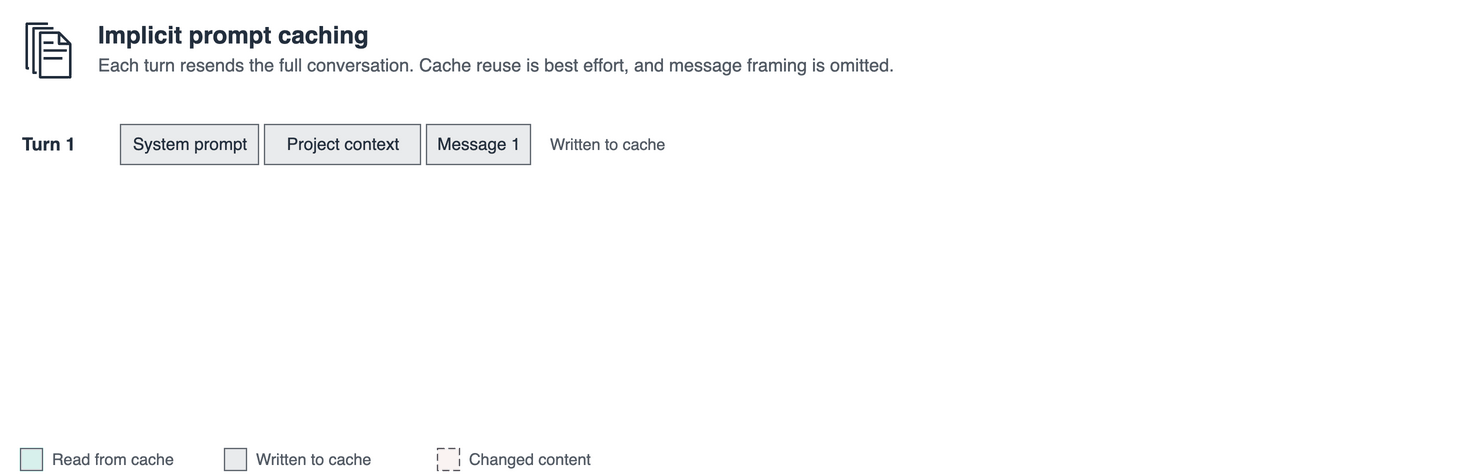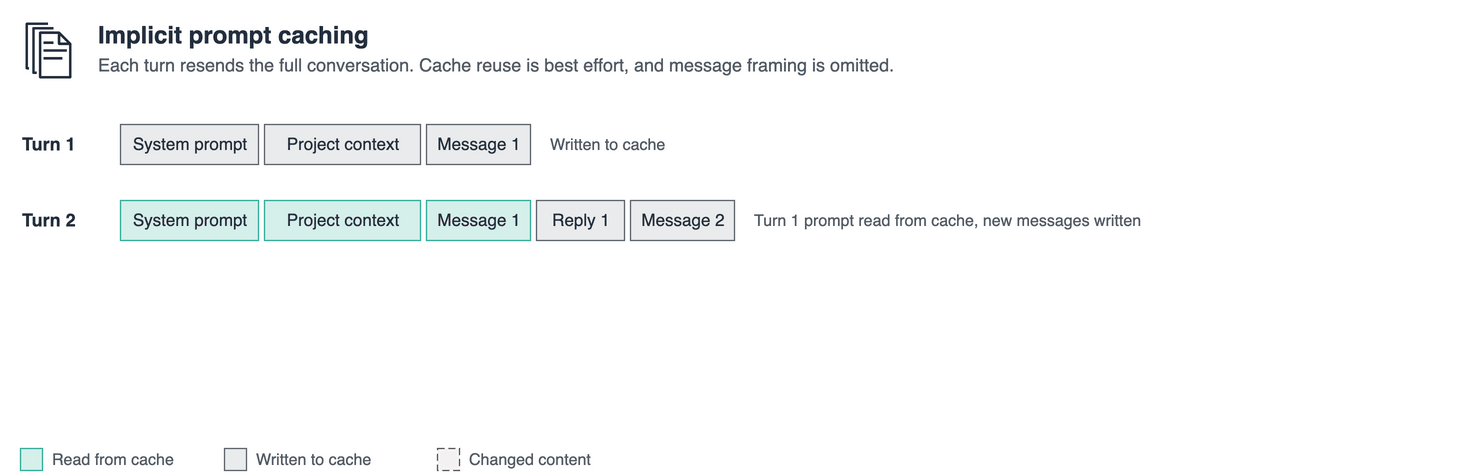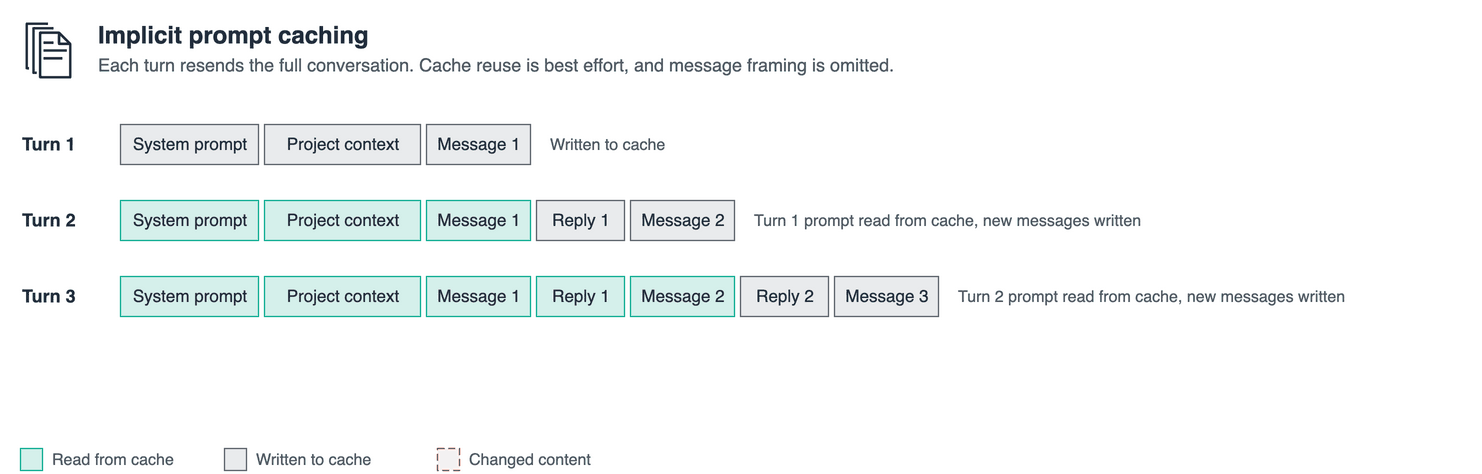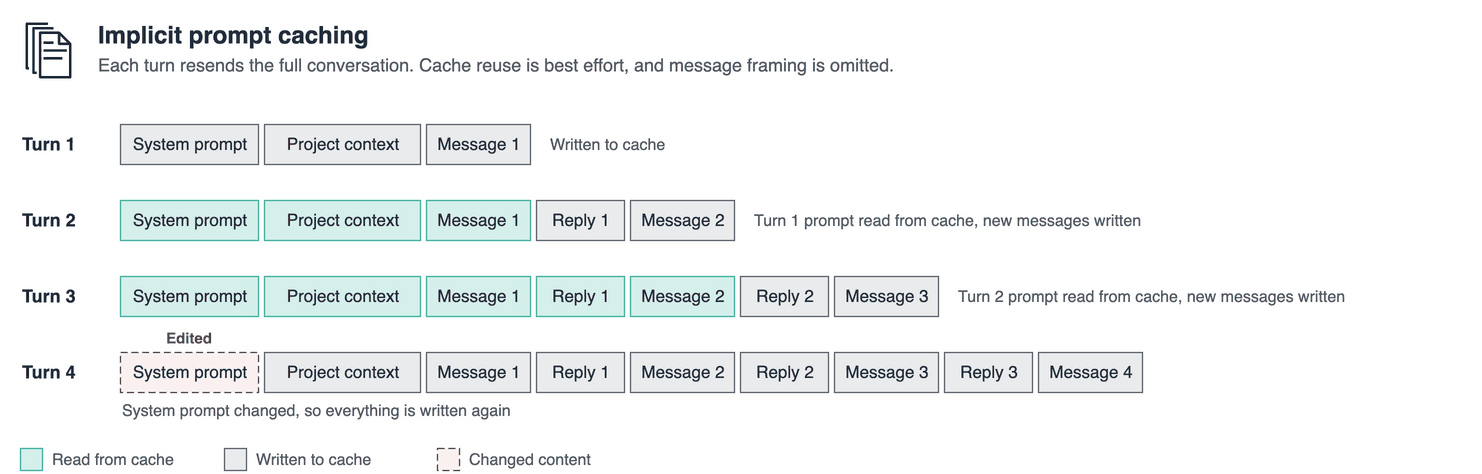
图 1:对话各轮次中的隐式提示词缓存
显式缓存: 你用缓存断点标记每个可复用前缀的结尾。你可以添加多个断点,最多不超过模型支持的上限,以缓存以不同频率变化的层,如图 2 所示。截至每个断点的内容会写入缓存一次,然后在后续请求中读取,而最后一个断点之后的内容会在每次请求时处理。请查看模型卡,了解断点前的最小 token 数、最大断点数以及生存时间(TTL),TTL 会在每次缓存命中时重置。
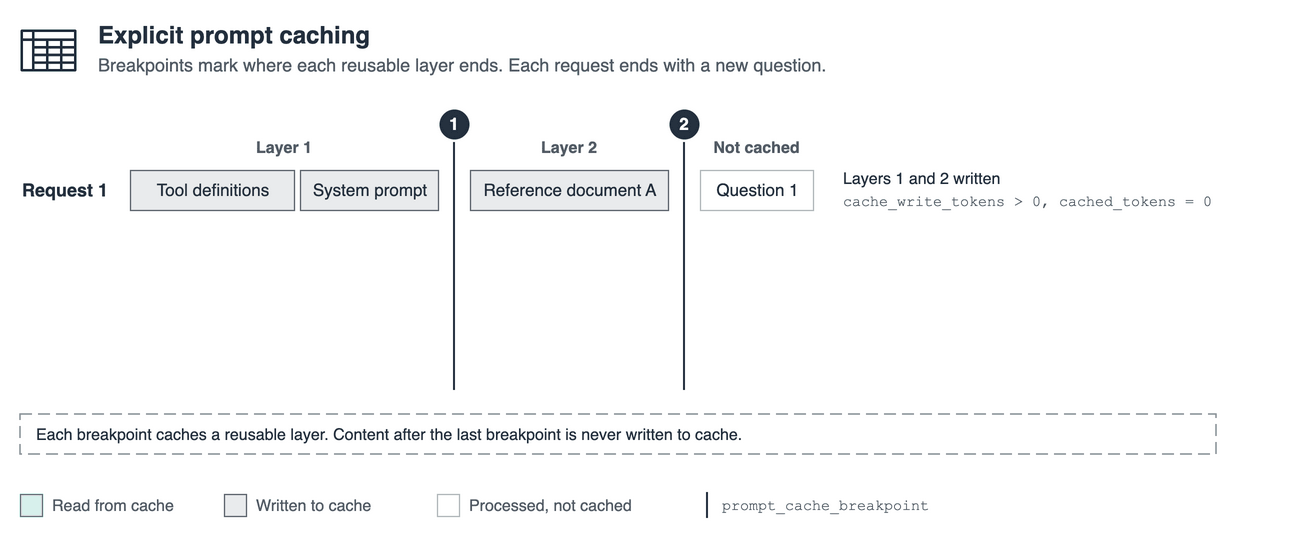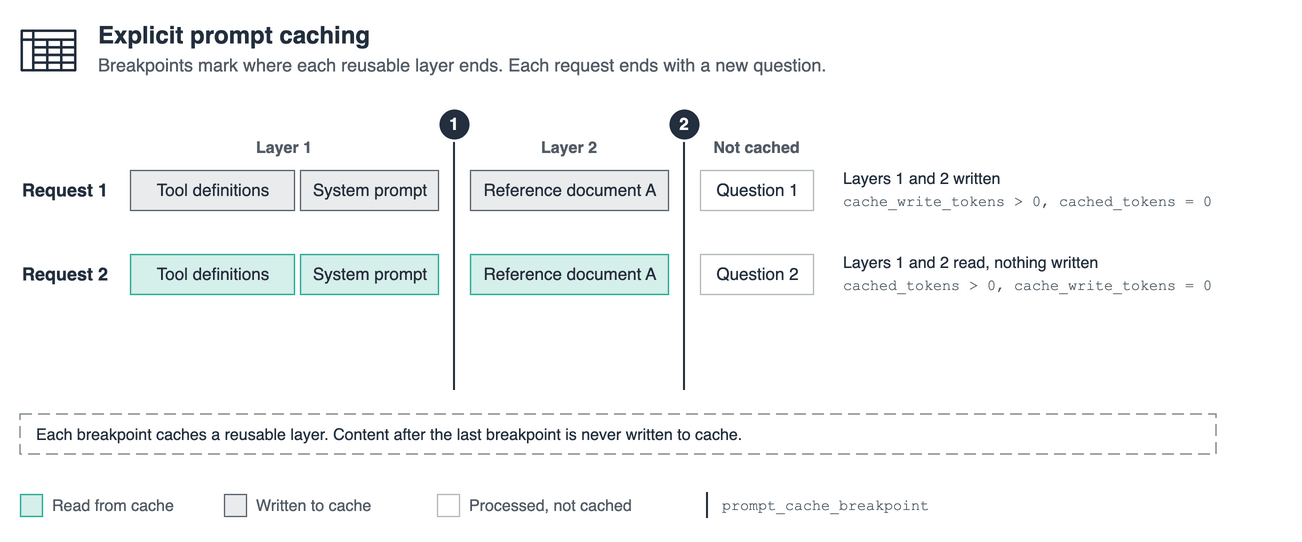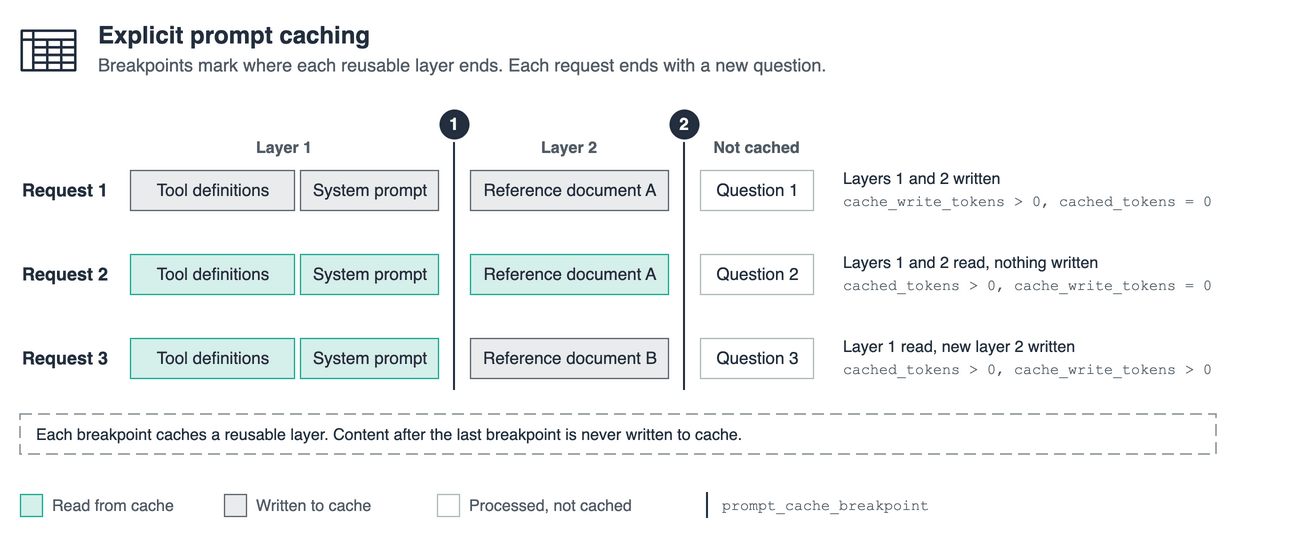
图 2:在共享前缀之后设置断点的显式提示词缓存
使用隐式缓存时,Amazon Bedrock 还可能将后续请求永远不会复用的内容写入缓存,例如每次都不同的问题。当共享前缀之后的内容在每次请求中都会变化时,请使用显式缓存,将缓存写入限制在共享前缀。最后一个断点之后的内容按标准输入费率计费。在缓存写入收费更高的模型上,你无需为永远不会被读回的内容支付更高的写入费率。
解决方案概述
下图展示了本文中的两个示例如何通过同一个 Chat Completions API 端点访问 Amazon Bedrock。
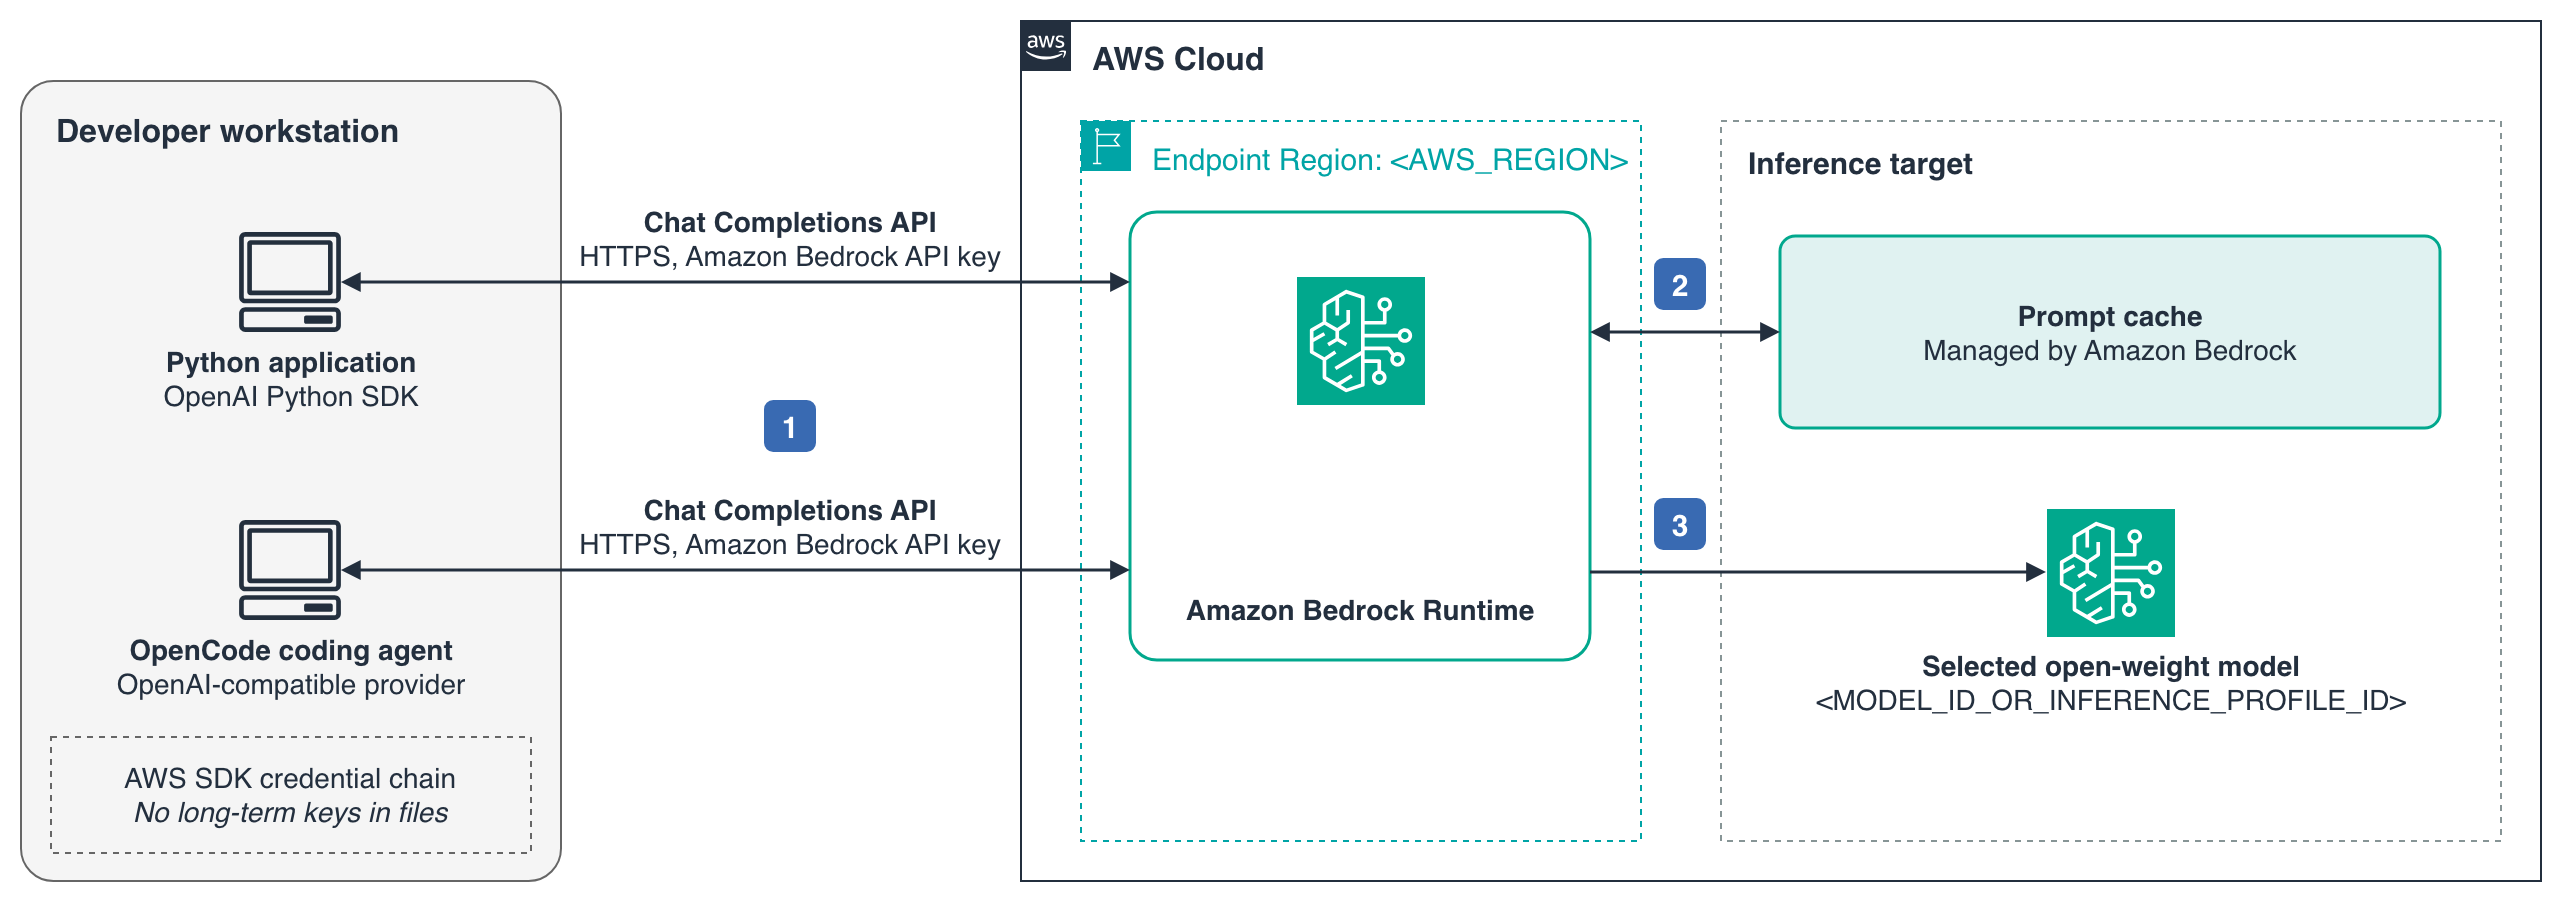
图 3:本文中的两个示例如何访问 Amazon Bedrock
- Python 应用程序和 OpenCode 编码代理会向你所处区域的 Amazon Bedrock Runtime 端点发送请求,并使用短期 Amazon Bedrock API 密钥进行身份验证。
- Amazon Bedrock 会在提示词缓存中检查匹配的前缀。它会从缓存中读取匹配的前缀,并将新的可缓存内容写入缓存。
- Amazon Bedrock 会将请求发送给所选的开放权重模型并返回响应,其中包括以下各节将展示如何读取的缓存使用情况字段。
先决条件
要运行这些示例,你需要以下内容:
- 一个 AWS 账户,并有权访问你在 Amazon Bedrock 上选择的模型。模型可用性和提示词缓存支持因 AWS 区域而异,因此请查看 模型卡 ,了解你的模型支持的区域。
- 具有调用你在 Amazon Bedrock 上所选模型权限的 AWS Identity and Access Management(IAM)身份的 AWS 凭证。
- Python 3.12,以及
openai(3.26.0 或更高版本)和aws-bedrock-token-generator(1.1.0 或更高版本)包。 - 对于编码代理示例,需要 npm 来安装 OpenCode 1.18.35。
在使用模型之前,请查看其 模型卡中链接的许可证和服务条款。你对模型的使用还须遵守 AWS 负责任 AI 政策.
。
通过 Chat Completions API 缓存产品手册
该示例是一个虚构净水器 AnyCompany AquaPure 500 的支持助手。系统提示词包含一行指令和用户手册,后者是可复用的前缀。每个请求都会询问不同的客户问题。
设置客户端 provide_token() 这些示例使用 OpenAI Python SDK 和 Amazon Bedrock Chat Completions 端点。对于身份验证,来自 aws-bedrock-token-generator 包可将您的 AWS 凭证转换为一个 短期 Amazon Bedrock API 密钥,有效期最长 12 小时。你无需创建或存储长期密钥。
1. 创建虚拟环境并安装这些包:
python3.12 -m venv .venv
source .venv/bin/activate
pip install "openai>=3.26.0" "aws-bedrock-token-generator>=1.1.0"
2. 创建手册。我们的手册大约有 4,000 个 token 的 Markdown 内容。以下摘录展示了它的格式:
# AnyCompany AquaPure 500 Owner's Manual

### 7.1 Replacement schedule
| Stage | Cartridge | Part number | Replace every |
| ----- | ------------------- | ----------- | ------------- |
| 1 | Sediment pre-filter | AP-F1 | 6 months |
| 4 | Carbon post-filter | AP-F4 | 12 months |

### 9. Error codes
| Code | Description | What to do |
| ---- | ----------------------- | -------------------------------------------- |
| E01 | Low feed water pressure | Check that the feed water valve is open. |
| E07 | Drain line restriction | Check the black concentrate tube for kinks. |

### 11. Warranty
- Faucet: 3 years from the date of purchase. The 3 V cell is not covered.
将其保存为 manual.md 并不断添加章节,直到其长度超过你模型卡上的最小前缀长度。占位文本即可,因为缓存只需要相同的前缀。保留所示的三节内容,它们回答了示例问题。
3. 将以下设置代码保存为 common.py 在同一目录中。你接下来创建的示例会从它导入。
from pathlib import Path

from aws_bedrock_token_generator import provide_token
from openai import OpenAI

REGION = "<AWS_REGION>"
MODEL_ID = "<MODEL_ID_OR_INFERENCE_PROFILE_ID>"

MANUAL = Path(__file__).with_name("manual.md").read_text()

SYSTEM_PROMPT = (
    "You are the AnyCompany AquaPure support assistant. Answer the customer's question in at "
    "most three sentences, using only the owner's manual below.\n\n" + MANUAL
)

QUESTIONS = [
    "My filter shows error code E07. What does it mean and how do I fix it?",
    "How often do I need to replace the AP-F4 post-filter?",
    "Is the 3 V battery in the smart faucet covered by the warranty?",
]

# Chat Completions API client: the OpenAI SDK pointed at the Amazon Bedrock OpenAI-compatible endpoint
client = OpenAI(
    api_key=provide_token(region=REGION),
    base_url=f"https://bedrock-runtime.{REGION}.amazonaws.com/openai/v1",
)


def report(call_number, response):
    """Print the cache fields from the response usage."""
    usage = response.usage
    read = usage.prompt_tokens_details.cached_tokens or 0
    written = usage.prompt_tokens_details.cache_write_tokens or 0
    print(
        f"Call {call_number}: prompt_tokens={usage.prompt_tokens} cached_tokens={read} "
        f"cache_write_tokens={written} uncached={usage.prompt_tokens - read - written}"
    )
如果你的模型返回推理 token,这些 token 会计入 max_tokens。示例集 max_tokens=1024 以便简短的回答有空间完成。
隐式缓存
隐式缓存不接受任何缓存控制。将手册放在系统消息中,将问题放在用户消息中。将两者作为同一条用户消息的组成部分发送,没有获得任何隐式缓存命中。将以下内容保存为 implicit.py 并在同一目录下运行它。 python implicit.py:
from common import MODEL_ID, QUESTIONS, SYSTEM_PROMPT, client, report

for i, question in enumerate(QUESTIONS, start=1):
    response = client.chat.completions.create(
        model=MODEL_ID,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT}, # static, same every call
            {"role": "user", "content": question}, # changes every call
        ],
        max_tokens=1024,
    )
    report(i, response)
验证隐式缓存
每次响应都会报告缓存活动, usage.prompt_tokens_details图 4 展示了如何读取这些字段,以及每个样本的三次调用中应预期的模式。
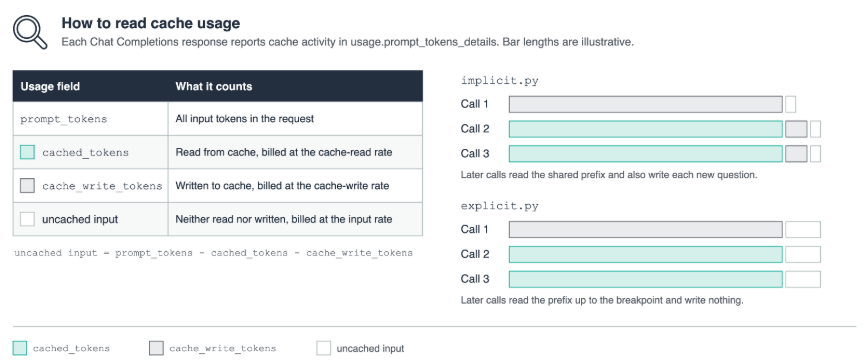
图 4:如何读取缓存使用字段(示例说明)
在隐式模式下,第 1 次调用会将提示词写入缓存。第 2 次和第 3 次调用会从缓存中读回系统消息,其中包含指令和手册。它们每次也会写入少量 token,因为隐式模式会扩展缓存前缀以覆盖每个新问题。每次调用中,最后一条消息之后的少量 token 都不会被缓存。这是首次运行的典型模式。如果你在 TTL 内再次运行该示例,每次调用都会从缓存读取,且不会写入任何内容。
显式缓存
选择显式缓存,以精确控制缓存的内容。如图 4 所示,隐式运行中的第 2 次和第 3 次调用各自向缓存写入少量 token,而使用显式缓存的相同调用则不会写入任何内容。借助多个断点,你可以缓存分层前缀,例如先缓存共享的指令和工具,再缓存每个客户各自的文档(图 2)。
对于显式缓存,请在请求中添加以下内容:
prompt_cache_options,并将模式设置为“explicit”以选择显式模式。 这是 Amazon Bedrock 的请求字段,OpenAI SDK 会通过 . 将其发送。在文本内容部分上标记可复用前缀的结束位置。截至并包括该部分的内容会被缓存,而其后的内容会在每次请求时重新处理。将同一循环的显式版本保存为 :同时设置这两部分。没有断点的显式模式不会缓存任何内容,而没有显式模式的断点则表现得像隐式缓存。对于 的可选 字段,请查看 mo 。这是 Amazon Bedrock 的请求字段,OpenAI SDK 会通过extra_body.prompt_cache_breakpoint在文本内容部分上标记可复用前缀的结束位置。截至并包括该部分的内容会被缓存,而其后的内容会在每次请求时重新处理。
将同一循环的显式版本保存为: explicit.py:
from common import MODEL_ID, QUESTIONS, SYSTEM_PROMPT, client, report

for i, question in enumerate(QUESTIONS, start=1):
    response = client.chat.completions.create(
        model=MODEL_ID,
        messages=[
            {
                "role": "system",
                "content": [
                    {
                        "type": "text",
                        "text": SYSTEM_PROMPT,
                        # Cache everything up to and including this content part.
                        "prompt_cache_breakpoint": {"mode": "explicit"},
                    }
                ],
            },
            {"role": "user", "content": question}, # after the breakpoint, not cached
        ],
        max_tokens=1024,
        extra_body={"prompt_cache_options": {"mode": "explicit"}},
    )
    report(i, response)
同时设置这两部分。没有断点的显式模式不会缓存任何内容,而没有显式模式的断点则表现得像隐式缓存。对于可选的 ttl 字段,请查看模型卡以了解支持的值。 prompt_cache_options,请查看模型卡以了解支持的值。
验证显式缓存
如果你运行 explicit.py ,其首次调用已经是缓存命中。对于冷启动的首次调用,请在系统提示词中添加一个唯一的第一行,例如 (将 放在 的顶部)。正如 Figure 4 中的显式条形所示,只有首次调用会写入。每次重复都会读取直到断点的整个前缀,且不写入任何内容,而断点之后的问题则构成未缓存的部分。将提示词缓存与 OpenCode 编码代理配合使用编码代理会在每一步重新发送一个庞大且稳定的前缀:系统提示词、工具定义 implicit.py,其首次调用已经是缓存命中。对于冷启动的首次调用,请在系统提示词中添加一个唯一的第一行,例如 SYSTEM_PROMPT = f"Run ID: {uuid.uuid4()}\n" + SYSTEM_PROMPT (使用 import uuid 顶部 explicit.py).
正如 Figure 4 中的显式条形所示,只有首次调用会写入。每次重复都会读取直到断点的整个前缀,且不写入任何内容,而断点之后的问题则构成未缓存的部分。
将提示词缓存与 OpenCode 编码代理配合使用
编码代理会在每一步重新发送一个庞大且稳定的前缀:系统提示词、工具定义以及到目前为止的对话。这使得它们天然适合隐式缓存。 OpenCode 是一个开源编码代理。它可以通过自定义的 OpenAI 兼容提供程序调用任何 Chat Completions 端点,因此可以使用与 Python 示例相同的 Amazon Bedrock 端点。图 5 展示了 OpenCode 在一轮对话中发送的请求,以及 Amazon Bedrock 从缓存中读取的部分。
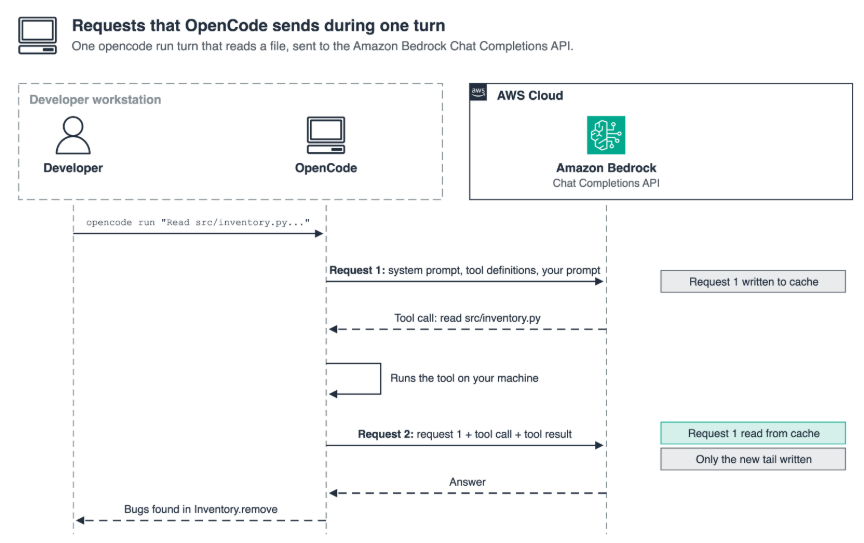
图 5:OpenCode 在一轮对话中向 Amazon Bedrock 发送的请求
在一轮对话中,OpenCode 会发送请求 1,其中包含其系统提示词、工具定义和你的提示词,Amazon Bedrock 会将其写入缓存。模型返回一个工具调用,OpenCode 会在你的机器上执行该调用。随后 OpenCode 发送请求 2,其中包含请求 1 以及该工具调用及其结果。Amazon Bedrock 从缓存中读取请求 1,仅写入新增的尾部内容,并返回响应。
配置 OpenCode
安装 OpenCode 并检查版本:
npm install --prefix ~/.local/opt/opencode opencode-ai@1.18.35
export PATH="$HOME/.local/opt/opencode/node_modules/.bin:$PATH"
opencode --version
以下内容添加到仓库根目录,或将其保存为 以应用到每个项目。它定义了一个名为 的提供程序,该提供程序使用 OpenAI 兼容包调用 Amazon Bedrock Chat Completions 端点:OpenCode 使用 生成会话标题,因此将其指向同一模型可确保每个请求都落在你已启用的模型上。该提供程序从 读取其密钥。将其设置为来自 的短期 Amazon Bedrock API 密钥,位于第一个示例中的虚拟环境中。如果密钥过期,请再次运行该命令 opencode.json 添加到你的仓库根目录,或将其保存为 ~/.config/opencode/opencode.json 以将其应用到每个项目。它定义了一个名为 bedrock 该提供程序使用 OpenAI 兼容包调用 Amazon Bedrock Chat Completions 端点:
{
  "$schema": "https://opencode.ai/config.json",
  "model": "bedrock/<MODEL_ID_OR_INFERENCE_PROFILE_ID>",
  "small_model": "bedrock/<MODEL_ID_OR_INFERENCE_PROFILE_ID>",
  "provider": {
    "bedrock": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Amazon Bedrock (Chat Completions)",
      "options": {
        "baseURL": "https://bedrock-runtime.<AWS_REGION>.amazonaws.com/openai/v1",
        "apiKey": "{env:BEDROCK_API_KEY}"
      },
      "models": {
        "<MODEL_ID_OR_INFERENCE_PROFILE_ID>": { "name": "Open-weight model on Amazon Bedrock" }
      }
    }
  }
}
OpenCode 使用 small_model 生成会话标题,因此将其指向同一模型可确保每个请求都落在你已启用的模型上。该提供程序从 BEDROCK_API_KEY将其设置为来自以下位置的短期 Amazon Bedrock API 密钥: provide_token(),位于第一个示例中的虚拟环境里。如果密钥过期,请再次运行该命令以获取新密钥:
export BEDROCK_API_KEY="$(python -c '
from aws_bedrock_token_generator import provide_token
print(provide_token(region="<AWS_REGION>"))')"
确认 OpenCode 列出了该模型:
opencode models bedrock在编码会话中验证隐式缓存
我们针对一个只包含一个简短 Python 文件的小型代码仓库运行了一个三轮会话。第 1 轮要求进行缺陷审查,第 2 轮要求修复,第 3 轮要求进行简短的后续跟进:
opencode run --format json --title "cache-demo" \
"Read src/inventory.py and list any bugs in Inventory.remove. Do not edit files."
opencode run --format json -s <sessionID> \
"Now propose a fixed version of Inventory.remove as a code block. Do not edit files."opencode run --format json -s <sessionID> \
"In one sentence, what does low_stock return?"将 <sessionID> ,并使用 sessionID 命令会列出每个请求的 token 用量: 保存来自 Amazon Bedrock 的 值,而 保存其余部分。OpenCode 1.18.35 不会为 OpenAI 兼容提供程序记录 ,因此 保持为 0。图 6 显示了会话中每个请求从缓存中读取的比例。图 6:OpenCode 会话中的缓存读取(示意)第一个请求处理整个提示词,其中大部分是 OpenCode 系统提示词和工具定义,Amazon Bedrock 将其写入缓存。之后的每个请求都会读取全部 opencode export <sessionID> 命令会列出每个请求的 token 用量: cache.read 保存 cached_tokens 来自 Amazon Bedrock 的值,而 input 保存其余部分。OpenCode 1.18.35 不会记录 cache_write_tokens 用于 OpenAI 兼容的提供程序,因此 cache.write 保持为 0。
图 6 显示了会话中每个请求从缓存中读取的比例。
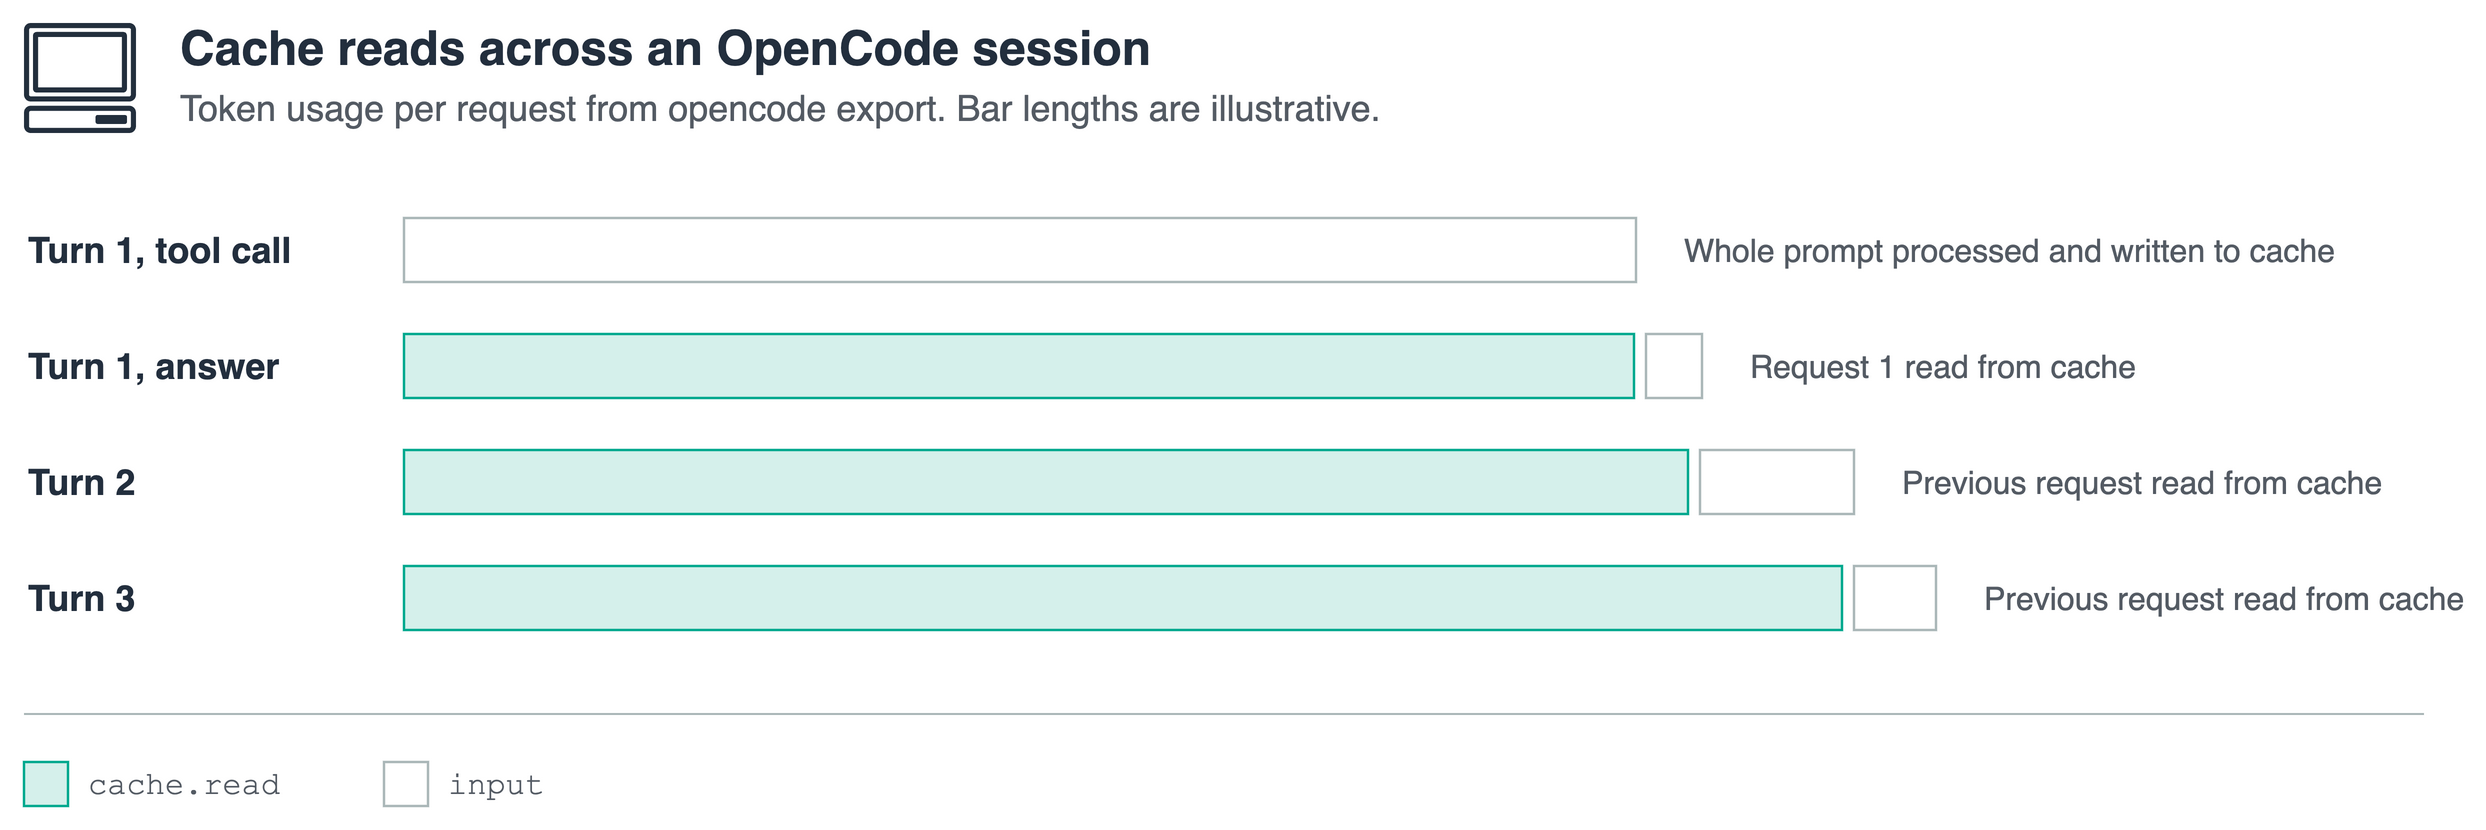
图 6:OpenCode 会话中的缓存读取(示意)
第一个请求会处理整个提示词,其中大部分是 OpenCode 系统提示词和工具定义,Amazon Bedrock 会将其写入缓存。之后的每个请求都会从缓存中读取截至上一个请求结束时的全部内容,因此只会处理对话中新增的尾部部分。这一机制无需任何缓存配置即可生效。
最佳实践
这些做法适用于任何支持提示词缓存的模型:
- 将静态内容放在最前面,两种模式均如此。 将系统提示词、工具定义和参考文档放在会变化的内容之前,并在各次请求之间保持它们完全一致。在显式模式下,将每个断点放在其所覆盖的静态内容之后。时间戳和请求 ID 应放在提示词末尾。
- 让前缀足够长。 符合模型卡上最低 token 数量的前缀才有资格被缓存。
- 使用用量字段确认命中情况。 在任一模式下,检查每次响应中的缓存读取和缓存写入。在整个工作负载中,跟踪
CacheReadInputTokenCount以及CacheWriteInputTokenCount运行时指标. - 保持缓存处于热状态。 稳定的流量会让前缀保持缓存状态,因为每次命中都会重置 TTL。在超过 TTL 的空闲间隔之后,下一次请求会再次写入该前缀。
- 缓存需要复用的内容。 节省来自缓存读取,因此应缓存后续请求会再次读取的内容,尤其是在缓存写入成本高于标准输入的情况下。使用跨区域推理时,在高需求时段预计会出现一些额外的缓存写入。
清理
这些示例仅进行推理调用,不会在您的 AWS 账户中创建任何资源。缓存条目在 TTL 内未被读取后即会过期。来自 provide_token() 也会自行过期,并且示例从不将其写入磁盘。要从 shell 中更快地清除它,请运行 unset BEDROCK_API_KEY.
要删除本地文件:
1. 删除示例目录及其 Python 虚拟环境。
2. 删除 opencode.json 从你的仓库中,或者 ~/.config/opencode/opencode.json 如果你将其全局保存。
3. 如果您不再需要 OpenCode,请删除 ~/.local/opt/opencode.
结论
提示词缓存让 Amazon Bedrock 上的开放权重模型能够复用重复的上下文,而几乎无需改动你的代码。在本文中,隐式缓存覆盖了支持助手和 OpenCode 会话,且完全无需任何缓存设置。显式缓存则通过一个请求选项和每个可复用层的断点提供了精确控制。在每种情况下,每次响应的用量字段都会显示哪些内容来自缓存,因此你可以根据自己的流量衡量收益。
要开始使用,请选择 Amazon Bedrock 上支持提示词缓存的开放权重模型使用你自己的参考内容运行本文中的示例,并将缓存读取与未缓存的输入进行比较。 提示词缓存指南 介绍了每种模型的限制和选项,以及 Amazon Bedrock 运行时指标 让你能够跟踪各应用中的缓存读取和写入。如有疑问,请通过 AWS Support 或 AWS re:Post 社区.