隆重推出 ZONOS3-Mini,这是一款紧凑的零样本语音克隆文本转语音(TTS)模型,具备最先进的性能以及领先的语音控制能力,可在设备端实时运行。
引言
我们很高兴地宣布推出 ZONOS3-Mini,这是我们新一代的实时文本转语音(TTS)模型,具备高保真语音克隆能力。ZONOS3-Mini 是一个稀疏混合专家(MoE)模型,拥有 1 亿激活参数和 8 亿总参数,采用 Apache 2.0 许可。我们在 112 块 Nvidia H100 上训练 ZONOS3-Mini 用时 2.5 天。你可以通过以下方式访问它: Zyphra Inference (在 Nvidia H200 上提供服务)、在你自己的 GPU 上,或在浏览器中于设备端运行。
借助 ZONOS2,我们确立了这样一个结论:质量与推理性能之间的权衡可以通过在 TTS 中使用 MoE 架构来缓解。然而,ZONOS2 为此付出的代价是在运行于 86 Hz 的编解码器上使用 8B 参数,这限制了该模型的部署。得益于技术栈多个层面的大幅效率提升,ZONOS3-Mini 规避了这些限制。
得益于其规模,ZONOS3-Mini 可以在众多设备上运行。我们发布了通过 WebGPU 在浏览器中运行的运行时、通过 SGLang 和 vLLM 在服务器上运行的运行时,以及通过 GGML 提供的许多其他运行时。ZONOS3-Mini 可实时运行,在 Pixel 9 的浏览器中首字音频延迟低于 570 ms,在 M3 MacBook Air 上低于 150 ms。
此外,推理服务器还提供对身份、口音、质量、情绪和表达方式的可控性。词级表达控制通过在流式生成期间监控对齐注意力头来实现,另外也可在生成后通过编辑模型实现。我们鼓励你收听相关章节中的以下示例。
ZONOS3-Mini 的模型权重已在 Hugging Face 上提供,我们的运行时已在我们的 GitHub 上提供。
模型对比
我们使用全新的 ZTTS2-Eval 基准(详见下文),对 ZONOS3-Mini 与多个最先进的专有及开源模型进行了定性对比。这些结果体现了模型生成内容的可懂度、质量、语音克隆性能和韵律变化。
我们认为,评估 TTS 模型的最佳方式是定性地聆听生成的样本。基于这一考虑,我们展示了一系列 ZONOS3-Mini 样本,以及来自同类开源和专有 TTS 模型的输出:
定性对比
预告片配音
“我绝不能过拟合。过拟合是模型杀手。过拟合是那微小的损失,却带来彻底的泛化失败。我将直面我的损失。我将允许梯度反向穿过我、流经我。而当它传播完毕,我将转动验证之眼,看清它的路径。损失所经之处,终将迎来收敛。唯有学到的表征将留存下来。”
 Zyphra
 Fish Audio
 Qwen
 Cartesia
 ElevenLabs
 OmniVoice
公园与游憩男
“你泄露了测试集?直接进监狱。没有验证,什么都没有。数据科学家,我们有一所专门关数据科学家的监狱。你过拟合?进监狱!你欠拟合?也进监狱!过拟合、欠拟合。你对训练数据做了归一化,却没对测试数据做?马上进监狱。你在排行榜上调超参数?信不信由你,进监狱!你管逻辑回归叫 AI?进监狱!你用神经网络去解决一个决策树就能解决的问题?进监狱!你忘了设随机种子?进监狱!你设了种子但没记录实验?也进监狱!你在不平衡数据集上说‘模型准确率 99%’?直接进监狱!你部署时没有监控漂移?立刻进监狱。”
ZyphraFish AudioQwenCartesiaElevenLabsOmniVoiceDwarkesh
“我觉得有意思的是,它不再有那种你预期这些模型会有的合成感、敷衍的语调。感觉真的像是在和人说话,对吧?而且也许 M.O.E 这个东西在这里确实起了很大作用。你能感受到一个大得多的模型的感觉,同时又具备出色的实时性能。”
ZyphraFish AudioQwenCartesiaElevenLabsOmniVoice定量比较

控制示例
语音设计
每组对比在 A、B、C 中使用完全相同的文本。这 15 个样本在嵌入模式下使用相同的旁白参考音色,采用中性表达。性别和音色纹理组使用种子 27182;其他组使用种子 2027。只有列出的设计控制项发生变化。这些设置是生成目标;感知特征和说话人一致性应通过试听来评估。
1. 同一说话人,三种口音
“我把车停在水边,就在咖啡店过去一点。四点半之后我在那儿等你。”
注意听发音的变化,同时声音仍可辨认为同一说话人。England steering 被用作南英格兰英语目标的近似。
A通用美式中性基础音色B南英格兰英语目标- british1.5
- 澳大利亚英语1.5
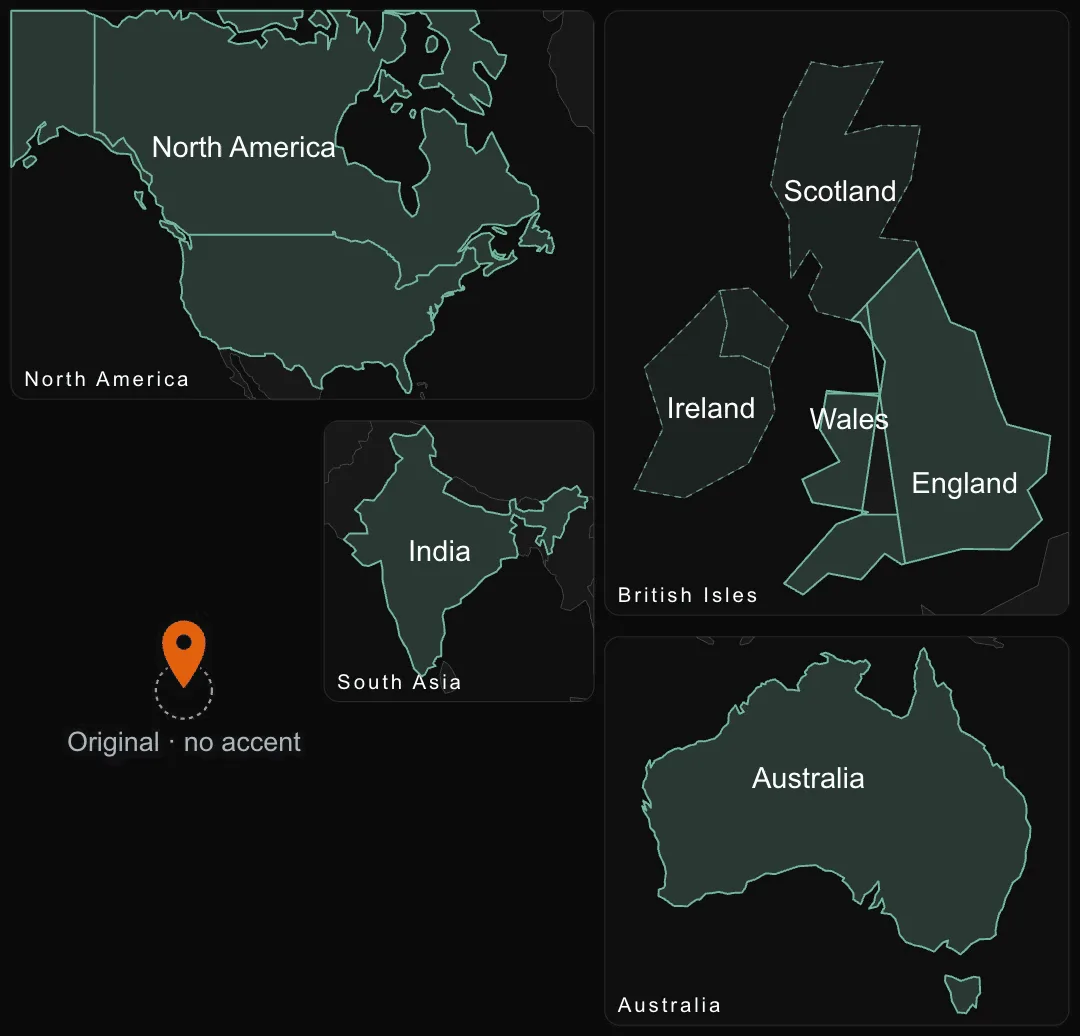
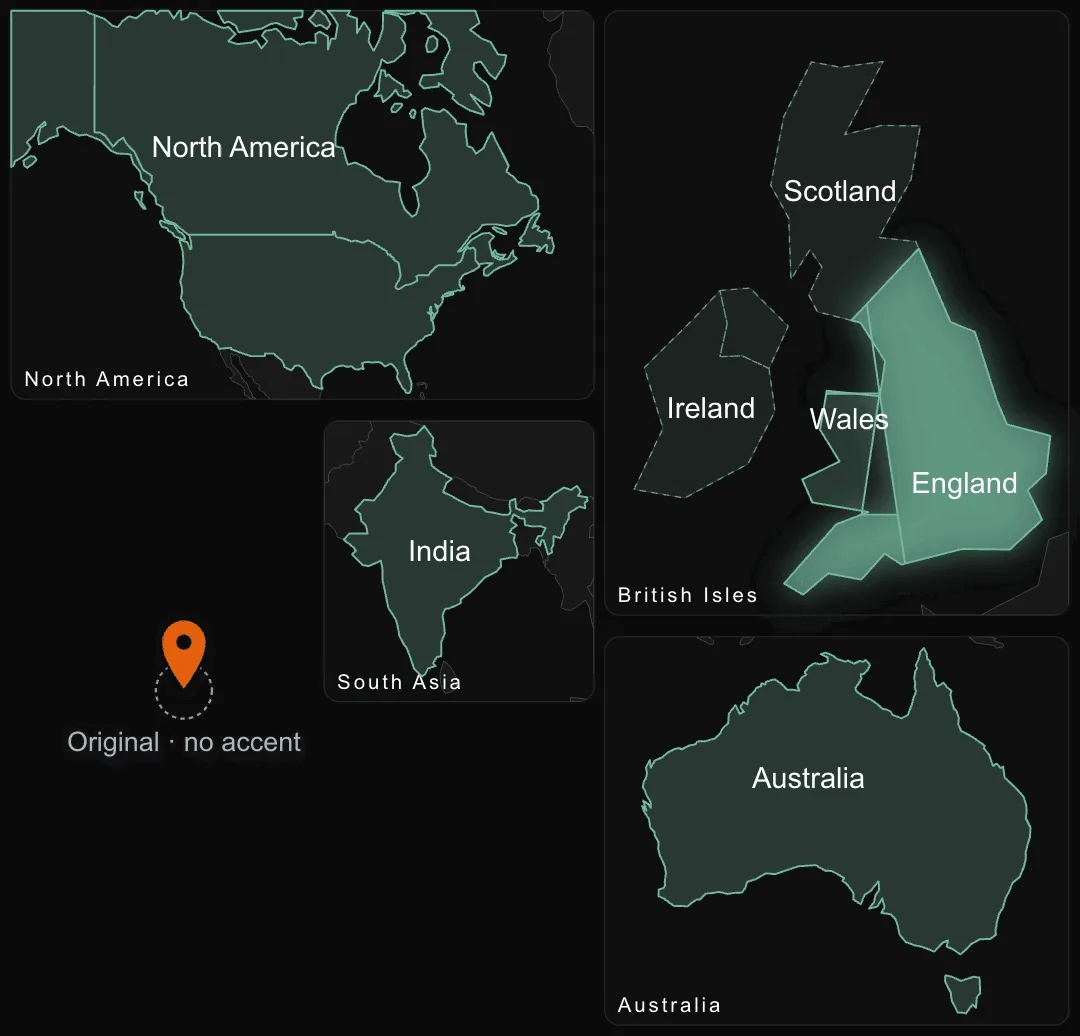
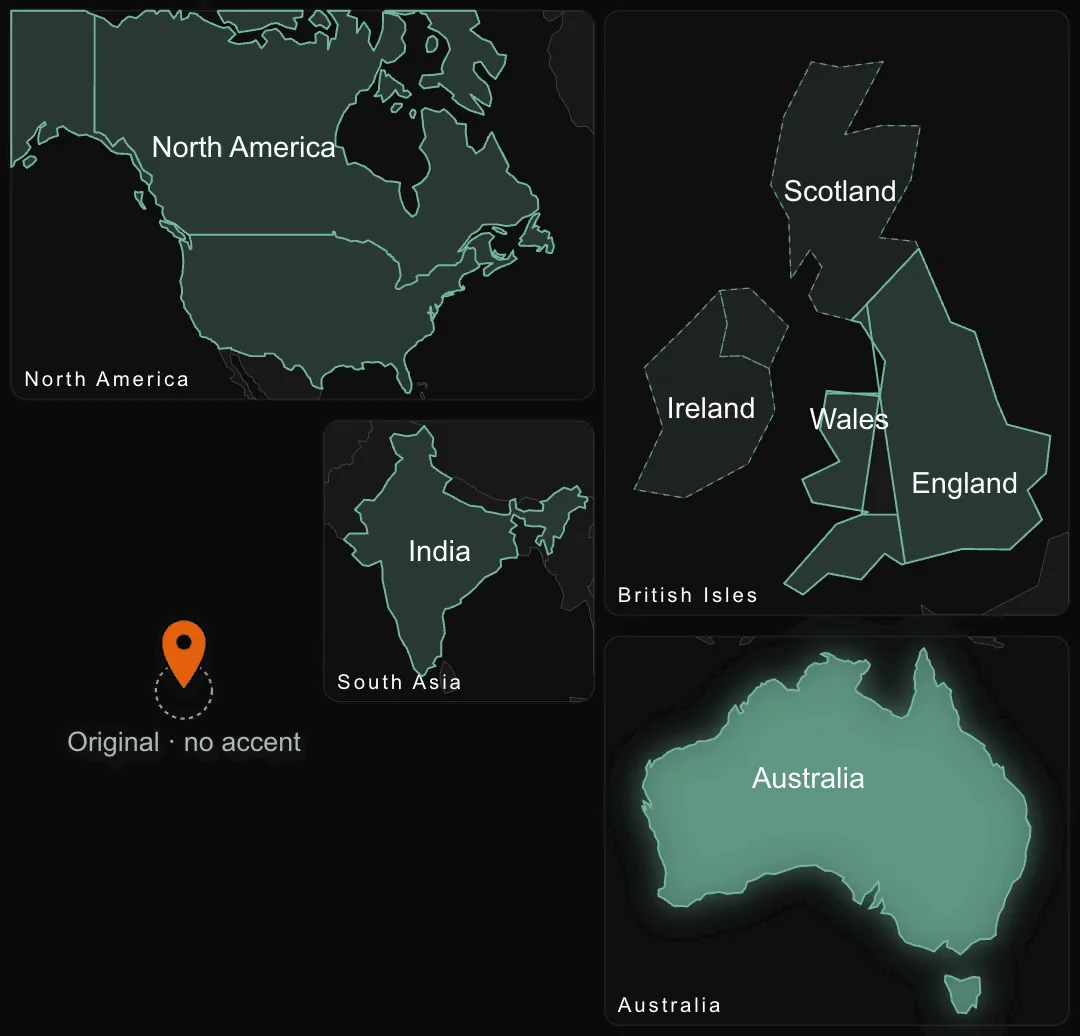
2. 同一声音在不同年龄
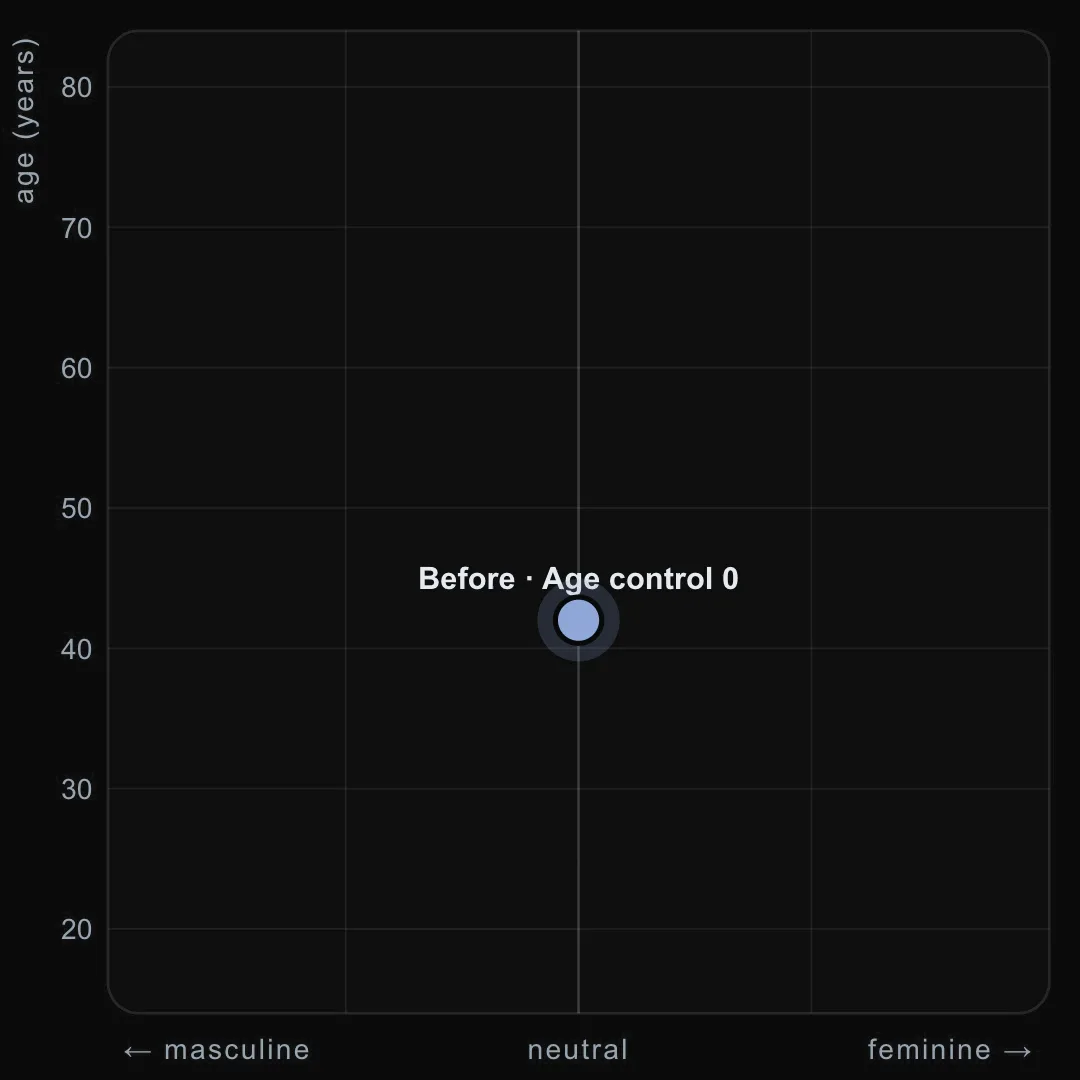
“我在楼上的盒子里找到了那台旧相机。里面还剩一张照片,所以我们把它拍好一点吧。”
注意聆听通过声音质感和共鸣所感知到的年龄递进。这些年龄是目标值,而非实测年龄。
A青年目标25- age−1.5
- age+1.5
3. 性别呈现
“下一班火车十分钟后发车。我们刚好有足够时间买杯咖啡并找到座位。”
注意聆听共鸣、质感和音高的变化,同时基础说话人、口音和表达方式保持不变。中间性别设置的目标是中性化呈现。
A男性- gender−1.5
- gender−1
4. 声音质感
“木盒在最上层架子上,旁边是绿色瓶子和那个小黄铜钟。”
在普通说话音量下注意聆听中等的质感变化。柔和质感近似气声;没有专门的气声控制。
A清晰平滑中性基础音色B轻微气声近似- 柔和+5
- 沙哑+5
5. 用多个控制项组合出一个角色
“地图到这里就结束了。越过那道山脊之后,我们就得自己找路了。”
注意听年龄、性别呈现、口音和质感是否作为三个不同的选角选择一起体现出来。
A年轻澳大利亚女性- age−1.5
- 明亮+2.25
- 澳大利亚1.5
- 性别−1.5
- 低沉+3
- 年龄+1.5
- 柔和+2.25
- 沙哑+1.5
- 英式1.5
表达方式引导
这15个样本保持旁白参考说话人和口音固定。耳语片段集使用种子22361;其他表达方式集使用种子2027。除非指定了词语片段,否则引导整行表达方式。每个A/B/C组使用相同文本,以便直接比较表演变化。
6. 在片段上耳语
“我没说她拿了钥匙。”
B针对“我没说”,C针对“她拿了钥匙”,使用局部耳语引导(+4)。中性版本使用相同句子和种子。
A中性 中性基础音色 B在“我没说”处耳语- 耳语+4
- 耳语+4
7. 同样的话,三种情感意图
“你回来了。我还不确定你会不会回来。我在这儿等了一整晚。”
注意聆听对同一情境的不同诠释。这些是情感目标;控制项并不保证能产生特定情感,也不保证语速和投射能完全独立变化。
A温暖的宽慰- 快乐+3.5
- 唤醒度+1
- 愤怒+3.5
- 唤醒度−1
- 害怕+8
8. 保持清晰度的语速
“下一班列车将于七点三十分从四号站台发车。请在登车前准备好车票。”
注意聆听清晰的速度范围,每个词都要保留,尤其是站台号和发车时间。语速调节也会影响响度和音高。
A缓慢而刻意- pace−2
- pace+2
9. 投射:从近旁到房间另一头
“你能听到我吗?我就在这儿,门旁边。跟着我的声音走,我会等你。”
注意聆听呼吸、共鸣、发声力度以及响度的变化。整组样本的情感目标保持平静。
A柔和亲密- 投射−3
- 投射+3
10. 生动度:从克制到活泼
“盒子里有一把银钥匙、一张折叠的地图和一个小门铃。我自然按了它。”
注意聆听逐渐增强的音高变化、节奏趣味和富有表现力的措辞。生动度调节也会影响音高水平和时长。
克制- 活泼−8
- 活泼+8
训练与架构细节
对于 ZONOS3-Mini,我们在编解码器、架构和说话人编码器层面做出了重大改进。
第一项重大改进在表示层面。Descript Audio Codec(DAC)尽管保真度极高,但极难建模,并且由于其高帧率(86 Hz)而限制了实时语音生成。为改善这些问题,我们训练了自己的编解码器 Zyphra Audio Codec 1(ZAC-1)。在相似的数据约束下,使用 ZAC-1 训练的模型相比使用 DAC 训练的模型实现了 10 倍的词错误率降低,同时获得更好的声学相似度。与 S1-DAC 和 MOSS v2 等领先的 TTS 编解码器相比,它在更优压缩率下取得相当的结果,或在相似压缩率下取得更好的结果。它通过为 TTS 主干网络创建更有利的表示来实现这一点。
其次,我们整合了在 LLM 中发展出的架构改进。ZONOS3-Mini 中的序列混合器采用 Gated DeltaNet(GDN)与全局注意力的 3:1 混合,这帮助我们在更长上下文长度下实现更强的性能以及更高的吞吐量。我们还整合了潜在 MoE、Q 平衡和注意力残差,这些在我们的模型规模下显著提升了性能。
第三,我们将说话人表示从 Qwen3-TTS 说话人编码器改为 MECT-B2 说话人验证模型。这既提升了下游说话人相似度,也使说话人操控更易实现。ZONOS3-Mini 支持两种说话人条件模式。第一种模式在预训练之初就通过上下文中单独的音频片段进行训练。这能实现更自然的输出,代价是无法精确复制韵律。第二种模式使用目标片段的直接语音表示,并在预训练后的短阶段进行微调。
最后,我们引入了两个后训练阶段,首先使用直接偏好优化(DPO),然后使用组相对策略优化(GRPO)来增强鲁棒性。
评测
继此前发布 ZTTS1-Eval 之后,我们现在发布 Zyphra TTS Evaluation v2(ZTTS2-Eval)。ZTTS2-Eval 将 ZTTS1 的干净集扩展到覆盖 35 种语言,将其真实场景集扩展到覆盖 20 种语言,且每种语言的样本数均更高。在低资源语言以及 Qwen TTS 模型更具优势的英语中,Qwen3-ASR 由 Whisper Large v3 补充。ZTTS1-Eval 中使用的 TTSDS2 韵律指标被取代,改用新的节奏和音高分布匹配指标,以及调整后的掩码韵律模型嵌入距离,并加入打乱输入下限,从而扩展了模型所覆盖的范围。
随着指标数量的增加,尤其是在跨语言和跨条件方面,我们纳入了新的 Zyphra TTS Capability Index v1,它基于 Epoch Capability Index,使用项目反应理论对 420 个项目(指标 × 测试集 × 语言)建模,每个项目都有自己的难度和斜率。ZONOS3-Mini 在开源模型中排名第一,紧随其后的是 Fish S2 Pro 和 MOSS TTS v1.5。
可控性
除了最先进的清晰度和说话人相似度之外,ZONOS3-Mini 还具备对说话人身份和表达方式的广泛控制。我们的控制轴涵盖年龄、性别、口音和质量方面的身份控制,通过说话人嵌入向量实现,并针对口音专门使用任务向量。包括语速、情感、投射感和生动度在内的表达控制通过激活引导(Activation Steering)实现。除了在话语层面进行引导外,我们还利用注意力中学习到的对齐头在词级别引导表达。此外,我们基于 VoiceCraft 方案发布了一个编辑模型,允许用户以与正常生成相同的控制方式无缝修改句子。
推理
为了服务 ZONOS3-Mini,我们通过 SGL 提供第 0 天支持。此外,我们还发布了原生 C++/ggml 运行时以及 WebGPU 运行时,可在从顶级服务器 GPU 到使用多年的手机等各种设备上运行 ZONOS3-Mini。