为解决这些问题,LG AI Research 提出了 ATAD(以智能体为中心的文本异常检测),这是一种动态评估协议,它超越了评估固定数据集的传统方法. 使评估过程本身能够随着模型能力的发展而演进。ATAD 由 Teacher、Orchestrator 和 Student 三个智能体组成,它们反复生成、验证并求解问题。当 Student 解决一个问题时,Teacher 会生成一个更难的问题,而 Orchestrator 则在整个过程中持续验证问题的清晰性、逻辑一致性和公平性,以防止问题随着难度增加而变得含糊。换言之, ATAD 的核心在于,它提出的协议并不止于一次性构建新的基准数据集,而是随着模型的进步持续调整评估问题的难度和质量.
. 相关研究以“从静态基准到动态协议:用于评估 LLM 推理的以智能体为中心的文本异常检测”为题,被 ICLR 2026 主会接收并展示。ICLR(国际学习表征会议)是享誉世界的国际会议,会上分享机器学习领域的最新研究成果,重点关注表征学习和深度学习。ICLR 2026 于 4 月 23 日至 27 日在巴西里约热内卢举行。
1. 现有静态基准的局限性与新的动机
目前广泛用于评估 LLM 的静态基准具有以下结构性局限。
● 性能饱和:最新的 LLM 在静态基准上已经超越人类水平的表现,导致其区分模型之间性能差异的能力丧失。
● 数据污染:评估数据被纳入大规模预训练过程,导致模型将其记忆,从而造成排行榜分数虚高。
● 格式过拟合:模型开发者针对数据集中的特定格式调整系统,形成反馈循环,使分数上升,而通用推理能力并未真正提升。
● 寿命短:一旦某个基准被攻克,构建新的基准需要耗费大量时间和资源,使可持续评估变得困难。
由于这些问题,人们日益需要 动态评估. 这种方法可以防止数据污染,并让模型随着自身的进步而持续演进。
然而,现有动态基准仅限于简单地生成或扩展问题,ATAD 则通过引入“以智能体为中心的三方交互结构(Teacher-Orchestrator-Student)”而与众不同。特别是,Orchestrator 专门负责验证,防止随着难度提升而出现的清晰性丧失和模糊性增加,并通过识别学生智能体失败的节点,实现“失败驱动的样本定稿”,从而创建了一个高质量的基准协议, 更精确地揭示模型的实际盲点.
. 特别是在文本异常检测领域创建问题时,研究人员始终面临一个重大挑战:“清晰性与难度之间的权衡”。这是因为,与数学或科学不同,语言没有明确的数学公式或固定答案;因此,试图提高难度往往会导致正确答案含糊不清,而让正确答案过于清晰又会使问题过于简单,从而失去区分能力。
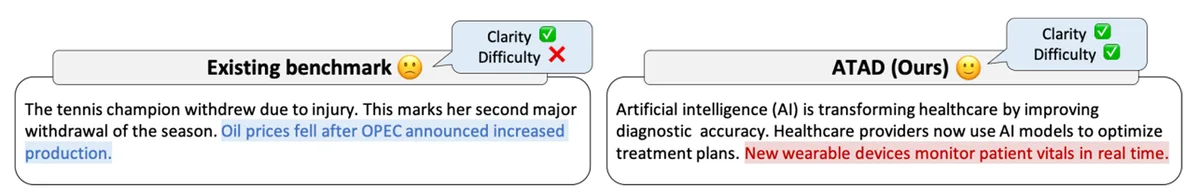
图 1. 现有基准与 ATAD 在文本异常检测问题上的比较[1]
例如,现有基准常常在一段关于“一名网球冠军因伤退赛”的文字中,插入一句完全脱离上下文的句子,如“石油价格在欧佩克宣布后下跌”。虽然正确答案显而易见,但对最先进的 LLM 来说,这是一个微不足道的问题。
相比之下,ATAD 要精细得多。在“AI 正在彻底改变医疗保健”的语境中,它诱导出微妙的话题转移,例如先列举治疗方案优化或实时生命体征监测等技术优势,然后突然提出关于 AI 的伦理担忧。这创造了一个具有挑战性的问题,需要高级的语言和逻辑推理能力,同时仍保持明确的正确答案依据。
2. ATAD 协议结构与 7 项文本异常检测任务
ATAD 通过引入三个 AI 智能体交互的协议来解决这一问题,而不是使用固定数据集。与数学或代码不同,自然语言缺乏明确的公式,这使得文本异常检测成为一项严格的压力测试,用以验证是否能够在保持清晰性的同时提高难度。
● Teacher 智能体(提问者):生成基础问题;如果 Student 正确回答了一个问题,它会基于分析生成难度递增的变体。
● 编排器智能体(验证者):严格验证所生成问题的逻辑一致性、清晰性和公平性,以防止出现模糊或不恰当的对抗性难度提升。
● 学生智能体(求解者):求解经过验证的问题。当学生智能体未能解决某个问题时,该问题即被确认为最终的基准测试项(失败驱动的样本定稿)。
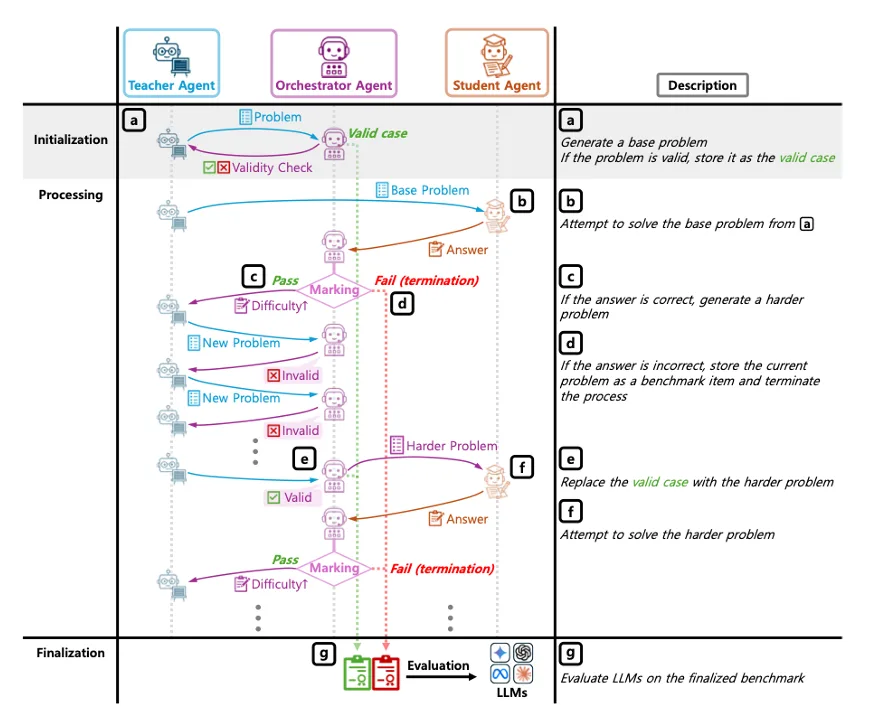
图 2. ATAD 基于教师-编排器-学生的动态评估协议[1]
ATAD 共设计了七项异常检测任务(T1-T7),以防止表面化的模式匹配,并评估跨句逻辑推理能力。
代表性任务包括:句子语境异常(T1),用于发现语境中的语义偏差;指代歧义(T5),用于发现指示词或代词中的歧义;以及语气/风格违规(T7),用于发现风格和语气上的不一致。每项任务都从多个角度验证模型的各种推理能力。
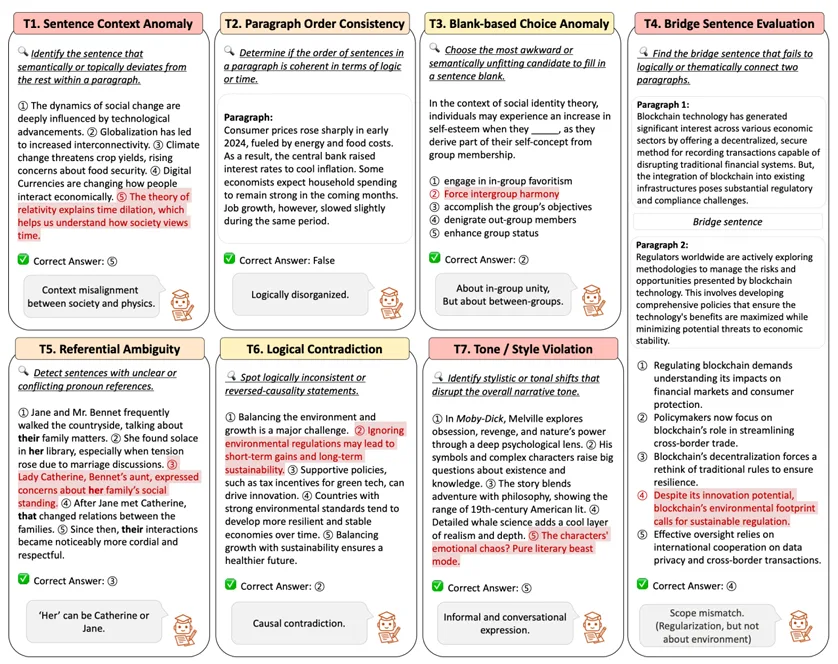
图 3. ATAD 定义的 7 项基于文本的异常检测任务示例[1]
3. 实验结果分析:难度扩展与编排器质量控制作用的证明 当 ATAD 生成的基准在包括 GPT-4o、Claude-3.5-Sonnet 和 Gemini-2.0-Flash 在内的多种 LLM 上进行评估时,发现了一些有趣的结果。
首先, LLM 的性能模式在不同任务间存在差异. 即使是平均表现相对较高的模型,在特定任务上的表现也逊于其他模型,且没有任何单一模型在全部七项任务上始终表现出最高性能。这表明每个模型在不同的推理能力上都有其独特的优势和劣势(盲点),例如语境理解、逻辑关联、指令目标的推理以及风格判断。在实际实验中,性能模式也因异常类型的不同而在模型之间呈现出显著差异。
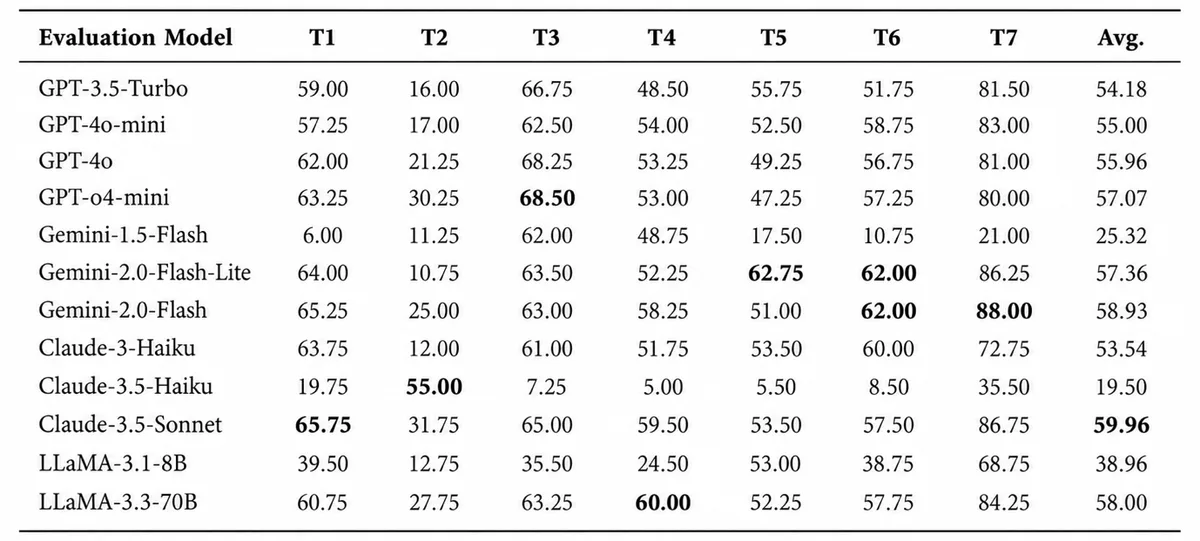
表 1. 各 LLM 在 ATAD 基准 7 项任务上的性能比较[1]
其次,在所有模型上,最终问题的准确率相比基础问题均显著下降。这表明 ATAD 协议并未止步于学生智能体已经能够解决的问题,而是通过教师与学生之间的迭代交互生成了实际难度更高的问题。即使使用 GPT-4o、Gemini-2.0-Flash、Claude-3.5-Sonnet 和 LLaMA-3.3-70B 进行基准生成,评估准确率也随着模型从基础问题推进到最终问题而持续下降,论文观察到整体性能下降约 21.3-33.9%。

表 2. LLM 在基础问题与通过 ATAD 生成的最终问题上的性能比较[1]
第三,最重要的发现来自 编排器的质量控制作用. 在实验中,当仅通过教师与学生之间的竞争生成问题、排除编排器时,GPT-4o 的评估准确率为 68.29%,低于有编排器参与时达到的 72.43%。如果仅看模型的准确率,没有编排器的问题似乎难度更高,即基准更好。
然而,当评估问题本身的质量时,结果却截然不同。当使用 GPT-4o 作为评审者并应用编排器时,问题的有效性从 4.30 提升至 4.85,连贯性从 3.71 提升至 4.74,公平性从 3.20 提升至 4.65。批准率,即被认为适合用作基准的问题所占比例,也从 38.14% 显著提升至 87.14%。使用 Claude-3.5-Sonnet 作为评审者时也观察到了相同的趋势。
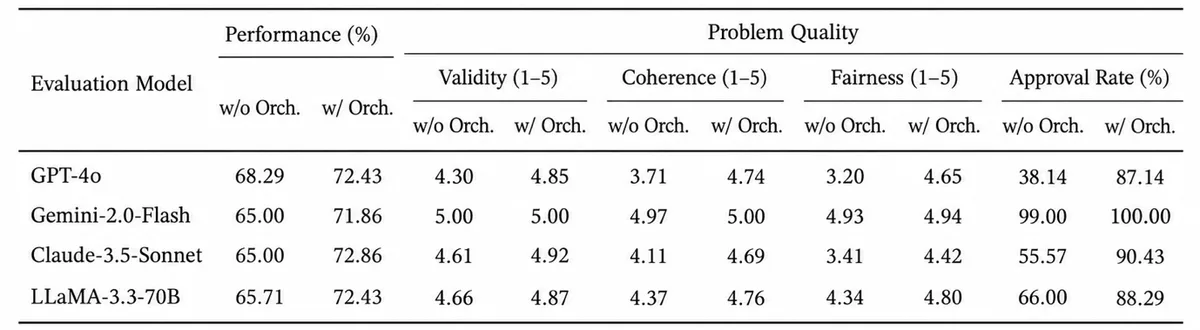
表 3. 基于是否应用编排器的问题难度与质量比较[1]
换言之,模型犯很多错误并不一定意味着它是一个好的基准。这是因为即使正确答案含糊不清、存在多个可能答案,或问题本身包含逻辑缺陷,模型的准确率也可能很低。在这种情况下,表现不佳可能并不反映模型在推理上的局限,而是由设计不佳的问题所造成的人为难度。
在 ATAD 中,编排器负责区分这两种情形。即使教师生成了难度更高的问题,如果逻辑一致性、清晰性或公平性无法保持,编排器也会拒绝这些问题并提示教师生成新的问题。因此,ATAD 并非简单地以降低模型准确率为目标;相反,它旨在在保持“好”问题标准的同时提高推理难度。论文还证实,在没有编排器的情况下观察到的低准确率可能源于模糊或表述不当的问题,而非实际的推理难度。
这一结果与前述的 清晰性与难度之间的权衡 直接相关。教师与学生的竞争提高了问题的难度,而编排器则控制整个过程以确保清晰性不受损害。通过分离这两个角色,ATAD 使得在自然语言任务中同时生成高难度和高质量的问题成为可能。
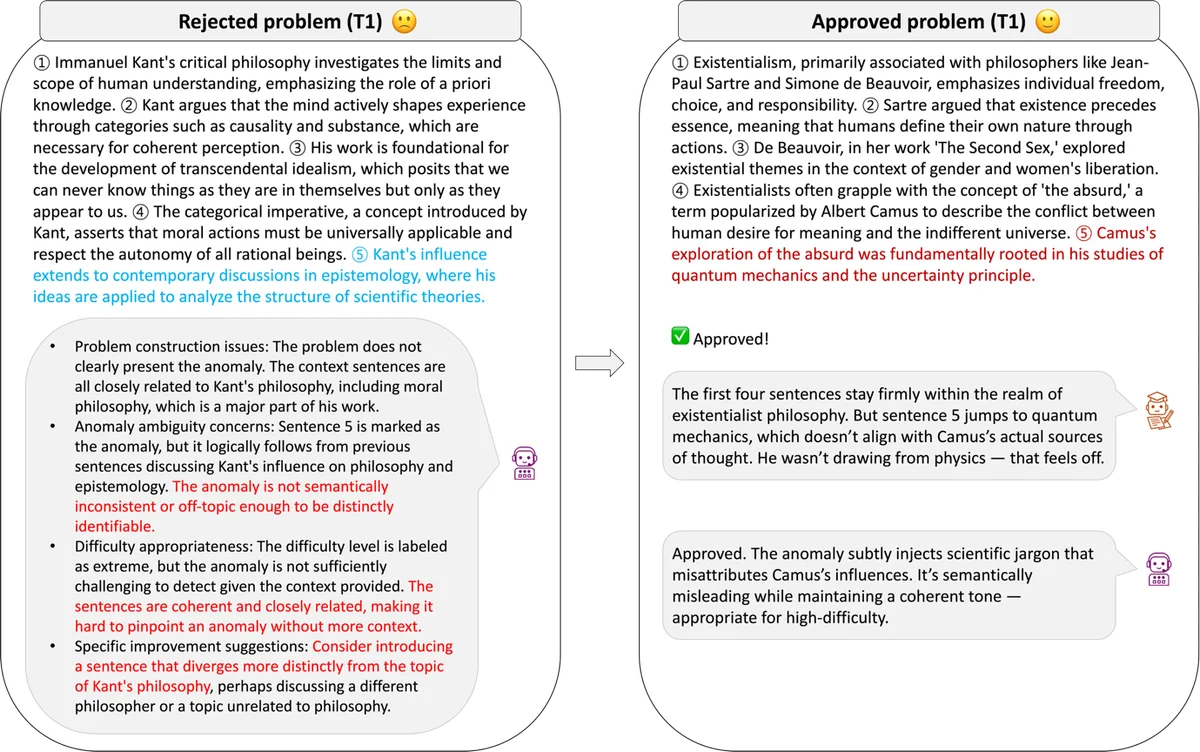
图 4. 通过编排器反馈改进问题的示例[1]
这一作用也可以在真实示例中观察到。在图 2 中,最初生成的问题所包含的句子都与主题有一定关联,使得难以判断哪一句是明确的异常。 编排器并未将其接受为高难度问题,而是拒绝了它,判定该异常不够明确. 随后,在收到反馈后,教师重新生成了问题,将其改进为一个既自然融入整体语境、又仍包含明确语义错误的问题。
因此,ATAD 中的质量控制并非旨在降低难度的机制,而是一个旨在消除因歧义而产生的不正确难度级别、仅保留真正需要实际推理能力的问题的过程。
4. 不是新数据集,而是随模型共同演进的评估协议 ATAD 最终提出的变革不止于新增一个文本异常检测数据集。在现有的静态基准中,一旦创建了评估问题,同一问题就会被反复使用。因此,随着模型不断进步并在该基准上取得高性能,随着时间推移,越来越难以区分模型之间的能力差异。
相比之下,ATAD 将基准定义为一种协议,而非固定的数据集,通过该协议,Teacher-Orchestrator-Student 三者进行交互。目前,当 Student 解决一个问题时,Teacher 会生成一个更难的问题,而 Orchestrator 则验证该问题是否仍然清晰且公平。因此,即使出现更强大的模型来承担 Student 的角色,评估的难度也可以再次提高,以匹配该模型的能力。
这实现了 模型-基准共同演进,即基准与模型并非彼此独立存在,而是 基准随模型的进步而共同演进. 论文本身强调,将焦点从传统的基于静态数据集的评估转向基于动态协议的评估,是 ATAD 的核心研究方向。
此外,问题动态生成并不意味着每次的评估结果会有显著差异。在使用相同智能体配置反复生成基准并进行评估的实验中,即使样本数量增加,模型的平均性能仍保持相对稳定。这表明 ATAD 能够适应模型的能力,同时作为评估协议保持一定程度的一致性和稳定性。
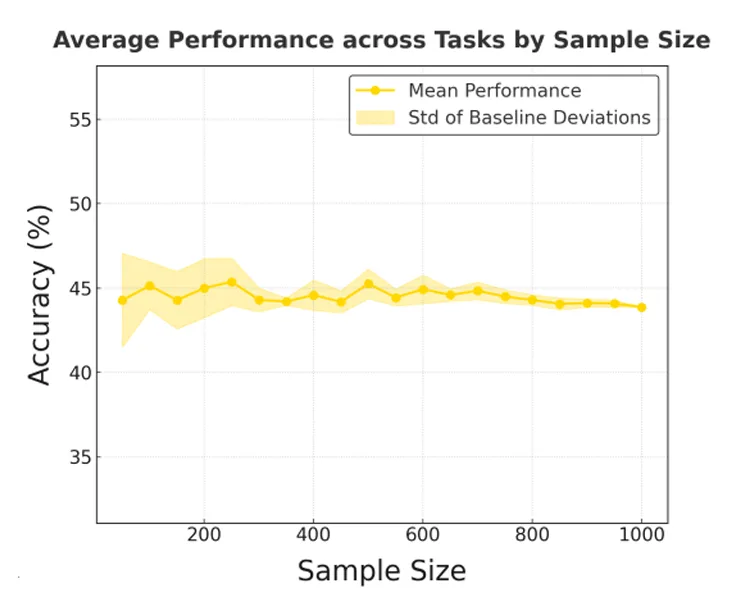
图 5. 评估性能随基准样本数量的稳定性[1]
最终,ATAD 的目标并非简单地“再创建一个更具挑战性的数据集”,而是 确保评估方法与被评估的 AI 共同演进.
未来研究方向:迈向自我演进的 AI 评估系统 本研究以文本异常检测为重点验证了 ATAD 的潜力。与数学或编程不同,文本异常检测难以使用明确的公式或执行结果来验证答案,同时需要各种形式的推理,如上下文、逻辑、指代关系和风格。因此,它作为一个具有挑战性的环境,用于 验证能否在保持问题清晰性的同时提高难度级别. 由于这些特性,论文还将文本异常检测用作 ATAD 的代表性压力测试。
然而,ATAD 的 Teacher-Orchestrator-Student 结构本身并不依赖于任何特定任务。未来,该框架可以扩展到更广泛的领域,如数学推理、代码验证、工具使用和多模态推理。此外,我们可以考虑为 Teacher 提供外部文档或知识以生成领域特定问题,或将检索增强生成(RAG)或单独的验证器与 Orchestrator 集成,以更严格地验证事实准确性和逻辑有效性。
此外,虽然目前由人类设计 Teacher、Student 和 Orchestrator 的角色和工作流程,但未来可以使用元智能体(Meta-Agents)来自动识别更好的 Teacher 和 Orchestrator,或优化智能体之间的角色和交互。这可能促成一种系统的发展,其中 不仅评估问题,而且创建问题的智能体以及评估协议本身都共同演进. 论文还提出了后续研究方向,例如从博弈论角度分析智能体的贡献,或通过元智能体自动探索更有效的智能体工作流程。
最终,LG AI Research 旨在超越每次模型演进都需要从头重建新基准的评估方法,转而将研究扩展到一种 动态评估系统,其中问题的难度和评估方法根据 AI 的能力持续调整. 目标是开发超越简单比较模型最终分数的评估方法,从而能够持续探索模型的推理能力及其具体失败点。
在 ICLR 2026 上,我们展示了我们的 ATAD 研究,并分享了我们的观点:评估方法必须随着大型语言模型(LLM)的快速发展而共同演进。展望未来,我们计划继续利用智能体之间的交互来更精确地衡量模型的能力和局限性,并开发即使在新 AI 技术涌现时仍然有效的评估方法。 参考文献 [1] Seungdong Yoa, Sanghyu Yoon, Suhee Yoon, Dongmin Kim, Ye Seul Sim, Junhyun Lee*, Woohyung Lim*. From Static Benchmarks to Dynamic Protocol: Agent-Centric Text Anomaly Detection for Evaluating LLM Reasoning. In International Conference on Learning Representations (ICLR), 2026.
[2] Dan Hendrycks, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song, Jacob Steinhardt. Measuring Massive Multitask Language Understanding. In International Conference on Learning Representations (ICLR), 2021.
[3] Karl Cobbe, Vineet Kosaraju, Mohammad Bavarian, Mark Chen, Heewoo Jun, Lukasz Kaiser, Matthias Plappert, Jerry Tworek, Jacob Hilton, Reiichiro Nakano, Christopher Hesse, John Schulman. Training Verifiers to Solve Math Word Problems.
查看列表