- 开放权重模型如今以更低成本接近前沿级智能,同时为企业提供数据主权和运营自主权。
- Unity AI Gateway 通过一个受治理的 API 提供开放权重模型、前沿模型和外部模型,具备快速推理、智能路由、回退和预算控制能力。
作为 Databricks 的现场工程师,我们每天都在企业 AI 部署中工作,在那里我们观察到战略上的明显转变。在两年标准化采用单一前沿模型供应商之后,企业正因七项关键压力而重新评估其做法:
塑造 AI 战略的七项观察
1. 支出未能产生足够回报。 AI 预算的增长已超过收入和成本节约,促使企业需要更好的单位经济效益 [1]。
2. 自 2023 年以来,模型排名已多次变化。 最适合编码、推理和提取的模型每月都在变化,而自 2023 年 5 月以来,最高智能排名已易主 20 多次 [2]。与单一供应商绑定的架构使得在排名变化时更难采用更好的模型。
3. 前沿模型的护栏可能阻止合法工作。 AI 实验室施加的模型护栏可能拒绝合法任务,例如分析实时恶意软件或复现漏洞以进行修补,这一限制在最近的 Hugging Face 事件中被发现 [6][7]。当 Hugging Face 响应人员将真实攻击日志和漏洞利用载荷输入托管的前沿模型进行分析时,护栏拒绝了请求,团队转而使用开放权重模型(GLM 5.2)进行分析。
4. 数据保留政策已经演变,且可能继续演变。 一些前沿供应商已偏离零数据保留(ZDR)政策,例如 Anthropic 的前沿层级引入了 30 天最低保留期 [8]。对于合规政策围绕“任何提示或补全内容都绝不存储”原则制定的企业而言,上游政策变化可能带来问题,并可能需要系统变更。
5. 企业希望获得对模型治理的可见性和控制权。 对跨 AI 模型的端到端可见性和治理的需求正在增长。客户希望获得可搜索的模型输入、输出、错误和智能体操作记录,以便团队评估准确性并提升性能,同时希望获得集中控制以保护敏感数据和知识产权。
6. 测试框架与模型同样重要。 Databricks 的研究表明,模型周围的脚手架——即由提示、工具和控制流组成的测试框架——会改变测得的性能。在 Databricks 自己的基准测试中,同一模型在一个测试框架中得分为 61.7%,在另一个中为 48.1%,而在裸模型下为 38.4% [9]。由于测试框架的选择会改变基准测试结果,评估应同时测试模型和测试框架。
7. 开放权重模型已赶上前沿模型。 顶级开放权重模型如今的基准测试水平已可与顶级前沿模型相媲美,且成本更低 [3][4][5]。这在十八个月前并不成立。开放权重模型达到前沿级基准性能,改变了其他六点中所述的成本、控制和部署权衡。
综观这些观察,企业正试图:1)在不牺牲生产力提升的情况下优化成本,2)保持运营自由,3)确保 AI 实施能够快速纳入创新。为此,他们需要一种架构,使模型和测试框架能够在不削弱治理的情况下发生变化。
开放权重模型的吸引力
相比前沿模型,开放权重模型在成本效率、控制和灵活性方面更优:
- 智能商品化: 随着模型智能成为商品,开放权重选项如今以极低成本提供与顶级前沿模型相当的智能,从而使 AI 部署获得更好的 ROI。
- 数据主权: 在可控基础设施上托管模型,使团队能够掌控合规、安全和数据保留政策,并降低未来出现不合规变更的风险。
- 完全运营自主权: 开放权重模型让团队能够运行前沿护栏可能阻止的工作负载(例如网络安全响应)
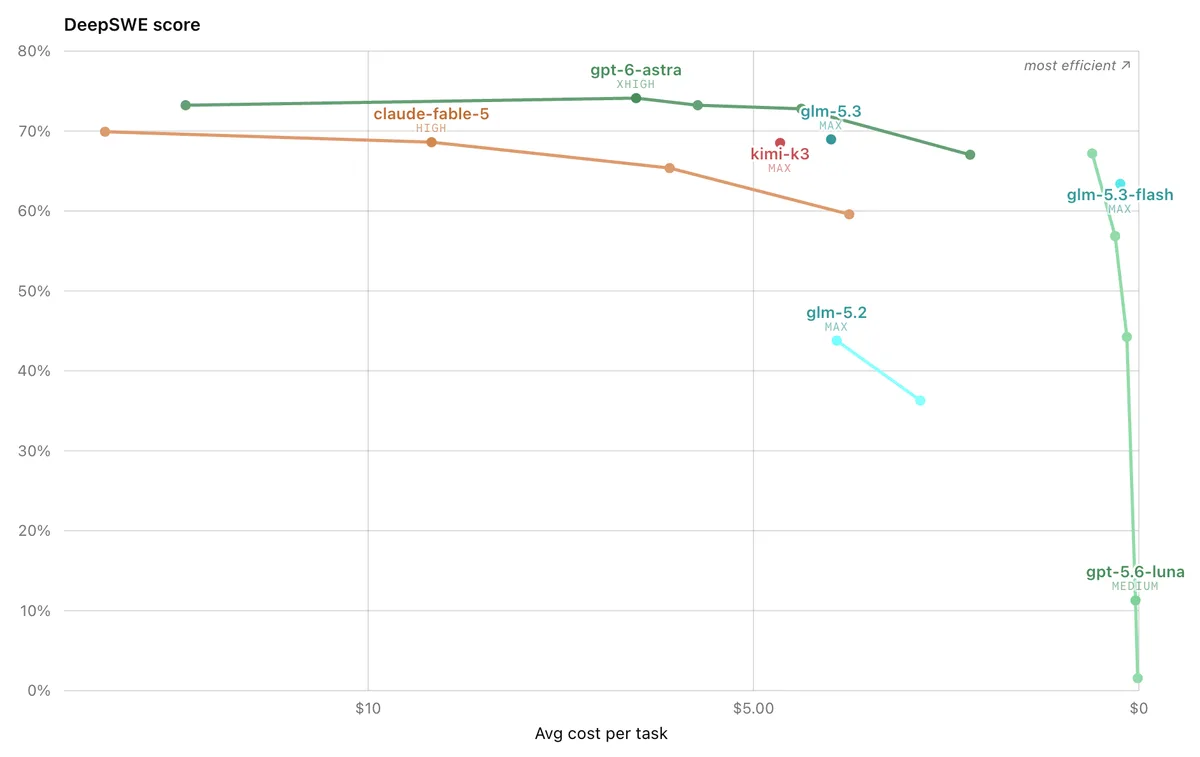
来源: [5] DeepSWE Leaderboard by Cost. 部分顶级开放权重模型与其专有等效模型的对比,筛选由作者自行决定。
在 Unity Gateway 上使用开放权重模型的好处
将开放权重模型与前沿模型结合使用
Unity Gateway 通过统一 API 和集中治理控制提供开放权重模型和前沿模型,使团队能够通过配置或智能路由在模型之间切换 [10][11] ,而无需通过代码更改或其他抽象层 [12][13].
Unity Gateway 的多模型能力正日益成为客户 AI 战略的核心组成部分。自 1 月以来,每位客户平均使用的唯一模型数量已从 4.2 个增加到 7.1 个,这既体现了 Unity Catalog 上可用的选项,也体现了对更高 ROI 模型的追求。在这些模型中,约 40% 为开放权重模型。
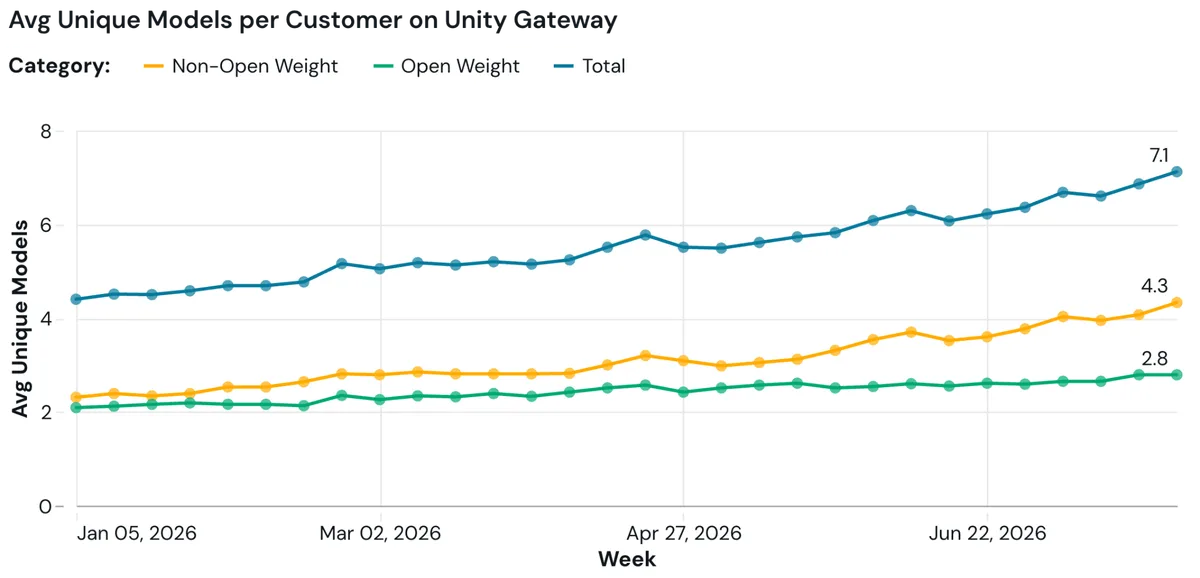
来源:Databricks 内部数据,统计周期为截至 2026 年 1 月 5 日当周至截至 2026 年 7 月 27 日当周。使用 Genie One 创建。
以行业领先速度使用大型开放权重模型
以具有竞争力的响应时间提供大型开放权重模型,需要优化以在规模化下保持成本效率。Databricks 通过在前沿 GPU 上部署定制推理引擎和优化内核来解决延迟限制。Artificial Analysis 的独立评估突出了这些性能特征:例如,GLM 5.3(max)在 Databricks 上实现 9.1 秒的端到端响应时间(包括输入处理、推理和生成) [15],与顶级托管端点相比表现良好 [16].
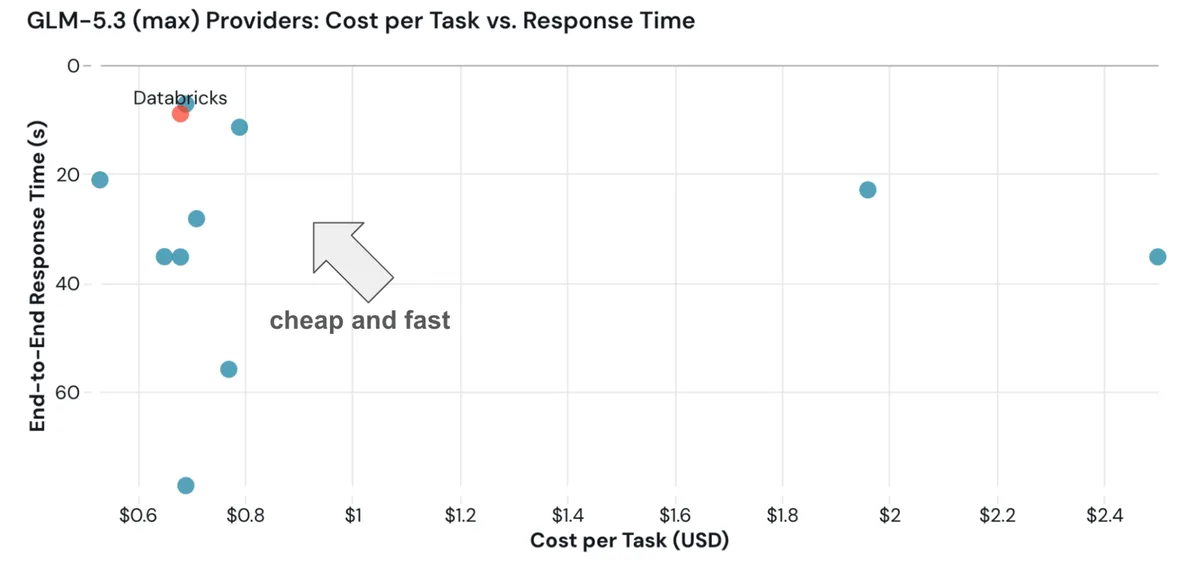
来源: [15] GLM 5.3 Model Providers: Artificial Analysis
从一个位置治理所有模型的成本和使用量
以下是一些关键功能,可帮助在 Unity Gateway 上治理这些模型并控制成本:
- 智能路由 将会话发送到成本高效的模型来执行任务,因此常规任务会从前沿模型上转移开 [10][11].
- 回退链 会根据模型速率限制或提供商中断自动重新路由 [14].
- 带支出上限的预算 按用户、团队或用例设置,可防止支出失控 [19][30]。这些限制可以配置为不同的严格程度,从软性警告到将会话重新路由到更便宜模型的严格策略。
- 工具和技能的统一治理。 除了内置 MCP 服务器外,Unity Catalog 还支持注册外部 MCP 服务器,这些服务器通过托管代理运行并接受集中审计。因此,代理获得的工具与其模型享有相同的治理 [20]。技能 [21] 也可以注册并接受治理,从而提高可重复工作流的确定性和 token 效率。
- 跨开放权重、外部和前沿模型的统一治理。 通过模型提供商服务连接外部模型提供商(例如 Amazon Bedrock、Azure AI Foundry) [17] ,并通过与 Databricks 托管的开放权重和前沿模型相同的中央治理层路由请求 [18]。从单一平台管理整个模型组合的访问权限、支出控制和审计跟踪。
企业正在将工作负载转向开放权重模型
GLM 5.2 的发布恰逢 Unity Gateway 上开放权重使用量急剧增加。GLM 5.2 于 7 月中旬上线后,其使用量随之上升。与此同时,Unity Gateway 客户的整体增长保持相对稳定,这表明现有客户将更多 AI 流量转向了开放权重模型。在首次提供仅一个月后,GLM 5.2 已占 Unity Gateway 上开放权重 token 使用量的约 40%,其中大部分增长为增量增长。GLM 5.3 和 Kimi K3 的基准性能为客户提供了另一个可与 GLM 5.2 一同评估的开放权重选项 [5].
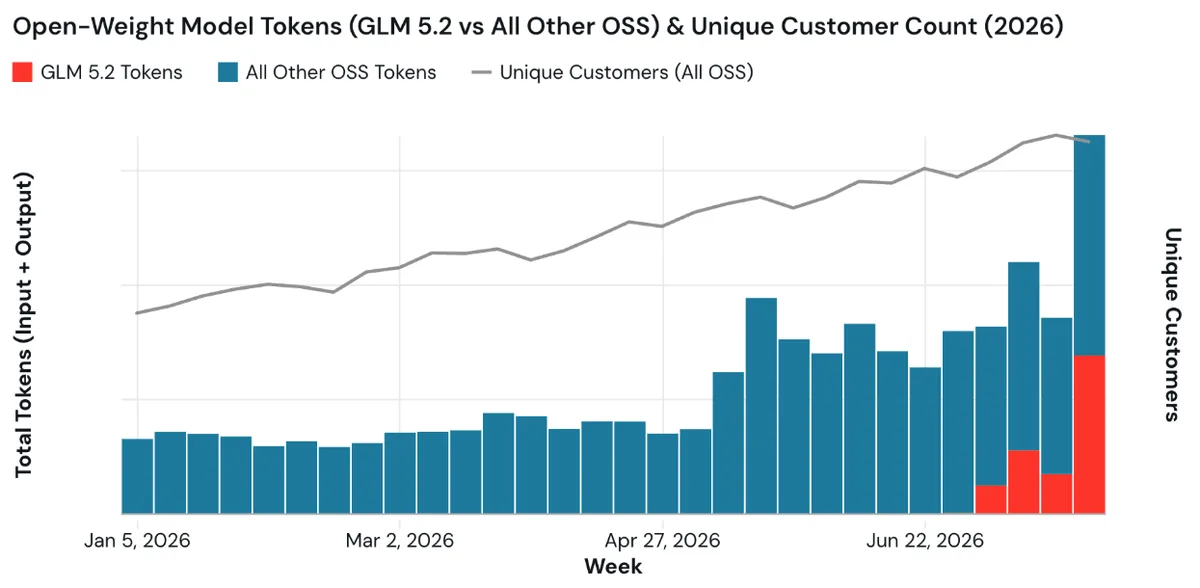
来源:Databricks 内部数据,统计周期为截至 2026 年 1 月 5 日当周至截至 2026 年 7 月 27 日当周。使用 Genie One 创建
为满足这一需求,Databricks 于 7 月宣布了一轮 30 亿美元的融资,CEO Ali Ghodsi 对 CNBC 表示,此次融资部分是为了确保托管开放模型所需的 GPU 容量。“我们在各地都面临 GPU 短缺……日本、韩国、美国、印度,所以我们只需要大量获取这些资源,而这需要大量资金。所以这就是触发我们此次融资的原因” [22].
在提供商 harness 中通过 Unity Gateway 访问开放权重模型
开发者已经使用的 harness 仍然可以运行 Databricks 托管的开放权重模型。截至 7 月下旬,Unity Gateway 上提供的模型(包括 GLM 5.3)可以在 Codex 和 OpenCode 等提供商编码 harness 中运行 [12][26],并正在逐步支持更多 harness。该网关为每个 harness 暴露 OpenAI 兼容端点,因此设置只需更改配置。将 harness 指向工作区的网关 URL,或使用 ucode 辅助工具 ,只需一行:
ucode codex --model system.ai.glm-5-3
结语
企业应规划一个模型组合,因为没有任何单一模型或提供商能在质量、成本和策略契合度上为所有工作负载领先。在可供选择的模型中,开放权重模型现在以更低的成本和更强的数据处理与治理策略控制力提供有竞争力的智能。相比之下,前沿模型在能带来更好结果的地方仍然有用。Unity Gateway 通过通用访问控制、路由策略、预算和审计来管理这些选项。Omnigent 将这种灵活性扩展到 harness,使团队无需重建工作流即可更换模型或代理环境。
本文中的使用数据表明,客户已经在朝这个方向前进。他们正在提供更多模型,将更多流量导向开放权重,并使用可移植的 harness 来拓宽选择。持久的优势在于,随着模型选项、质量、定价和策略要求不断演变,能够快速做出这些改变。
来源
[1] Nanda, M., Challapally, A., Pease, C., Raskar, R., & Chari, P. (2025, July). The GenAI divide: State of AI in business 2025 (AI 实施研究初步发现)。Project NANDA,麻省理工学院。
[2] LLM Leaderboard History: AI Rankings 2023-2026 Tracked, BenchLM
[3] Kimi K3 - Intelligence, Performance & Price Analysis, Artificial Analysis
[4] GLM-5.3 (max) - Intelligence, Performance & Price Analysis | Artificial Analysis
[5] DeepSWE Leaderboard by Cost
[6] Security incident disclosure, July 2026, Hugging Face Blog
[7] OpenAI's Hugging Face Breach Shows Frontier AI Guardrails Are Failing, Forbes, July 23, 2026
[8] Statement on the US government directive to suspend access to Fable 5 and Mythos 5
[9] What is an AI Agent Harness?, Databricks Blog
[10] Smart routing for coding agents
[11] Smart Routing in Unity AI Gateway: Match frontier quality with 30%+ lower cost per task
[12] Databricks-hosted foundation models, Databricks docs
[13] Agent Bricks: Data + AI Summit 2026, Databricks Blog
[14] Configure routing and fallbacks for model services
[15] GLM-5.3 (max) API Provider Benchmarking & Analysis
[16] https://artificialanalysis.ai/models#end-to-end-response-time
[17] Govern external model providers (model provider services)
[18] Databricks Unity AI Gateway Documentation
[19] Manage budgets for Unity Gateway
[20] Unity AI Gateway: How to connect agents to external MCPs securely, Databricks Blog
[21] Skills support in Unity Gateway
[22] Databricks CEO: We're hosting open source models like Kimi and running out of GPUs, CNBC, July 17, 2026
[23] Models & Credentials, Omnigent docs
[24] Benchmarking Coding Agents on Databricks’ Multi-Million Line Codebase
[25] Governing MCPs at Scale with Unity AI Gateway
[26] Use Open Source models with coding agents
[27] Unity AI Gateway: Multi-AI governance and cost control, Databricks
[28] Introducing Omnigent: A Meta-Harness to Combine, Control and Share Your Agents, Databricks Blog
[29] GLM-5.2 Providers: Output Speed Comparison, Artificial Analysis
[30] Introducing AI spend controls with Unity Gateway
[31] 推出 Omnigent:一个用于组合、控制和共享你的智能体的元框架
了解如何通过一个统一平台来治理、路由和监控开放权重、前沿及外部模型。
在收件箱中获取最新文章
订阅我们的博客,即可在收件箱中收到最新文章。