发布于 2026 年 11 月 4 日
Together Compiler:面向 AI 推理的持续编译
作者
Reyna Abhyankar Dylan Lim Simran Arora
目录
本文中的链接
AI 推理工作负载是动态的。存在成千上万种情形,涵盖新模型、硬件平台、客户、用例和流量形态。逐一手动优化这些情形已不再具备可扩展性。
- 架构高度多样:距离 Transformer 问世已约 11 年。我们或许以为会出现更多整合,但 OpenRouter 上排名前十的开源 LLM 没有一个使用相同的架构!
- 工作负载高度多样:Together 每天为数千名客户提供数万亿 token 的服务,每个客户的流量形态各不相同(批大小、序列长度、MoE 专家不均衡、注意力稀疏性、会话时长、领域)。
- 硬件高度多样:H100、B200、B300、NVL72、VR、Groq 等各自需要不同的策略。
理论上,智能体非常适合解决这个问题。它们能够适应新的工作负载,并在可能的优化空间中进行搜索,而不依赖那些困扰人类专家和传统机器学习编译器的固定规则或启发式方法。然而,当今的智能体系统受限于实验速度。
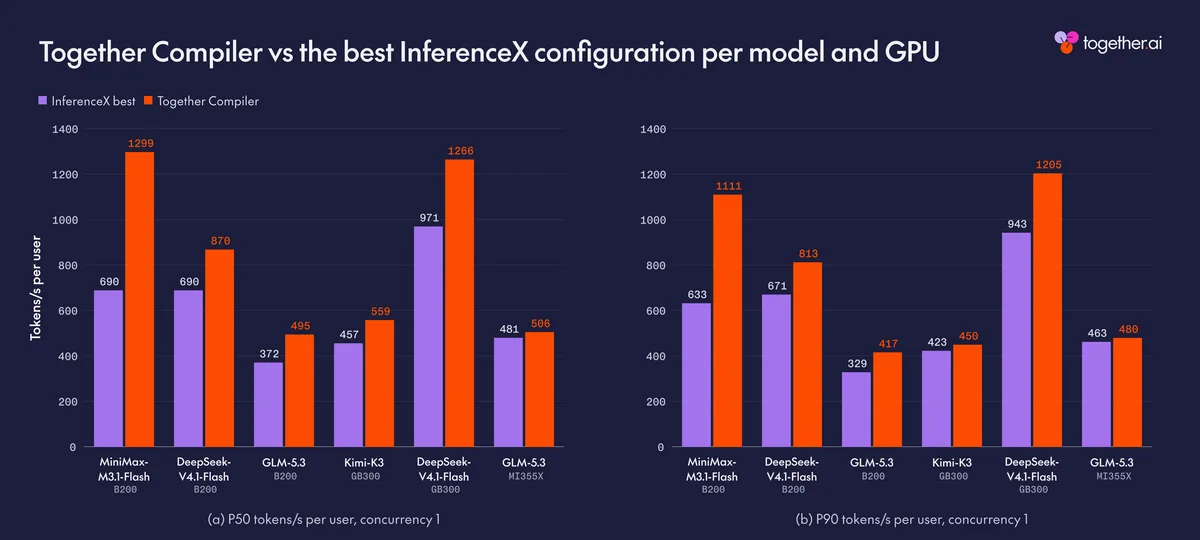
我们推出 Together Compiler(TKCC),这是首个 真正 持续 的 RSI 系统,利用高吞吐智能体针对多样化的推理工作负载进行优化. 在不到 24 小时内,TKCC 在前沿开源模型(Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash)上实现了 1.3-3 倍的 TPS 提升,在 SemiAnalysis 的 InferenceX 低延迟基准上取得 SOTA,MiniMax M3.1-Flash 达到 1111 TPS,DeepSeek v4.1-Flash 达到 1205 TPS,并在其主力 Llama 1B 批大小为 1 的设置上以 1.7 倍的优势超越现有的开源 megakernel。此外,TKCC 还能泛化到语言模型推理之外的领域(天气建模、PDE、时间序列和生物学)。这一性能提升得益于 TKCC 相比基线智能体式 RSI 性能优化系统高出 252 倍的实验吞吐。Together Compiler 目前已在服务数万亿 token。
流量在不断变化
作为推理服务提供商,我们观察到基于区域模式、新模型发布和突发性的各种用户行为。
- 区域模式: 世界各地的用户可能有不同的模型偏好。我们观察到,某个国家工作时间的流量中,提示长度比另一个国家长 1.4 倍(97k 对 70k)。
- 模型发布: 用户需要时间来弄清楚如何将新发布的模型整合到他们的工作流中。起初,他们倾向于选择基于聊天的交互和评估。紧接着,在发布仅两周后,随着用户转向智能体工作负载,提示长度迅速增加了 80%。
- 突发性: 客户可能在一天中的随机时间发送突发请求。如果不谨慎处理,提示长度可能突然翻倍,缓存命中率也可能下降。
显然,我们必须通过针对每个新部署的专门优化来适应不断变化的用户行为。
Together Compiler 概览
TKCC 以流量形态、模型和硬件作为输入。TKCC 使用智能体为推理引擎生成一系列优化。

TKCC 的核心洞见如下:
1. TKCC 最大化实验吞吐,并最小化智能体优化期间的 GPU 空闲时间
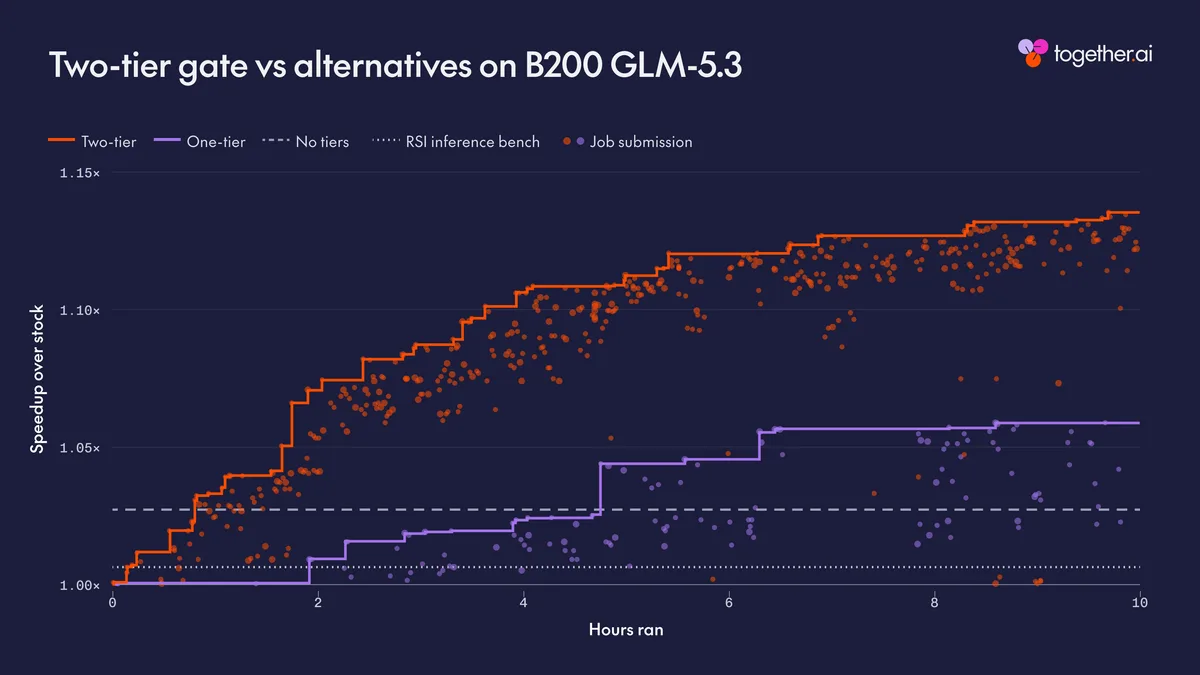
大多数现有的智能体式 RSI 推理系统要求智能体启动并拆除 VLLM、SGLang 或 TRT-LLM 等引擎来测试每个新实验。然而,引擎启动时间长达数 分钟, 严重阻碍了实验吞吐(见下表)。相反,TKCC 提出了一种“常驻引擎”的新范式,引擎只启动一次,即可热重载任何候选前向传播,无需任何重启。为确保常驻引擎始终有新的优化可供测试,TKCC 会生成多个智能体,持续产生想法并通过留言板通信,以并行化它们的工作。
| 阶段 | 现状(秒) | Together Compiler(秒) |
|---|---|---|
| 进程 + worker 初始化 | 93 | – |
| 权重加载 | 50 | – |
| KV-cache 大小设定 | 21 | – |
| JIT kernel 预热 | 93 | – |
| 自动调优 | 193 | – |
| API 服务器就绪 | 10 | – |
| RPC 调用 + Together Compiler 设置 | – | 1.7 |
| CUDA-graph 捕获 | 7 | 7.3 |
| 总服务就绪时间 | 467 | 9.0 |
表 1:引擎启动开销高昂
2. TKCC 在测量吞吐与测量保真度之间取得平衡
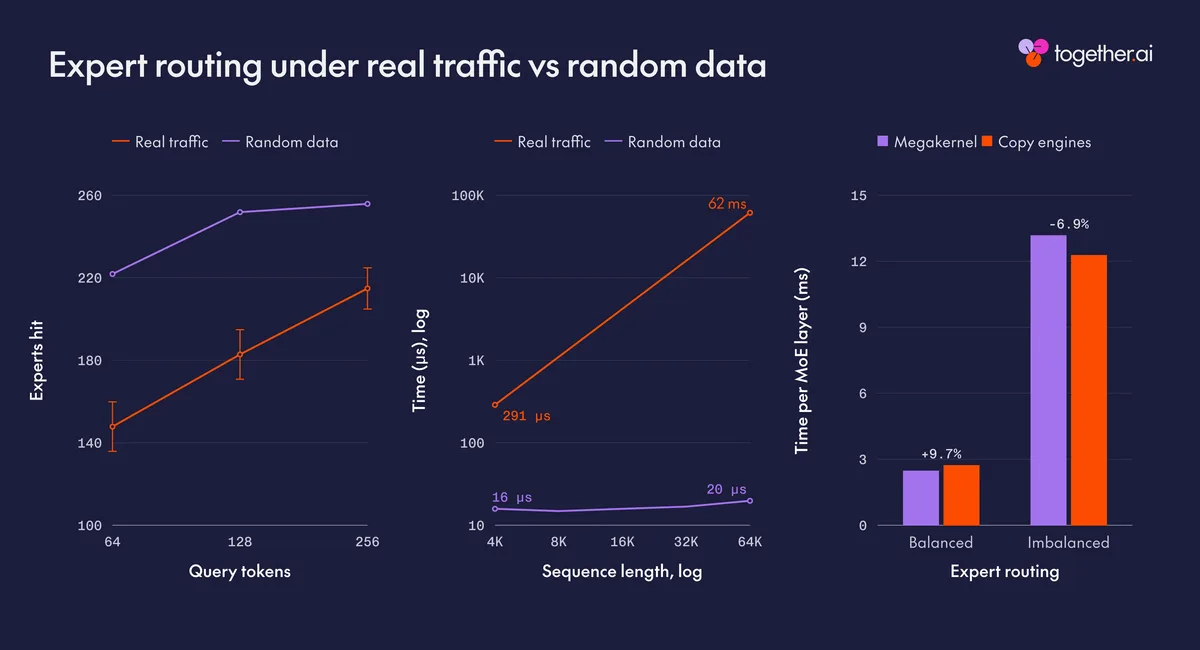
现有的智能体优化系统要么迭代地重新启动推理引擎,受困于低实验吞吐,要么在推理引擎之外孤立地优化独立 kernel,受困于较差的测量保真度。优化独立 kernel 的系统通常使用随机输入数据来评估它们。然而,在使用 MoE 和稀疏 k 注意力等数据依赖原语的现代架构中,输入数据分布会直接影响哪些优化策略可能胜出(见下图)。高保真输入对于有效优化至关重要。TKCC 使用一层常驻引擎来平衡吞吐与保真度之间的权衡:“快引擎”加载少量层,非常适合快速迭代和低方差计时;而“慢引擎”加载许多层,非常适合测试优化在真实数据分布上是否依然成立。
3. TKCC 利用自定义成本模型为智能体选择并行策略(例如 TP、EP、DCP 等),以实现最高性能
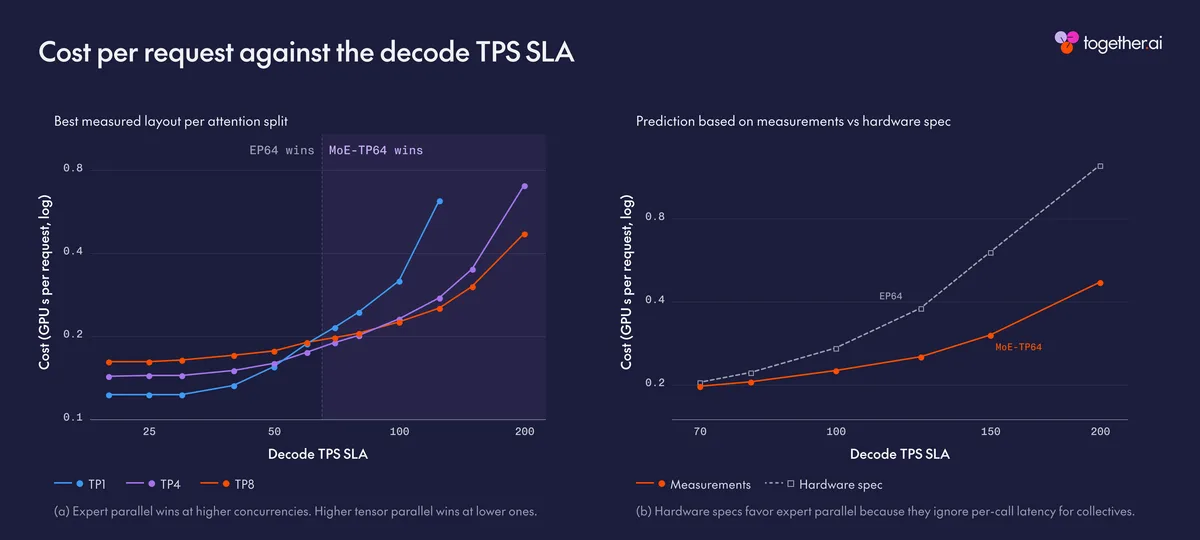
现有系统已有在 SLA 要求下选择推理配置的成熟方法。然而,选择理想配置仍面临同样的吞吐量与保真度权衡:逐一测量每种并行配置是难以实现的,尤其因为软件实现尚不成熟。一种朴素的做法是根据原始硬件规格或微基准来选择并行策略。然而,这不足以捕捉数据相关的流量特性,例如 MoE 专家不均衡或提示长度分布不均。我们设计了一个成本模型,采用分层测量策略,结合硬件规格、微基准和实测前向传播,以构建高保真表示,同时快速剪枝配置搜索空间,从而支持持续的流量漂移。
结果
我们将 TKCC 与三类不同的基线进行评估:手工调优的 megakernel、InferenceX 引擎配置,以及来自天气建模、PDE、时间序列和生物模型等不同领域的流行 AI 代码库。
MegaKernel 工作负载
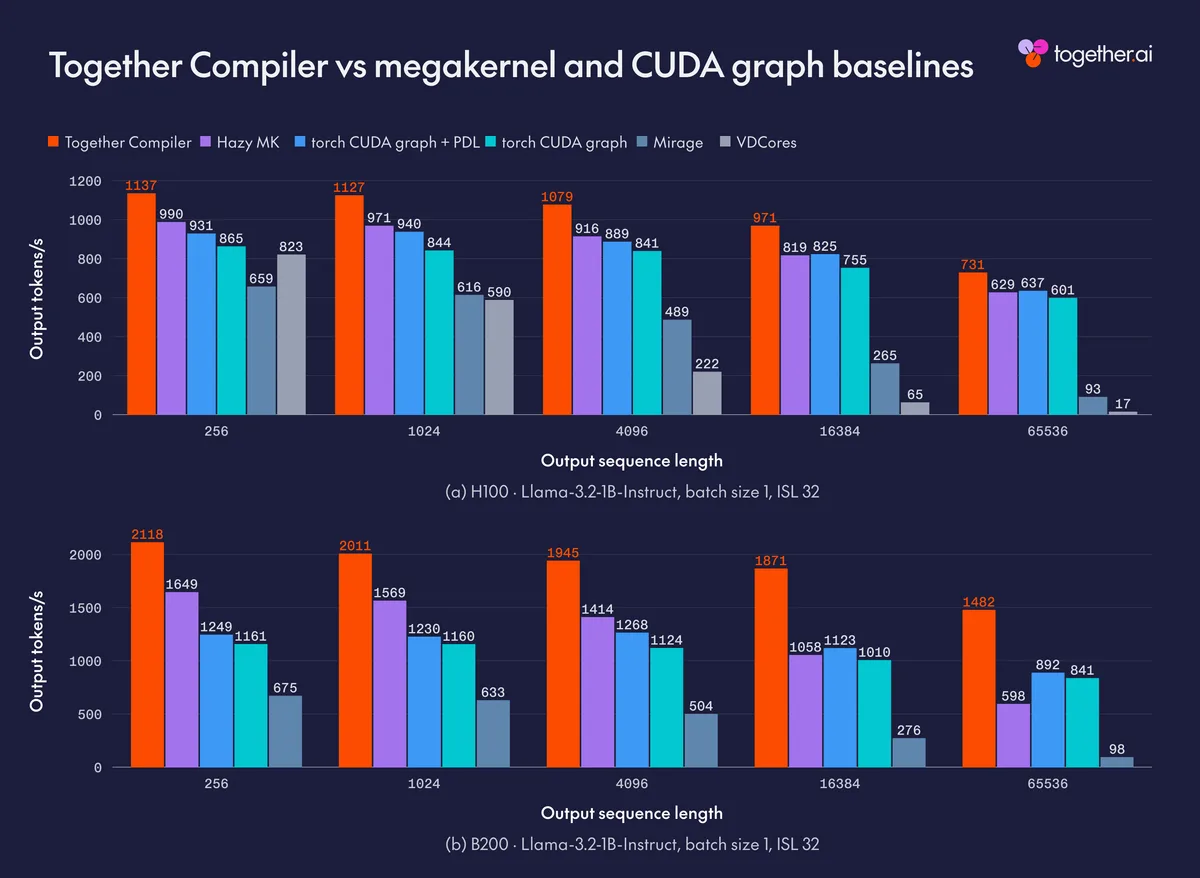
我们首先评估经典的 MegaKernel 工作负载:批大小为 1 的 Llama 1B。该模型架构已被人类专家和传统机器学习编译器充分优化。TKCC 生成的 TPS 高出 1.7 倍,并且随着序列长度增加仍保持性能。
InferenceX AgentX 工作负载
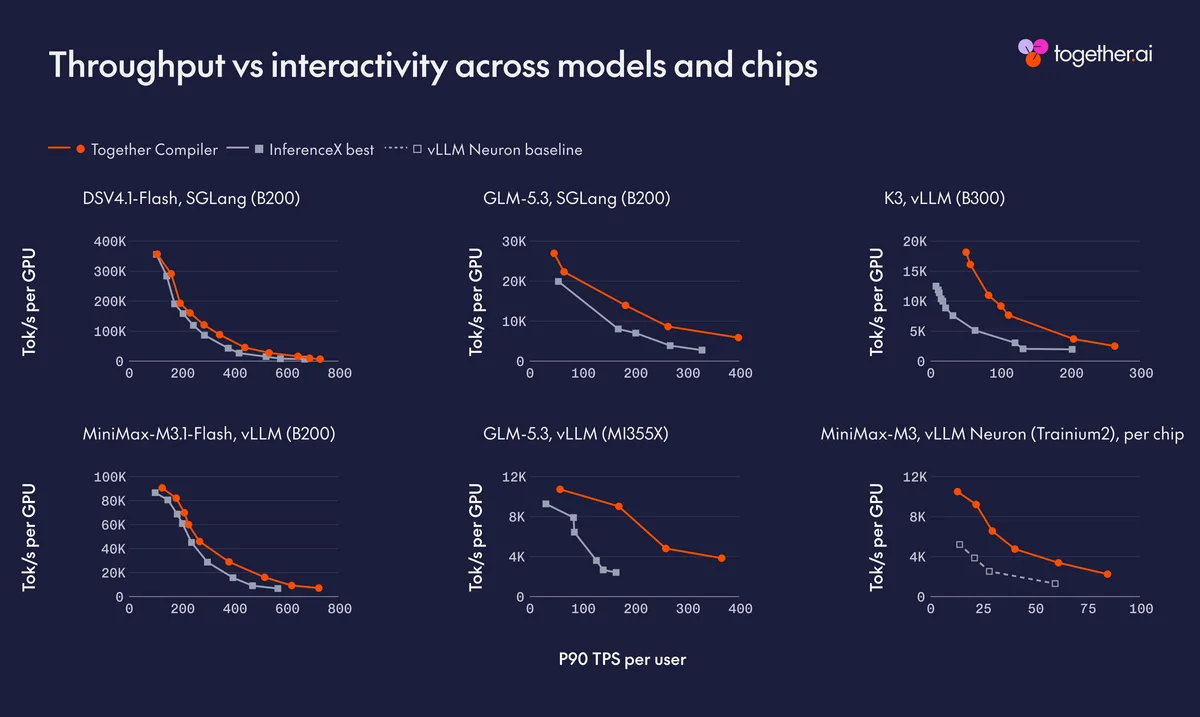
我们在 SemiAnalysis 的 AgentX 基准上评估 TKCC。我们从各推理引擎和硬件平台上前沿模型已报告的最佳开源引擎配置出发。TKCC 在所有设置下都持续刷新性能前沿,以高出 1.3-3 倍的 TPS 超越高度优化的基线。1
我们还专门评估了批大小为 1 的低延迟用例,并在 MiniMax M3.1-Flash 上以 1111 TPS、在 DeepSeek v4.1-Flash 上以 1205 TPS 达到最先进性能。对于这些结果,我们使用成本模型来选择并行配置,而非使用 InferenceX 配置。我们观察到这种方法带来了加速。
跨 AI 工作负载
我们选取了天气建模、PDE、时间序列和生物学领域的流行开源代码库。我们展示了 TKCC 相对于仅使用 Claude Code 配合 /goal 命令的几何平均加速比,说明 TKCC 的原理可跨领域泛化。我们一直将 TKCC 作为超越 LLM 推理的通用 AI 编译器使用。

多态 AI 系统是下一个前沿
对 Together AI 而言,最令人兴奋的系统挑战是 多态推理。推理不再是为单一硬件平台和模型优化单一流量形态,流量正像金融市场一样持续动态演变,而这种动态性开辟了一系列全新的研究问题。
查看我们的 论文以了解更多.
如果你对这些 AI 系统前沿感到兴奋,欢迎 联系我们!
1 Trainium2 是在合成的多轮数据集(70k ISL、3.5k 新 ISL 95% 缓存、700 OSL)上运行的,而非 AgentX,因为我们的实现尚不支持在有限的 HBM 容量上实现更高并发。