人工智能
基于 AWS 构建的智能体式对话视频智能方案借助由智能体式 AI 驱动的视频智能,你可以用自然语言对上传的视频提问,并在数秒内获得答案。媒体、安防、保险和专业服务等各行业的组织所生成的视频数量,已超出其团队能够审阅的范围。会议录像在共享网盘中不断堆积,安防摄像头拍摄了数周无人审阅的影像。现场检查视频在初次审阅后很久仍滞留在对象存储中。这些视频中的信息往往很有价值:三周前讨论过的一项设计决策、某人到达门口的确切时刻,或导致车辆碰撞的事件经过。但传统上,要获取这些信息需要人工观看数小时的内容。另一种做法是为每种特定问题类型构建定制的机器学习(ML)流水线,这需要投入大量开发工作。 每个新用例都意味着新的开发工作:
- 用于会议查询的转录流水线。
- 用于视觉搜索的计算机视觉流水线。
- 人脸匹配集成。
在本文中,我们将介绍构建视频智能解决方案的架构和关键模式,该方案可接受自然语言问题并从视频内容中返回答案。该方案采用智能体式架构,在运行时决定调用哪些 AWS 服务。对于此前已分析过的内容,响应可在 1 秒内返回。新视频的首次分析需要 5–10 分钟,具体取决于视频长度和所需服务。完整实现可在 配套 GitHub 仓库.
我们并未为每种问题类型预先构建固定流水线,而是使用 Strands Agents SDK 创建一个单一的 AI 智能体,由它根据用户的提问来编排 Amazon Bedrock, Amazon Rekognition, 以及 Amazon Transcribe 。一家大型媒体和娱乐公司在 AWS Professional Services 的参与下采用了这一方案。借助该解决方案,他们的顾问可以查询已录制的探索会议内容,提取设计决策、行动项和利益相关方的立场。结果是:基于客户内部对每段录像分析师工时的前后对比(未经独立验证),在 200 多段长达数小时的录像积压中,人工审阅时间减少了约 80%。
解决方案概览
该解决方案是一个 AI 智能体,可接受视频文件,并让用户通过自然对话即时查询其内容。用户可以上传一段 90 分钟的会议录像,并提问“这次会议做出了哪些决定?”或“有人提到预算时间表吗?”该智能体会判断是调用转录、视觉分析,还是两者兼用,然后将结果综合成连贯的答案。同一系统可处理安防录像查询(“这个人出现过吗?”)、内容分析(“总结前 30 分钟”)和调查性问题(“碰撞前哪辆车变道了?”)。无需为每个用例单独构建处理流水线。
以下截图展示了该界面,其中提供用于自然语言查询的聊天面板,以及用于文件上传和分析模式选择的侧边栏。
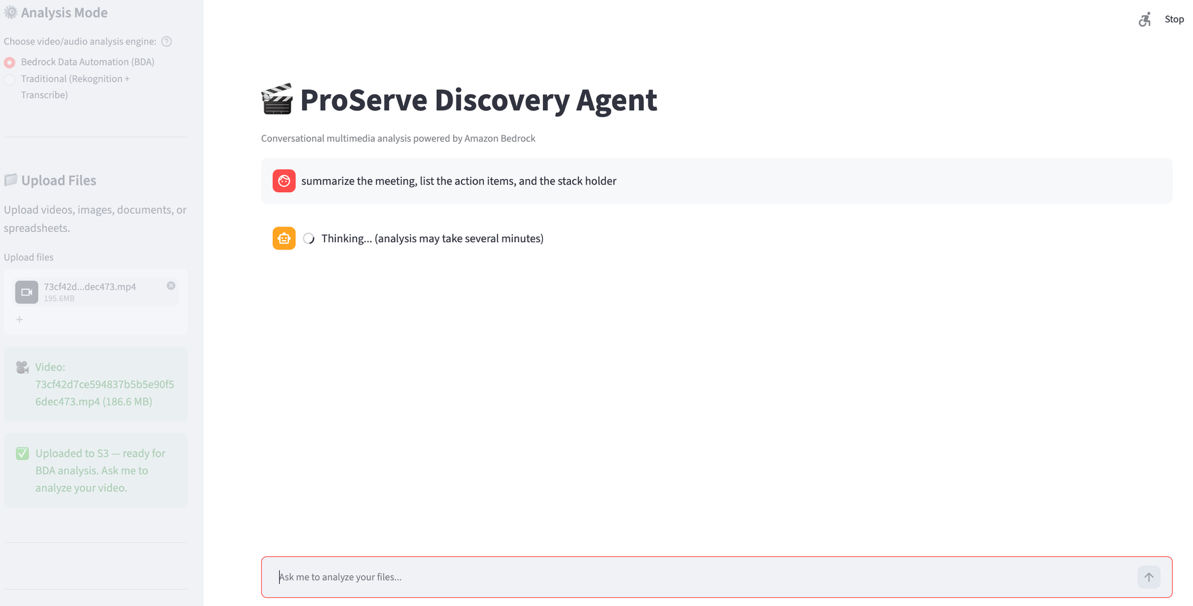
图 1:视频智能聊天界面
关键洞察在于,流水线是在运行时确定的。智能体会针对语音内容问题调用 Amazon Transcribe,针对人脸匹配转向 Amazon Rekognition,并对先前已处理内容的后续问题复用缓存结果。路由由模型处理,而非应用代码。
先决条件
要跟随本文中的实现进行操作,您需要:
- 一个可访问 Amazon Bedrock(已启用 Anthropic Claude Sonnet)和 Amazon Simple Storage Service (Amazon S3)。对于文档处理,需要 Amazon Bedrock Data Automation (BDA) 或 Amazon Rekognition 与 Amazon Transcribe。请参阅 Amazon Bedrock 中各 AWS 区域支持的模型.
- 已安装 Strands Agents SDK 的 Python 3.11 或更高版本(
pip install strands-agents strands-agents-tools). - 已配置 AWS Identity and Access Management (IAM) 权限(涵盖前文所列服务)的 AWS Command Line Interface (AWS CLI)。
- 基本熟悉 AI 智能体概念,例如工具使用和推理循环。
架构
该系统由一个智能体编排器组成,该编排器连接多个 AWS AI 服务,并由 Amazon S3 为上传的视频和缓存的分析输出提供存储。智能体编排器是推理引擎。它基于 Strands Agents SDK 构建,由 Amazon Bedrock 提供支持,使用 Claude Sonnet 或其他支持工具使用的大型语言模型 (LLM)。它接收用户的自然语言查询,根据问题决定调用哪些工具,在需要时对多个服务调用进行排序,并将结果综合为对话式响应。智能体会维护对话历史,因此后续问题可基于先前的分析继续,而无需重新处理。
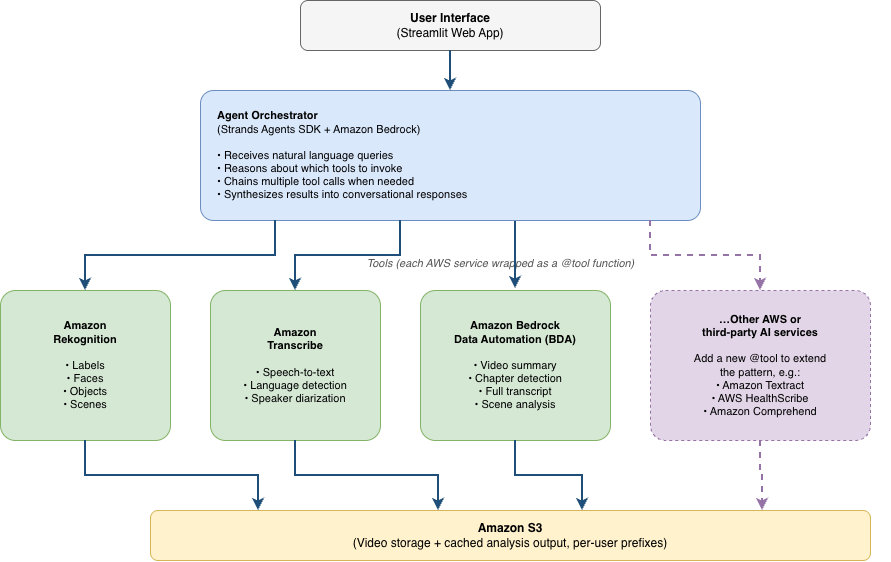
图 2:解决方案架构
Amazon Rekognition 提供视觉分析,包括检测视频帧中的对象、场景、活动和面部。当用户的问题涉及视频中可见的内容时,智能体会调用 Amazon Rekognition。Amazon Transcribe 将语音音频转换为文本,支持自动语言检测(覆盖 100 多种语言,参见 Amazon Transcribe 支持的语言)和说话人分离。当问题涉及语音内容时,智能体会使用 Transcribe。Amazon Bedrock Data Automation (BDA) 提供另一种分析路径,可在单次 API 调用中结合视频摘要、章节检测和完整转录。当用户希望一步完成全面分析,或 Amazon Rekognition 或 Transcribe 不可用时,这很有用。所有上传的视频和分析输出都存储在 Amazon S3 中,并按用户前缀实现多租户隔离。
这三项服务只是起始集合,而非固定集合。由于智能体是根据工具描述而非硬编码的工作流逻辑来选择工具,因此同一架构可以接受更多服务作为工具。我们将在 “扩展到视频之外”一节中回到这一点。对于生产部署,我们建议添加 Amazon Bedrock Guardrails,以对智能体响应实施内容过滤和依据性检查,尤其是在面部匹配和监控用例中,负责任 AI 控制至关重要。
智能体式编排如何工作
在传统的视频分析应用中,开发者定义固定的处理流水线:上传视频、运行转录、执行视觉分析、呈现结果。这种方法无论具体查询是什么,都会让每个视频经过相同的步骤,而且用户需要等待整个流水线完成后才能提问。智能体式方法颠覆了这一模式。只需进行最少的预处理(仅限于将视频文件上传到 S3 存储桶),智能体就会独立推理每个问题,并且只调用回答问题所需的服务。
当用户提交查询时,智能体首先解析意图:用户想要转录摘要、视觉搜索还是面部匹配?然后它检查相关分析是否已经执行并缓存。如果没有,它会选择合适的工具,执行这些工具(当一个工具的输出作为另一个工具的输入时,可能按顺序执行),并将结果组合成自然语言回答。在我们使用 60 分钟视频进行的测试中,关于视频的第一个问题通常需要 5–10 分钟(同时运行转录或视觉分析)。关于同一内容的后续问题会在不到一秒内返回,因为智能体会复用缓存结果。实际时间因视频长度、分辨率和所调用的 AWS 服务而异。
配置智能体
以下代码展示了完整的智能体设置。我们定义了模型提供方、用于引导智能体推理行为的系统提示,以及可用工具集。借助 Strands,整个编排逻辑(决定调用哪些工具、以何种顺序调用,以及如何组合它们的输出)由 LLM 而非应用代码处理。我们展示了两个具有代表性的工具实现(search_faces_in_video 和 analyze_with_bda)。其余工具,包括 transcribe_video 和 analyze_video_visuals,遵循相同的模式,可在 GitHub 仓库.
from strands import Agent
from strands.models.bedrock import BedrockModel
from tools import (
    transcribe_video, analyze_video_visuals,
    search_faces_in_video, analyze_reference_image,
    analyze_with_bda, upload_video
)

model = BedrockModel(
    model_id="us.anthropic.claude-sonnet-4-5-20250929-v1:0",
    max_tokens=4096
)

SYSTEM_PROMPT = """
You are a video intelligence assistant. For each user query:
1. Determine whether it requires spoken content analysis,
   visual content analysis, or both
2. Check if prior analysis results are already cached
3. Invoke the appropriate tools
4. Synthesize results into a clear answer with timestamps
"""
生产环境系统提示约有 250 行源代码。以下简化示例说明了三项具有代表性的策略(缓存复用、服务回退和多模态编排),而非逐字复现该提示:
# --- Cache management (excerpt) ---
CACHE_GUIDANCE = """
Before invoking any analysis tool, check the cache:
- Call get_cached_result(video_id, analysis_type) first
- If cached results exist and are < 24 hours old, use them
- If the user says "re-analyze" or "fresh analysis", bypass cache
- After any new analysis, store results with cache_result()

# --- Tool fallback behavior ---
If a tool call fails or returns low-confidence results:
- Transcribe failure: suggest BDA as fallback
- Rekognition low confidence (<60%): report uncertainty to user
- BDA timeout: fall back to individual Transcribe + Rekognition calls

# --- Multi-modal orchestration ---
When the query requires both audio and visual understanding:
1. Run Transcribe and Rekognition in parallel when possible
2. Correlate timestamps across modalities
3. Synthesize a unified answer referencing both sources
4. Cite specific timestamps for each claim
"""

agent = Agent(
    model=model,
    system_prompt=SYSTEM_PROMPT,
    tools=[transcribe_video, analyze_video_visuals,
           search_faces_in_video, analyze_reference_image,
           analyze_with_bda, upload_video]
)
生产提示的其余部分列出了可用工具,并定义了以下工作流:文件选择、缓存复用与显式重新分析、BDA 设置与访问被拒回退、参考图像搜索、转录与字幕、体育精彩片段、架构图,以及在 BDA 与特定服务分析之间进行选择。它还统一了多文件响应格式,要求在清理前进行确认,对后续问题复用先前结果,并应用范围与上传进度防护措施。
在这种配置下,智能体自主处理路由、工具调用顺序和响应合成。添加新能力(例如检测屏幕上的文本)只需定义一个新的工具函数并将其添加到工具列表中。无需更改工作流逻辑。
使用 @tool 装饰器定义工具
每个 AWS 服务都以 Python 函数的形式暴露给智能体,这些函数使用 @tool进行装饰。函数签名定义了参数,而文档字符串则告诉智能体何时以及如何使用该工具。这个文档字符串至关重要:它充当智能体使用该工具的说明书。以下示例展示了封装 Amazon Rekognition 的人脸搜索工具:
from strands.tools import tool
import boto3

@tool
def search_faces_in_video(
    video_s3_key: str,
    collection_id: str,
    confidence_threshold: float = 80.0
) -> dict:
    """Search for a specific person in video footage.

    Use this tool when the user provides a reference photo
    and asks whether that person appears in a video.
    Requires a face collection created first via
    analyze_reference_image.

    Args:
        video_s3_key: S3 key of the uploaded video
        collection_id: Rekognition collection with the
            indexed reference face
        confidence_threshold: Minimum confidence for a
            match (default 80%)

    Returns:
        Dict with matched_faces containing timestamps
        and confidence scores for each appearance
    """
    rek = boto3.client("rekognition")
    response = rek.start_face_search(
        Video={"S3Object": {
            "Bucket": BUCKET, "Name": video_s3_key}},
        CollectionId=collection_id,
        FaceMatchThreshold=confidence_threshold
    )
    job_id = response["JobId"]
    # Poll for completion and collect results...
    return {"matched_faces": matches}
以下示例展示了 BDA 工具,它通过一次 API 调用提供全面的视频分析(摘要、章节和转录):
@tool
def analyze_with_bda(
    s3_uri: str,
    analysis_types: list[str] = ["SUMMARY", "CHAPTERS", "TRANSCRIPT"]
) -> dict:
    """Perform comprehensive video analysis using Amazon Bedrock Data Automation.

    Use this tool when the user wants a full video summary, chapter
    breakdown, or complete transcript, or when Rekognition/Transcribe
    are unavailable. Returns all requested analysis types in one call.

    Args:
        s3_uri: S3 URI of the uploaded video (s3://amzn-s3-demo-bucket/key)
        analysis_types: List of analysis types to perform.
            Options: "SUMMARY", "CHAPTERS", "TRANSCRIPT", "IAB"

    Returns:
        Dict with keys for each requested analysis type,
        including timestamps and confidence scores
    """
    bda = boto3.client("bedrock-data-automation-runtime")
    response = bda.invoke_data_automation_async(
        inputConfiguration={"s3Uri": s3_uri},
        dataAutomationConfiguration={
            "dataAutomationArn": BDA_PROJECT_ARN
        },
        outputConfiguration={"s3Uri": f"s3://{BUCKET}/bda-output/"}
    )
    invocation_arn = response["invocationArn"]
    # Poll for completion...
    result = poll_bda_result(invocation_arn)
    return {
        "summary": result.get("summary"),
        "chapters": result.get("chapters", []),
        "transcript": result.get("transcript")
    }
多步推理实战
为了说明智能体如何串联多个工具调用,假设一位用户上传了一张参考照片并问道:“这个人是否出现在我的监控录像中?”智能体必须首先对参考人脸建立索引,然后在视频中搜索它。这是两个相互依赖的顺序操作。以下跟踪记录展示了智能体的内部推理过程:
[Think] This is a face-matching query. I need to index
the reference photo first, then search the video.

[Act] analyze_reference_image(image="reference.jpg")
[Observe] {"faces_detected": 1, "face_id": "face_001",
"confidence": 99.8}

[Think] Face indexed. Now searching the video.

[Act] search_faces_in_video(
video_s3_key="security_cam_july5.mp4",
collection_id="user_collection")
[Observe] {"matched_faces": [
{"timestamp": "00:14:32", "confidence": 97.2},
{"timestamp": "00:47:15", "confidence": 94.8}]}

[Response] Yes, the person appeared twice: at 14:32
(97% confidence) and 47:15 (95% confidence).
智能体确定了正确的操作顺序,并处理了它们之间的依赖关系(人脸搜索需要一个已建立索引的集合)。然后它以对话方式呈现了结果。没有任何应用代码定义这一顺序。模型是根据工具描述和用户的问题推理得出的。
对于全面分析(当用户要求“分析这段视频”或“总结这段录像”时),智能体可以调用 Amazon Bedrock Data Automation(BDA),而不是分别调用 Amazon Rekognition 和 Transcribe。BDA 通过一次异步 API 调用即可生成视频摘要、带时间戳的逐章分解以及完整转录文本:
[Think] The user wants a full summary. BDA provides summary +
chapters + transcript in one call, more efficient than
running Rekognition and Transcribe separately.

[Act] analyze_with_bda(s3_uri="s3://amzn-s3-demo-bucket/meeting.mp4")
[Observe] {"summary": "Team discussed Q3 roadmap...",
"chapters": [{"title": "Introductions", "start": "00:00"},
{"title": "Roadmap Review", "start": "05:32"}, ...],
"transcript": "Welcome everyone. Let's start with..."}

[Response] Here's the meeting summary with chapters:
Summary
The team discussed the Q3 roadmap...
Chapters
- 00:00 - Introductions
当结果存在歧义时,智能体会明确表达不确定性。处于临界值的置信度分数(例如 62%)会生成有保留的回答:“我在 14:32 发现了一个可能的匹配,但置信度较低,因此你可能需要手动核实。”如果因音频质量差导致转录失败,智能体会建议替代方案:“音频质量过低,无法进行可靠的转录。你是否希望我改为尝试对演示幻灯片进行视觉分析?”
示例用例
这种智能体模式广泛适用于以下场景:用户需要从视频内容中提取特定信息,但事先并不知道需要哪种分析类型。
会议情报 – 一位中途加入项目的团队成员上传了此前的会议录像并提出有针对性的问题:“四月份做出了哪些架构决策?”、“团队何时同意使用 GraphQL?”或“总结关于身份验证方法的讨论。”智能体进行转录、搜索和总结,返回带有时间戳的答案,并引用录像中的具体时刻。
安全与出入监控 – 一位楼宇管理员上传了大堂摄像头的录像以及一张预期访客的照片,并问道:“这个人本周进入过这栋楼吗?什么时候?”智能体对视频进行人脸匹配,并返回带有置信度分数的具体时间戳。
理赔调查—— 一名保险理算员上传行车记录仪视频并问道“描述碰撞前的事件经过”或“哪辆车在错误的车道上?”智能体将视觉场景分析与音频(口头反应、喇叭声)结合起来,重建事件时间线。
以稳定的工具契约扩展到视频之外
上述三个示例都在分析视频,但该架构中没有任何部分是视频专用的。智能体根据工具的文档字符串来选择工具,因此添加新能力(或全新的模态)只需将另一个服务封装为 @tool 函数并描述何时使用它。无需更改工作流逻辑。同一个编排器、缓存和按用户隔离机制均原样适用。
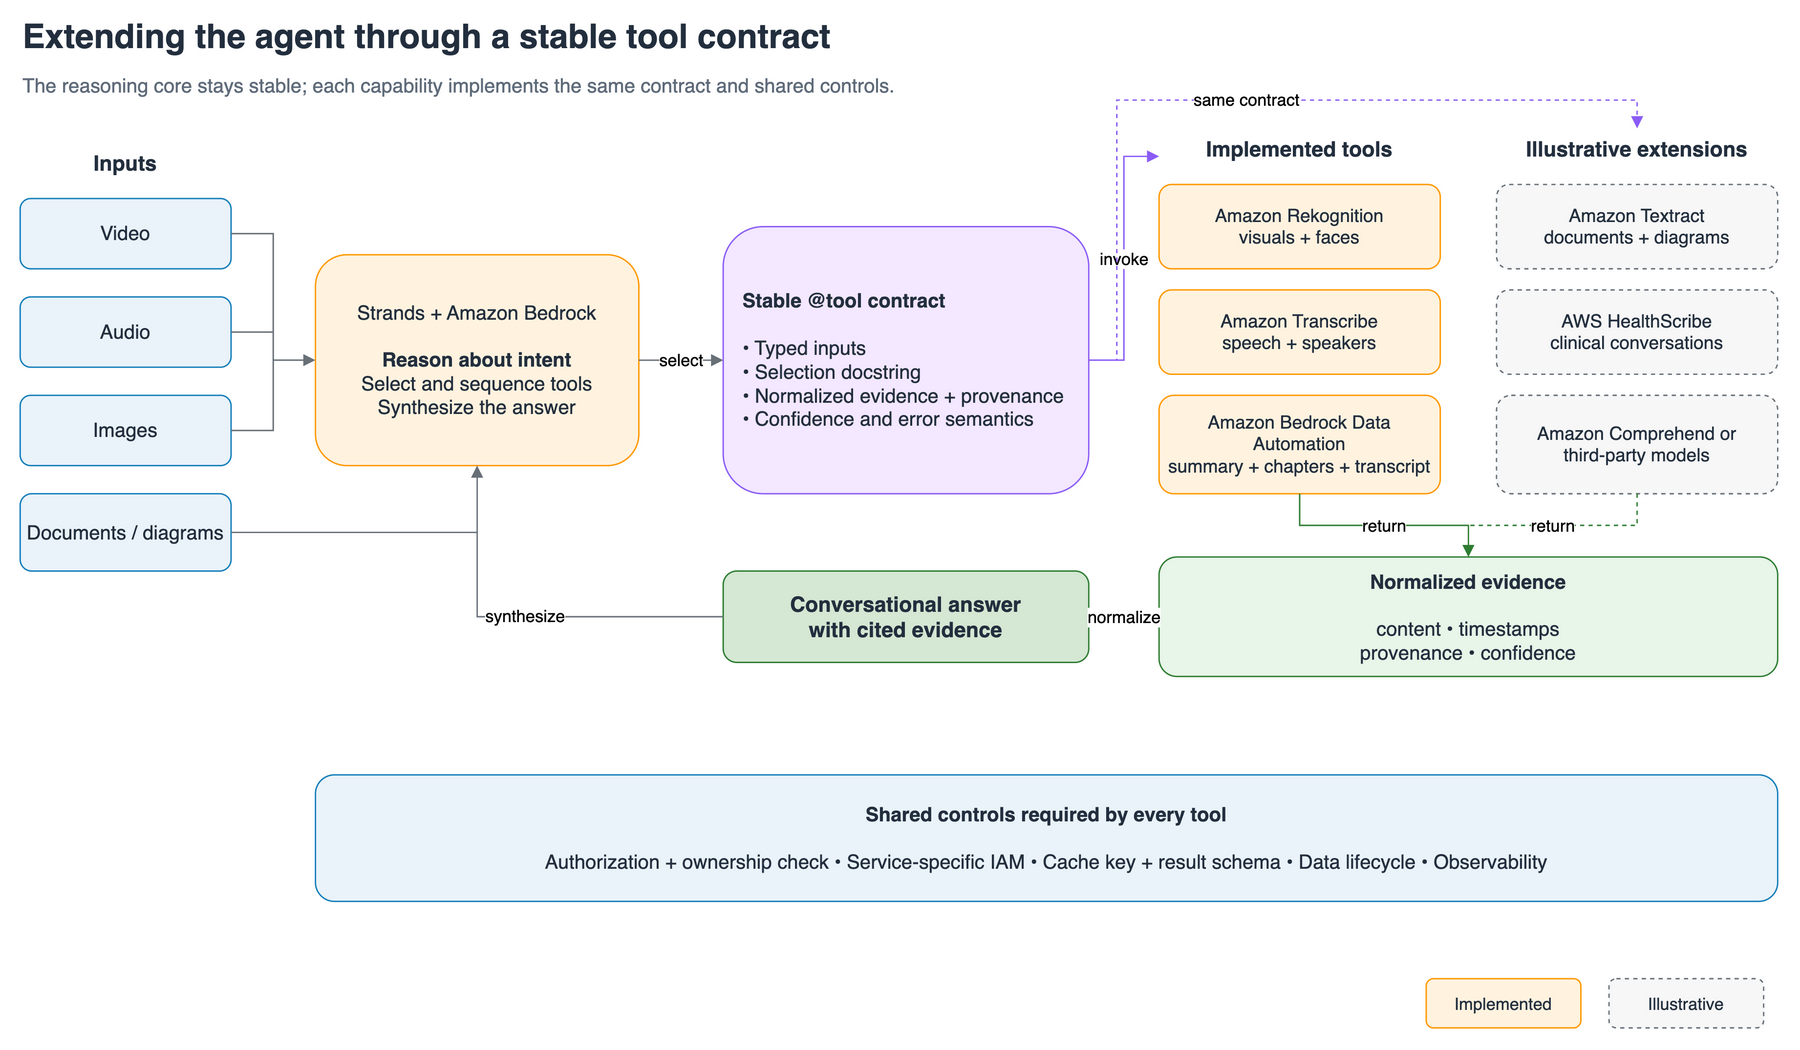
图 3:将该模式扩展到其他模态
这使得该模式成为多模态 AI 助手的通用模板,既可使用 AWS 服务,也可使用第三方模型:
- 使用 Amazon Textract 进行文档和图表理解。 发现会话很少只存在于视频中。添加一个 Textract 工具,从以 PDF 形式提供的架构图和工作文档中提取文本、表格和表单字段,智能体就能将白板上绘制的内容与录音中所说的内容进行交叉比对。这丰富了同一个对话会话,而该会话已经能够回答关于会议音频的问题。
- 使用 AWS HealthScribe 的临床对话。 将同样的模式应用于临床医生与患者的音频文件,HealthScribe 工具会返回结构化的临床记录(逐轮转录加上提取的章节,如主诉和治疗计划),因此用户可以针对录音提问“建议了哪些随访?”。
- 实体和情感提取,或第三方模型。 Amazon Comprehend 工具可以从智能体生成的任何转录文本中提取实体、关键短语和个人身份信息(PII)。Amazon Bedrock 上可用的模型(包括第三方模型)也可以以同样的方式封装,用于特定领域的推理。
在每种情况下,扩展点都是工具契约,而不是流水线。已经构建了视频助手的团队已经拥有脚手架(编排、缓存、身份验证和按用户隔离),只需添加工具即可为不同模态搭建 AI 助手。
成本考量
每次查询的成本取决于智能体调用了哪些 AWS 服务。在初始分析(转录或视觉处理)之后,关于同一视频的后续问题只会产生 Amazon Bedrock 推理成本,因为结果已被缓存。下表显示了 60 分钟视频的大致成本:
| 服务 | 操作 | 大致成本 |
| Amazon Transcribe | 60 分钟音频转录 | $1.44 |
| Amazon Rekognition | 人脸搜索(60 分钟视频) | $6.00* |
| Amazon Rekognition | 标签检测(60 分钟视频) | $6.00* |
| Amazon Bedrock | 智能体推理(每轮) | $0.05–$0.15 |
| Amazon S3 | 存储(500 MB,24 小时) | <$0.01 |
$6.00 的 Amazon Rekognition 费用是每个视频的一次性费用(后续查询仅产生 Bedrock 推理费用)。
根据截至 2025 年 7 月的 AWS 服务定价以及前面的成本表,对一段 60 分钟视频进行典型的基于转录文本的查询,初始转录费用约为 $1.50,外加 Bedrock 推理费用。针对同一转录内容的后续提问每轮仅需 $0.05–$0.15,仅涵盖 Bedrock 推理调用。实际费用取决于模型选择、输入长度和 AWS 区域。如需了解当前定价,请参阅 Amazon Bedrock 定价, Amazon Transcribe 定价,以及 Amazon Rekognition 定价.
部署
该解决方案部署在 Amazon Elastic Container Service(Amazon ECS)上,并使用 AWS Fargate。Streamlit 应用程序和智能体运行时在 Fargate 任务中运行,位于内部 Application Load Balancer 之后,Amazon CloudFront 分发是唯一的公共入口点。CloudFront 通过虚拟私有云(VPC)源站访问负载均衡器,因此负载均衡器保持在私有子网中,没有通往互联网网关的路由,也无法从互联网直接访问。CloudFront 还使用其默认的 *.cloudfront.net 证书终止查看器 TLS,从而提供公开受信任的 HTTPS 端点,无需自定义域名或 AWS Certificate Manager 证书。 Amazon Cognito 负责身份验证(仅限邀请,默认通过基于时间的一次性密码(TOTP)强制执行多因素身份验证(MFA)),上传内容和缓存的输出存储在 Amazon S3 中,按用户前缀划分,并采用 24 小时生命周期策略。
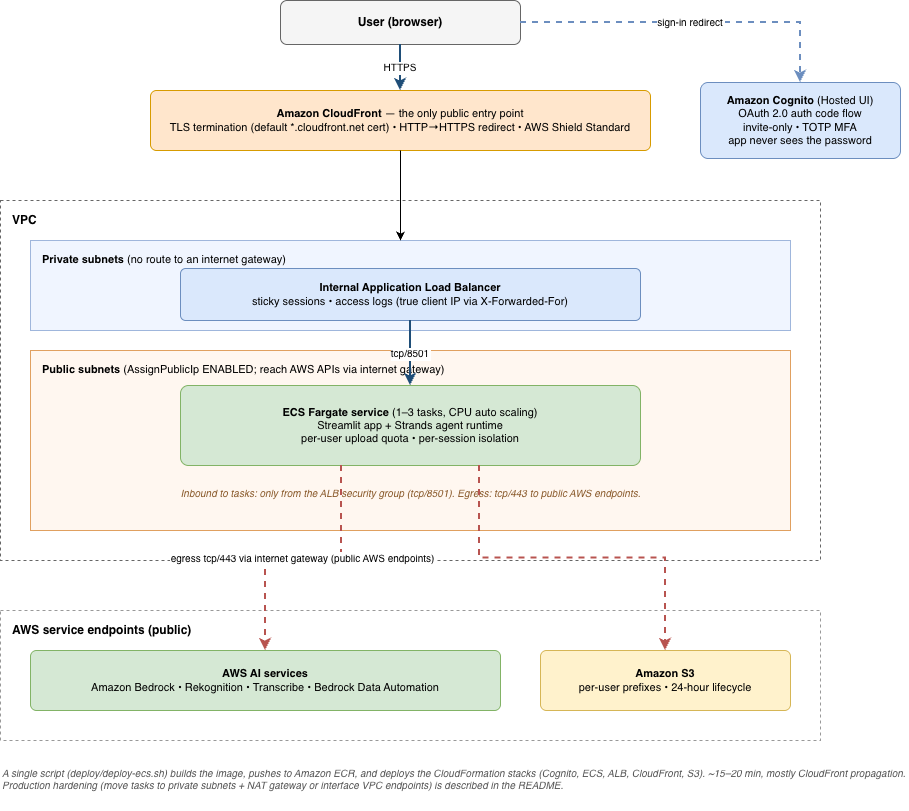
图 4:Amazon ECS 和 AWS Fargate 上的部署架构
单个脚本(./deploy/deploy-ecs.sh)构建容器镜像,将其推送至 Amazon Elastic Container Registry(Amazon ECR),并部署 AWS CloudFormation 堆栈。部署通常在 15–20 分钟内完成,其中大部分时间用于 CloudFront 传播。完整的部署先决条件、 AllowSelfSignup 参数及其权衡取舍,以及分步操作说明均见仓库 README。
开发工作流
Kiro 是一个由 AI 驱动的开发环境,它通过将高层想法转化为结构化的需求、设计和实现任务,支持规范驱动的软件开发。我们利用其规范工作流、持久化项目上下文和智能体钩子,从概念推进到可部署的示例,同时在每项能力逐步成型的过程中将安全性融入其中。
规范在实现之前定义了每项能力。 人脸匹配规范定义了输入(参考照片加视频)、预期行为(索引人脸、搜索并返回时间戳)以及边缘情况(未检测到人脸、低置信度匹配)。转录规范涵盖了多语言检测、说话人分离以及重复查询的缓存行为。Kiro 根据每份规范生成实现任务,并在整个功能生命周期中保持上下文。基于团队此前构建类似集成的经验,这将他们估计通常需要数周的工作压缩为一个专注的冲刺。
威胁建模与规范同步进行,而非在其之后。 在每项能力被规范定义时,我们对其可能如何被滥用进行了建模,并将结果记录在持续更新的威胁模型中(见 docs/threat-model.md (见配套仓库)。该模型梳理了具体的攻击链(身份验证绕过、网络暴露、通过提示注入利用智能体、过度授权的 IAM 以及审计规避),并为每种威胁指定了处置方式。在示例中,所有严重和高危发现均已修复。仍未关闭的事项均记录在案,并附有明确决定(接受残余风险,或记录在案的生产环境变更)。下一节所述的控制措施是该流程的产出,而非事后补充。
安全扫描已嵌入开发循环。 Kiro Hooks 在变更落地时对其运行自动化静态扫描和基础设施即代码扫描,所用工具包括 Automated Security Helper(ASH),并且容器镜像仓库在创建时即启用推送时扫描。发现的问题会作为任务返回到产出该功能的同一工作流中,因此配置错误在代码编写过程中就会暴露,而不是留到最后的单独审查环节。最终效果是形成左移的安全姿态:单个小型团队在同一工作流中兼顾功能交付速度与安全严谨性,安全设计成为默认路径,而非额外的关卡。
安全考量
视频通常包含敏感的业务讨论和可识别的人物,因此多用户部署必须控制访问、隔离每位用户的数据,并限制任何单个用户行为的影响范围。
参考部署实现了四项主要控制措施:
- 仅限邀请的 Amazon Cognito 账户,并强制启用 MFA。
- 按用户划分的 Amazon S3 前缀,在每个工具边界处通过所有权验证强制执行。
- 一个仅通过 CloudFront 暴露的内部 Application Load Balancer。
- 按用户设置的上传配额,用于限制跨租户的资源耗尽。
生产部署仍应决定是否使用具有更严格查看器 TLS 策略的自定义域名、附加 AWS WAF、扩展审计日志记录和监控,并为人脸集合、转录文本和跨区域 Amazon Bedrock 模型推理定义数据处理要求。请与您的法律和隐私团队合作,确定适用的同意、保留、删除和驻留要求。有关逐项控制的完整分析、已接受的残余风险、攻击链和加固检查清单,请参阅 docs/threat-model.md 以及配套仓库 README 中的“生产环境安全考量”。
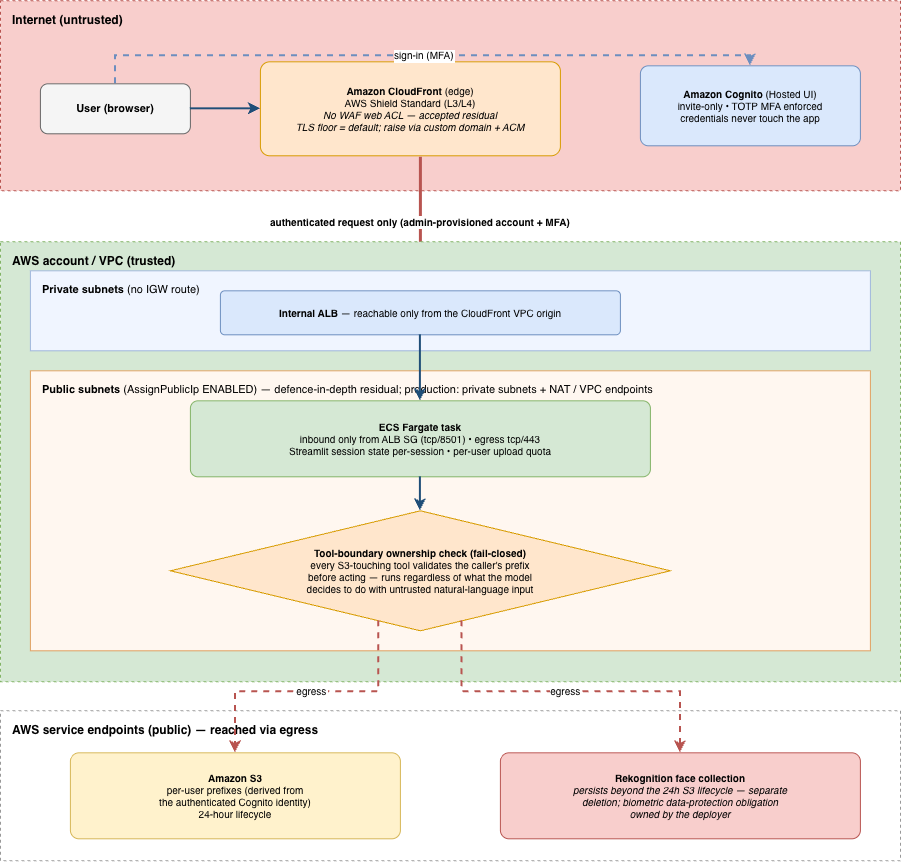
图 5:参考部署中的安全控制措施
当前限制
时长超过两到三小时的视频需要数分钟才能完成初始转录,不过后续查询可从缓存中近乎即时地返回。人脸匹配的准确性取决于参考照片的质量。清晰、光线充足的图像效果最佳,而从合影中裁剪出的模糊图像可能会产生较低的置信度。在背景噪声严重或说话人重叠的情况下,转录准确性会下降。当智能体检测到质量问题时,会提示这一点。Web 界面接受最大 2 GB 的 MP4、MOV、AVI 和 MKV 文件,这一限制被有意设定为低于 Fargate 任务的内存,因为 Streamlit 会在内存中缓冲上传内容。对于更大的媒体文件,请直接上传到您的用户前缀下的 Amazon S3,并让智能体按 URI 分析该对象(BDA 接受最大 10 GB 的视频对象)。 并发容量受任务临时存储和每用户配额的限制(在默认设置下,每个任务大约支持六个并发用户),并且自动扩缩容会在 CPU 负载下增加任务。
清理
如果您部署了此解决方案且不再需要它,请删除已预置的资源以避免持续产生费用。拆除涉及三个 CloudFormation 堆栈,它们通过参数值而非跨堆栈导出来连接,因此 CloudFormation 不会强制其依赖顺序。清空 S3 存储桶后,请按以下顺序删除堆栈:(1) video-analytic-agent-ecs (应用程序)、(2) video-analytic-cognito (身份)和 (3) video-object-locator-infra (存储)。这些模板还会遗留 Amazon ECR 存储库和镜像,并且 AWS Key Management Service(AWS KMS)密钥仍处于待删除计划中。
Amazon Rekognition 人脸集合需要单独清理。应用程序在运行时创建它们,因此 CloudFormation 并不拥有它们,而且它们独立于视频存储桶的 24 小时 S3 生命周期而持续存在。删除已上传的对象或堆栈并不会删除已索引的人脸。请显式列出并删除每个集合。完整的拆除顺序(包括先清空带版本的 S3 存储桶)见仓库 README 中的“拆除/清理”部分。
结论
在本文中,我们展示了使用 Strands Agents SDK、Amazon Bedrock、Amazon Rekognition 和 Amazon Transcribe 构建对话式视频智能解决方案的架构和关键模式。借助这种智能体式架构,您不再需要为每种问题类型预先构建处理管道。相反,单个智能体会根据用户的自然语言查询,在运行时推理应调用哪些服务。添加新功能只需新增一个 @tool 函数和提示更新,而不是新的管道。
要将此模式应用于您自己的用例,首先请配置一个以 Bedrock 作为模型提供方的 Strands 智能体,并将每个相关的 AWS 服务封装为带有描述性文档字符串的工具函数。然后定义一个系统提示,引导您所在领域的推理,并部署到 ECS Fargate 以便访问,或在本地运行以进行原型开发。完整的源代码、部署自动化以及所有工具实现均可在 配套的 GitHub 仓库.
要详细了解此解决方案中使用的服务,请访问:
如需相关阅读,请参阅 隆重推出 Strands Agents,一个开源 AI 智能体 SDK 在 AWS 机器学习博客上。