人工智能
宣布推出 SOCI 索引镜像,加速 SageMaker AI 作业你的深度学习容器镜像每花一分钟下载,就是你付费的一分钟,也是你的团队等待的一分钟。容器镜像下载是纯粹的开销:可计费的作业时间,却不产生任何模型进展。对于现代深度学习镜像,这一开销在每一个作业上都要耗费数分钟。今天,我们很高兴宣布为 Amazon SageMaker AI Training 和 Amazon SageMaker AI 处理作业推出 可寻址 OCI(SOCI)索引, 它将完整的容器镜像下载从每个作业的关键路径上移除。
借助 SOCI 索引,SageMaker AI 会懒加载你的容器镜像。它只获取启动容器所需的文件,并在你的代码运行的同时在后台流式传输其余部分,因此你的作业只需数秒即可开始,而不是数分钟。你只需指向预先建立索引的 AWS 深度学习容器(DLC),或为自己的镜像添加索引即可采用。这两种方式都不需要更改你的作业定义、入口点或数据通道。结果是作业启动更快、作业成本更低,并有更多时间用于构建模型,而不是等待基础设施。
SOCI 索引镜像可在数秒内启动 Amazon SageMaker AI 训练容器,且不影响训练性能。正如我们在 我们测量的结果 一节中所展示的,在我们的基准测试中,这将镜像拉取期间的 GPU 空闲时间最多减少了 90%。
本文介绍如何采用 SOCI 索引:它是什么、我们测量的结果,以及如何为你自己的作业启用它。
挑战SageMaker AI 训练和处理作业在存储于 Amazon Elastic Container Registry(Amazon ECR)的容器镜像内运行。在作业能够执行你的代码之前,服务会将整个镜像下载到实例上。它会解压每个层并将其写入磁盘。
对于小镜像,这只需数秒。但深度学习镜像通常超过 10 GB 甚至更大。这一下载会为每个作业增加数分钟,而你还要将其作为作业时间付费。影响最大的恰恰是迭代速度最重要的地方:涉及数百个作业的超参数调优扫描、快速实验以及短时处理作业,在这些场景中镜像下载可能占据总运行时间的大部分。
SOCI 索引的工作原理可寻址 OCI(SOCI) 是一项懒加载容器镜像的开源技术。运行时不会在启动前下载整个镜像,而是使用 SOCI 索引仅获取立即启动容器所需的文件。然后,当你的代码访问其余文件时,它在后台流式传输这些文件。
SOCI 索引是映射镜像内每个文件的元数据。你将其作为符合 OCI 规范的工件存储在 Amazon ECR 中,并链接到你的原始镜像。由于索引是独立的工件,你的镜像摘要和任何现有签名都保持有效。
SageMaker AI 会自动检查索引
当你创建训练或处理作业时,SageMaker AI 会检查你指定的镜像是否具有 SOCI 索引,并据此采取相应行为:
| 场景 | 会发生什么 |
| 镜像包含 SOCI 索引 | SageMaker AI 会懒加载镜像,并在完整下载完成之前启动你的容器 |
| 镜像没有 SOCI 索引 | 标准下载,行为不变 |
| 索引无法读取,或懒加载未成功 | 作业回退到标准下载并继续运行 |
由于作业在需要时总会回退到标准下载,添加 SOCI 索引绝不会阻止你的作业运行。你只会获得更快的启动速度。你绝不会冒破坏现有工作流的风险。
我们测量的结果我们在真实的 SageMaker AI 训练作业上以两种方式拉取相同的容器镜像:标准下载和 SOCI 索引懒加载。然后我们从两者运行完整的训练作业,以测量对训练速度的影响。
设置
- 八个镜像, 压缩后 1.8–35.4 GB。
- GPU 和 CPU 实例 ml.g4dn、ml.g5、ml.g6、ml.g6e、ml.g7、ml.g7e、ml.p4d、ml.p5 和 ml.m7i,从 xlarge 到 48xlarge,位于美国西部(俄勒冈)区域(us-west-2)和美国东部(弗吉尼亚北部)区域(us-east-1)。
- 下载时间 从镜像拉取开始测量,直到容器准备好运行。所有数据均为重复运行的中位数。
结果 1:在每种镜像大小下,下载时间都从数分钟降至数秒
| 镜像大小(压缩后) | 标准下载 | 懒加载 | 提升 |
| 1.8 GB | 48 秒 | 3-11 秒 | ~8x |
| 13.2 GB | 3 分 42 秒 | ~6 秒 | ~34x |
| 35.4 GB | 7 分 17 秒 | 3-11 秒 | ~38x |
下图比较了八个镜像大小(从 1.8 GB 到 35.4 GB)下标准 Docker 拉取与 SOCI 懒加载的容器镜像下载时间。
每个镜像大小显示两个条形。Docker 下载时间条形(蓝色)随镜像大小稳步增长,从 1.8 GB 时的 48 秒增长到 35.4 GB 时的 7 分 17 秒。
每对条形上方的加速标签显示了 Docker 时间与 SOCI 时间的比率。加速范围从最小镜像的约 10x 到最大镜像的超过 35x。
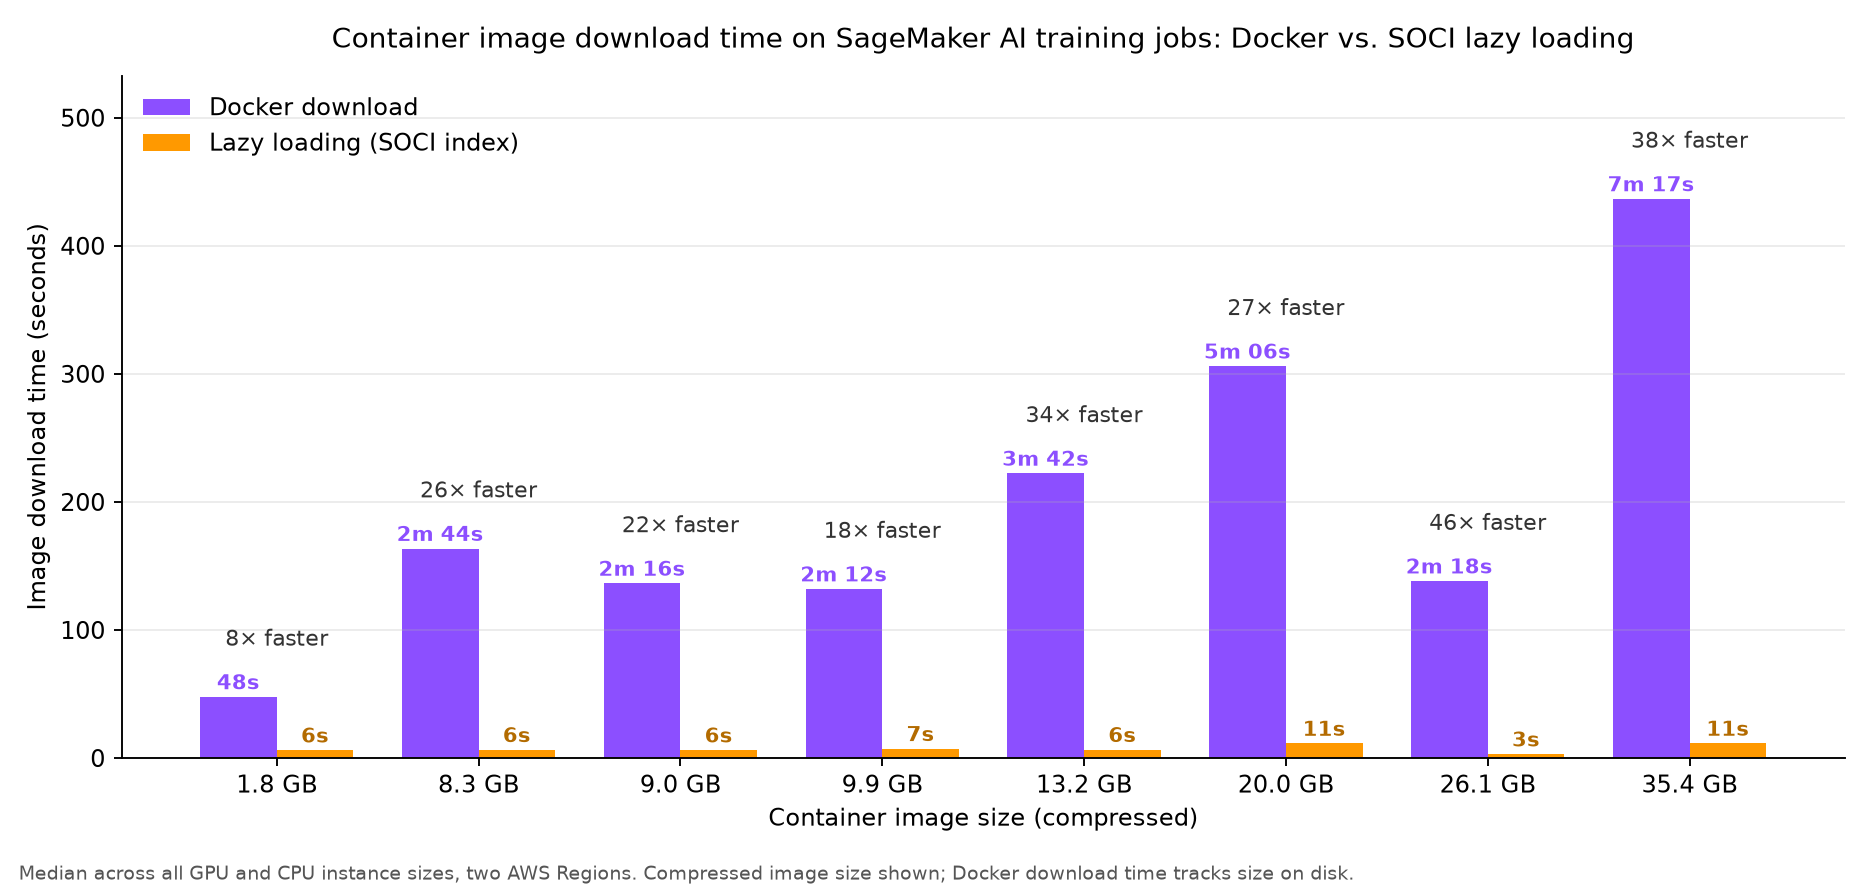
图 1:八个镜像大小下标准 Docker 拉取与 SOCI 懒加载的容器镜像下载时间对比
标准下载时间随镜像大小增长,因为每个文件都会被解压并写入。懒加载无论大小都保持在 3–11 秒,提升了 8x–46x。镜像越大,你节省的分钟数越多。
结果 2:这一节省在每种实例类型和大小上都成立
在 13 种实例类型/大小组合上运行 13.2 GB 镜像时,标准下载范围为 3 分 16 秒到 4 分 20 秒,而懒加载保持在 6-8 秒。这在每种配置上都约快 34x。你无需更改实例类型或大小即可受益。
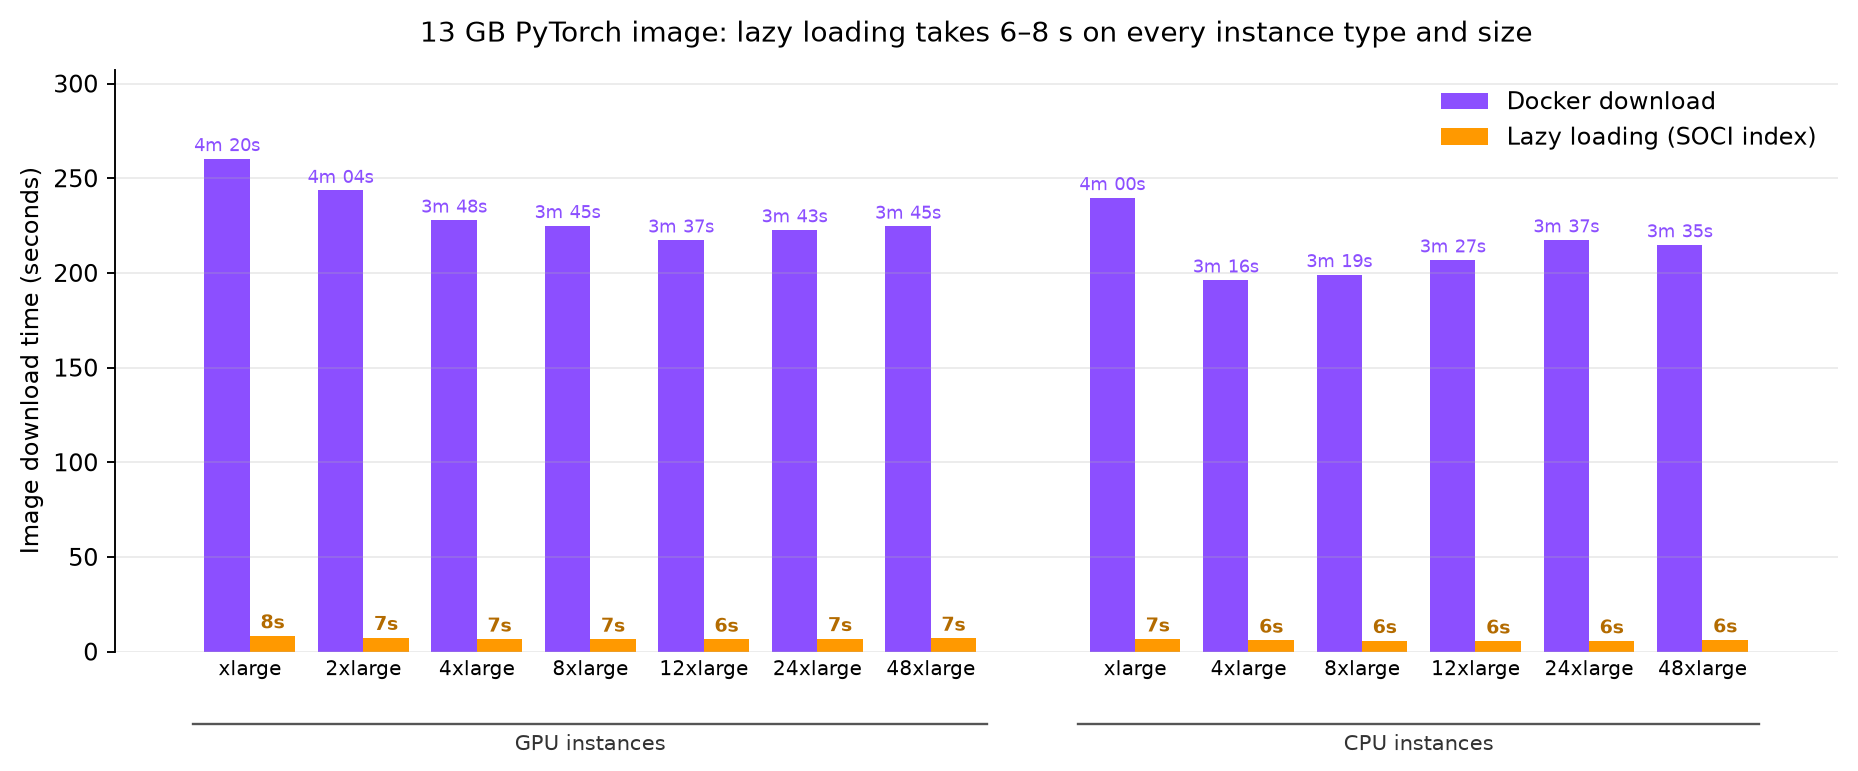
图 2:13 种实例类型和大小组合下 13.2 GB 镜像的下载时间
结果 3:除第一个 epoch 的代价外,训练性能不受影响
我们从 Docker 拉取的镜像和 SOCI 索引镜像运行了两种完整的训练作业,并比较了每个 epoch:
- 在 Imagenette (9,469 张图像)上使用 ResNet-50 进行图像分类
- 容器镜像:PyTorch(13.2 GB DLC)和 TensorFlow(9.9 GB DLC)
- 实例:ml.p5.48xlarge、ml.p4d.24xlarge、ml.g7e.48xlarge、ml.g7.48xlarge、ml.g6e.12xlarge、ml.g6e.24xlarge 和 ml.g6e.48xlarge。
- 大语言模型(LLM)微调:使用 Hugging Face Trainer 在 Qwen2.5-0.5B 上对 alpaca-cleaned (51,760 个示例)进行全参数监督微调(SFT)。
- 容器镜像:9.4 GB Hugging Face PyTorch DLC。
- 实例:ml.p5.48xlarge、ml.p4d.24xlarge、ml.g6.48xlarge。
下图将作业启动拆分为镜像下载时间和首个训练 epoch 时间,并在 GPU 和 CPU 配置下针对两种工作负载,对比标准 Docker 拉取与 SOCI 索引镜像。
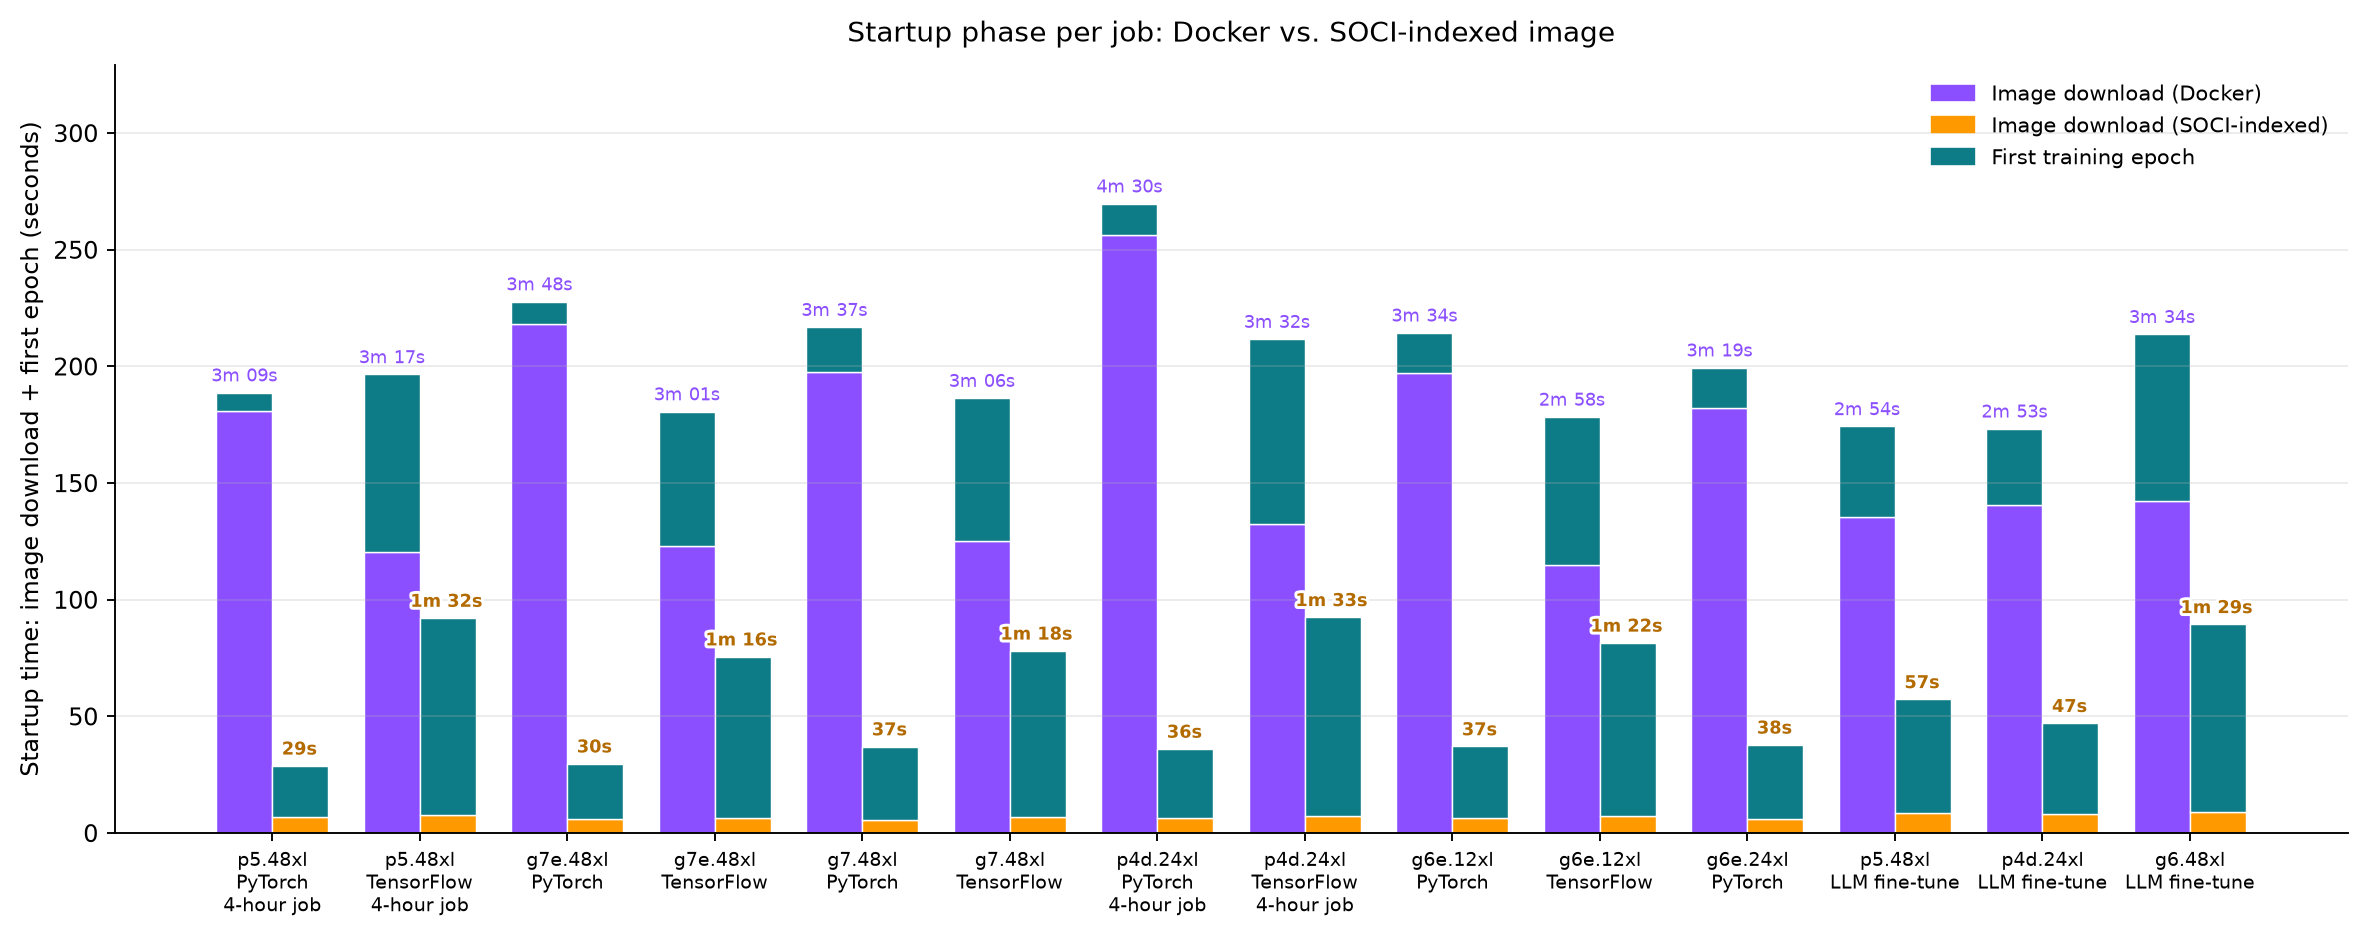
图 3:作业启动拆分为镜像下载时间和首个训练 epoch 时间,标准 Docker 拉取与 SOCI 索引镜像对比
- 从第二个 epoch 起,在每种实例上、两种工作负载下,每个 epoch 的耗时都相同(在运行间波动范围内)。
- 首个 epoch 因懒加载镜像而多花 3–16 秒,同时框架首次访问的文件会被拉取。这一首 epoch 代价在每种实例规格上都相同。
- 净效果:每个作业提前 1-6 分钟完成。这是下载节省的时间减去一次性的首 epoch 代价,即每个作业的固定节省。
在你自己的工作负载上测试
这些数字来自前面描述的两种工作负载。首 epoch 代价取决于你的镜像以及代码在启动时访问的内容:
- 当第一个训练步骤只需要镜像的一小部分时,懒加载占优,其余部分在你训练时流式加载。
- 如果你的入口点在训练开始前读取了大部分镜像内容(例如扫描、校验和或预加载其内容),那么第一个 epoch 将等待与完整拉取大致相同的字节数。净提升会很小。
- 在我们的测试中,前置加载的启动方式仍然胜出:
- torch.compile 和即时(JIT)构建的 CUDA 扩展为第一个 epoch 增加了 7-15 秒(净节省仍为 3 分 25 秒至 3 分 56 秒)
- 一个 6 GB 的模型被烘焙进镜像,在加载时流式传输其权重,增加了 2-3.5 分钟,但在索引镜像上整体作业仍提前 2-2.5 分钟完成。
你可以通过两种方式采用 SOCI 索引:使用预索引的 AWS 深度学习容器,或为你自己的自定义镜像创建索引。
选项 1:使用预索引的 AWS 深度学习容器
AWS 发布了多个热门深度学习容器的 SOCI 索引变体,通过镜像标签上的 -soci 后缀来标识:
763104351884.dkr.ecr.us-east-1.amazonaws.com/pytorch-training:2.9-gpu-py312-cu130-ubuntu22.04-sagemaker-v1-soci预索引变体可用于 PyTorch Training、TensorFlow Training、vLLM 和 SGLang,其中部分框架还提供 arm64 变体。要采用懒加载,请将作业定义中的镜像标签更新为 -soci 变体。你可以在以下位置浏览完整列表: AWS 深度学习容器库.
注意: 如果你基于 DLC 基础镜像构建自己的镜像,则必须为最终镜像创建 SOCI 索引。基础镜像的索引不会延续到派生镜像。
选项 2:为你自己的镜像创建 SOCI 索引
要为自定义镜像建立索引,你需要一台 Linux 主机(例如运行 Amazon Linux 2023 的 Amazon Elastic Compute Cloud (Amazon EC2) 实例),并安装 containerd、 SOCI snapshotter, 以及 Finch 或 nerdctl 。
- 设置环境变量.
ACCOUNT_ID="111122223333" REGION="us-east-1" REPOSITORY_NAME="my-training-image" ORIGINAL_IMAGE_TAG="v1.0" SOCI_IMAGE_TAG="v1.0-soci" REGISTRY="$ACCOUNT_ID.dkr.ecr.$REGION.amazonaws.com" - 安装所需工具.
sudo dnf install -y containerd fuse soci-snapshotter runfinch-finch sudo systemctl start soci-snapshotter sudo systemctl restart containerd - 向 Amazon ECR 进行身份验证.
aws ecr get-login-password --region "$REGION" \ | sudo nerdctl login -u AWS --password-stdin "$REGISTRY" - 拉取你的原始镜像.
sudo nerdctl pull "$REGISTRY/$REPOSITORY_NAME:$ORIGINAL_IMAGE_TAG" - 创建 SOCI 索引镜像.
sudo nerdctl image convert --soci \ "$REGISTRY/$REPOSITORY_NAME:$ORIGINAL_IMAGE_TAG" \ "$REGISTRY/$REPOSITORY_NAME:$SOCI_IMAGE_TAG" - 推送已建立索引的镜像.
sudo nerdctl push --platform linux/amd64 \
  "$REGISTRY/$REPOSITORY_NAME:$SOCI_IMAGE_TAG"
这会在你的仓库中创建两个产物:SOCI 索引,以及一个将你的镜像链接到该索引的、符合 OCI 规范的镜像索引清单。你的原始镜像及其摘要保持不变。
在 CI/CD 中自动创建索引
要在每次推送时自动生成索引,请部署 CFN ECR SOCI Index Builder。它使用一个 Amazon EventBridge 规则来检测 Amazon ECR 镜像推送事件并构建索引。无需更改你的构建流水线。
在 SageMaker AI 作业中使用已建立索引的镜像完全像引用任何其他镜像一样引用你的 SOCI 索引镜像。无需更改 API。只有标签不同。
训练示例(SageMaker Python SDK)
from sagemaker.train import ModelTrainer
from sagemaker.train.configs import Compute

trainer = ModelTrainer(
    training_image="111122223333.dkr.ecr.us-east-1.amazonaws.com/my-training-image:v1.0-soci",
    role="arn:aws:iam::111122223333:role/SageMakerExecutionRole",
    compute=Compute(
        instance_type="ml.g5.12xlarge",
        instance_count=2,
    ),
)

trainer.train()
验证你的镜像包含 SOCI 索引
在启动之前,确认你的标签解析为已建立索引的镜像:
aws ecr batch-get-image \
  --repository-name "$REPOSITORY_NAME" \
  --image-ids imageTag="$SOCI_IMAGE_TAG" \
  --accepted-media-types \
  "application/vnd.oci.image.index.v1+json" \
  --query 'images[0].imageManifest' --output text \
  | jq '.manifests[] | {mediaType, artifactType}'
在你的平台清单旁边查找一个子清单,其 artifactType 以 application/vnd.amazon.soci.index 开头。如果不存在,则该标签并不指向已建立索引的镜像。
注意事项- 仅限 Amazon ECR 私有仓库。 其他注册表中的镜像,或通过私有 Docker 注册表拉取的镜像(TrainingRepositoryAccessMode 设置为 Vpc),不符合懒加载条件。
- 提升幅度随镜像大小而变化。 小于约 4 GB 的镜像提升幅度相对较小。
- 检查是否存在 Docker 特有的假设。 SOCI 索引镜像运行在基于 containerd 的运行时上。请检查入口点和设置脚本中是否有调用 Docker CLI、读取 /var/run/docker.sock 或从 cgroup 路径推导标识符的代码。SageMaker AI 为向后兼容挂载了 /.dockerenv 标记文件,但请避免新增对它的依赖。
- SageMaker AI 作业的 SOCI 索引已在所有 AWS 区域推出。
借助 SOCI 索引,你可以最大限度地缩短 SageMaker AI 训练和处理作业的容器镜像下载时间。为你的镜像添加 SOCI 索引,或改用已预先建立索引的 AWS 深度学习容器。无论采用哪种方式,你都能将启动时间从数分钟缩短到数秒,降低作业总成本,并加速机器学习(ML)迭代周期。而且你现有的作业定义、API 调用和数据管道完全保持不变。
要详细了解 Amazon SageMaker AI 并开始使用 SOCI 索引,请浏览以下资源:
- 选择一个已建立 SOCI 索引的深度学习容器。 浏览 深度学习容器库 并在镜像标签后追加 -soci。如需针对特定框架的指导,请参阅 AWS 深度学习容器的 SOCI 索引.
- 为你的自定义镜像建立索引。 请按照 SageMaker AI 开发者指南中的分步操作说明进行,或参阅 SOCI snapshotter 入门指南 以了解高级选项。
- 在 CI/CD 管道中自动建立索引。 部署 CFN ECR SOCI 索引构建器 以便在每次推送镜像时自动生成索引。无需更改流水线。
- 使用 Finch 在本地进行测试。 请参阅 Finch 懒加载操作指南,在提交作业前于基于 containerd 的运行时上验证你的镜像。深入了解相关技术。阅读 AWS 机器学习博客上的《使用 SOCI 索引缩短 DLAMI 和 DLC 上的容器冷启动时间》以了解基准数据,或浏览 AWS 容器博客上的《深入解析:使用 Seekable OCI 和 AWS Fargate 懒加载容器镜像》以详细了解懒加载机制。更快的容器启动只差一个镜像标签。在你的 Finch 懒加载操作指南 在提交作业前,于基于 containerd 的运行时上验证你的镜像。
- 深入了解这项技术。 阅读 使用 SOCI 索引缩短 DLAMI 和 DLC 上的容器冷启动时间 以查看基准数据,或浏览 深入解析:使用 Seekable OCI 和 AWS Fargate 懒加载容器镜像 ,以详细了解懒加载机制。
更快的容器启动只差一个镜像标签。在你下一次 SageMaker AI 作业上试试,感受其中的差异。